AI-translated from English; not yet reviewed by a fluent editor.
# رهان Jev الأكبر: قرارات الذكاء الاصطناعي داخل البرامج التي نستخدمها بالفعل
> يدافع الرئيس التنفيذي لشركة TypeSafe، Diogo Almeida، عن ذكاء اصطناعي مدمج في قرارات صغيرة داخل البرامج. نستعرض إطلاق Jev وحدوده وما الذي يثبت حدوث تغيير ذي شأن.
By BIG CHANGE Editorial
Published: 2026-09-22T00:45:03.943Z
Updated: 2026-09-22T00:45:03.943Z
Canonical: https://bigchange.ai/blog/jev-typesafe-ai-decisions-software-diogo-almeida
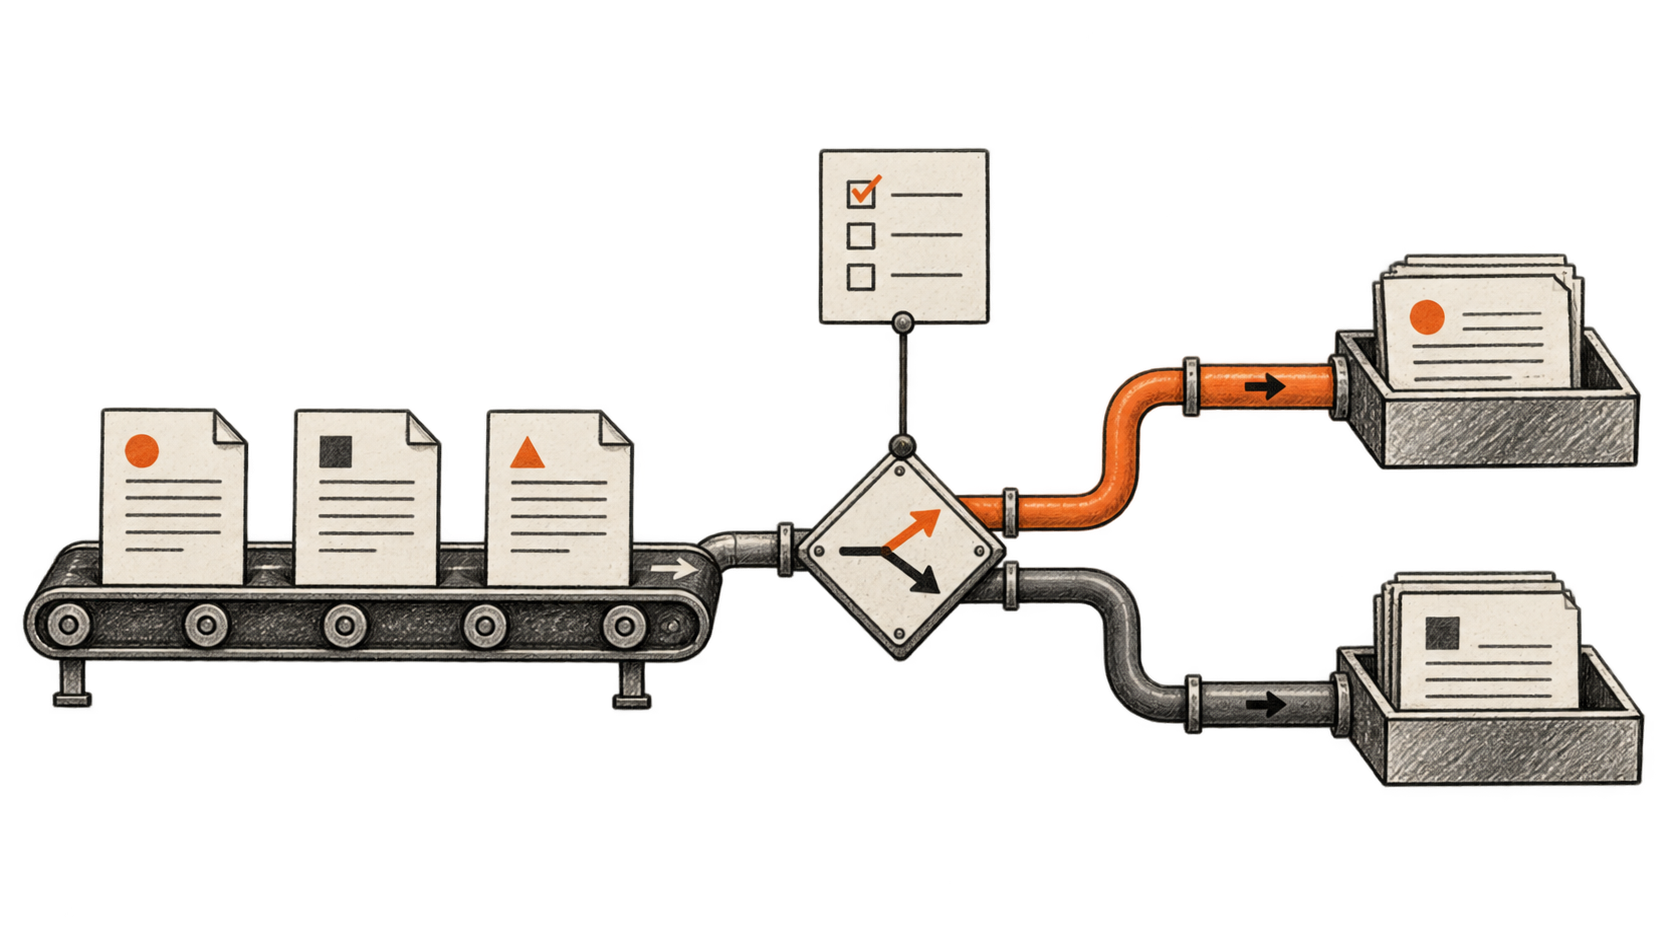
AI-generated conceptual illustration by BIG CHANGE. A decision switch inside a larger workflow; not a depiction of Jev’s internal architecture.
يغير عميل عنوان طلب. وتطلب الرسالة أيضاً استرداداً للمال، وتشير إلى طرد تالف، وتلمح إلى أن هذه ثالث مرة يحدث فيها خطأ. وتحويل الرسالة إلى رد مفيد مهمة، أما تحديد السجلات المطلوب تحديثها والفريق الذي ينبغي أن يتدخل والإجراءات التي تتطلب إذناً فمهمة أخرى.
يستهدف Jev، النموذج الذي قدمته TypeSafe AI في مرحلة الوصول المبكر يوم 15 سبتمبر 2026، تلك القرارات. وينتج إجابات منظمة ومقيّدة لتستخدمها البرامج. ويدعو الإطلاق إلى إعادة النظر في مقدار اعتماد التطبيق على محادثة طويلة مع نموذج عام الغرض. [إعلان الإطلاق من TypeSafe](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
تُعرض الحجة بأوسع صورة في مقابلة Latent Space بتاريخ 21 سبتمبر مع الشريك المؤسس والرئيس التنفيذي لـTypeSafe، Diogo Almeida، وأدارها swyx. راجعنا التسميات التوضيحية الإنجليزية الكاملة للمحادثة التي استمرت ساعتين و22 دقيقة، وتحققنا من وثائق المنتج. وهذا تحليل للمقابلة والأدلة العامة؛ ولم نختبر Jev بمعيار مستقل. [شاهد المقابلة الأصلية](https://www.youtube.com/watch?v=cFx9Z3ZXca0)
نرى أن أبرز مقترحات Jev تتعلق بوحدة الأتمتة. فقد تستطيع شركة أتمتة حكم محدد النطاق داخل عملية قائمة قبل أن تتمكن من تسليم العملية بأكملها بمسؤولية. وإذا أصبح ذلك الحكم رخيصاً بما يكفي لتكراره وواضحاً بما يكفي لقياسه، فقد تكتسب برامج الأعمال المألوفة قدرات مفيدة من دون تحويل كل تفاعل إلى جلسة دردشة.
وسيؤثر ذلك في مصممي سير العمل بقدر تأثيره في مستخدميه. فلا بد لشخص من تحديد الإجراءات المسموح بها وما يُعد خطأً ومن يتولى الاستثناءات. وستحدد جودة هذه القرارات ما إذا كان النهج سينشئ خدمات يُعتمد عليها أو يسرّع الأخطاء فحسب.
## ما الذي أطلقته TypeSafe فعلياً؟
تأخذ الواجهة الموثقة لـJev حالةً ومجموعة من الأسئلة ذات الأنواع المحددة. ولها ثلاث لبنات أساسية: Choice، للاختيار من خيارات محددة؛ وScore، للتقييم وفق معيار؛ وNoul، للتعبير عن احتمال صحة عبارة على مقياس من صفر إلى واحد. ويعيد Choice وScore توزيعات وحقلاً للثقة، أما Noul فلا يتضمن حقل ثقة منفصلاً. ويمكن تقييم الأسئلة بصورة مستقلة بالاستناد إلى الحالة المقدمة نفسها. [وثائق واجهة TypeSafe](https://docs.typesafe.ai/introduction)
في تطبيق لخدمة العملاء، يستطيع المطور استخدام هذه اللبنات للتمييز بين طلب تغيير العنوان وطلب الإلغاء، وتقييم مدى الإلحاح والتحقق مما إذا كانت الرسالة تتضمن دليلاً على تلف. وهذه أمثلة افتراضية، لا نتائج من نشر Jev. وبعد ذلك يقرر التطبيق ما الذي سيفعله بالإجابات.
يفيد هذا الفصل لأن التفسير والصلاحية مسؤوليتان مختلفتان. قد يستنتج الذكاء الاصطناعي أن العميل يريد استرداداً للمال، لكن ينبغي ألا يحصل على إذن بإصداره لمجرد توصله إلى هذا الاستنتاج. ويمكن للتطبيق التحقق من الطلب وفرض سقف للاسترداد واشتراط الموافقة عند اللزوم.
تسمي TypeSafe هذه الفئة من النماذج System One، استعارةً لمفهوم التفكير السريع والحدسي. وتعامل مع الاسم بوصفه وصفاً لنوع العمل المقصود، لا تصديقاً على إدراك شبيه بالبشر أو دليلاً على حد فاصل واضح بين المهام السهلة والصعبة. فقد يخفي السؤال القصير حكماً معقداً، خصوصاً عندما تكون المعلومات اللازمة ناقصة.
## التغيير الهندسي: قرارات أصغر يمكن فحصها
يدعو Almeida إلى تفكيك المهمة: اطرح أسئلة محدودة النطاق، ثم اجمع الإجابات في الشيفرة. [المقابلة، 1:03:02](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=3782s)
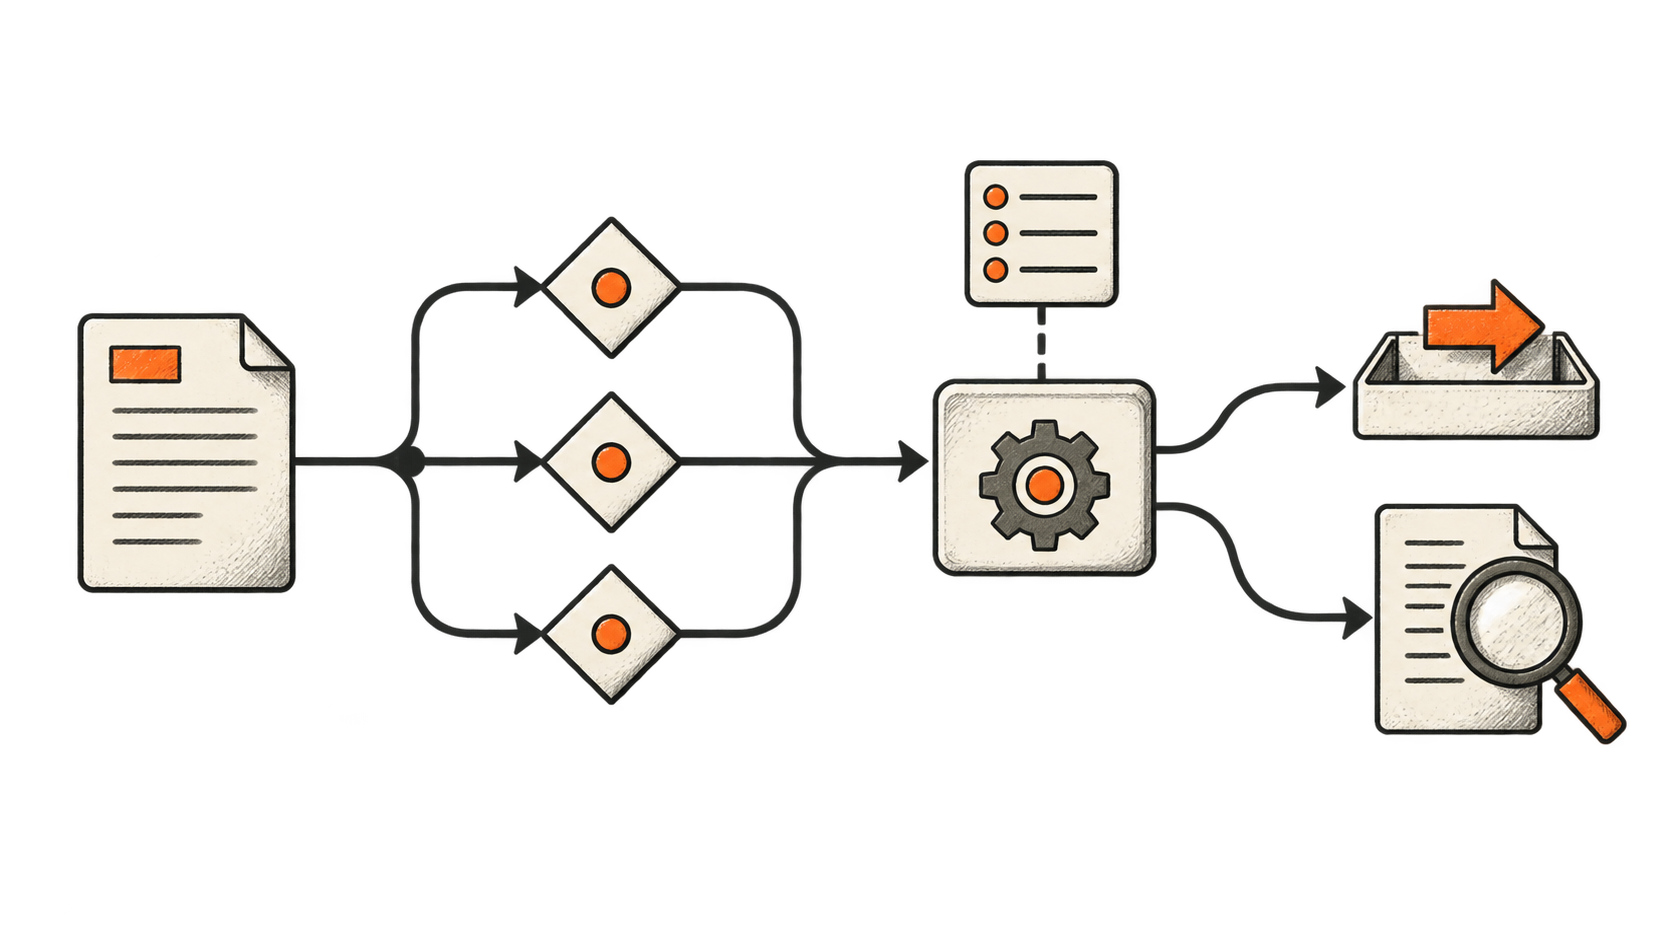
لنتناول مثال الطلب التالف مرة أخرى. فتوجيه واحد لمعالجة الشكوى يخفي عدة أحكام داخل رد واحد. أما التصميم الأسهل للفحص فيحدد على حدة الإجراء المطلوب وإمكان التعرف على الطلب وما إذا كانت الأدلة المتاحة تدعم الادعاء بوجود تلف. وتظل قواعد السياسة خارج هذه الأحكام.
وهذا يسهل التحقيق في الإخفاق. فإذا وجّه النظام طلب تغيير العنوان إلى فريق المرتجعات، يستطيع المشغّل فحص قرار التوجيه. وإذا كان تقييم التلف خاطئاً، أمكن اختبار ذلك المكون على حالات سابقة. ويستطيع تغيير السياسة تعديل قاعدة صريحة من دون مطالبة الفريق بإعادة صياغة تعليمات عامة والأمل أن يفسرها النموذج باستمرار.
لكن لهذا تكاليف. فزيادة المكونات تعني واجهات أكثر تحتاج إلى الصيانة. وقد تحذف الأسئلة سياقاً يجعل الإجابة واضحة. وقد يعتمد حكمان يبدوان مستقلين على الدليل المضلل نفسه. ويمكن لسير عمل مؤلف من أجزاء مقبولة كل على حدة أن يؤدي مع ذلك إلى نتيجة غير مقبولة.
تشمل الأنماط الموثقة لدى TypeSafe طرح عدة أسئلة معاً ودمج الدرجات وتحويل الحالات غير المؤكدة إلى مسار معالجة إضافية. وهي تصف خيارات معمارية، لا تثبت أن عملية عميل بعينها جاهزة للعمل دون إشراف. [أنماط TypeSafe](https://docs.typesafe.ai/patterns)
الاختبار المفيد هو ما إذا كان التفكيك يحسن تشخيص الأخطاء والنتائج معاً. فإمكان شرح الخطوة التي أخفقت له قيمة، لكن حجة العمل تتمثل في خفض تواتر الإخفاقات وعواقبها.
## قد تظل الإجابة الصحيحة شكلياً خاطئة
تتطلب عبارة الإطلاق القائلة إن Jev «لا يمكنه الهلوسة» تفسيراً ضيقاً. تربط TypeSafe ضمانها بمطابقة مخطط المخرجات المسموح به، لكن ذلك لا يثبت صحة الإجابة المختارة. ويميّز إعلان الشركة نفسه بين ضمان المخطط والتقييم التجريبي. [شرح TypeSafe لسلامة الأنواع](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
لنفترض أن التطبيق يسمح بالقيم `damaged` و `late` و `other`. وإرجاع `damaged` يطابق المخطط تماماً حتى لو لم يكن الطرد تالفاً بل متأخراً فحسب. فالنموذج الذي لا يستطيع اختراع فئة رابعة قد يختار مع ذلك الفئة الخطأ. وإذا استبعدت القائمة فئة ضرورية فعلاً، يصبح المخطط نفسه جزءاً من المشكلة.
كما أن المخرجات المنظمة نهج هندسي قائم بالفعل. قدمت OpenAI المخرجات المنظمة المقيدة بمخطط في أغسطس 2024، وأشارت صراحةً إلى أن النموذج قد يخطئ في القيم التي يعيدها. لذا ينبغي تقييم Jev وفق مجموعته المحددة من جودة القرار والإبلاغ عن عدم اليقين والكمون والتكلفة، لا منحه فضل ابتكار كل المخرجات المنظمة للذكاء الاصطناعي. [الإعلان الأصلي لـOpenAI وحدوده](https://openai.com/index/introducing-structured-outputs-in-the-api/)
يغير هذا التمييز خطة التقييم للمشترين. فاختبار المخطط يسأل ما إذا كان البرنامج يستطيع استهلاك الإجابة. والاختبار الوقائعي يسأل ما إذا كانت الإجابة توافق الأدلة. واختبار السياسة يسأل ما إذا كان الإجراء الناتج مسموحاً. واجتياز أحدها لا يغني عن اجتياز الآخرين.
## أهم تحد في المقابلة يتعلق بالمعايرة
عند الدقيقة 1:09، يرفض Almeida الإيحاء بوجود معايرة مثالية ويقر بأخطاء النموذج. [المقابلة، 1:08:50](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4130s)
تتناول المعايرة مدى توافق الاحتمالات المتوقعة مع النتائج المرصودة عبر مجموعات التوقعات. وقد يفيد النموذج في الإشارة إلى عدم اليقين حتى إن لم يصب في كل حالة توقع مرتفع. ويحافظ دليل TypeSafe التمهيدي صراحةً على هذا التمييز. [شرح TypeSafe للمعايرة](https://docs.typesafe.ai/introduction/machine-learning-primer)
ويتطلب حقل الثقة في الواجهة البرمجية تمييزاً آخر. تصفه TypeSafe بأنه إحصاء مشتق من توزيع الإجابات، لا احتمالاً قابلاً للاستبدال باحتمال مستقل مقاس لصحة الإجابة المختارة. وتوصي وثائقها باختيار عتبات تناسب المهمة وعواقبها. [وثائق الثقة لدى TypeSafe](https://docs.typesafe.ai/confidence)
هذه مخاوف عملية. لنتخيل أن نموذج التوجيه يؤدي جيداً مع الرسائل القصيرة بالإنجليزية، لكنه يتعثر في الشكاوى الطويلة التي تجمع طلبات عدة. وقد تخفي درجة إجمالية واحدة هذا الضعف. وقد يستحق القرار عالي الثقة في المجموعة الأضعف تدقيقاً أكبر من الرقم المعروض نفسه في المجموعة المألوفة.
لذلك ينبغي للفريق تقييم الحالات التي يتوقع تلقيها، بما فيها المعلومات الناقصة والصياغات غير المألوفة والمدخلات المربكة عمداً. وعليه فحص الأخطاء حسب الفئة ومقارنة تكلفة إرسال الحالة للمراجعة بتكلفة التصرف على نحو خاطئ. وهكذا تصبح العتبات خيارات تشغيلية تسندها الأدلة، لا أرقاماً منسوخة من عرض توضيحي.
يسبق بحث المعايرة Jev بسنوات طويلة. فقد تناولت ورقة واسعة الاستشهاد من عام 2017 لـChuan Guo وزملائه ضعف المعايرة في الشبكات العصبية الحديثة وطرق تحسينها. وتوفر تلك الدراسة سياقاً للمشكلة، لكنها لا تصادق على نموذج TypeSafe. [حول معايرة الشبكات العصبية الحديثة](https://arxiv.org/abs/1706.04599)
## تشمل الموثوقية ما يحدث عندما تتغير الخدمة
تميز المحادثة بين المتانة والحتمية، وتناقش استقرار الإصدارات دون وعد عام بدعم طويل الأمد. [المقابلة، 41:24](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2484s) و [49:40](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2980s)
هذه أسئلة شراء منفصلة. فالحتمية تسأل هل تعطي المدخلات المتطابقة المخرجات نفسها. أما المتانة فتسأل هل يؤدي تغيير غير ذي صلة، مثل معرّف سجل مختلف، إلى تغير غير معقول في السلوك. وقد يكرر نموذج الإجابة الخاطئة نفسها باستمرار ويكون حتمياً. وقد يتذبذب قليلاً فيما يظل سير العمل المحيط به موثوقاً.
ولا تحل أي من الخاصيتين مخاطر دورة حياة المنتج. تحتاج الشركة إلى معرفة مراجعة النموذج التي أنتجت القرار، وما إذا ظلت متاحة، وكيفية تقييم البديل. وقد يغير التحسن في اختبارات المزود سلوك سير عمل العميل الذي ضبطه بعناية.
والاستجابة المعقولة هي الاحتفاظ بحالات تمثيلية وتسجيل الإصدارات ومقارنة البدائل قبل نقل الأعمال المهمة. كما تهم الخطة الاحتياطية: فقد تصبح خدمة قرارات دقيقة في الظروف الأخرى غير متاحة. وإذا لم يكن لدى التطبيق سبيل آمن للإيقاف المؤقت أو تحويل العمل إلى مكان آخر، تصبح استمرارية الخدمة جزءاً من جودة قراراته عملياً.
وهنا تتحول الواجهة البرمجية الجذابة إلى تبعية تشغيلية. فلا يختفي الشراء والرصد والتخطيط للانتقال حين يصبح النموذج أسرع، بل يسهل إهمالها لأن الاستدعاء الواحد يبدو بسيطاً جداً.
## لماذا تحتاج أرقام السرعة والسعر إلى سياق؟
تتضمن نتائج سير العمل الرئيسية التي تذكرها TypeSafe تحسناً بمقدار 193.6 مرة في السرعة و444.6 مرة في التكلفة. ويحدد الإعلان أنها مكاسب قصوى في مسارات عمل أعدتها الشركة. وجاءت الإجابات المرجعية من تقديرات احتمالية لنماذج أخرى، لا من تصنيفات صحيحة أرضية جرى التحقق منها بصورة مستقلة. وتحذر الشركة أيضاً من أن عرضها القصير يصب في مصلحة Jev، وأن الأسعار المستدامة على المدى الطويل لم تتحدد بعد. [تحفظات TypeSafe بشأن التقييم](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
ينبغي أن تظل هذه التحفظات ملازمة للأرقام. فقد تكون المطابقة مع نموذج مرجعي مفيدة، لكنها تقيس شيئاً مختلفاً عن الصحة في ضوء حالة عميل حُسمت. وقد يكون سير العمل الذي صممه البائع مهماً للمشتري، من دون أن يمثل توزيع طلبات ذلك المشتري.
وينبغي للمقارنة الصحيحة أن تشمل المهمة كاملة: جمع السياق واتخاذ القرارات وتطبيق القواعد ومعالجة الاستثناءات والتعافي من الإخفاق. وقد يتزامن استدعاء النموذج الأرخص مع تكلفة إجمالية أعلى إذا أحال كثيراً من العمل إلى المراجعين. وقد يكون الاستدعاء الأبطأ اقتصادياً إذا تجنب إعادة العمل المكلفة.
وينبغي قياس الكمون أيضاً في المنطقة الفعلية للتطبيق. فالعرض القريب من بنية الخدمة التحتية لا يعد بتجربة مماثلة لمستخدم في مكان آخر. وعلى الأنظمة التفاعلية فحص الطلبات البطيئة لا المتوسط فحسب؛ وقد تهتم المعالجة في الخلفية بمعدل الإنجاز والتكلفة الإجمالية أكثر.
يوحي اسم Jev بفكرة أن الكفاءة قد توسع الاستهلاك. وبالنسبة إلى شركة بعينها، يثير ذلك سؤالاً عن الميزانية: ما القرارات الجديدة التي أصبح تقييمها مجدياً، وأيها أصبح رخيصاً بما يكفي لتقييمه بلا داعٍ فحسب؟ زيادة استدعاءات النموذج ليست نتيجة في حد ذاتها.
## هدف بحثي مختلف وأدلة لم تكتمل بعد
يربط طرح Almeida البحثي البيانات واختيار المهام وRLCD بانتقاده لتحسين التفضيلات. [المقابلة، 7:23](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=443s) و [22:12](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=1332s)
يرمز RLCD إلى التعلم بالتعزيز من أجل القرارات المعايرة. وتعرضه TypeSafe بوصفه تدريباً موجهاً إلى قرارات واحتمالات قابلة للاستخدام، في مقابل أساليب التفضيلات البشرية والمكافآت القابلة للتحقق. وهذا وصف الشركة لهدفها، ولا ينبغي اعتباره تحققاً مستقلاً من منهج التدريب الكامل. [الدليل التمهيدي للذكاء الاصطناعي من TypeSafe](https://docs.typesafe.ai/introduction/machine-learning-primer)
ويستحق السؤال الأوسع البحث حتى مع تقييم المنهج: ما السلوك الذي يكافئه هدف التدريب؟ قد يكون النموذج المحسّن لتقديم شرح مقنع لطيف الاستخدام من دون كشف عدم اليقين بصيغة تستطيع الشيفرة التصرف بناءً عليها. وقد تسهل واجهة موجهة للقرارات التعامل مع عدم اليقين، لكن تظل مخرجاتها بحاجة إلى فحوص خارجية تطابق الواقع.
تربط TypeSafe هذا القلق بإسقاط الأنماط: فقد يضيّق تحسين التفضيلات نطاق المخرجات المرجحة باتجاه الإجابات التي يكافئها الناس. وهذا تفسيرها لنمط إخفاق، لا استنتاج بأن كل نموذج مدرب على التفضيلات غير صالح لاتخاذ القرارات. [نقاش TypeSafe حول تحسين التفضيلات](https://docs.typesafe.ai/introduction/machine-learning-primer)
ويجعل ماضي Almeida هذه الحجة مثيرة للاهتمام خصوصاً. فهو أحد المشاركين في تأليف ورقة InstructGPT التي درست تدريب نماذج اللغة على اتباع التعليمات باستخدام التغذية الراجعة البشرية. ويمكن التحقق من مشاركته في التأليف؛ أما الادعاءات الشاملة عما تخطئ فيه كل المختبرات فمسألة مختلفة. [ورقة InstructGPT](https://arxiv.org/abs/2203.02155)
وينتمي اعتراضه على الإنفاق على التدريب المسبق والمختبرات الجديدة غير الموجهة إلى النقاش نفسه عن اختيار المهام المفيدة. [المقابلة، 1:49:32](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6572s) و [2:03:10](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7390s)
وبالنسبة إلى المشتري، فالدرس المهم أن يسأل عما يستطيع المنتج فعله ضمن عملية محددة. وقد يشرح الإرث البحثي والإنفاق على الحوسبة وبنية النموذج المميزة كيف توصلت الشركة إلى منتجها، لكنه لا يثبت اقتصاديات نشره في شركة أخرى.
وتتناول المقابلة أيضاً مغادرة Almeida لـOpenAI وصعوبة التبني المبكر والنمو بقيادة المطورين. [المقابلة، 1:31:27](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5487s) و [1:56:48](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7008s)
تشرح هذه الذكريات أولويات الشركة، لكنها ليست دليلاً مدققاً على التبني. وينبغي في النهاية تقييم منصة المطورين على أساس أعباء عمل مفيدة ومستدامة والدعم المقدم عندما تخفق. ويعد الحماس بعد الإطلاق سبباً للتحقق، لا بديلاً عن هذا السجل.
## قد تستفيد البرامج القائمة أكثر من نافذة دردشة جديدة
يتوقع Almeida منتجات SaaS أقوى وتراجع الذكاء الاصطناعي إلى الخلفية. [المقابلة، 1:19:57](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4797s)
وهذا اتجاه جدير بالبحث لأن البرامج تتضمن بالفعل نقاطاً قد يغير فيها حكم مفيد الخطوة التالية. فقد يحدد تطبيق جدولة طلباً ملتبساً قبل الحجز، أو ينظم أرشيف وسائط مواد للباحث، أو يميز مكتب خدمة تحديثاً روتينياً من شكوى تتطلب الاهتمام. وهذه تصاميم محتملة، لا عمليات نشر لـJev أُبلغ عنها.
قد لا تتغير الواجهة إلا قليلاً. وسيلحظ المستخدمون أخطاء أقل أو تصنيفاً متكرراً أقل أو انتظاراً أقصر للشخص المناسب. وقد تذهب الميزة التجارية إلى شركات تفهم سير العمل بالفعل وتستطيع دمج قرارات أفضل فيه.
وستظل شركات البرمجيات القائمة تواجه المنافسة. فإذا أصبح الحكم نفسه متاحاً لكثير من المطورين، فلن يوفر استدعاء النموذج وحده تمايزاً كبيراً. وينبغي للمنتج المحيط أن يقدم وصولاً مفيداً إلى البيانات وتصميماً مدروساً للتفاعل وطريقة موثوقة لإتمام العمل.
وتتطلب ادعاءات التوظيف تحفظاً أكبر. فقد يؤدي خفض الجهد في مهمة واحدة إلى تغيير التوظيف أو زيادة حجم الخدمات أو تحويل العمل نحو الحالات الاستثنائية. وتتوقف النتائج على المؤسسة والطلب على خدمتها. ولا تثبت المقابلة أو الإطلاق المبكر حماية الوظائف أو إلغاءها أو خلقها بعدد محدد.
وبالنسبة إلى النظرة القطاعية لدى BIG CHANGE، يتمثل الحدث القابل للقياس في إتاحة نهج آخر لأتمتة القرارات. أما التبني الواسع ومكاسب الإنتاجية وآثار سوق العمل فأسئلة لاحقة تتطلب أدلة مختلفة.
## البيانات الخفية والبرمجيات الآنية وحدود العروض التوضيحية
تناقش المقابلة البيانات المخزنة والتطبيقات التفاعلية والتحقق وعروض استخدام الحاسوب. [المقابلة، 1:34:50](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5690s)
ويقترح كل نوع تقييماً مختلفاً. يمكن لمهمة معالجة الأرشيف تحمل بعض التأخير، لكنها تحتاج خطة لأخذ عينات من النتائج وربطها بالسجلات الأصلية. وتتطلب الواجهة الآنية استجابة متوقعة. أما أداة التحقق التي تقيّم نموذجاً آخر فتحتاج إلى الاختبار على الأخطاء التي يرتكبها ذلك النموذج فعلياً، بما فيها الحالات التي يخطئ فيها النظامان معاً.
وفي استخدام الحاسوب، لا يمثل اختيار الإجراء إلا جزءاً واحداً من النظام. فهو يحتاج أيضاً إلى تمثيل دقيق للواجهة وطريقة لتنفيذ الإجراء وفحص حدوث التغيير المتوقع. وقد يثبت عرض مصقول وقوع تسلسل مرة واحدة؛ لكن الأتمتة الموثوقة تحتاج تجارب متكررة وتعافياً من الانقطاعات.
وينطبق الحذر نفسه على الألعاب. فقد تستجيب شخصية تعمل بنموذج لحالة أغنى، فيما تظل محركات اللعبة تفرض الإجراءات الممكنة. ويتوقف تحسن اللعب على الاستجابة والاتساق وتصميم التجربة. ولا يؤدي إضافة الاستدلال إلى كل إطار تلقائياً إلى جعل اللعبة أمتع.
تمنع هذه الفروق خطأً تصنيفياً: ينبغي تقدير المكون المفيد وفق الدور الذي يؤديه، دون أن يرث كل قدرات التطبيق الأكبر المحيط به.
وتظهر الضبط الدقيق والرؤية الحاسوبية وأشكال النماذج الإضافية كاحتمالات في المقابلة. [المقابلة، 1:10:27](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4227s) و [1:26:23](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5183s)
ينبغي ألا يتحول نقاش خارطة الطريق إلى تبعية في خطة الإطلاق. ابنِ على الواجهة المتاحة، وحدد ما الذي يجب أن يوفره مكون منفصل، وقيّم كل قدرة جديدة عند وصولها فعلياً. ويتيح ذلك الاستفادة من التحسينات المستقبلية من دون تقديم التكهنات على أنها ميزة في المنتج.
## قد تغير وكلاء البرمجة طريقة تقسيم العمل
يقترح Almeida معالجة أقل تكلفة للحالة وسياقاً مشتركاً لوكلاء البرمجة يتجاوز دورة نموذج واحد. [المقابلة، 1:40:17](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6017s) و [2:09:29](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7769s)
قد تستخدم بنية محتملة نموذج برمجة مقتدراً لتطوير التغيير، واستدعاءات قرار أصغر لتصنيف الملفات ذات الصلة، وبرمجيات عادية لإدارة المهام الناتجة، ثم يراجع مراجع منفصل التصحيح النهائي. وهذا اقتراح تصميمي، لا توصية اختُبرت معيارياً أو دليلاً على أن Jev يحل بالفعل محل وكيل برمجي قائم.
والجانب الجذاب هو السياق الانتقائي. فإذا لم تتطلب مهمة فرعية إلا واجهة واحدة وعدداً قليلاً من القيود، فقد يكون إرسال محادثة كاملة إليها هدراً. وقد تسهل سجلات المهام الصريحة تحديد الحقائق المهمة وما حُسم بالفعل والتغييرات التي ما زالت معلقة.
أما الجانب الخطر فهو الخلط بين اقتراح للتنسيق وضمان للتزامن. فقد يعتقد وكيلان أن كليهما ينبغي أن يكتب الملف نفسه. ولا ينبغي لنموذج احتمالي أن يحل محل آليات البرنامج التي تمنع تعارض الكتابة. وتظل الأذونات وفحوص الإصدارات والأقفال ضرورية لفرض النتيجة.
وبالمثل، قد يحسن استرجاع العمل السابق بتكلفة أقل إدارة الذاكرة دون حل كل مشكلة تسمى التعلم المستمر. فتذكر محاولة سابقة وفهم سبب فشلها والتكيف الموثوق مع موقف جديد قدرات مختلفة. وينبغي لتقييم مقنع فحص المهام المكتملة والتراجعات والتعارضات والتدخل البشري، لا مجرد عد الوكلاء أو الاستدعاءات.
## تنتقل السلامة عبر النظام ولا تختفي
يفضل Almeida ضوابط السلامة على مستوى التطبيق على رفض النموذج؛ ويتحدى swyx عواقب ذلك. [المقابلة، 13:11](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=791s) و [1:42:29](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6149s)
ثمة مشكلة تصميم حقيقية هنا: يجب على التطبيق غير الخاضع للإشراف التعامل مع حالات رفض أحد المكونات أو إخفاقه أو إرجاعه نتيجة غير مؤكدة. وهو بحاجة إلى مسار استجابة صريح. لكن هذه الملاحظة لا تحسم مكان كل ضمانة.
ينبغي للتطبيق فرض أذونات الوصول حتى عندما يحدد النموذج الإجراء المقصود على نحو صحيح. فقد يكون طلب حذف سجل مفهوماً تماماً، لكنه غير مصرح به. وقد يكون الطلب صالحاً تقنياً لكنه يخالف سياسة المشغل. ولا تستطيع خدمة القرار الإجابة عن هذه الأسئلة بمسؤولية دون سياق مناسب، كما يجب أن يحتفظ التطبيق بالسيطرة على الإجراء.
لذلك فإن نقل مزيد من القرارات إلى البرامج يزيد أهمية تحديد الحدود قبل النشر. فعلى الفرق تحديد الأدلة المطلوبة والعمليات التي تظل قابلة للعكس وكيف يستطيع شخص ما الاعتراض على النتيجة أو تصحيحها. ولا يكفي إزالة تفاعل محرج مع نموذج دليلاً على سلامة النظام بأكمله.
## ما الذي يثبت حدوث تغيير كبير؟
يتيح الإطلاق تجربة واضحة. اختر عملية محددة النطاق ذات نتيجة يمكن ملاحظتها. وسجل طريقة عملها الحالية، بما في ذلك الأخطاء والوقت الذي يقضيه الناس في إصلاحها. واختبر نهجاً قائماً على القرارات في حالات تمثيلية قبل منحه صلاحية التنفيذ.
قِس نسبة الحالات التي تُنجز على نحو صحيح من دون تدخل، والأخطاء التي تفلت من المراجعة، وحجم العمل الذي يُحال إلى الأشخاص، والتكلفة الإجمالية لكل حالة مكتملة. واحتفظ بالأدلة الأصلية ليتسنى للمراجع فحص سبب قبول النتيجة. وكرر المقارنة عند تغير النموذج أو السياسة أو فئة المدخلات.
قد يكشف هذا التقييم أن جزءاً من العملية وحده جاهز. وهذه نتيجة مفيدة. فقد تكون أتمتة التصنيف الروتيني مع إبقاء الحالات الملتبسة لدى مشغل خبير مجدية، دون أن تبرر استقلالية أوسع.
يطرح إطلاق Jev ومقابلة Almeida فرضية طموحة عن دخول الذكاء الاصطناعي إلى الاقتصاد: فالقرارات المتكررة والمقيدة قد تجعل البرامج التي يعتمد عليها الناس بالفعل أقدر. وينبغي أن تأتي الأدلة التالية من أنظمة تنجز هذا العمل بمرور الوقت، مع احتساب الأخطاء والاستثناءات. هناك تتحول بنية نموذج مثيرة للاهتمام إلى تغيير يستطيع القراء رؤيته فعلاً.
## Sources
- [مقابلة Latent Space الأصلية](https://www.youtube.com/watch?v=cFx9Z3ZXca0) — مقابلة Latent Space مع Diogo Almeida، نُشرت في 21 سبتمبر 2026. وترد روابط بطوابع زمنية في هذا التحليل.
- [تقديم نماذج System One وJev](https://typesafe.ai/blog/introducing-system-one-models-and-jev) — 15 سبتمبر 2026. إعلان TypeSafe عن الوصول المبكر إلى Jev، بما يشمل ادعاءات الأداء وحدود التقييم.
- [المقدمة](https://docs.typesafe.ai/introduction) — وثائق TypeSafe التي تشرح حالة الإدخال وأسئلة Choice وScore وNoul للنموذج.
- [الثقة](https://docs.typesafe.ai/confidence) — وثائق TypeSafe التي تميز الثقة عن الاحتمال وتشرح كيفية استخدام التطبيقات للعتبات.
- [الدليل التمهيدي للذكاء الاصطناعي](https://docs.typesafe.ai/introduction/machine-learning-primer) — شرح TypeSafe لهدف التدريب ومعنى المعايرة عبر مجموعات التوقعات.
- [الأنماط](https://docs.typesafe.ai/patterns) — أمثلة TypeSafe على دمج قرارات النموذج بمنطق التطبيق.
- [تقديم المخرجات المنظمة في واجهة API](https://openai.com/index/introducing-structured-outputs-in-the-api/) — 6 أغسطس 2024. تقديم OpenAI للمخرجات المقيدة بمخطط وحدودها.
- [حول معايرة الشبكات العصبية الحديثة](https://arxiv.org/abs/1706.04599) — بحث عام 2017 لـChuan Guo وزملائه عن معايرة الشبكات العصبية. ولا تقيّم هذه الورقة Jev.
- [تدريب نماذج اللغة على اتباع التعليمات باستخدام التغذية الراجعة البشرية](https://arxiv.org/abs/2203.02155) — ورقة InstructGPT البحثية لعام 2022، التي شارك Diogo Almeida في تأليفها، حول اتباع التعليمات مع التغذية الراجعة البشرية.
نشرة BIG CHANGE البريدية
الصورة الأوسع. على وتيرتك.
قصص حديثة عن الذكاء الاصطناعي والروبوتات، وتحولات تستحق المتابعة، وأفكار عملية للتطبيق. اختر موجزًا يوميًا أو خلاصة أسبوعية أو رؤية شهرية.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
خصوصيتك، خيارك.
يساعد التخزين الضروري على حماية الموقع وتذكّر خياراتك. تظل Google Analytics الاختيارية متوقفة حتى تسمح بها. يمكنك قراءة كل قصة باستخدام التخزين الضروري فقط. تفاصيل الخصوصية