AI-translated from English; not yet reviewed by a fluent editor.
# Grok 4.7 একই token-দামে চালু। কাজ শেষ করতে মোট খরচই বড় প্রশ্ন
> Grok 4.7 চালুর ঘোষণায় coding ও office কাজের সক্ষমতা বাড়ার কথা বলা হয়েছে। Matthew Berman-এর আলোচনা, স্বাধীন পরীক্ষা এবং model বদলানোর আগে দলগুলোর কী মাপা উচিত—তা আমরা দেখি।
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
Grok 4.7 এসেছে ২১ সেপ্টেম্বর ২০২৬-এ। কোড লেখা বা ব্যবসার তথ্য বিশ্লেষণে AI কেনা দলের জন্য এর প্রকাশ ব্যবহারিক প্রশ্ন তোলে: উন্নত model কি কাজ শেষ করার খরচ কমায়? উত্তরটি বিজ্ঞাপিত token rate-এর চেয়ে বেশি কিছুর ওপর নির্ভর করে। [আনুষ্ঠানিক release note](https://docs.x.ai/developers/release-notes)
এই মিশ্র চিত্র নিয়েই Matthew Berman-এর ২২ সেপ্টেম্বরের ভিডিও, *Grok 4.7 নিয়ে কী ভাবব বুঝতে পারছি না…*। তিনি তুলনার পদ্ধতি নিয়ে প্রশ্ন করেন এবং বলেন, token-এর দাম নয়, সম্পন্ন কাজপ্রতি খরচ গুরুত্বপূর্ণ। model-টি বিস্তারিতভাবে পরীক্ষা করেননি বলেও জানান। তাঁর ভিডিও প্রমাণের প্রাথমিক মূল্যায়ন; সম্পূর্ণ হাতে-কলমে পরীক্ষা নয়। [Berman-এর ভূমিকা, ০:০০ মিনিটে](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
launch-টি নজর পাওয়ার যোগ্য, কারণ ব্যবসা কী কী স্বয়ংক্রিয় করতে পারবে তা বদলাতে ভালো model-কে প্রতিটি benchmark জিততে হয় না। তবে মোট খরচ যৌক্তিক করতে যথেষ্ট কাজ সঠিকভাবে শেষ করতে হয়। স্বাধীন পরীক্ষায় ইতিমধ্যে এই টানাপোড়েন দেখা যাচ্ছে: Grok 4.7-এর ভালো ফলের সঙ্গে অনেক বেশি তৈরি করা output থাকতে পারে।
developer, ছোট ব্যবসা এবং agent নির্মাতা দলের জন্য সিদ্ধান্তটি তাই ব্যবহারিক। কোন কাজগুলো এ model গ্রহণযোগ্য মানে শেষ করতে পারে? কতটা প্রচেষ্টা লাগে? আর model কাজ শেষ বলার পর মানুষের কতটা কাজ বাকি থাকে?
Berman-এর প্রায় ১৭ মিনিটের ভিডিওর সম্পূর্ণ caption আমরা পর্যালোচনা করেছি এবং launch, পণ্যের নথি ও Artificial Analysis-এর মূল্যায়ন যাচাই করেছি। নিচের বিশ্লেষণে BIG CHANGE-এর কোনো benchmark বা Grok হাতে-কলমে পরীক্ষা করার দাবি নেই।
## কী চালু হয়েছে এবং কোথায় পাওয়া যায়
সাধারণ model-টি xAI API-তে `grok-4.7`, পাশাপাশি Cursor ও Grok Build-এ পাওয়া যায়। API-তে text ও image input নিয়ে text output পাওয়া যায়। নথিভুক্ত context window ৫০০,০০০ token; reasoning setting চারটি: low, medium, high ও xhigh। default হলো high। [আনুষ্ঠানিক release note](https://docs.x.ai/developers/release-notes)
SpaceXAI-র বক্তব্য, বড় base model এবং কঠিন কাজে দীর্ঘ reinforcement learning উন্নতিটি এনেছে। এটি নির্মাতার ব্যাখ্যা। [launch-এর প্রযুক্তিগত বিবরণ](https://x.ai/news/grok-4-7)
Grok 4.7 Fast-ও আছে। নথিতে একে দ্রুত অবকাঠামোতে চালানো একই model বলা হয়েছে; সাধারণ token rate-এর দ্বিগুণ দাম। এটি Cursor ও Grok Build-এ পাওয়া যায়, Grok Build-এর বিনামূল্যের স্তরে নেই এবং প্রকাশ্য xAI API-তে পাওয়া যায় না। [Grok 4.7 পণ্যের নথি](https://docs.x.ai/developers/grok-4-7)
screenshot, প্রদর্শনী ও বিল তুলনা করতে এই পার্থক্যগুলো গুরুত্বপূর্ণ। Model version, reasoning effort এবং serving tier—আলাদা পছন্দ। xhigh-এ Fast দিয়ে করা প্রদর্শনী সাধারণ গতির API ও medium effort ব্যবহারের অভিজ্ঞতা বা খরচের অনুমান নয়।
অন্য model-এর সঙ্গে launch page-এর তুলনাকে upgrade-সংক্রান্ত তুলনা থেকে আলাদা রাখতে হবে। SpaceXAI বলছে, সাধারণ Grok 4.7-এর দাম ও গতি Grok 4.6-এর মতোই। 4.6 থেকে upgrade করলেই গ্রাহকের বিল স্বয়ংক্রিয়ভাবে অর্ধেক হবে—এ কথা বলা হয়নি।
## দীর্ঘ context-এর জন্য মূল্যস্তর বদলায়
সাধারণ API-র প্রকাশিত rate হলো:
- prompt token ২০০,০০০ পর্যন্ত: প্রতি million token-এ input $2, cached input $0.50 এবং output $6।
- prompt token ২০০,০০০-এর বেশি: প্রতি million token-এ input $4, cached input $1 এবং output $12।
এগুলো token rate, agent দিয়ে কাজ শেষ করানোর সর্বমোট দাম নয়। ২০০,০০০-এর বেশি prompt-এর জন্য বাড়তি দাম মডেল-পৃষ্ঠায় চিহ্নিত, এবং release note-এ উচ্চতর rate নির্দিষ্ট। দাম ও প্রাপ্যতা ২২ সেপ্টেম্বর যাচাই করা হয়েছে। [model-এর মূল্যতালিকা](https://docs.x.ai/developers/models/grok-4.7) এবং [release note](https://docs.x.ai/developers/release-notes)
তাই ৫০০,০০০-token context window থাকলেই তার মধ্যে প্রতিটি request সর্বনিম্ন rate-এ পড়ে না। বড় context window মানেই বড় file-সমষ্টির প্রতিটি প্রাসঙ্গিক তথ্য model ধারাবাহিকভাবে খুঁজে পাবে—এটিও নয়।
Cursor-এ পণ্য-স্তরের আরেক পার্থক্য আছে: তাদের নথিতে standard window ২৫৬,০০০ token এবং সর্বোচ্চ ৫০০,০০০। Editor-এ দেখানো সক্ষমতা API specification থেকে আলাদা হতে পারে, বা বেছে নেওয়া mode-এর ওপর নির্ভর করতে পারে। [Cursor-এর Grok 4.7 নথি](https://prod.cursor.com/docs/models/grok-4-7)
দীর্ঘ report প্রক্রিয়াকারী দলের তাৎক্ষণিক প্রশ্ন হলো, সব উপাদান পাঠালে খরচ সার্থক করার মতো উন্নত ফল আসে কি না। প্রাসঙ্গিক অংশ খুঁজে পাঠানো কম খরচে করা ও পরীক্ষা করা সহজ হতে পারে। কখনো পুরো নথি দরকার, কখনো prompt বানানোর সবচেয়ে সহজ পথ শুধু সেটি। বাজেট করার সময় এ পরিস্থিতিগুলোকে একই বলে ধরা উচিত নয়।
## ভালো ফলেও token ব্যবহার বাড়তে পারে
Artificial Analysis-এর ২১ সেপ্টেম্বরের মূল্যায়নে xhigh-এ Grok 4.7-এর Intelligence Index score ৪৬, high effort-এ Grok 4.6-এর চেয়ে দুই পয়েন্ট বেশি। একেকটি কাজে আনুমানিক ৮১,০০০ output token লাগে বলে জানায়; high effort-এ Grok 4.6-এর ক্ষেত্রে ৩৬,০০০। একই প্রতিবেদনে xhigh-এ Grok 4.6-এর জন্য ৩৮,০০০ বলা হয়েছে; ফলে effort একই রেখেও output token দ্বিগুণের বেশি। [Artificial Analysis-এর launch মূল্যায়ন](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
token-এর দাম ও কাজের খরচ আলাদা করে দেখার এটি নির্দিষ্ট কারণ। প্রতি million-এ মূল $6 rate ধরে ৮১,০০০ output token-এ উদাহরণস্বরূপ output charge $0.486 হয়। ৩৮,০০০ token হলে $0.228। হিসাব দুটিতে ইচ্ছাকৃতভাবে input, cache আচরণ, tool charge, উচ্চ context-এর দাম ও ব্যর্থ চেষ্টা বাদ। এগুলো জানানো token count দিয়ে করা অঙ্ক, মাপা সর্বমোট কাজের দাম নয়।
বেশি output হলেই অপচয় নয়। Model হয়তো উত্তর যাচাইয়ে অতিরিক্ত চেষ্টা করে এমন ব্যর্থতা এড়ায়, যেখানে মানুষের হস্তক্ষেপ লাগত। আবার ভুল পথে বেশি সময়ও দিতে পারে। শুধু token গুনে ফলদায়ক অধ্যবসায় আর ব্যয়বহুল পুনরাবৃত্তি আলাদা করা যায় না।
ভিডিওর শেষদিকে Berman এই সমস্যায় আবার আসেন; Artificial Analysis-এর জানানো বাড়তি token ব্যবহারের কথা বলেন। [ভিডিও, ১৫:৪৩ মিনিটে](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
কার্যকর ফল হলো গৃহীত deliverable। উপযুক্ত test ও review পেরোনো code change, সূত্র মেলানো spreadsheet বা প্রমাণ-সূত্রে ফেরত যাওয়া যায় এমন দাবি-সহ report—এগুলো কেবল দ্রুত পাওয়া উত্তরের থেকে ভিন্ন মূল্যের।
## benchmark-এ সক্ষমতা আছে, তবে ফল সমান নয়
launch table-এ Grok 4.7 xhigh-এর CursorBench 4.0 score ৪৬.৩%; Fable 5.1 max-এর ৫১.৮%-এর নিচে। Fable-এর Terminal-Bench তুলনাতেও এগিয়ে থাকার কথা। [বিক্রেতার benchmark table](https://x.ai/news/grok-4-7)
সঙ্গে থাকা chart-এ benchmark score-এর বিপরীতে output token আঁকা; রেখাগুলো ডানদিকে নামতে থাকে। এতে reasoning setting তুলনা করা হয়েছে। [মূল interactive chart: Tokens নির্বাচন করুন](https://x.ai/news/grok-4-7)। [বড় আকারে chart খুলুন](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png)।
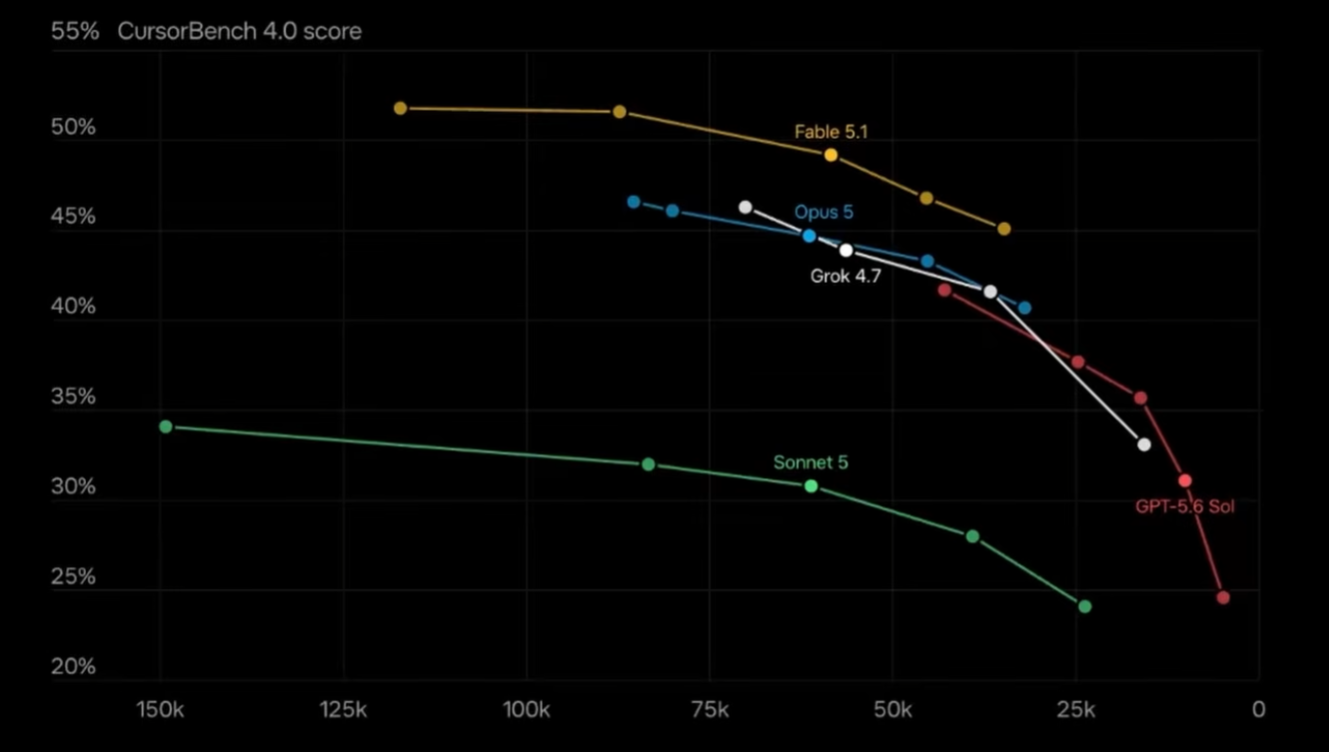
ওপরের দিকে যাওয়া মানে বেশি score; ডানদিকে যাওয়া মানে এই মূল্যায়নে কম token তৈরি। এর অর্থ সর্বমোট দাম কম নয়: token rate, input ব্যবহার এবং চারপাশের agent-ও গুরুত্বপূর্ণ। Artificial Analysis-এর উপরের token সংখ্যার চেয়ে এটি আলাদা test। দুইটির সংখ্যা এক করলে task ও পদ্ধতির পার্থক্য হারাবে, যা প্রতিটি ফল বোঝার জন্য জরুরি।
এ থেকে Grok 4.7 সব ধরনের coding কাজেই এগিয়ে—এমন blanket দাবি খারিজ করা যায়। নির্দিষ্ট workload-এ আরও পরীক্ষা করার যথেষ্ট কারণও আছে। একটি মূল্যায়নে উন্নতির মাপ থেকে বোঝা যায় না model অপরিচিত repository, অসম্পূর্ণ bug report বা অস্বাভাবিক tool environment সামলাবে কীভাবে।
Artificial Analysis আরেকটি কার্যকর পার্থক্য দেখায়। তাদের প্রতিবেদন অনুযায়ী, Grok Build-সহ Grok 4.7-এর Coding Agent Index score ৫৬, Grok Build-সহ Grok 4.6-এর ৪৭ থেকে বেশি। তারা স্পষ্টভাবে এই native-agent ফলকে standardized Intelligence Index setup থেকে আলাদা রেখেছে। [স্বাধীন মূল্যায়ন ও পদ্ধতির নোট](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
চারপাশের agent-ও গুরুত্বপূর্ণ। এটি tool দেয়, context সামলায় এবং model-এর request কীভাবে চালানো হবে ঠিক করে। Model-এর নাম একই থেকেও পরিবেশ বদলালে ফল বদলাতে পারে। এক setup-এর terminal score আর অন্য setup-এর software-engineering score মিশিয়ে এমন আকর্ষণীয় table তৈরি হতে পারে, যা কেউ বাস্তবে পরীক্ষা করেননি।
একটি launch table-এ GPT-6 Astra নেই বলে Berman প্রশ্ন তোলেন এবং যোগ করতে AI-তৈরি পুনর্গঠন ব্যবহার করেন। তুলনাটি অনুসন্ধানের ভালো সূচনা; পুনর্গঠনটি স্বাধীন benchmark source নয়। অন্তর্নিহিত মূল্যায়ন না দেখে তার যোগ করা সংখ্যা আমরা গ্রহণ করিনি। [ভিডিও, ৬:০৩ মিনিটে](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
বাণিজ্যিক সম্পর্কও মনে রাখা দরকার। Cursor-এর ১৪ আগস্টের কোম্পানি-ঘোষণায় বলা হয়েছে SpaceX প্রতিষ্ঠানটিকে অধিগ্রহণ করেছে। একই কর্পোরেট পরিবারের ভেতরে প্রচারিত benchmark মূল্যবান প্রমাণ থাকলেও প্রতিদ্বন্দ্বী সরবরাহকারীর নিরপেক্ষ মূল্যায়ন নয়। [Cursor-এর অধিগ্রহণ ঘোষণা](https://cursor.com/blog/joining-spacex)
## অফিসের কাজই হয়তো আরও আকর্ষণীয় সুযোগ
স্বাধীন মূল্যায়নে xhigh-এ Grok 4.7-এর AA-Briefcase score ১,৬৫৭ Elo—high effort-এ Grok 4.6-এর চেয়ে ১১১ বেশি। তাদের মতে উন্নতির বড় অংশ বিশ্লেষণের মান থেকে এসেছে; তবে উপস্থাপনার মান আগের model-এর ফলের চেয়ে সামান্য কম। [Artificial Analysis-এর জ্ঞানভিত্তিক কাজের ফল](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
report, spreadsheet বা presentation তৈরি করান—এমন যে কারও জন্য এ বিভাজন উপকারী। উত্তরে বিশ্লেষণ আরও শক্তিশালী হতে পারে, তবু সম্পাদনা বা নতুন নকশা লাগতে পারে। উল্টো দিকে, ঝকঝকে slide-এর আড়ালে দুর্বল যুক্তি থাকতে পারে। শুধু চোখে দেখা finish মাপলে ভুল উন্নতিকে পুরস্কৃত করার ঝুঁকি থাকে।
Operations দল পুনরাবৃত্ত performance report-এ model পরীক্ষা করতে পারে। কার্যকর পরীক্ষায় দেখা হবে সঠিক সময়কাল নেওয়া হয়েছে কি না, source data-র সঙ্গে সংখ্যা মেলে কি না এবং পর্যবেক্ষিত পরিবর্তনকে প্রস্তাবিত ব্যাখ্যা থেকে আলাদা করা হয়েছে কি না। পর্যালোচক প্রথম দেখায় report পেশাদার লাগে কি না শুধু তা নয়, কতটা সংশোধন করতে হয়েছে তাও লিখবেন।
ছোট ব্যবসা সবচেয়ে কঠিন benchmark জেতার চেয়ে এমন বিশ্লেষণ নিয়মিত করাকে বেশি গুরুত্ব দিতে পারে, যা অন্যথায় তাদের সাধ্যের বাইরে। ব্যাপক গ্রহণের একটি সম্ভাব্য পথ এটি। Output যথেষ্ট নির্ভুল হয়, সময়ে আসে এবং মালিক নিজে কাজটি করলে যতটা শ্রম লাগত তার চেয়ে কম লাগে—তখনই তা বাস্তব হয়।
Professional benchmark-এর label-কে পেশাগত যোগ্যতা ভাবা উচিত নয়। Legal-work বা clinical-reasoning ফল ওই মূল্যায়নে model-এর কাজ বর্ণনা করে; কোনো মক্কেলের আইনি বিষয় নিজে সামলানো বা রোগীর চিকিৎসার সিদ্ধান্ত নেওয়া প্রতিষ্ঠা করে না। ওই সিদ্ধান্তে Grok ব্যবহার করার সুপারিশ এই নিবন্ধে নেই।
## সুরক্ষার দাবিও প্রেক্ষাপটে বিচার করতে হবে
SpaceXAI-র বক্তব্য, Grok 4.7-এ নতুন safeguard stack এবং jailbreak ঠেকানোর ক্ষমতা বেড়েছে। এটি launch-এর দাবি, model ব্যবহার করা প্রতিটি application নিরাপদ—তার নিশ্চয়তা নয়। [নির্মাতার নিরাপত্তা-বিবরণ](https://x.ai/news/grok-4-7)
ব্যবসায়িক agent-এর অন্তত দুটি প্রশ্ন থাকে। Model যে request পায় তাতে যথাযথ সাড়া দেয় কি? আর application model আসলে কী করতে পারে তা সীমাবদ্ধ রাখে কি?
গ্রাহকের নথি বদলানোর নির্দেশ model সঠিক বুঝলেও তার অনুমতি না-ও থাকতে পারে। আবার, সারসংক্ষেপ করতে দেওয়া নথির মধ্যেই ক্ষতিকর নির্দেশ থাকতে পারে। Access control ও অনুমোদনের নিয়ম চারপাশের ব্যবস্থায় থাকতে হবে; model-এর উন্নত refusal আচরণ তার বিকল্প নয়।
ব্যবহারিক শিক্ষা হলো পুরো কর্মপ্রবাহ পরীক্ষা করা। যেসব বৈধ request সফল হওয়া উচিত, যেসব নিষিদ্ধ কাজ ঠেকানো উচিত এবং যেসব অস্পষ্ট ক্ষেত্রে ব্যাখ্যা চেয়ে থামা উচিত—সব রাখুন। নিরীহ কাজ বারবার প্রত্যাখ্যান করা পণ্য অচল করতে পারে; অননুমোদিত পদক্ষেপ নেওয়া তার চেয়েও খারাপ। একটি headline score-এ কোনোটিই ধরা পড়ে না।
## ভিডিওতে যেসব প্রশ্ন অমীমাংসিত থাকে
Berman-এর আলোচনা কয়েকটি প্রশ্ন তোলে, যেগুলো প্রশ্ন হিসেবেই রাখা উচিত। উপলভ্য compute-এর সঙ্গে দাম যুক্ত করে তাঁর ব্যাখ্যা বাজার-সংক্রান্ত ধারণা, প্রকাশিত unit-cost হিসাব নয়। সামাজিক মাধ্যম নিয়ে তাঁর পূর্বাভাস প্রত্যাশা, ইতিমধ্যে পাওয়া ফলের প্রমাণ নয়। শেষের demo তুলনায় কোন setting ব্যবহার হয়েছে তিনি জানেন না বলেও স্বীকার করেন। [দামের আলোচনা, ৮:৪৪ মিনিটে](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s), [প্রত্যাশা, ১১:৫১ মিনিটে](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s) এবং [demo-র আলোচনা, ১৫:২০ মিনিটে](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
ভিডিওতে open-weight model নিয়েও কথা আছে। প্রতিযোগিতার ওই বৃহত্তর প্রবণতাকে Grok 4.7-এর license-এর সঙ্গে গুলিয়ে ফেলা উচিত নয়: Artificial Analysis এই release-কে proprietary বলেছে এবং weights না পাওয়ার কথা তালিকাভুক্ত করেছে। [Grok 4.7 release profile](https://artificialanalysis.ai/models/releases/grok-4-7)
এ পার্থক্যগুলো মূল্যায়নকে নির্দিষ্ট রাখে। সরবরাহকারী কেন দাম বেছেছেন তা জনসাধারণ না জেনেও পণ্যের দাম আকর্ষণীয় হতে পারে। চমকপ্রদ ব্যর্থ প্রদর্শনী পুনরায় পরীক্ষা করার মতো কিছু দেখাতে পারে, কিন্তু তাতে model সাধারণভাবে খারাপ প্রমাণ হয় না। Model পাওয়া গেলেও প্রতিষ্ঠাতার আগের পূর্বাভাসের সমান ফল দিতে হবে না।
পৃষ্ঠপোষকতার একটি সীমাও আছে। Berman-এর ভিডিওতে Zapier-এর বিজ্ঞাপন রয়েছে। এটি Grok-এর ফলাফলের স্বাধীন প্রমাণ নয়; এর প্রচারমূলক দাবিও BIG CHANGE-এর সুপারিশ নয়।
## আরও ভালো কেনার মাপকাঠি: গৃহীত কাজপ্রতি খরচ
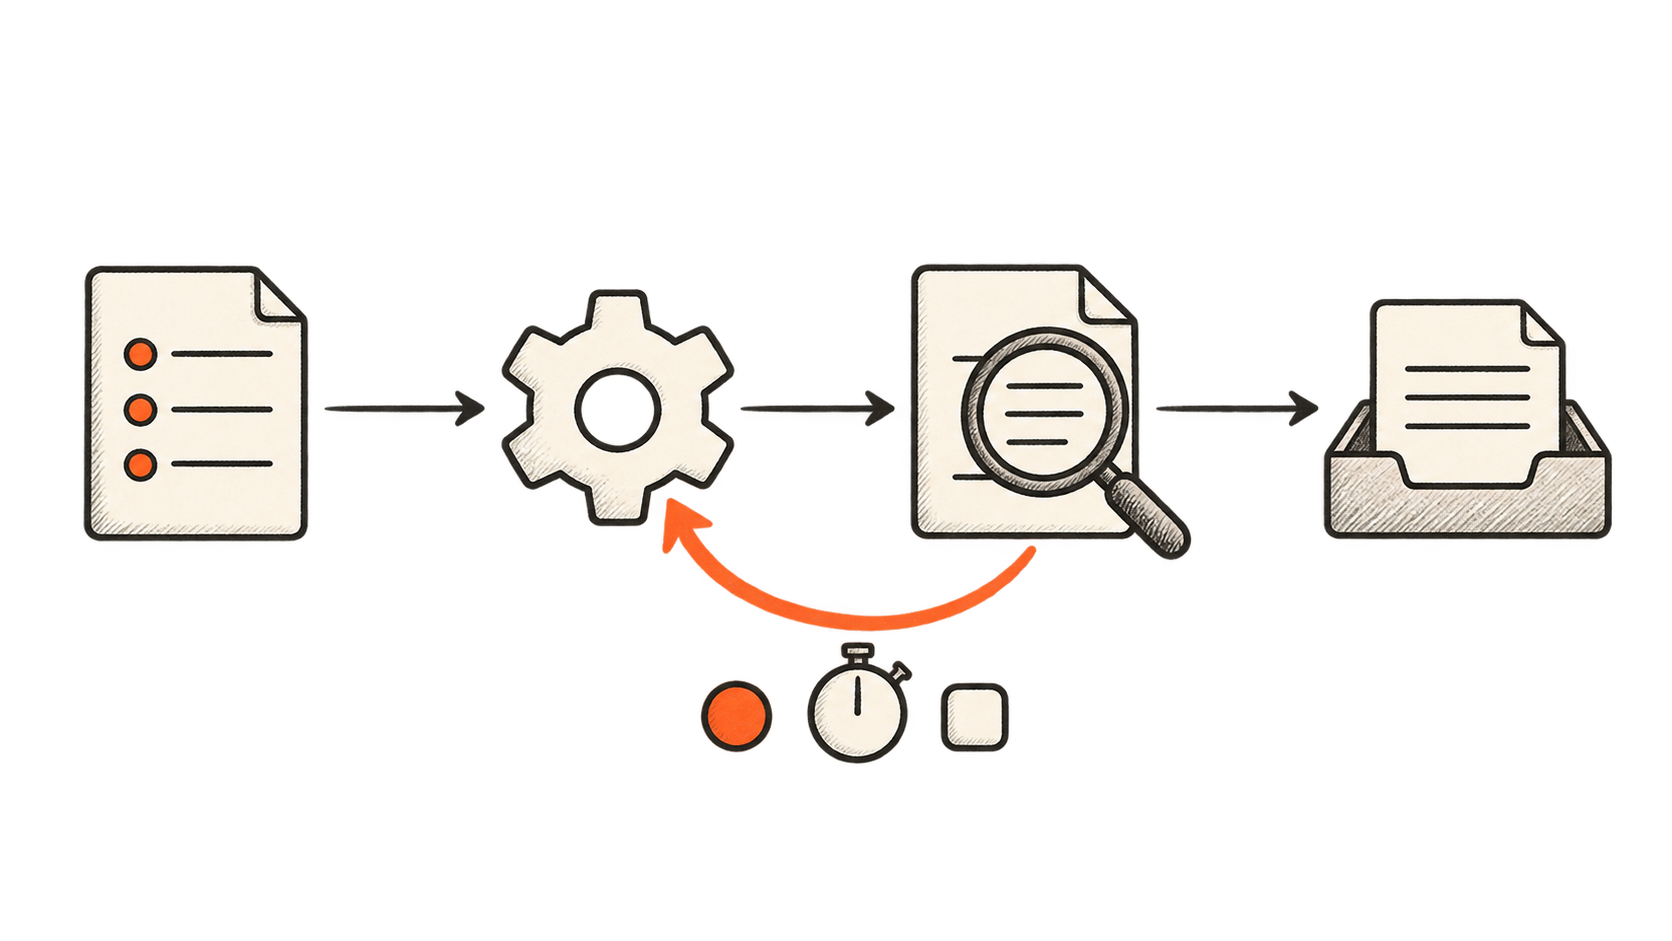
Grok 4.7 বিবেচনাকারী দলের উচিত ছোট কিন্তু প্রতিনিধিত্বশীল কাজের নমুনায় বর্তমান প্রক্রিয়ার সঙ্গে তুলনা করা। Output দেখার আগেই গ্রহণযোগ্যতার শর্ত ঠিক করুন। Coding-এর ক্ষেত্রে প্রাসঙ্গিক test, পড়তে সুবিধাজনক patch এবং সম্পর্কহীন পরিবর্তন না থাকা এতে পড়তে পারে। বিশ্লেষণের ক্ষেত্রে সঠিক হিসাব ও গুরুত্বপূর্ণ দাবির প্রমাণ লাগতে পারে।
তারপর পুরো বিল নথিবদ্ধ করুন: input ও output ব্যবহার, tool, retry এবং ফল পর্যালোচনা বা মেরামতে লাগা সময়। ব্যর্থ চেষ্টা-সহ সব গুনুন। গ্রহণযোগ্যতার শর্ত পূরণ করা deliverable-এর সংখ্যা দিয়ে সেই মোট খরচ ভাগ করুন।
একটি কাল্পনিক উদাহরণে পার্থক্যটি বোঝা যায়। একটি configuration এক batch-এ $20 খরচ করে এবং ৮০টি গৃহীত ফল দেয়। মানুষের শ্রমের আগে গৃহীত ফলপ্রতি খরচ $0.25। অন্যটি $12 খরচ করে, কিন্তু গৃহীত ফল ৩০টি; ফলে প্রতিটি $0.40। সস্তা batch-টিই ব্যবহারযোগ্য কাজের বেশি খরচের উৎস। এগুলো কাল্পনিক সংখ্যা, Grok-এর মাপা ফল নয়।
Reasoning effort-ও পরীক্ষার অংশ হওয়া উচিত। কঠিন কাজে high-effort setting তার খরচ পুষিয়ে দিতে পারে, নিয়মিত কাজে তেমন না-ও পারে। শুধু প্রয়োজনীয় ক্ষেত্রেই effort বাড়ানো সব request xhigh-এ চালানোর চেয়ে সাশ্রয়ী হতে পারে—যদি কোনটিতে বাড়াতে হবে সেই সিদ্ধান্তটিও মূল্যায়ন করা হয়।
Model ভেদে review-এর মান একই রাখুন। সস্তা model-এর জন্য মান কমালে খারাপ কাজ মেনে নিয়ে কৃত্রিম সাশ্রয় দেখা যায়। বর্তমান model-এর জন্যই শুধু মান বাড়ালে উল্টো বিকৃতি আসে। লক্ষ্য হলো নির্ভরযোগ্য ফল কেনা এবং মানুষকে এখনও কী করতে হয় তার স্পষ্ট হিসাব রাখা।
## যে পরিবর্তনটির দিকে নজর রাখবেন
Grok 4.7 পরীক্ষা করার জন্য দলগুলোর হাতে আরেকটি বিকল্প। সেটি বাছতে পুরো কাজ দেখতে হবে: model কী তৈরি করে, কী খরচ করে এবং মানুষকে এখনও কী মেরামত করতে হয়।
দৈনন্দিন কাজে বেছে বেছে আরও AI ব্যবহারের সম্ভাবনা আছে। নিয়মিত বিশ্লেষণে এক configuration, কঠিন coding-এ আরেকটি এবং বিচার বা জবাবদিহি অর্পণ করা যায় না এমন ক্ষেত্রে মানুষ—এভাবে দল বেছে নিতে পারে। বাড়তি প্রতিযোগিতা পরীক্ষার আরেকটি পথ দেয়; কোনটি জিতবে তা নির্ধারণ করে না।
BIG CHANGE-এর কাছে পরবর্তী মাইলফলক হলো কম মোট শ্রমে মাপা যায় এমন কাজ সম্পন্ন করা। Grok 4.7 গৃহীত deliverable-এর খরচ কমালে আরও প্রতিষ্ঠানের জন্য উপকারী automation সহজলভ্য হতে পারে। বাড়তি reasoning যদি শুধু token-এর দাম থেকে খরচকে ব্যবহৃত token-এর পরিমাণে সরিয়ে দেয়, headline price ক্রেতাকে সামান্যই জানাবে। উত্তর দেবে শেষ হওয়া কাজের প্রমাণ—প্রথমে ব্যর্থ হওয়াগুলোসহ।
## Sources
- [Matthew Berman: Grok 4.7 নিয়ে কী ভাবব বুঝতে পারছি না…](https://www.youtube.com/watch?v=MJllZbpvrAc) — ২২ সেপ্টেম্বর ২০২৬। এই বিশ্লেষণের সূত্র হওয়া ভিডিও। সময়-চিহ্নিত link-এ আলোচিত অংশ চিহ্নিত; Berman তাঁর মূল্যায়নকে প্রাথমিক বলেছেন। sponsorship অংশ model-সংক্রান্ত প্রমাণ থেকে আলাদা।
- [Grok 4.7 পরিচিতি](https://x.ai/news/grok-4-7) — ২১ সেপ্টেম্বর ২০২৬। SpaceXAI-র ঘোষণা ও interactive benchmark chart। ফল বিক্রেতার নিজস্ব; effort setting বিবেচনা করা দরকার, এগুলো সর্বজনীন ranking নয়।
- [xAI developer release note](https://docs.x.ai/developers/release-notes) — ২১ সেপ্টেম্বরের entry-তে প্রাপ্যতা, context, effort setting এবং সাধারণ ও দীর্ঘ-context API rate প্রতিষ্ঠিত হয়। ২২ সেপ্টেম্বর যাচাই; দাম ও পণ্য-প্রবেশ বদলাতে পারে।
- [Grok 4.7 পণ্যের নথি](https://docs.x.ai/developers/grok-4-7) — সাধারণ model ও Fast serving option ব্যাখ্যা করে। Fast-এর প্রাপ্যতা সাধারণ API model-এর চেয়ে সীমিত; তাই প্রদর্শনী ও বাজেটে tier নির্দিষ্ট করা দরকার।
- [Grok 4.7 model-এর দাম](https://docs.x.ai/developers/models/grok-4.7) — Model-এর rate card এবং ২০০,০০০ token ছাড়ানো prompt-এ উচ্চ দামের সীমা। শুধু token-এর দাম retry, tool ও মানুষের review বাদ দেয়।
- [Cursor-এর Grok 4.7 নথি](https://prod.cursor.com/docs/models/grok-4-7) — Cursor-এর standard context window-কে তার সর্বোচ্চ সীমা থেকে আলাদা করে। পণ্যের setting অন্তর্নিহিত API সক্ষমতার থেকে ভিন্ন হতে পারে।
- [Artificial Analysis: Grok 4.7-এর benchmark](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — ২১ সেপ্টেম্বর ২০২৬। Token ব্যবহার ও জ্ঞানভিত্তিক কাজের আলোচনা-সংক্রান্ত স্বাধীন পরীক্ষা। প্রতিবেদন standardized evaluation-কে native-agent ফল থেকে আলাদা করে; দুই setup মেশানো উচিত নয়।
- [Artificial Analysis: Grok 4.7 release profile](https://artificialanalysis.ai/models/releases/grok-4-7) — Release-টির proprietary license ও weights না পাওয়ার কথা চিহ্নিত করে। ভিডিওতে আলোচিত open-weight প্রতিযোগিতা থেকে model-টি open-weight—এমন প্রমাণ মেলে না।
- [Cursor এখন SpaceX-এর অংশ](https://cursor.com/blog/joining-spacex) — ১৪ আগস্ট ২০২৬। Cursor অধিগ্রহণের ঘোষণা একই কর্পোরেট পরিবারের মধ্যে প্রচারিত benchmark মূল্যায়নের প্রেক্ষাপট দেয়।
BIG CHANGE নিউজলেটার
বড় ছবিটা। আপনার গতিতে।
এআই ও রোবোটিক্স নিয়ে সাম্প্রতিক খবর, নজর রাখার মতো পরিবর্তন এবং কাজে লাগানোর ব্যবহারিক ধারণা। দৈনিক ব্রিফিং, সাপ্তাহিক সংকলন বা মাসিক দৃষ্টিভঙ্গি বেছে নিন।
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
আপনার গোপনীয়তা, আপনার পছন্দ।
প্রয়োজনীয় স্টোরেজ সাইটের নিরাপত্তায় সাহায্য করে এবং আপনার পছন্দ মনে রাখে। আপনি অনুমতি না দেওয়া পর্যন্ত ঐচ্ছিক Google Analytics বন্ধ থাকবে। প্রয়োজনীয় স্টোরেজ ব্যবহার করেই প্রতিটি গল্প পড়তে পারেন। গোপনীয়তার বিবরণ