AI-translated from English; not yet reviewed by a fluent editor.
# KI-Programmierung macht zuverlässige Auslieferung zur nächsten Herausforderung im Engineering
> Wenn KI die Menge des erzeugten Codes steigert, müssen Engineering-Verantwortliche erkennen, wo Änderungen warten, was die Validierung kostet und ob veröffentlichte Software wie beabsichtigt funktioniert.
By BIG CHANGE Editorial
Published: 2026-09-22T05:31:05.772Z
Updated: 2026-09-22T05:31:05.772Z
Canonical: https://bigchange.ai/blog/ai-coding-ci-bottleneck-dependable-delivery
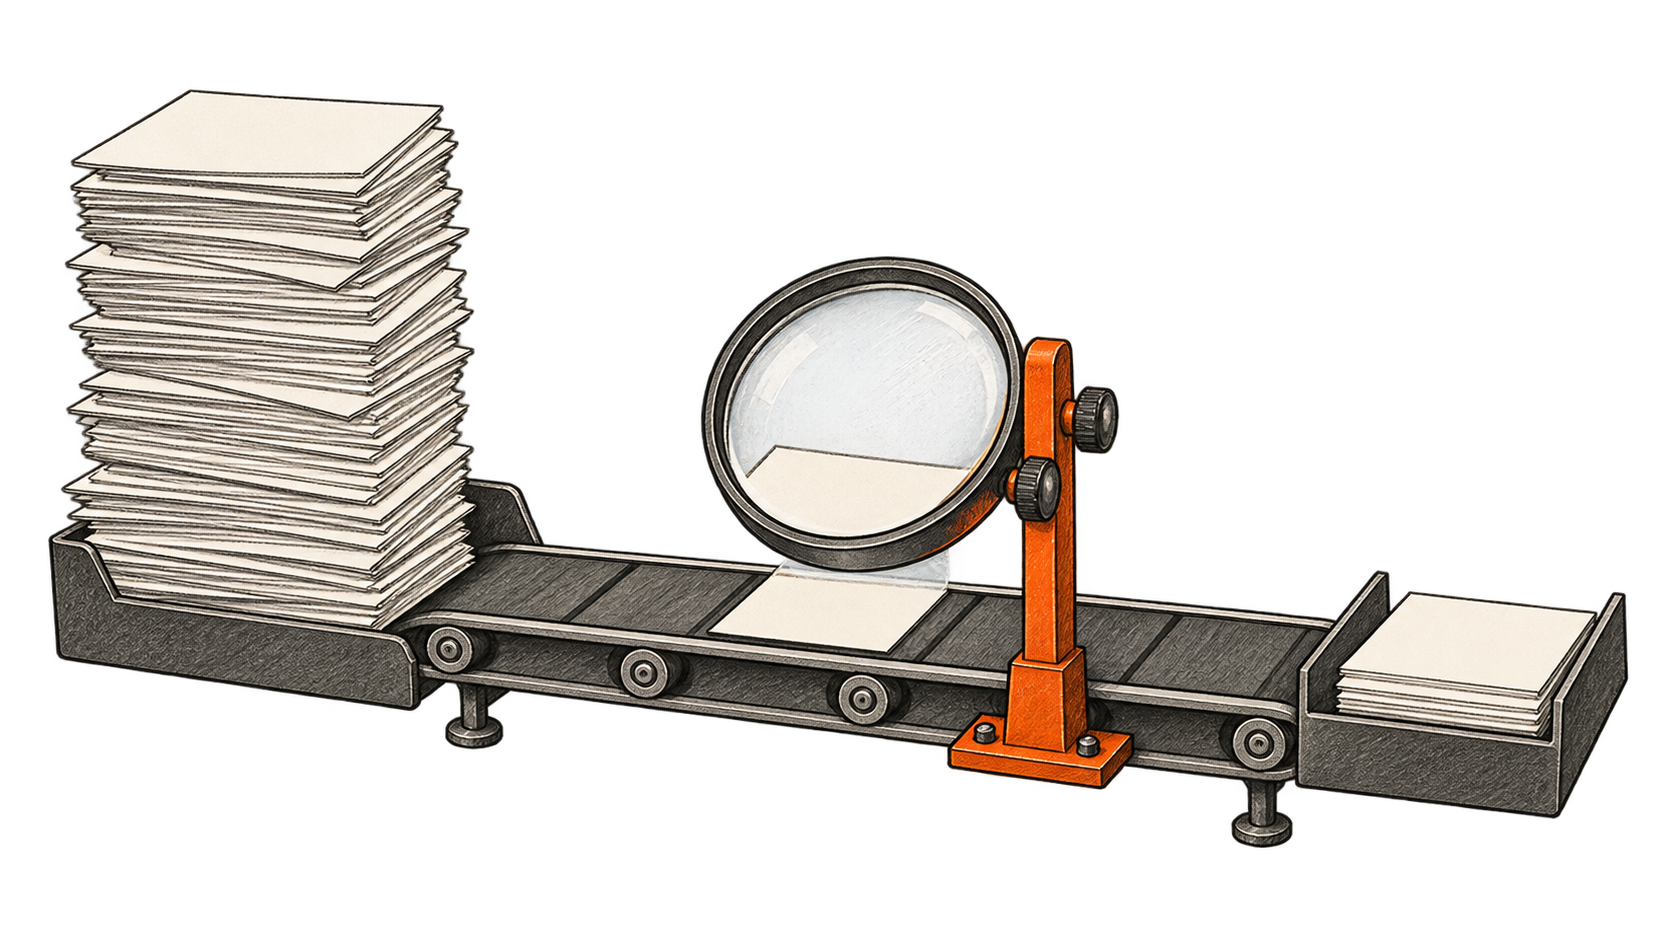
AI-generated conceptual illustration by BIG CHANGE. More proposed changes can put pressure on validation. Conceptual illustration of a queue and inspection stage; stack sizes are not measurements, and passing checks does not guarantee dependable delivery.
Ein KI-Programmieragent kann einen Patch fertigstellen, während die Prüfungen des vorherigen noch laufen. Für eine Engineering-Leitung entsteht dadurch ein unangenehmer Unterschied: Das Team hat mehr Code produziert, aber beim Kunden ist noch nichts angekommen.
Linear liefert ein anschauliches Beispiel. In einem Engineering-Bericht vom 21. September schreibt Mufeez Amjad, dass sich die Test-Suiten seit Anfang 2026 fast vervierfacht haben, während die Wartezeit von Pull Requests auf Continuous Integration von über sechs auf etwas mehr als fünf Minuten sank. Die Runner-Zeit je Test halbierte sich ungefähr. Das sind getrennte Verbesserungen; die letzte Zahl bedeutet nicht, dass sich die gesamten CI-Kosten halbiert haben. Linear führt den wachsenden Validierungsdruck auf die Entwicklung mit Agenten zurück. Der Bericht ist jedoch kein kontrolliertes Experiment, das einen Produktivitätseffekt von KI nachweist. [Engineering-Bericht von Linear](https://linear.app/now/ci-bottleneck-reworked).
Continuous Integration, kurz CI, führt automatisierte Prüfungen für vorgeschlagene Softwareänderungen aus. Sie liegt zwischen einem plausiblen Patch und einer Änderung, die ein Team freigeben kann. Steigert KI-Programmierung die Zahl der Patches, wird die Prüfkapazität zur geschäftlichen Frage: Wie viel nützliche Arbeit kann die Organisation sicher aufnehmen?
Unserer Ansicht nach sollten Führungskräfte drei Ergebnisse gemeinsam sichtbar machen: die Zeit bis zu verlässlichem Feedback, den gesamten Rechenaufwand und die Zuverlässigkeit veröffentlichter Änderungen. Eine schnellere Antwort ist nur dann wertvoll, wenn das Team versteht, was sie aussagt.
## Kürzere Wartezeiten können mehr Arbeit erfordern
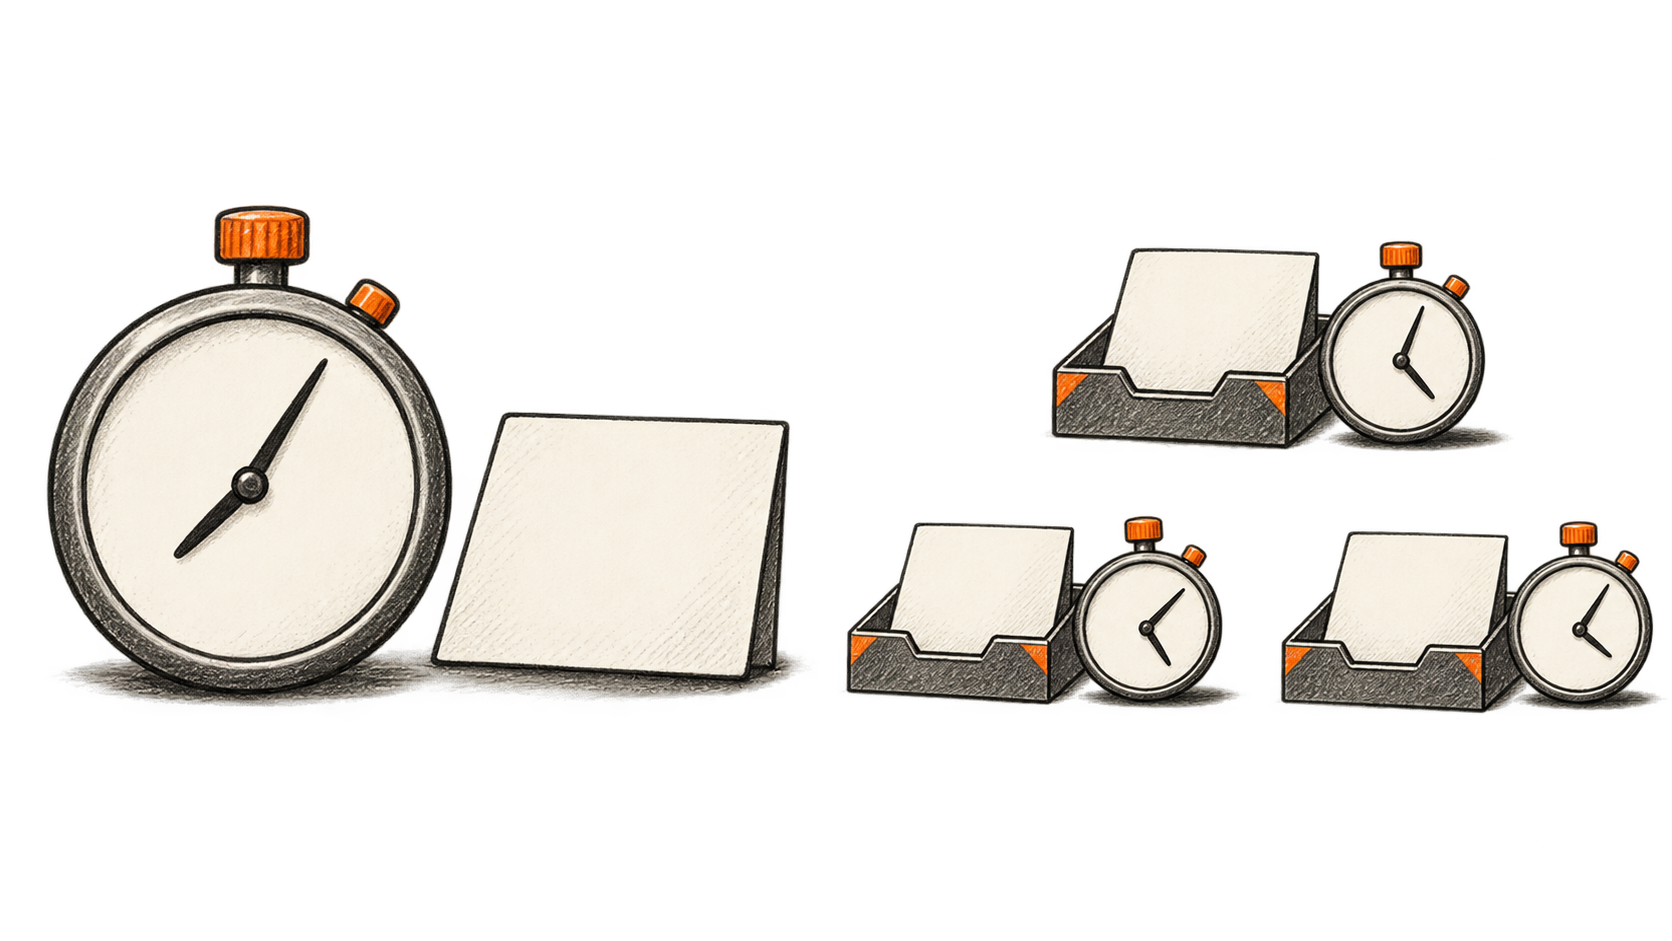
Stellen wir uns eine Testsuite vor, die auf einem Rechner zwölf Minuten Arbeit erfordert. Wird sie gleichmäßig auf vier Rechner verteilt, könnte sie in drei Minuten fertig sein. Dieses hypothetische Beispiel setzt eine perfekte Aufteilung voraus und lässt alles Weitere außer Acht. Insgesamt verrichten die Rechner weiterhin zwölf Minuten Arbeit.
Benötigt jeder Rechner nun eine Minute Vorbereitung, dauert die Variante mit vier Rechnern insgesamt vier Minuten und verbraucht 16 Runner-Minuten. Die Variante mit einem Rechner dauert 13 Minuten und verbraucht 13 Runner-Minuten. Die Wartezeit sinkt deutlich, während der Gesamtverbrauch an Rechenzeit steigt. Die tatsächlichen Kosten hängen außerdem von den Runner-Typen, Preisen und Abrechnungsregeln ab.
Der Unterschied ist wichtig, wenn ein Dashboard einen kürzeren grünen Balken feiert. Wer parallele Kapazität einkauft, bezahlt für früheres Feedback – möglicherweise gegen Aufpreis. Das kann ein ausgezeichneter Tausch sein, wenn dadurch ein echter Engpass verschwindet. Schwerer zu rechtfertigen ist es, wenn die fertig geprüfte Änderung anschließend stundenlang auf eine verfügbare prüfende Person wartet.
Die Betrachtung sollte über einen einzelnen CI-Lauf hinausgehen. Ein Patch, der wiederholte Überarbeitungen, erneute Läufe und eine zweite Prüfrunde auslöst, kann deutlich mehr Aufwand verursachen, als sein schnellster einzelner Lauf vermuten lässt. Zählen Sie alle Versuche, die bis zur Freigabe nötig waren, einschließlich abgebrochener Versuche. Andernfalls kann eine scheinbar effiziente Pipeline einen teuren Entwicklungsprozess verschleiern.
Auch ist nicht jede Warteminute gleichbedeutend mit Arbeitskosten. Wer während laufender Prüfungen eine andere sinnvolle Aufgabe beginnt, hat nicht zwangsläufig das gesamte Zeitfenster verloren. Wiederholte Unterbrechungen und die Rückkehr zu unerledigter Arbeit können trotzdem schaden. Um diese Effekte zu messen, muss man die Arbeitsweise des Teams beobachten, statt die verstrichenen Minuten mit den Gehältern zu multiplizieren.
## Die Forschung zeichnet ein gemischtes Bild
Die Analyse von DORA vom März 2026 berichtet über zwei unterschiedliche Evidenzbestände. In der Studie von 2025 war eine höhere KI-Nutzung sowohl mit mehr Durchsatz bei der Softwareauslieferung als auch mit größerer Instabilität verbunden. Davon getrennt analysierten Forschende 1.110 offene Antworten von Google-Ingenieuren aus dem dritten Quartal 2025. Die Ingenieure berichteten sowohl von Unterstützung beim Entwerfen und anderen Aufgaben als auch von zusätzlichem Prüfaufwand. Die interne qualitative Studie ist nicht die Datengrundlage des breiteren DORA-Zusammenhangs; keine der beiden Untersuchungen belegt, dass KI die Release-Probleme eines bestimmten Teams verursacht hat. [DORA-Analyse und Methodik](https://dora.dev/insights/balancing-ai-tensions/).
Es gibt zudem aussagekräftigere experimentelle Belege mit engerem Geltungsbereich. In einer randomisierten Studie von METR aus dem Juli 2025 wurden 246 Aufgaben auf 16 erfahrene Entwickler von Open-Source-Software verteilt, die in vertrauten Repositorien arbeiteten. Mit den damals verfügbaren KI-Werkzeugen brauchten sie 19 Prozent länger. Die Teilnehmenden glaubten dennoch, dass KI ihnen geholfen habe, schneller zu arbeiten. Der Befund gilt für diese Entwickler, Aufgaben und Werkzeuge; er entscheidet nicht über den Nutzen aller heute verfügbaren Programmieragenten. [Ursprüngliches Experiment von METR](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/).
Im Februar 2026 erklärte METR, eine Folgestudie habe keine verlässliche Schätzung zu den aktuellen Produktivitätseffekten ergeben. Entwickler lehnten zunehmend Aufgaben ohne KI ab oder wählten selbst aus, welche Aufgaben sie einreichten; parallel laufende Agenten erschwerten zudem die Zeitmessung. Die Forschenden hielten eine stärkere Beschleunigung für plausibel, sahen in den Daten aber nur schwache Belege für deren Ausmaß. Die frühere Verlangsamung ohne diesen Vorbehalt zu wiederholen, würde Leser irreführen. [Folgestudie von METR](https://metr.org/blog/2026-02-24-uplift-update/).
Für Führungskräfte begründen diese Studien eine praktische Haltung: Behalten Sie nützliche Werkzeuge bei, untersuchen Sie ihre Auswirkungen und machen Sie weder Begeisterung noch Skepsis zur universellen Personalformel. Bei einer Art von Arbeit kann ein Team erheblich profitieren, bei einer anderen Zeit verlieren. Der Auslieferungsprozess sollte diesen Unterschied sichtbar machen.
## Geben Sie jedem Engpass eine eigene Lösung
Bevor Sie zusätzliche CI-Kapazität kaufen, verfolgen Sie eine Änderung vom ersten vorgeschlagenen Patch bis zur Produktionsumgebung. Unterscheiden Sie zwischen Arbeit, die ausgeführt wird, und Arbeit, die wartet. Finden Sie heraus, welche Prüfung eine Entscheidung tatsächlich verzögert, wessen Prüfung erforderlich ist und welche Freigabebedingungen danach noch gelten.
Schon eine einfache Zeiterfassung reicht oft aus, um eine Fehlinvestition aufzudecken. Entsteht die meiste Verzögerung, bevor die Prüfung beginnt, beheben ein paar Sekunden schnellere Tests das Problem nicht. Warten Prüfende wiederholt auf eine lange vorgeschriebene Prüfung, gibt es einen klaren Grund, genau diese zu verbessern. Treten Fehler hauptsächlich erst nach der Bereitstellung auf, sollte das Team untersuchen, was die Validierung übersieht.
Das Zwischenspeichern von Abhängigkeiten zeigt, warum eine vertraute Optimierung gemessen werden muss. GitHub beschreibt Caching als Möglichkeit, Dateien wiederzuverwenden, deren Neuerstellung auf sauberen Runnern kostspielig ist. Zugleich weist GitHub darauf hin, dass Aufträge diese Dateien auch dann neu erstellen oder herunterladen können müssen, wenn der Cache nicht verfügbar ist. Das Cache-Verhalten sollte daher sowohl bei Treffern als auch bei Fehlschlägen bewertet werden. [Dokumentation von GitHub zum Zwischenspeichern von Abhängigkeiten](https://docs.github.com/en/actions/concepts/workflows-and-actions/dependency-caching).
Für Führungskräfte lautet die entscheidende Frage, wie vorhersehbar das Feedback wird. Ein sehr guter Durchschnitt kann gelegentliche Wartezeiten verbergen, die eine Veröffentlichung aus dem Takt bringen. Verfolgen Sie auch das langsame Ende der Verteilung und unterscheiden Sie einen berechtigten Testfehler von einem fehlgeschlagenen Download oder einem ausgeschöpften Runner. Für jeden Fall ist eine andere Reaktion nötig.
Zuverlässiges, zeitnahes Feedback gibt Menschen und Agenten früher Gelegenheit, Fehler zu korrigieren. Verbesserungen an dieser gemeinsamen Infrastruktur können viele Arten der Entwicklung unterstützen, auch Änderungen ohne KI. Das ist ein Grund, sie zu finanzieren, selbst wenn sich die eingesetzten Programmierwerkzeuge ändern.
## Schnellere Tests müssen weiterhin Fehler finden
Manche Leistungsoptimierungen verändern die Bedingungen, unter denen Tests ausgeführt werden. Das verdient mehr Aufmerksamkeit als ein schnellerer Prozessor.
Vitest, ein Testwerkzeug für JavaScript und TypeScript, isoliert Testdateien standardmäßig, damit der Zustand einer Datei keine andere beeinflusst. Die Dokumentation beschreibt, dass die Isolation für geeignete Tests gezielt aufgehoben werden kann; veränderlicher Modulzustand, geänderte globale Variablen und andere Abhängigkeiten sprechen jedoch dafür, sie beizubehalten. Eine Einstellung, die die Vorbereitungszeit verkürzt, kann somit eine Grenze für die Korrektheit verändern. [Hinweise von Vitest zur Isolation](https://vitest.dev/guide/recipes/disable-isolation).
Linear setzte für gemeinsam genutzten Zustand auf ein Opt-in-Verfahren, ergänzte Bereinigungsroutinen und behielt die Isolation für Dateien bei, die sich nicht sicher umstellen ließen. Der Leistungsvorteil hing davon ab, zu entscheiden, welche Tests ihre Umgebung sicher gemeinsam nutzen konnten. [Umsetzung bei Linear](https://linear.app/now/ci-bottleneck-reworked).
Eine zusätzliche Herausforderung entsteht, wenn ein Agent sowohl eine Änderung als auch deren Tests schreibt. Stellen wir uns hypothetisch eine Rabattregel vor, die nur für Jahresabonnements gilt. Ein Agent könnte sie irrtümlich auch für Monatsabonnements umsetzen und anschließend Tests verfassen, die seine eigene Auslegung bestätigen. Erfolgreiche Tests würden dann nur die Konsistenz des Fehlers belegen.
Prüfende brauchen Belege, die unabhängig von dieser Umsetzung sind: die vereinbarte Anforderung, Beispiele für das beabsichtigte Verhalten und Fälle, die fehlschlagen sollten. Einen Agenten um weitere Tests zu bitten, kann helfen; eine größere Zahl von Tests zeigt allein jedoch nicht, dass eine missverstandene Anforderung infrage gestellt wurde. Menschen müssen hier entscheiden, was die Software tun soll und ob die Belege diese Frage beantworten.
Teams, die Testumfang belohnen, ohne zu prüfen, was die Tests tatsächlich belegen, riskieren, Prüfenden mehr Material und zugleich weniger Sicherheit zu geben. Führungskräfte sollten dafür bei der Arbeitsverteilung Zeit einplanen, statt es als unerklärliche Verzögerung zu behandeln, nachdem der Agent fertig ist.
## Messen Sie die Änderung, die bei Kunden ankommt
Die Auslieferungskennzahlen von DORA bieten eine sinnvolle nachgelagerte Kontrolle. Sie umfassen die Zeit vom eingecheckten Code bis zur Produktionsumgebung, die Häufigkeit von Bereitstellungen, die Wiederherstellungszeit nach einer fehlgeschlagenen Bereitstellung, den Anteil der Bereitstellungen, die sofortiges Eingreifen erfordern, und den Anteil ungeplanter, durch Vorfälle bedingter Nacharbeiten. Diese Kennzahlen beschreiben Auslieferungsergebnisse jenseits eines erfolgreichen Testlaufs. [Definitionen der DORA-Kennzahlen](https://dora.dev/guides/dora-metrics/).
Für ein Team, das seinen KI-Programmierablauf untersucht, würden wir diese Ergebnisse mit einer kleinen diagnostischen Erfassung ergänzen:
- Feedback: verstrichene Zeit bis zum Abschluss der erforderlichen Prüfungen, einschließlich langsamer Läufe und Wartezeit auf Kapazität.
- Verbrauch: gesamter Runner-Aufwand und wiederholte Versuche für eine freigegebene Änderung.
- Prüfung: Wartezeit auf Rückmeldung, umfangreiche angeforderte Überarbeitungen und deren jeweiliger Grund.
- Auswirkung auf Kunden: ob die veröffentlichte Änderung das beabsichtigte Verhalten lieferte und Nachbesserungen erforderte.
Nutzen Sie diese Erfassung, um einen bestimmten Arbeitsablauf zu untersuchen. Eine kleine Dokumentationsänderung und eine Datenbankmigration sind keine gleichwertigen Einheiten der Produktivität. Vergleichen Sie, soweit möglich, ähnliche Arbeiten im Zeitverlauf und halten Sie andere Änderungen fest, etwa einen neuen Runner-Anbieter oder einen überarbeiteten Veröffentlichungsprozess. Eine Verbesserung, die gleichzeitig mit der KI-Einführung auftritt, beweist nicht deren Ursache.
Führungskräfte können dann eine konkrete Entscheidung treffen: Finanzieren Sie den Engpass, der verhindert, dass nützliche Änderungen mit ausreichender Sicherheit bei Kunden ankommen. Manchmal bedeutet das mehr Rechenkapazität. Manchmal braucht es klarere Anforderungen, bessere Tests oder genügend Zeit erfahrener Prüfender, um die bereits eingehenden Vorschläge zu verstehen.
## Sources
- [Linear: KI-Programmierung und der CI-Engpass](https://linear.app/now/ci-bottleneck-reworked) — 21. September 2026. Mufeez Amjads Bericht zur Umsetzung liefert die einleitenden Zahlen und das Beispiel der selektiven Isolation. Messungen aus erster Hand beschreiben Linears System, nicht eine kontrollierte Schätzung der KI-Produktivität oder der Gesamtausgaben.
- [DORA: KI-Zielkonflikte ausbalancieren](https://dora.dev/insights/balancing-ai-tensions/) — 10. März 2026. Trennt den DORA-Zusammenhang aus dem Jahr 2025 von einer qualitativen Analyse der Antworten von Google-Ingenieuren. Die interne Studie berichtet Erfahrungen, keine gemessenen Kausalwirkungen; frühere Fragen könnten die Antworten beeinflusst haben.
- [METR: KI von Anfang 2025 und die Produktivität erfahrener Entwickler](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/) — Randomisiertes Experiment vom 10. Juli 2025 mit vertrauten Open-Source-Repositorien und Werkzeugen von Anfang 2025. Belegt den eingegrenzten Befund der Verlangsamung und die Diskrepanz zur Wahrnehmung. Es ist keine Schätzung für alle Entwickler oder Modelle vom September 2026.
- [METR: Überarbeitung des Experiments zur Entwicklerproduktivität](https://metr.org/blog/2026-02-24-uplift-update/) — Aktualisierung vom 24. Februar 2026. Erläutert die Auswahl von Teilnehmenden und Aufgaben, geänderte Vergütung und Schwierigkeiten bei der Messung paralleler Arbeit. Die Forschenden halten die neue Schätzung für unzuverlässig; wir stellen ihre Rohwerte nicht als aktuelle Beschleunigung dar.
- [GitHub: Zwischenspeichern von Abhängigkeiten](https://docs.github.com/en/actions/concepts/workflows-and-actions/dependency-caching) — Aktuelle Dokumentation, abgerufen am 22. September 2026. Beschreibt die Wiederverwendung auf sauberen Runnern und die Notwendigkeit, dass Aufträge auch ohne Cache funktionieren. Sie belegt weder die Leistung noch die Kosten eines bestimmten Repositoriums.
- [Vitest: Isolationseinstellungen pro Testdatei](https://vitest.dev/guide/recipes/disable-isolation) — Aktuelle Dokumentation, abgerufen am 22. September 2026. Erläutert die standardmäßige Isolation, gezielte Konfiguration und Zustandsabhängigkeiten, die Schutz erfordern. Die technische Anleitung stützt die Abwägung; BIG CHANGE hat weder einen Benchmark ausgeführt noch eine Testsuite geändert.
- [DORA: Kennzahlen zur Softwareauslieferung](https://dora.dev/guides/dora-metrics/) — Aktualisiert am 5. Januar 2026. Definiert fünf Auslieferungskennzahlen und ihre Anwendung auf Service-Ebene. Sie ergänzen die CI-Dauer um Ergebnismaße; die diagnostischen Beispiele im Artikel sind eine Analyse und keine Ergebnisse eines neuen Experiments.
Der Newsletter von BIG CHANGE
Das große Ganze. In Ihrem Tempo.
Aktuelle Storys über KI und Robotik, beobachtenswerte Veränderungen und praktische Ideen zur Anwendung. Wählen Sie ein tägliches Briefing, eine wöchentliche Zusammenfassung oder eine monatliche Perspektive.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ihr Datenschutz, Ihre Entscheidung.
Notwendiger Speicher schützt die Website und merkt sich Ihre Einstellungen. Optionales Google Analytics bleibt deaktiviert, bis Sie es erlauben. Sie können alle Geschichten auch nur mit notwendigem Speicher lesen. Datenschutzdetails