AI-translated from English; not yet reviewed by a fluent editor.
# Claude ist zurück. Ihr Unternehmen braucht trotzdem einen Notfallplan
> Der Vorfall bei Claude vom 22. September ist behoben. Dieser praktische Leitfaden zeigt, wie Unternehmen bei eingeschränktem Betrieb weiterarbeiten, unfertige Vorgänge sichern und ihren Rückstand nach einem KI-Ausfall abarbeiten können.
By BIG CHANGE Editorial
Published: 2026-09-22T08:51:37.833Z
Updated: 2026-09-22T08:51:37.833Z
Canonical: https://bigchange.ai/blog/claude-outage-ai-business-continuity
AI-generated conceptual illustration by BIG CHANGE. When an AI service pauses, a business still needs accessible records of unfinished work. The bookmarked ledger represents preserving the stopping place. Conceptual illustration, not evidence of damaged equipment or lost data.
Am 22. September kam es bei Claude über mehrere Modelle hinweg zu erhöhten Fehlerraten. Im abschließenden Vorfallsbericht von Anthropic liegt das Auswirkungsfenster zwischen 00:50 und 02:10 Uhr UTC, also bei 80 Minuten. Um 02:35 Uhr wurde der Vorfall als behoben markiert. Zu den betroffenen Komponenten gehörten claude.ai, die API, Code und Cowork. Dem Bericht zufolge schlug nicht jede Anfrage fehl; eine veröffentlichte Erklärung zur Ursache enthält er nicht. [Vorfallsbericht von Anthropic](https://status.claude.com/incidents/7g1qpkyz5gxh)
Für ein Unternehmen, das KI in einen Arbeitsablauf eingebunden hat, beantwortet die Wiederherstellung des Dienstes nur einen Teil der Fragen. Kundenanfragen können noch offen sein. Vielleicht hat jemand einen Fall manuell weiterbearbeitet, während ein automatisierter Versuch noch lief. Eine Führungskraft muss wissen, welche Arbeit fortgesetzt werden kann und was zuerst geprüft werden muss.
Wenn ein Assistent beim Brainstorming gelegentlich nicht verfügbar ist, ist das lästig. Hilft derselbe Dienst jedoch bei der Kategorisierung eingehender Fälle, beim Formulieren von Antworten und beim Aktualisieren von Datensätzen, wird eine Unterbrechung zum Betriebsproblem. Eine kleine, klare Notfallplanung hilft den Mitarbeitenden, auch ohne Zugriff auf den KI-Dienst weiterzuarbeiten.
Dieser Leitfaden veranschaulicht die mögliche Umsetzung anhand eines hypothetischen Kundenserviceteams. Die Verfahren sind Vorschläge zur Anpassung und zum Einüben. BIG CHANGE hat sie weder getestet noch beschreiben sie Kunden, die von diesem Vorfall betroffen waren.
## Legen Sie fest, welchen Dienst Sie ohne KI aufrechterhalten können
Stellen wir uns einen kleinen Ausrüster vor, dessen Assistent eingehende Supportnachrichten kategorisiert und anhand freigegebener Produktinformationen Antworten vorbereitet. Mitarbeitende prüfen die Antworten vor dem Versand. Das Unternehmen verlässt sich auf das System zur Organisation der Warteschlange, auch wenn weiterhin Menschen für die Antworten verantwortlich sind.
Wenn der Assistent nicht mehr reagiert, muss die Führungskraft zuerst entscheiden, was das Serviceteam noch zusagen kann. Mitarbeitende könnten den Eingang weiter bestätigen und Fälle mit nahen Fristen bearbeiten, während routinemäßige Produkterklärungen warten. Auf die ursprünglichen Nachrichten und freigegebene Referenzmaterialien müssen sie außerhalb des Assistenten zugreifen können. Andernfalls ist „manuell weiterarbeiten“ eine Anweisung ohne die nötigen Mittel.
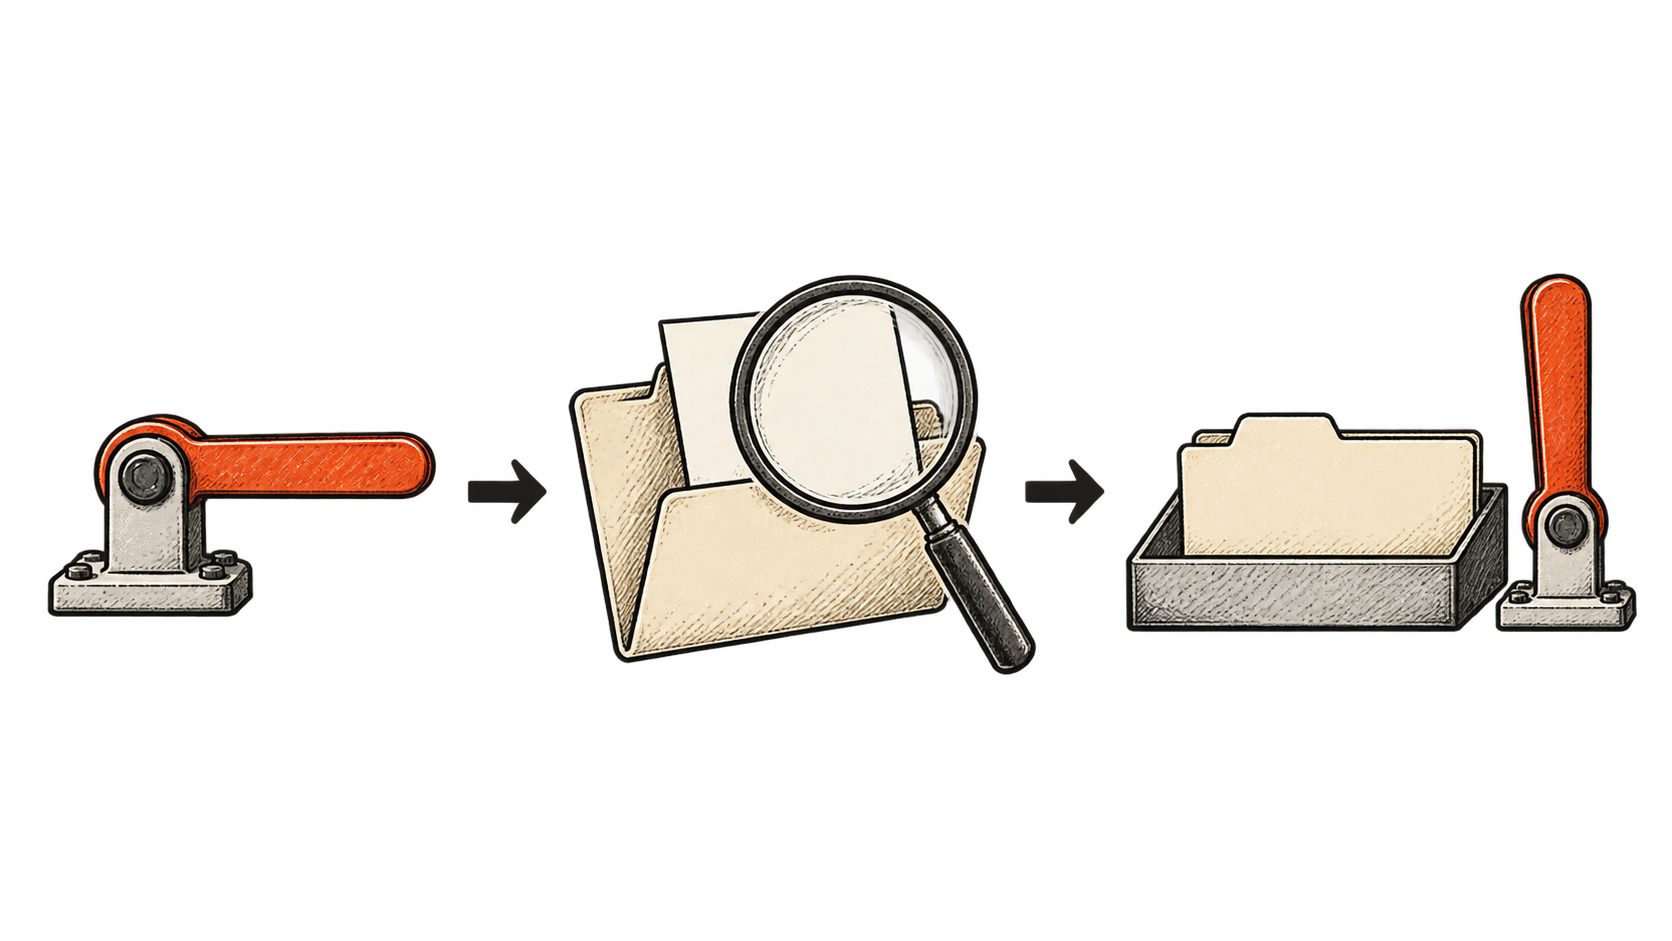
Legen Sie diesen eingeschränkten Betrieb im Voraus fest. Benennen Sie die Person, die ihn aktivieren darf, die zu pausierenden Arbeiten und die Mitarbeitenden, die die verbleibenden Aufgaben übernehmen. Setzen Sie einen Zeitpunkt zur erneuten Prüfung fest, damit eine Übergangslösung nicht unbemerkt den ganzen Nachmittag läuft. Mitteilungen an Kunden sollten die Verzögerung und den verfügbaren Weg für dringende Hilfe erklären und nur Versprechen enthalten, die das Team einhalten kann.
Googles Leitlinien zur Überlastung beschreiben, wie bei knappen Ressourcen eingeschränkte Funktionen bereitgestellt, Zugriffe begrenzt und wichtige Anfragen priorisiert werden können. Das sind bewährte Zuverlässigkeitsverfahren, keine Diagnose dieses Claude-Vorfalls. Auf ein Serviceteam übertragen, sprechen sie dafür, den Leistungsumfang bewusst zu reduzieren, wenn die normale Verarbeitung nicht weiterlaufen kann. [Google SRE: Umgang mit Überlastung](https://sre.google/sre-book/handling-overload/)
Auch der eingeschränkte Dienst braucht eine Kapazitätsgrenze. Zwei Personen können nicht stillschweigend die Arbeitslast eines automatisierten Systems übernehmen, das sonst viel mehr Anfragen bearbeitet. Halten Sie fest, was sie bewältigen können, was warten muss und wann zusätzliche Hilfe nötig wird. Für Kunden ist ein glaubwürdiger Antwortzeitraum hilfreicher als eine automatische Eingangsbestätigung, die den Eindruck eines normalen Betriebs erweckt.
## Halten Sie die Arbeit außerhalb des Gesprächs fest
Das Serviceteam braucht einen Vorgangsdatensatz, auf den es zugreifen kann, während das Modell nicht verfügbar ist. Das kann das bestehende Supportsystem sein. Entscheidend ist, dass das Unternehmen nachvollziehen kann, was geschehen ist, ohne den ausgefallenen Assistenten um eine Rekonstruktion zu bitten.
Halten Sie für jeden Fall die ursprüngliche Anfrage, die zuständige Person oder den verantwortlichen Prozess und die letzte bestätigte Aktion fest. Ein gespeicherter Entwurf ist keine versandte Antwort. Eine vorgeschlagene Änderung an einem Kundendatensatz ist keine vom System bestätigte Änderung. Bewahren Sie die nötigen Nachweise auf, um beides unterscheiden zu können, und wenden Sie dieselben Zugriffsbeschränkungen wie für die zugrunde liegenden Kundendaten an.
Ordnen Sie die Arbeit während einer Unterbrechung diesen praktischen Kategorien zu:
- Noch nicht begonnen: Es wurde noch nichts verarbeitet und keine externe Aktion ausgelöst.
- Teilweise vorbereitet: Eine Kategorisierung oder ein Entwurf liegt vor, aber der nächste Schritt ist noch offen.
- Abgeschlossen und bestätigt: Das Zielsystem verzeichnet die beabsichtigte Aktion.
- Unklar: Eine Aktion wurde versucht, aber die Bestätigung fehlt.
Weisen Sie unklare Fälle einer Person zu, die das betreffende System prüfen kann, bevor die Arbeit fortgesetzt wird. Wenn der Assistent beim Verbindungsabbruch eine Antwort vorbereitete, ist ein neuer Entwurf womöglich unproblematisch. Wenn ein separates Werkzeug die Antwort versendete, könnte die Wiederholung des gesamten Vorgangs sie doppelt verschicken. Diese Unterscheidung gehört in die Arbeitsdokumentation.
Laut Anthropics API-Dokumentation kann eine gestreamte Antwort nach einer anfänglichen HTTP-Erfolgsmeldung 200 noch fehlschlagen. Dass der erste Text erscheint oder dieser Statuscode eintrifft, beweist nicht, dass die vollständige Antwort angekommen ist. Die Integration muss den Abschluss erkennen und Teilergebnisse als unvollständig kennzeichnen. [Claude-API-Fehlerdokumentation](https://platform.claude.com/docs/en/api/errors)
## Begrenzen Sie Wiederholungen und weisen Sie die Verantwortung zu
Ein erneuter Versuch kann einen vorübergehenden Fehler beheben. Er kann die Unsicherheit aber auch verlängern, wenn jede Ebene denselben Auftrag eigenständig wiederholt. Fragen Sie den Softwareanbieter, ob Wiederholungen bereits in dessen Clientbibliothek stattfinden, bevor Sie eine weitere Schaltfläche oder automatische Schleife hinzufügen.
Anthropic dokumentiert in seinen offiziellen SDKs standardmäßig zwei automatische Wiederholungsversuche bei vorübergehenden Fehlern. Die Verzögerung wird dabei verlängert; eine Retry-After-Anweisung wird berücksichtigt. Die Fehlerdokumentation unterscheidet zudem zwischen vorübergehenden Serverproblemen sowie Fehlern bei Authentifizierung, Berechtigung und ungültigen Anfragen. Es ist nicht davon auszugehen, dass dieselbe Anfrage jede Fehlerart behebt. [Dokumentiertes Wiederholungsverhalten von Claude](https://platform.claude.com/docs/en/api/errors)
Für das Serviceteam sollte die Betriebsregel festlegen, wann automatische Versuche enden und wer den Fall anschließend übernimmt. Bewahren Sie die Kennung der Anfrage zur Fehlersuche auf. Mitarbeitende sollten sehen können, ob ein Auftrag wartet, erneut versucht wird oder eine Person übernehmen muss, damit sie nicht unwissentlich konkurrierende Versuche starten.
AWS erklärt, wie eine Aktion erfolgreich ausgeführt werden kann, obwohl ihre Antwort nie eintrifft. Idempotente APIs verwenden eine eindeutige Anfragekennung, um Wiederholungen zu erkennen und zusätzliche Nebenwirkungen zu verhindern. Der empfangende Dienst muss diese Vereinbarung umsetzen; eine interne Fallnummer allein bietet keinen solchen Schutz. [AWS: Wiederholungen sicher gestalten](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/)
Fragen Sie gezielt nach den Aktionen, die Ihr Arbeitsablauf ausführt. Kann ein erneuter Versuch ein weiteres Supportticket erstellen oder eine zusätzliche E-Mail versenden? Wenn Duplikate nicht verhindert werden, muss der Notfallplan vor einem weiteren Versuch eine Prüfung des Zieldatensatzes vorsehen. Eine Textgenerierung zu wiederholen und einen vollständigen Geschäftsvorgang erneut auszuführen, erfordert unterschiedliche Entscheidungen.
## Ein Ausweichmodell braucht einen enger umrissenen Auftrag
Ein alternativer KI-Dienst kann helfen, die Arbeit am Laufen zu halten. Ein zweites Konto ist jedoch erst der Anfang einer Ausweichlösung. Der Ersatzdienst braucht passende Anweisungen, freigegebene Referenzmaterialien und die Berechtigung, die Daten zu verarbeiten. Außerdem muss er verfügbar sein, wenn das Unternehmen ihn braucht.
Legen Sie eine klar abgegrenzte Ausweichaufgabe fest, bevor Sie einen vollständigen Ersatz versuchen. In unserem hypothetischen Serviceteam könnte ein anderes Modell routinemäßige Nachrichten kategorisieren, während Mitarbeitende die Antworten an Kunden bearbeiten. Das Team könnte es anhand typischer Fälle prüfen, darunter mehrdeutige Produktnamen und Anfragen, die an eine Person gehen müssen. Eine flüssig formulierte Antwort allein belegt nicht, dass die Supportregeln des Unternehmens eingehalten wurden.
Legen Sie vor einem Vorfall fest, welche Informationen an den alternativen Dienst übermittelt werden dürfen. Mitarbeitende sollten nicht improvisieren und Kundendatensätze in persönliche Konten kopieren. Prüfen Sie die Datenverarbeitung und Zugriffsregelungen des Ersatzdienstes bei der Beschaffung – ebenso wie Antwortqualität und Preis.
Unterschiedliche Modellnamen belegen auch keine unabhängige Verfügbarkeit. Ein Ausweichmodell kann weiterhin von derselben Anmeldung, Netzwerkverbindung, Dokumentenablage oder Orchestrierungssoftware abhängen. Erfassen Sie, welche Abhängigkeiten die geplante Alternative tatsächlich vermeidet. Dabei kann sich zeigen, dass eine manuelle Warteschlange mit zugänglichen Referenzdokumenten mehr Schutz bietet als ein weiteres Modell hinter derselben fehleranfälligen Verbindung.
Alternativen müssen gepflegt werden, wenn sich Anweisungen ändern und Produktwissen veraltet. Mitarbeitende sollten selten genutzte Verfahren üben. Ein kleines Unternehmen kann sich vernünftigerweise für einen langsameren manuellen Betrieb entscheiden, statt den gesamten Ablauf doppelt vorzuhalten. Maßgeblich sollten die Kosten verzögerter Arbeit und die Folgen einer falschen Antwort sein.
## Setzen Sie die Arbeit mit einer geprüften Warteschlange fort
Wenn der Anbieter die Wiederherstellung meldet, prüfen Sie eine kleine Stichprobe Ihres eigenen Arbeitsablaufs, bevor Sie den normalen Betrieb wieder aufnehmen. Sie sollte einen Fall enthalten, bei dem die benötigte Dokumentensuche und Datensatzänderung getestet werden. Eine erfolgreiche Modellantwort beweist nicht, dass alle verbundenen Systeme wieder bereit sind.
Prüfen Sie anschließend die wartenden Vorgänge. Entfernen Sie Fälle, die bereits manuell bearbeitet wurden, kontrollieren Sie unklare Aktionen und suchen Sie Anfragen, deren Umstände sich geändert haben. Ein Kunde könnte während der Unterbrechung neue Informationen übermittelt haben. Eine Antwort auf Grundlage eines älteren Bearbeitungsstands könnte ein neues Problem schaffen, obwohl der technische Ausfall bereits vorbei ist.
Geben Sie die verbleibende Arbeit in kontrollierten Gruppen frei. Halten Sie Kapazität für neue dringende Anfragen bereit und beobachten Sie, ob die Warteschlange schrumpft. Wenn neue Anfragen die verfügbare Verarbeitungskapazität vollständig beanspruchen, bleibt der Rückstand bestehen, auch wenn jeder neue Versuch gelingt. Der Abbau kann zusätzliche Mitarbeitende, vorübergehend eingeschränkten Service oder eine ehrliche Verlängerung der Antwortzeiten erfordern.
Nehmen wir als separates Zahlenbeispiel an, dass pro Stunde 24 Fälle eingehen und die Bearbeitung 30 Minuten lang stoppt. Dann warten 12 Fälle. Bearbeitet das Team danach 36 Fälle pro Stunde, während weiterhin 24 neue Fälle eingehen, braucht es eine Stunde, um den Rückstand abzubauen. Dies sind illustrative Annahmen, keine Messwerte zum Claude-Vorfall.
Googles Leitfaden zu Service Level Objectives beginnt mit dem für Nutzer wichtigen Ergebnis und den Abhängigkeiten, die für dessen Erbringung nötig sind. Für dieses Serviceteam könnte ein sinnvolles Maß der Anteil dringender Fälle sein, auf die innerhalb des zugesagten Zeitfensters angemessen reagiert wird. Die Verfügbarkeit des Anbieters ist relevant; das Unternehmen muss jedoch auch wissen, ob seine Kunden den Service erhalten haben. [Google SRE: Service Level Objectives umsetzen](https://sre.google/workbook/implementing-slos/)
Dokumentieren Sie, wann der normale Kundenservice wieder aufgenommen wurde, wie viele Fälle noch offen waren und welche nachträglichen Korrekturen nötig wurden. So wird die Wiederherstellungsarbeit sichtbar, die eine Statusseite des Anbieters nicht erfassen kann.
## Üben Sie eine Unterbrechung, bevor Sie die Automatisierung ausweiten
Eine kurze Tischübung kann fehlende Zugriffe oder unklare Zuständigkeiten aufdecken, ohne echte Kunden zu beeinträchtigen. Verwenden Sie einige fiktive Supportfälle und gehen Sie diese Schritte durch:
1. Nehmen Sie an, das Modell wird mitten in der Vorbereitung einer Antwort nicht verfügbar. Fragen Sie, wer den eingeschränkten Betrieb aktiviert und wo Mitarbeitende die ursprüngliche Anfrage finden.
2. Geben Sie einen Fall mit bestätigtem Antwortversand und einen mit einem unklaren Versandversuch vor. Prüfen Sie, ob das Team weiß, welches System den Ausgang belegen kann.
3. Nehmen Sie an, der Anbieter hat den Dienst wiederhergestellt, während weiterhin neue Fälle eingehen. Entscheiden Sie, welche Arbeit zuerst fortgesetzt wird und wie manuell erledigte Fälle aus der Warteschlange entfernt werden.
4. Bitten Sie eine Person, die den Plan nicht verfasst hat, das Verfahren zu erklären und fehlende Berechtigungen oder Unterlagen zu benennen.
Halten Sie fest, welche Fragen die Übung offenließ. Die nötigen Korrekturen können klein sein: Zugriff auf eine bestehende Warteschlange, eine klare Pausenfunktion, eine gespeicherte Bestätigung oder eine zuständige Person für die Wiederherstellung. Nichts davon garantiert einen unterbrechungsfreien Dienst. Jede Maßnahme kann jedoch helfen, einen Ausfall einzugrenzen, ohne die Vorteile der Automatisierung aufzugeben.
Bevor Sie einem Assistenten eine weitere betriebliche Aufgabe übertragen, bitten Sie eine Kollegin oder einen Kollegen zu zeigen, wie diese Aufgabe bei einem Ausfall erledigt würde. Hängt die Antwort davon ab, dass sich der nicht verfügbare Assistent daran erinnert, woran er gerade arbeitete, muss der Notfallplan noch ergänzt werden.
## Sources
- [Claude-Status: Erhöhte Fehlerraten bei mehreren Modellen](https://status.claude.com/incidents/7g1qpkyz5gxh) — Der Vorfallsbericht des Anbieters nennt ein 80-minütiges Auswirkungsfenster und einen späteren Zeitpunkt der Behebung. Die öffentliche JSON-Datei wurde unabhängig ausgelesen. Sie meldet erhöhte Fehlerraten, keinen Totalausfall, und enthält keine veröffentlichte Erklärung zur Ursache.
- [Claude Platform: API-Fehler](https://platform.claude.com/docs/en/api/errors) — Die aktuelle Dokumentation behandelt Fehler, standardmäßige SDK-Wiederholungen und Ausfälle nach Beginn eines Streams. Diese Mechanismen belegen weder den Abschluss eines Geschäftsvorgangs noch verhindern sie doppelte Aktionen in verbundenen Werkzeugen.
- [AWS Builders’ Library: Wiederholungen mit idempotenten APIs sicher gestalten](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/) — Malcolm Featonbys Erläuterung unsicherer Antworten und der Vermeidung von Duplikaten. Der empfangende Dienst muss den API-Vertrag umsetzen; eine Kennung allein genügt nicht.
- [Google SRE: Umgang mit Überlastung](https://sre.google/sre-book/handling-overload/) — Bewährte technische Leitlinien zu eingeschränkter Funktionalität, Prioritäten und begrenzten Wiederholungsversuchen. Der Artikel überträgt diese Grundsätze auf ein hypothetisches Serviceteam; sie diagnostizieren nicht die Ursache des Anthropic-Vorfalls.
- [Google SRE Workbook: Service Level Objectives umsetzen](https://sre.google/workbook/implementing-slos/) — Erläutert Zuverlässigkeitsziele anhand von Nutzerergebnissen und kritischen Abhängigkeiten. Das vorgeschlagene Maß für den Kundenservice und das Rückstandsbeispiel sind illustrative Anwendungen, keine beobachteten Ergebnisse oder allgemeinen Zielwerte.
Der Newsletter von BIG CHANGE
Das große Ganze. In Ihrem Tempo.
Aktuelle Storys über KI und Robotik, beobachtenswerte Veränderungen und praktische Ideen zur Anwendung. Wählen Sie ein tägliches Briefing, eine wöchentliche Zusammenfassung oder eine monatliche Perspektive.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ihr Datenschutz, Ihre Entscheidung.
Notwendiger Speicher schützt die Website und merkt sich Ihre Einstellungen. Optionales Google Analytics bleibt deaktiviert, bis Sie es erlauben. Sie können alle Geschichten auch nur mit notwendigem Speicher lesen. Datenschutzdetails