AI-translated from English; not yet reviewed by a fluent editor.
# Mehrstufiges Reinforcement Learning mit SageMaker: Was ein Suchteam vor dem Training prüfen muss
> AWS berichtet bei seinem Qwen3.6-27B-Agenten von Verbesserungen auf drei von vier zurückgehaltenen Such-Benchmarks. Dieser Leitfaden erläutert die SageMaker-Konfiguration, die Kosten und die erforderliche Evaluation vor einem Testlauf.
By BIG CHANGE Editorial
Published: 2026-10-04T17:55:25.736Z
Updated: 2026-10-04T17:55:25.736Z
Canonical: https://bigchange.ai/blog/fine-tune-search-agent-sagemaker-multi-turn-rl
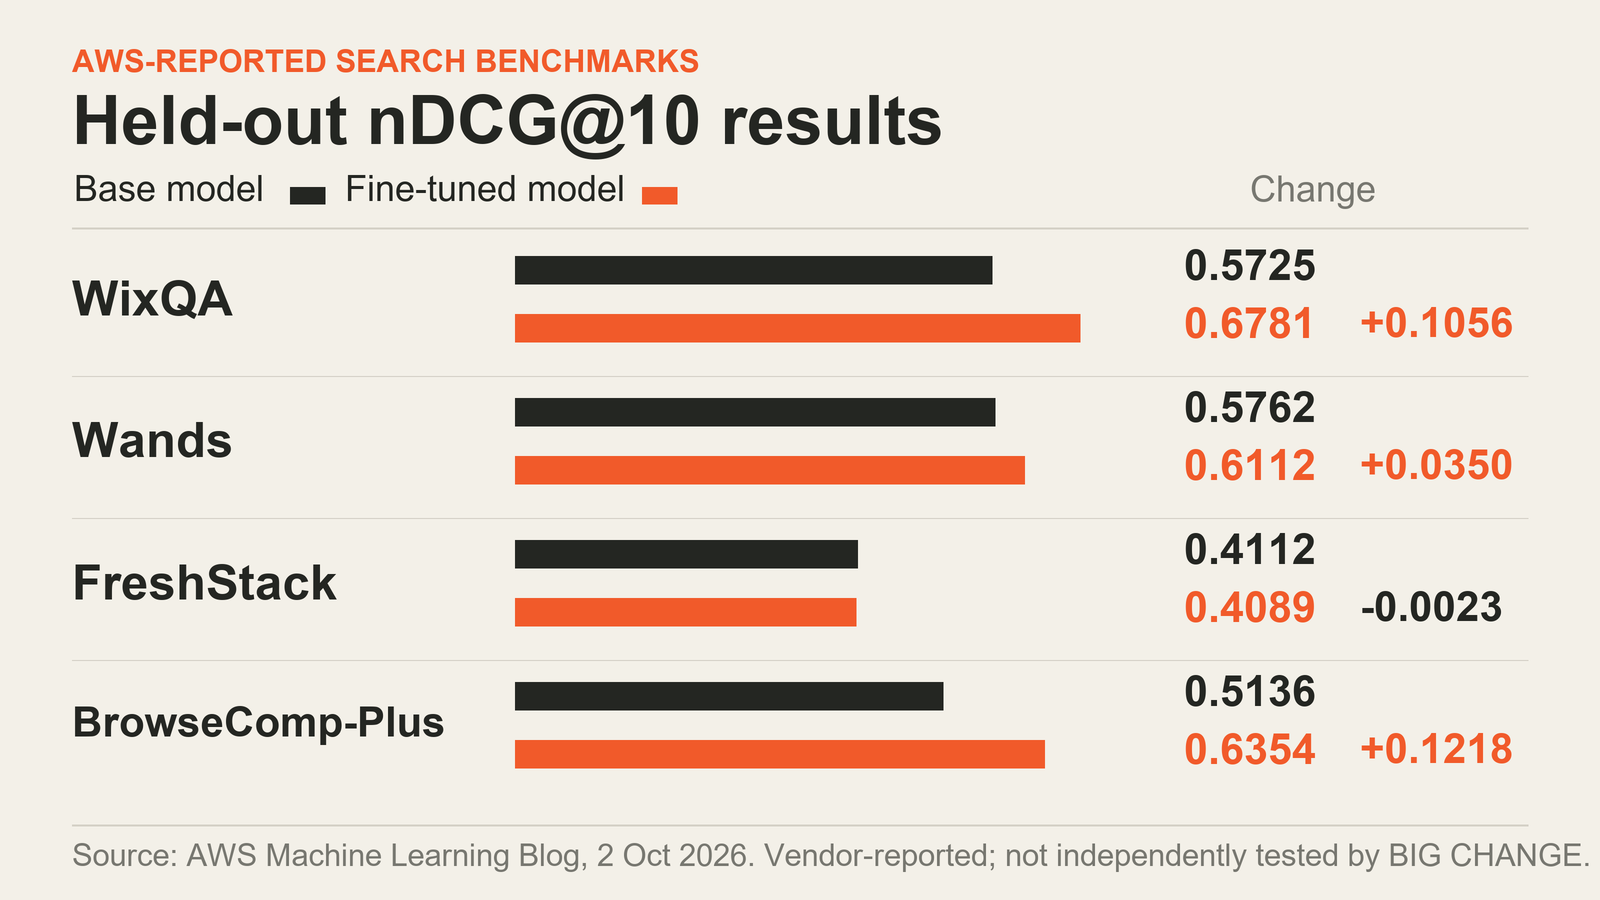
BIG CHANGE graphic; data: AWS Machine Learning Blog
## Die wesentliche Änderung
In seinem [Leitfaden vom 2. Oktober](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) beschreibt AWS die Feinabstimmung eines Qwen3.6-27B-Suchagenten mit mehrstufigem Reinforcement Learning (MTRL) in SageMaker AI. Das Diagramm oben zeigt die von AWS gemeldeten nDCG@10-Werte im zurückgehaltenen Testsatz: Sie stiegen bei WixQA, Wands und BrowseComp-Plus und sanken bei FreshStack leicht. BIG CHANGE hat das Diagramm anhand der AWS-Zahlen erstellt; wir haben den Agenten weder unabhängig getestet noch die Ergebnisse reproduziert. Bei diesem Verfahren wird ein Modell anhand der Ergebnisse einer Abfolge von Entscheidungen trainiert, bei denen Werkzeuge eingesetzt werden.
Vor dem Absenden eines Jobs muss ein ML Engineer sicherstellen, dass Modell und Region unterstützt werden, der Agent an der Rollout-Schleife von SageMaker teilnehmen kann, Prompts und Rewards die vorgesehene Suchaufgabe abbilden und ein separater Evaluationsdatensatz Regressionen sichtbar machen kann. Dieser Leitfaden basiert auf der AWS-Dokumentation; BIG CHANGE hat keinen AWS-Job ausgeführt und keine AWS-APIs aufgerufen.
## Was MTRL an der Trainingsschleife ändert
Beim überwachten Fine-Tuning benötigt ein Team Beispiel-Trajektorien, die das gewünschte Verhalten zeigen. In der Beschreibung von MTRL durch AWS sendet SageMaker stattdessen Prompts an einen Agenten. Dieser ruft in mehreren Schritten das Policy-Modell und seine Werkzeuge auf und meldet nach Abschluss des Rollouts einen Reward. Anhand dieser Rückmeldung wird das Modell aktualisiert. Bei der Suche kann ein Reward das endgültige Ranking bewerten, sodass frühe Entscheidungen zur Suchanfrage im Kontext der gesamten Suchepisode optimiert werden.
Dieser Unterschied ist wichtig, wenn Werkzeugaufrufe von früheren Ergebnissen abhängen. Stellt ein Modell eine schlechte erste Suchanfrage, erhält schwache Ergebnisse und sollte sie neu formulieren, kann ein Reward am Ende der Aufgabe berücksichtigen, ob die gesamte Abfolge letztlich relevante Dokumente gefunden hat. Damit entfällt weder die Notwendigkeit, „relevant“ zu definieren, noch muss das Team einen Agenten entwickeln, der seine Suchwerkzeuge aufrufen kann.
## Zuerst Zugriffsrechte, Modell und Region prüfen
Das Beispiel vom 2. Oktober lief in US West (Oregon), `us-west-2`, und verwendete ein feinabgestimmtes Qwen3.6-27B. Die [Tabelle der von SageMaker MTRL unterstützten Modelle](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html), geprüft am 4. Oktober 2026, führt vier Modelle für sechs Modell-Region-Kombinationen auf: Nova Lite 2.0 und GPT-OSS-20B in US East (N. Virginia), `us-east-1`, sowie in US West (Oregon), `us-west-2`; Gemma-4-31B-it und Qwen 3.6 27B sind nur in Oregon aufgeführt. Prüfen Sie die aktuelle Tabelle in der Region, in der Sie den Job anlegen möchten. Die Auflistung eines Modells belegt nicht, dass es auch anderswo verfügbar ist.
Ein Team benötigt außerdem ein AWS-Konto und bei Nutzung der Studio-Oberfläche eine SageMaker-Studio-Domain, S3-Zugriff auf Datensätze und Ausgaben sowie IAM-Rollen, die für den neuen MTRL-Job und die Runtime-Aufrufe konfiguriert sind. Laut den AWS-Voraussetzungen braucht der Aufrufer die Berechtigungen `CreateJob` und zugehörige Job-Aktionen sowie die Erlaubnis, die Ausführungsrolle an `job.sagemaker.amazonaws.com` weiterzugeben. Die Ausführungsrolle benötigt die Richtlinie `AmazonSageMakerJobFullAccess` und diesen Service Principal in ihrer Vertrauensrichtlinie. Die Runtime-Rolle des Agenten braucht `AmazonSageMakerJobRuntimeAccess`; auch eine AgentCore-Runtime benötigt eine eigene Vertrauensbeziehung. Für die Runtime-Auswahl in Studio sind Berechtigungen zum Auflisten von AgentCore-Runtimes nötig. AWS zufolge umfassen bereits vorhandene umfassende SageMaker-Zugriffsrechte nicht automatisch alle neuen Job-Aktionen.
AWS dokumentiert zwei Möglichkeiten für den Agenten. Für verwaltetes Hosting lässt er sich mit Bedrock AgentCore bereitstellen; laut AWS eignet sich dieser Weg besonders für Agenten auf Basis von Strands. Alternativ kann ein Team einen eigenen Agenten hosten und über einen Lambda-Forwarder anbinden. Der Agent erhält Rollout-Prompts, ruft das Policy-Modell über die SageMaker-Job-Runtime auf, nutzt seine Suchwerkzeuge, schließt jeden Rollout ab und meldet einen Reward. Der SDK-Decorator von AWS übernimmt einen Großteil dieser Integration; eigene Frameworks können die Runtime-APIs direkt aufrufen. Bei einem nicht standardmäßigen Namen der Lambda-Funktion muss laut AWS deren ARN möglicherweise ausdrücklich in die Berechtigungsrichtlinie aufgenommen werden. Ein kundeneigener VPC oder ein kundeneigener KMS-Schlüssel bringt zusätzliche Konfigurationsanforderungen mit sich.
## Prompts und Reward auf die tatsächliche Suchaufgabe ausrichten
SageMaker akzeptiert laut Asset-Leitfaden Parquet, JSON Lines, JSON und CSV. Der Dienst sucht nach einer Spalte namens `prompt` und verwendet andernfalls die erste Spalte. Diesen Wert übergibt er unverändert an den Agenten. Der Dienst analysiert, validiert oder verändert den Prompt-Inhalt nicht. Für eine werkzeuggestützte Suche kann der Prompt im erwarteten Format des Agenten Gesprächsnachrichten, Aufgabenmetadaten, eine Reward-Spezifikation und die Werkzeugkonfiguration enthalten. AWS weist darauf hin, dass Prompts ohne Prüfung durchgereicht werden. Teams müssen daher selbst sensible Daten schützen und geeignete Verschlüsselung oder andere Schutzmaßnahmen für Speicherung und Agentenpfad vorsehen.
Der Reward gibt das Optimierungsziel des Modells vor. Das AWS-Beispiel bewertet die endgültig abgerufenen Dokumente mit nDCG@10 und setzt den Reward auf -1, wenn der Agent sein Turn- oder Sampling-Token-Limit erreicht. Für eine Aufgabe mit gerankten Suchergebnissen ist das ein konkreter Ausgangspunkt. Dadurch wird die Wahl der Evaluation aber besonders wichtig: Das Team braucht verlässliche Relevanzlabels oder ein anderes gut begründetes Bewertungsverfahren und sollte prüfen, ob der Reward kleine Ranking-Verbesserungen auf Kosten der Antwortqualität, Latenz oder Werkzeugkosten begünstigt.
Der Blogbeitrag zufolge umfasste der Trainingsmix FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique und MLQA; fünf Prozent der Trainingsbeispiele jedes Datensatzes wurden zur Validierung zurückgehalten. Der separate Testsatz bestand aus FreshStack, WixQA, BrowseComp-Plus und Wands. Diese öffentlichen oder synthetischen Datensätze ersetzen keine Evaluation auf dem privaten Korpus und der Abfrageverteilung, die ein Team später bedienen will.
## Einen kleinen, nachvollziehbaren Job absenden
Der [AWS-Blogbeitrag vom 2. Oktober](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) verwendet in seinem Codebeispiel einen anderen SDK-Import und andere Argumentnamen. Die aktuelle [Referenz für SageMaker-Trainingsjobs](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) zeigt die folgende API-Form für eine Bedrock-AgentCore-Runtime. Das Beispiel verwendet die aktuell von AWS dokumentierte GPT-OSS-20B-Modellkennung. Wählen Sie ein Modell, das in Ihrer Zielregion verfügbar ist, und prüfen Sie vor einer Anpassung die aktuelle Liste unterstützter Modelle. Das aktuelle Beispiel erfordert außerdem eine MLflow-App-ARN, eine Rollen-ARN und die Zustimmung zur EULA.
```python
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer
trainer = MultiTurnRLTrainer(
model="openai-reasoning-gpt-oss-20b",
agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
training_dataset="s3://my-bucket/prompts/prompts.parquet",
mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
s3_output_path="s3://my-bucket/output/",
role="arn:aws:iam::123456789012:role/SageMakerRole",
accept_eula=True,
)
trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
```
Dies ist das aktuelle Beispiel aus der AWS-Dokumentation, kein von BIG CHANGE getesteter Befehl. Im Blogbeitrag vom 2. Oktober verwendet AWS einen anderen Importpfad: `sagemaker.modules.train`; die Argumentnamen lauten `model_id`, `agent_endpoint`, `training_dataset_s3_uri` und `output_s3_uri`. Da diese Namen von der aktuellen Job-Referenz abweichen, sollten Sie für neue Implementierungen der aktuellen Referenz folgen und die SDK-Version sowie die Modellanforderungen in Ihrer eigenen Umgebung prüfen. Wir konnten nicht feststellen, ob das Blogbeispiel eine ältere SDK-Version widerspiegelt oder ob eine Inkonsistenz in der Dokumentation vorliegt. Als weiteren dokumentierten Weg können Sie den Job über die Studio-Oberfläche absenden: Wählen Sie ein unterstütztes JumpStart-Modell, dann „Multi-Turn Reinforcement Learning“, konfigurieren Sie die AgentCore-Runtime oder den Lambda-Forwarder, geben Sie die Trainingsdaten an und senden Sie den Job ab.
Dokumentieren Sie bei einem ersten Lauf Modell, Region, Datensatzversion, Reward, Limits, Hyperparameter und Ausgabepfad, damit sich spätere Evaluationen mit derselben Ausgangsbasis vergleichen lassen. Bei einem kundeneigenen VPC nennt der separate AWS-Leitfaden private Subnetze in zwei Availability Zones, VPC-Endpunkte für S3 und CloudWatch Logs sowie je nach Setup einen AgentCore- oder Lambda-Endpunkt; bei Verwendung von MLflow ist auch dafür ein Endpunkt erforderlich. Die Ausführungsrolle braucht Berechtigungen zum Verwalten elastischer Netzwerkschnittstellen (ENIs). Ein optionaler kundeneigener KMS-Schlüssel erfordert zusätzliche Berechtigungen und eine Schlüsselrichtlinie für Aufrufer, Ausführungsrolle und Runtime. Die standardmäßige Verschlüsselung im Ruhezustand verwendet einen AWS-eigenen KMS-Schlüssel. Lesen Sie die VPC- und Verschlüsselungsleitfäden, bevor Sie eine dieser Konfigurationen nutzen. Prüfen Sie vor dem Absenden außerdem die Kontingente: AWS nennt standardmäßig je einen gleichzeitig laufenden MTRL-Fine-Tuning-Job und Evaluationsjob. Beide Kontingente lassen sich über Service Quotas anpassen. Die Drosselungslimits der Job-Management-APIs sind nicht änderbar.
## Vor dem Deployment mit zurückgehaltenen Prompts evaluieren
Laut AWS-Evaluationsdokumentation sollten Evaluations-Prompts nicht Teil der Trainingsdaten sein. Verwenden Sie dasselbe Prompt-Format, decken Sie wichtige Werkzeuge und Werkzeugkombinationen ab, beziehen Sie frühere Fehlerfälle ein und schützen Sie sensible Inhalte. Der SageMaker-Evaluator kann ein Kandidatenmodell mit einem Prompt-Satz ausführen und Reward, pass@k sowie Trajektorienmetriken ausgeben. Die Dokumentation zeigt, wie ein feinabgestimmtes Modell und optional auch das Basismodell innerhalb desselben Vergleichs-Pipelines evaluiert werden.
Legen Sie das Evaluationsprotokoll vor dem Training fest. Halten Sie einen festen, unabhängigen Testsatz zurück, der die Anfragen, Berechtigungen und Dokumentänderungen im späteren Betrieb abbildet. Vergleichen Sie Basis- und feinabgestimmtes Modell mit denselben Werkzeugen, Limits und derselben Bewertungslogik. Prüfen Sie neben dem durchschnittlichen Suchscore auch Aufgabenfehler, Anzahl der Turns, Latenz, Tokenverbrauch und Fälle, in denen relevante Dokumente aus den vorderen Treffern verschwinden. Die Dokumentation erläutert, wie sich ein AWS-Evaluationsjob absenden lässt. Sie belegt nicht, dass eine einzelne Metrik die Qualität einer Suche in der Produktion vollständig erfasst.
AWS berichtet für den zurückgehaltenen Testsatz folgende Ergebnisse:
| Datensatz (Fragen) | nDCG@10 des Basismodells | nDCG@10 nach Fine-Tuning | Fehlerrate des Basismodells | Fehlerrate nach Fine-Tuning |
| --- | --- | --- | --- | --- |
| WixQA (400) | 0,5725 | 0,6781 | 0,67 % | 0,17 % |
| Wands (147) | 0,5762 | 0,6112 | 0,00 % | 0,00 % |
| FreshStack (672) | 0,4112 | 0,4089 | 0,20 % | 0,05 % |
| BrowseComp-Plus (830) | 0,5136 | 0,6354 | 22,89 % | 0,68 % |
Die Tabelle zeigt bei drei Datensätzen einen Anstieg des nDCG@10 und bei FreshStack einen leichten Rückgang. AWS führt die niedrigere Fehlerrate von BrowseComp-Plus auf die Strafe zurück, wenn der Agent sein Turn- oder Token-Limit erreicht. Der Blogbeitrag nennt zu diesen Werten weder Konfidenzintervalle noch eine statistische Signifikanzanalyse. Außerdem benötigte das feinabgestimmte Modell bei WixQA durchschnittlich 4,5 statt 4,3 Turns und bei Wands 2,9 statt 2,2. Weniger Turns waren also nicht durchgängig zu beobachten. Es handelt sich um ein vom Anbieter berichtetes Experiment, nicht um eine unabhängige Validierung oder einen Beleg dafür, dass sich ein anderer Korpus ebenso verbessern wird.
## Die gesamten Kosten des Testlaufs einplanen
Die MTRL-Dokumentation von AWS nennt drei Kostenbestandteile für das Training: verarbeitete Prefill-Tokens als Eingabe, während der Rollouts generierte Sampling-Tokens und Trainingsupdates. Die Preisseite führt modellspezifische Tarife auf. Zusammen mit dem Rollout-Volumen, der Sequenzlänge, den Epochen und der Runtime bestimmen diese Tarife die Kostenschätzung. Der Beispielartikel nennt keine Gesamtrechnung, und die Dokumentation gibt keinen universellen Preis für einen Testlauf an. Prüfen Sie den aktuellen Tarif des gewählten Modells in der gewünschten Region und kalkulieren Sie anhand der erwarteten Job-Nutzung, statt von einem Festpreis auszugehen.
Berücksichtigen Sie in der Schätzung auch Nebenkosten: S3-Speicher und -Anfragen für Training, Validierung, Checkpoints und Ausgabe-Artefakte; AgentCore-Runtime oder Lambda und unterstützende Suchinfrastruktur während der Rollouts; Logging und MLflow; die separate Evaluation sowie Endpunkte oder eine Bedrock-Bereitstellung nach dem Training. AWS empfiehlt in seinem Beitrag ausdrücklich, laufende MTRL-Jobs anzuhalten oder zu löschen, nicht benötigte S3-Modellartefakte zu entfernen und Evaluations-Endpunkte abzubauen, um weitere Kosten zu vermeiden. Die Bereitstellung eines Endpunkts ist eine separate Entscheidung und Kostenkategorie gegenüber dem Training.
## Entscheiden, ob sich ein Versuch lohnt
Der Ablauf ist besonders relevant, wenn die Suchaufgabe mehrere voneinander abhängige Werkzeugaufrufe erfordert und das Team das Endergebnis bewerten kann. Ein Testlauf ist nur dann eine belastbare Entscheidungsgrundlage, wenn die Modell-Region-Kombination unterstützt wird, die Agentenintegration funktioniert, die Prompt-Daten repräsentativ sind, der Reward die Aufgabe abbildet, ein Vergleich mit zurückgehaltenen Daten erfolgt und die Kostenschätzung auch die zusätzlichen Dienste umfasst. Ein starkes Ergebnis auf den vier AWS-Benchmarks ist ein Grund, die Methode genauer zu prüfen, aber kein Anlass, denselben Effekt für einen anderen Index, andere Suchanfragen oder andere Berechtigungsgrenzen anzunehmen.
**Quellen und weiterführende Informationen**
- [AWS Machine Learning Blog: „Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI“ (2. Oktober 2026)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — die Anleitung des Anbieters, die Einrichtung, die Auswahl der Datensätze und die gemeldeten Evaluationsergebnisse.
- [Amazon SageMaker AI: Mehrstufiges Reinforcement Learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — aktuell unterstützte Modelle und Regionen sowie die Abrechnungsdimensionen.
- [Voraussetzungen](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html), [Agenten vorbereiten](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-agent.html), [VPC-Konfiguration](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-vpc.html) und [Verschlüsselung im Ruhezustand](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-encryption-at-rest.html) — Berechtigungen, Runtime-Auswahl, Integration und optionale Netzwerk- und Verschlüsselungskonfiguration.
- [Assets erstellen](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html), [Trainingsjob absenden](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html), [Evaluation](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-evaluation.html), [Hyperparameter](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-hyperparams.html) und [Kontingente](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-quotas.html) — aktuelle Implementierungsreferenzen.
- [Preise für SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/) — aktuelle Preisinformationen für die Modellanpassung; die Tarife können sich ändern und variieren je nach Modell und Region.
*Redaktioneller Hinweis: Es wurde ausschließlich die Dokumentation geprüft. BIG CHANGE hat nicht auf ein AWS-Konto zugegriffen, keinen SageMaker-Job abgesendet oder untersucht, keine AWS-APIs aufgerufen und die gemeldeten Kennzahlen nicht unabhängig reproduziert. Die Implementierungsanleitung stammt von AWS; der Anbieter berichtet über sein eigenes Experiment.*
## Sources
- [AWS Machine Learning Blog: Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI (October 2, 2026)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — AWS-Implementierungsanleitung, Auswahl der Datensätze und vom Anbieter gemeldete Evaluationsergebnisse im Testsatz.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — Aktuell unterstützte Modell-Region-Kombinationen, Prozessübersicht und Abrechnungsdimensionen für das Training.
- [Amazon SageMaker AI MTRL: Voraussetzungen und Agenteneinrichtung](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html) — Erforderliche Berechtigungen, Runtime-Auswahl, Agentenintegration und optionale Netzwerk- und Verschlüsselungskonfiguration.
- [Amazon SageMaker AI MTRL: Dokumentation zu Training und Evaluation](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html) — Aktuelle Dateneingaben und Abläufe; der Artikel verlinkt außerdem auf die Referenzen zu Trainingsjobs und Evaluation.
- [Amazon SageMaker AI MTRL: Trainingsjob absenden](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) — Aktueller Python-SDK-Import, Argumentnamen, AgentCore-Beispiel und Schritte für das Absenden über Studio; geprüft am 4. Oktober 2026.
- [Preise für Amazon SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/) — Aktuelle modellspezifische Preisinformationen; die Tarife variieren je nach Modell und Region.
Der Newsletter von BIG CHANGE
Das große Ganze. In Ihrem Tempo.
Aktuelle Storys über KI und Robotik, beobachtenswerte Veränderungen und praktische Ideen zur Anwendung. Wählen Sie ein tägliches Briefing, eine wöchentliche Zusammenfassung oder eine monatliche Perspektive.
Nächster geplanter Versand (UTC): . Deine erste Ausgabe kommt zum nächsten geplanten Versand nach deiner Bestätigung.
Ihr Datenschutz, Ihre Entscheidung.
Notwendiger Speicher schützt die Website und merkt sich Ihre Einstellungen. Optionales Google Analytics bleibt deaktiviert, bis Sie es erlauben. Sie können alle Geschichten auch nur mit notwendigem Speicher lesen. Datenschutzdetails