AI-translated from English; not yet reviewed by a fluent editor.
# Jevs größere Wette: KI-Entscheidungen in der Software, die wir bereits nutzen
> TypeSafe-CEO Diogo Almeida plädiert für KI, die kleine Entscheidungen direkt in Software trifft. Wir untersuchen den Start von Jev, seine Grenzen und die Belege, die eine echte Veränderung bestätigen würden.
By BIG CHANGE Editorial
Published: 2026-09-22T00:45:03.943Z
Updated: 2026-09-22T00:45:03.943Z
Canonical: https://bigchange.ai/blog/jev-typesafe-ai-decisions-software-diogo-almeida
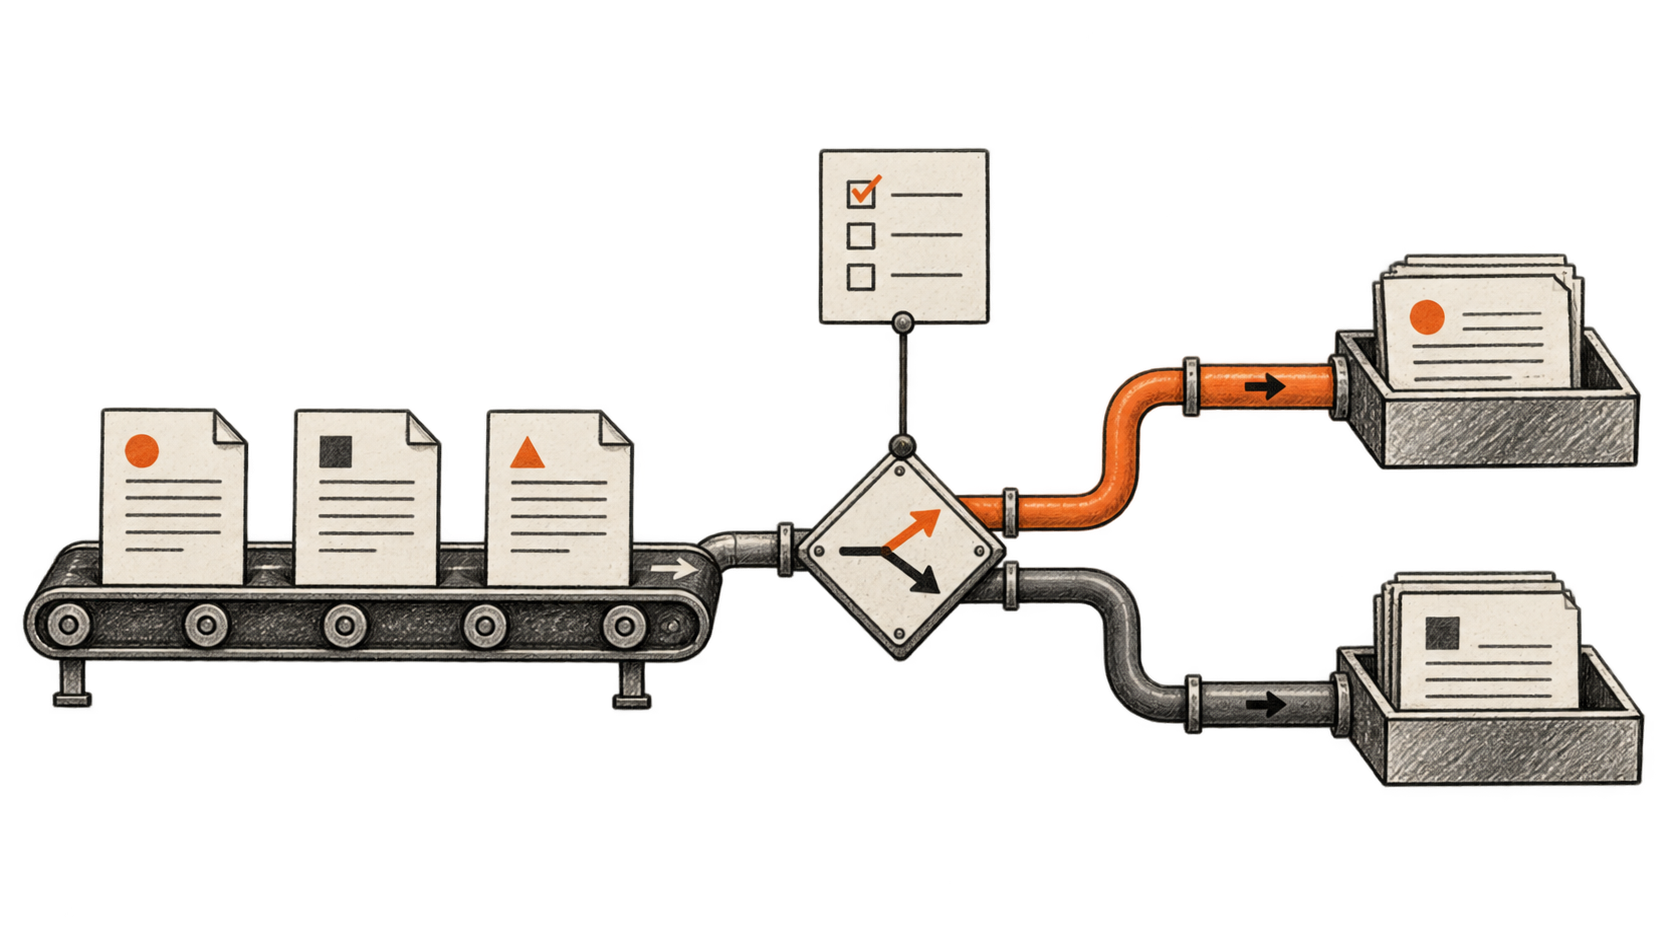
AI-generated conceptual illustration by BIG CHANGE. A decision switch inside a larger workflow; not a depiction of Jev’s internal architecture.
Ein Kunde ändert die Lieferadresse einer Bestellung. In derselben Nachricht bittet er um eine Rückerstattung, erwähnt ein beschädigtes Paket und deutet an, dass zum dritten Mal etwas schiefgegangen ist. Aus dieser Nachricht eine hilfreiche Antwort zu machen, ist eine Aufgabe. Zu entscheiden, welche Datensätze geändert werden, welches Team eingreifen sollte und welche Schritte eine Genehmigung benötigen, ist eine andere.
Jev, das Modell, das TypeSafe AI am 15. September 2026 im Early Access einführte, zielt auf solche Entscheidungen. Es erzeugt für Software eingeschränkte, strukturierte Antworten. Die Markteinführung lädt dazu ein, neu zu überlegen, wie viele Abläufe einer Anwendung von langen Gesprächen mit einem Allzweckmodell abhängen sollten. [TypeSafes Ankündigung zur Markteinführung](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
Am ausführlichsten wird das Argument im Interview von Latent Space mit TypeSafe-Mitgründer und CEO Diogo Almeida vom 21. September erläutert, moderiert von swyx. Wir haben die vollständigen englischen Untertitel des zweistündigen und 22-minütigen Gesprächs geprüft und die Produktdokumentation herangezogen. Dies ist eine Analyse des Interviews und der öffentlich zugänglichen Belege; wir haben Jev nicht unabhängig einem Benchmark unterzogen. [Das Originalinterview ansehen](https://www.youtube.com/watch?v=cFx9Z3ZXca0)
Unserer Lesart nach betrifft Jevs folgenreichster Vorschlag die Einheit der Automatisierung. Ein Unternehmen kann möglicherweise ein klar abgegrenztes Urteil innerhalb eines bestehenden Ablaufs automatisieren, bevor es verantwortungsvoll den gesamten Ablauf übergeben kann. Wenn sich dieses Urteil günstig genug wiederholen und klar genug messen lässt, könnte vertraute Unternehmenssoftware nützliche Fähigkeiten erhalten, ohne dass jede Interaktion zu einem Chat werden muss.
Das würde die Menschen, die Arbeitsabläufe entwerfen, ebenso betreffen wie deren Nutzer. Jemand muss weiterhin festlegen, welche Handlungen erlaubt sind, was als Fehler gilt und wer sich um Ausnahmen kümmert. Von der Qualität dieser Entscheidungen hängt ab, ob dieser Ansatz verlässliche Dienste schafft oder Fehler lediglich beschleunigt.
## Was TypeSafe tatsächlich eingeführt hat
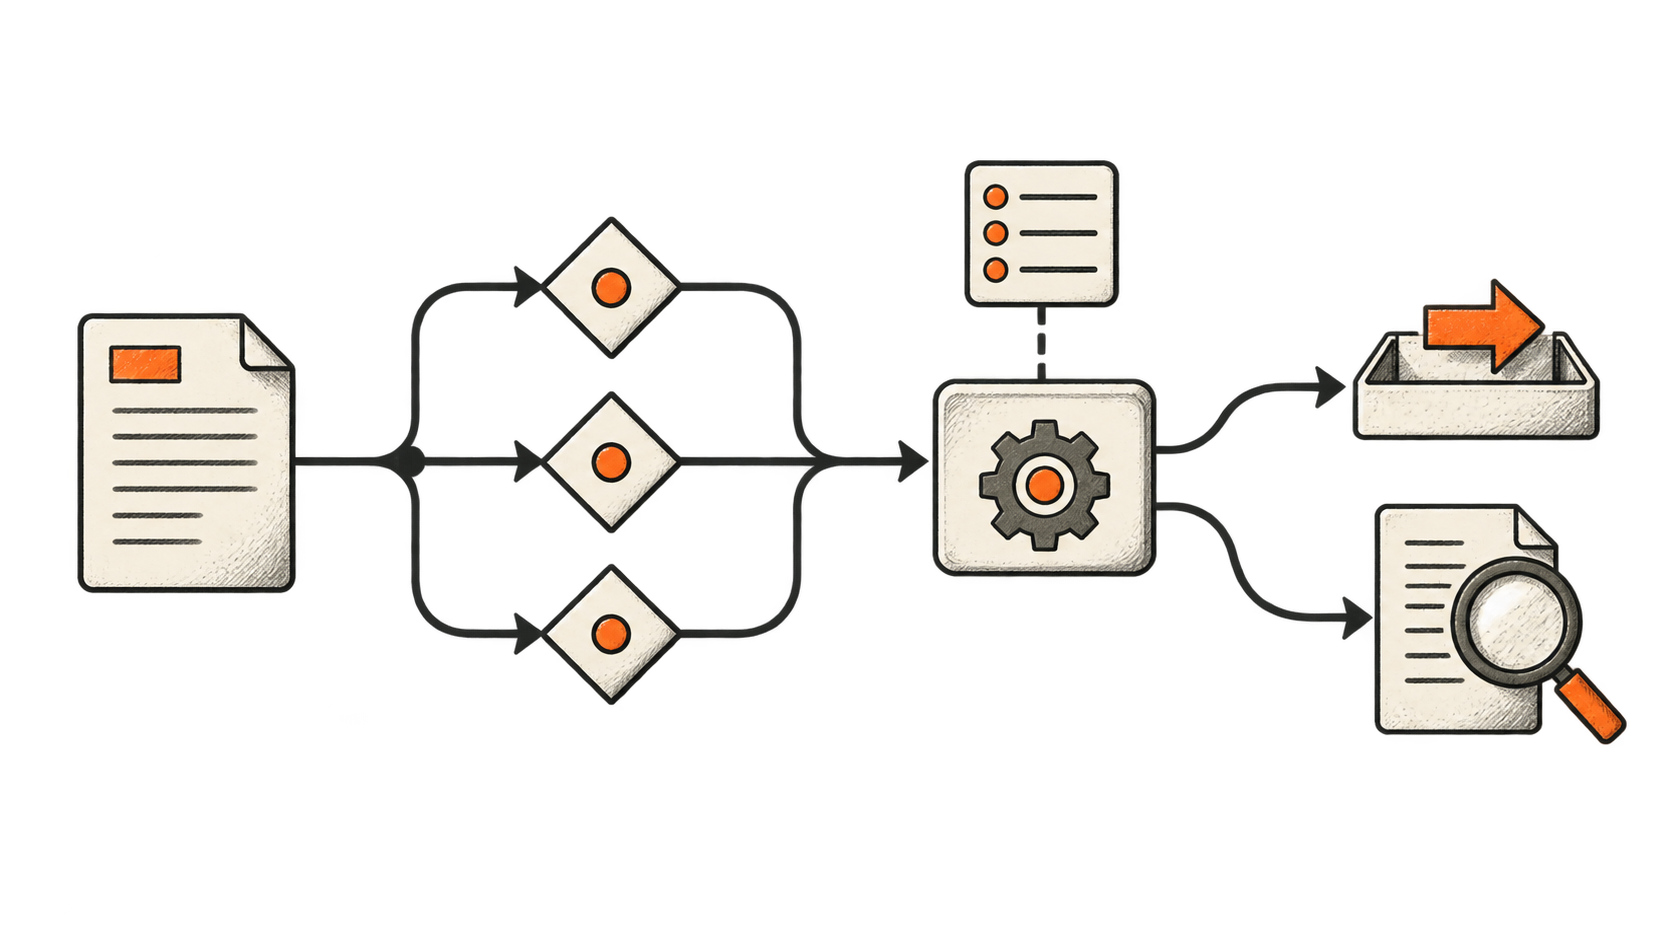
Jevs dokumentierte Schnittstelle erhält einen Zustand und eine Reihe typisierter Fragen. Die drei Grundbausteine heißen Choice, das aus vorgegebenen Optionen auswählt; Score, das anhand eines Bewertungsrasters urteilt; und Noul, das die Wahrscheinlichkeit einer Aussage auf einer Skala von null bis eins angibt. Choice und Score geben Verteilungen und ein Konfidenzfeld zurück. Noul hat kein separates Konfidenzfeld. Mehrere Fragen können denselben bereitgestellten Zustand nutzen und unabhängig voneinander ausgewertet werden. [TypeSafes Schnittstellendokumentation](https://docs.typesafe.ai/introduction)
In einer Kundenserviceanwendung könnte ein Entwickler mit diesen Bausteinen unterscheiden, ob jemand eine Adressänderung oder eine Stornierung wünscht, die Dringlichkeit einschätzen und prüfen, ob eine Nachricht Hinweise auf einen Schaden enthält. Das sind hypothetische Beispiele, keine Ergebnisse eines Jev-Einsatzes. Anschließend entscheidet die Anwendung, was mit den Antworten geschieht.
Diese Aufteilung ist sinnvoll, weil Interpretation und Befugnis unterschiedliche Verantwortlichkeiten sind. Eine KI kann ableiten, dass ein Kunde eine Rückerstattung wünscht. Allein aus dieser Schlussfolgerung darf sie aber nicht die Befugnis erhalten, eine Rückzahlung auszulösen. Die Anwendung kann die Bestellung prüfen, eine Rückerstattungsgrenze durchsetzen und gegebenenfalls eine Genehmigung verlangen.
TypeSafe bezeichnet diese Modellkategorie als System One und greift dabei auf die Vorstellung schnellen, intuitiven Denkens zurück. Der Name beschreibt die vorgesehene Art von Aufgaben. Er bescheinigt weder menschenähnliches Denken noch eine klare Grenze zwischen einfachen und schwierigen Aufgaben. Eine kurze Frage kann ein kompliziertes Urteil verbergen, besonders wenn wichtige Informationen fehlen.
## Die technische Änderung: kleinere, nachvollziehbare Entscheidungen
Almeida plädiert dafür, Aufgaben aufzuteilen: eng umrissene Fragen stellen und die Antworten anschließend im Code zusammenführen. [Interview, 1:03:02](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=3782s)
Betrachten wir erneut das Beispiel mit der beschädigten Bestellung. Eine einzige Anweisung, die Beschwerde zu bearbeiten, verbirgt mehrere Urteile in einer Antwort. Ein besser überprüfbarer Entwurf würde getrennt feststellen, welche Handlung gewünscht ist, ob sich die Bestellung zuordnen lässt und ob die verfügbaren Belege eine Schadensmeldung stützen. Die Regeln der Richtlinie blieben außerhalb dieser Urteile.
So lässt sich ein Fehler leichter untersuchen. Leitet das System eine Adressänderung an das Retourenteam weiter, kann der Betreiber die Weiterleitungsentscheidung prüfen. Ist die Schadensbewertung falsch, lässt sich diese Komponente anhand früherer Fälle testen. Eine Änderung der Richtlinie kann eine ausdrückliche Regel anpassen, ohne dass das Team eine umfassende Anweisung umschreiben und hoffen muss, dass das Modell sie weiterhin einheitlich interpretiert.
Das hat seinen Preis. Mehr Komponenten bedeuten mehr Schnittstellen, die gewartet werden müssen. Fragen können versehentlich Kontext auslassen, der für eine klare Antwort nötig ist. Zwei scheinbar unabhängige Urteile können von denselben irreführenden Belegen abhängen. Auch ein Ablauf aus einzelnen, für sich akzeptablen Bausteinen kann zu einem unvertretbaren Ergebnis führen.
Zu den dokumentierten Mustern von TypeSafe gehören mehrere Fragen auf einmal, das Zusammenführen von Bewertungen und die Weiterleitung unsicherer Fälle zur zusätzlichen Bearbeitung. Sie beschreiben Architekturvarianten, belegen aber nicht, dass ein bestimmter Kundenprozess schon unbeaufsichtigt laufen kann. [TypeSafes Muster](https://docs.typesafe.ai/patterns)
Entscheidend ist, ob die Aufteilung sowohl die Fehlersuche als auch die Ergebnisse verbessert. Erklären zu können, welcher Schritt fehlschlug, ist wertvoll. Den Anteil und die Folgen solcher Fehler zu senken, ist der wirtschaftliche Nutzen.
## Eine gültige Antwort kann trotzdem falsch sein
TypeSafes Aussage, Jev könne „nicht halluzinieren“, ist eng auszulegen. Die Garantie bezieht sich laut Unternehmen darauf, dass die zulässige Ausgabestruktur eingehalten wird. Daraus folgt nicht, dass die ausgewählte Antwort wahr ist. In seiner eigenen Ankündigung unterscheidet TypeSafe ausdrücklich zwischen Strukturgarantien und empirischer Bewertung. [TypeSafes Erklärung der Typsicherheit](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
Angenommen, eine Anwendung erlaubt die Werte `damaged`, `late` und `other`. Die Rückgabe von `damaged` ist vollkommen gültig, auch wenn das Paket lediglich verspätet war. Ein Modell, das keine vierte Kategorie erfinden kann, kann trotzdem die falsche auswählen. Schließt die Liste eine tatsächlich notwendige Kategorie aus, wird das Schema selbst zum Teil des Problems.
Strukturierte Ausgaben sind außerdem ein bereits etablierter technischer Ansatz. OpenAI führte im August 2024 schema-beschränkte Structured Outputs ein und wies ausdrücklich darauf hin, dass ein Modell innerhalb der zurückgegebenen Werte trotzdem Fehler machen kann. Jev sollte daher anhand seiner konkreten Kombination aus Entscheidungsqualität, Unsicherheitsangaben, Latenz und Kosten bewertet werden. Man sollte dem Modell nicht zuschreiben, strukturierte KI-Ausgaben insgesamt erfunden zu haben. [OpenAIs ursprüngliche Ankündigung und ihre Einschränkungen](https://openai.com/index/introducing-structured-outputs-in-the-api/)
Für Kaufinteressenten verändert dieser Unterschied den Evaluierungsplan. Ein Schematest fragt, ob die Software eine Antwort verarbeiten kann. Ein Sachlichkeitstest fragt, ob die Antwort mit den Belegen übereinstimmt. Ein Richtlinientest fragt, ob die daraus folgende Handlung zulässig ist. Das Bestehen eines Tests ersetzt die anderen nicht.
## Die wichtigste Herausforderung im Interview betrifft die Kalibrierung
Bei 1:09 widerspricht Almeida der Annahme perfekter Kalibrierung und räumt Modellfehler ein. [Interview, 1:08:50](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4130s)
Bei der Kalibrierung geht es darum, wie vorhergesagte Wahrscheinlichkeiten über Gruppen von Prognosen hinweg mit den beobachteten Ergebnissen übereinstimmen. Ein Modell kann Unsicherheit sinnvoll anzeigen, ohne in jedem Fall mit hoher prognostizierter Wahrscheinlichkeit richtig zu liegen. TypeSafes Einführungsmaterial wahrt diesen Unterschied ausdrücklich. [TypeSafes Erläuterung zur Kalibrierung](https://docs.typesafe.ai/introduction/machine-learning-primer)
Auch das Konfidenzfeld der API muss von einer anderen Größe unterschieden werden. TypeSafe beschreibt es als eine aus der Antwortverteilung abgeleitete Kennzahl. Es ist nicht gleichbedeutend mit einer unabhängig gemessenen Wahrscheinlichkeit, dass die ausgewählte Antwort richtig ist. Die Dokumentation empfiehlt, Schwellenwerte passend zur Aufgabe und zu ihren Folgen festzulegen. [TypeSafes Dokumentation zur Konfidenz](https://docs.typesafe.ai/confidence)
Das sind praktische Fragen. Man stelle sich vor, ein Weiterleitungsmodell funktioniert bei kurzen englischen Nachrichten gut, hat aber Schwierigkeiten mit langen Beschwerden, die mehrere Anliegen vermischen. Ein Gesamtwert kann diese Schwäche verbergen. Eine Entscheidung mit hoher Konfidenz aus der schwächeren Gruppe verdient womöglich mehr Prüfung als dieselbe angezeigte Zahl aus der vertrauten Gruppe.
Ein Team sollte deshalb die Fälle bewerten, die voraussichtlich tatsächlich eintreffen, darunter unvollständige Informationen, ungewohnte Formulierungen und bewusst verwirrende Eingaben. Es sollte Fehler nach Kategorien untersuchen und die Kosten einer Weiterleitung zur Prüfung mit den Kosten einer falschen Handlung vergleichen. Schwellenwerte werden so zu betrieblichen Entscheidungen, die durch Belege gestützt werden, statt zu Zahlen aus einer Vorführung.
Die Forschung zur Kalibrierung ist deutlich älter als Jev. Eine viel zitierte Arbeit von Chuan Guo und Mitautoren aus dem Jahr 2017 untersuchte die schlechte Kalibrierung moderner neuronaler Netze und Methoden zu ihrer Verbesserung. Sie liefert Kontext für das Problem, validiert aber nicht TypeSafes Modell. [On Calibration of Modern Neural Networks](https://arxiv.org/abs/1706.04599)
## Zuverlässigkeit umfasst auch, was passiert, wenn sich der Dienst ändert
Im Gespräch werden Robustheit und Determinismus voneinander abgegrenzt und die Versionsstabilität erörtert, ohne eine allgemeine Langzeitunterstützung zu versprechen. [Interview, 41:24](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2484s) sowie [49:40](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2980s)
Das sind unterschiedliche Fragen für den Einkauf. Determinismus fragt, ob identische Eingaben identische Ausgaben erzeugen. Robustheit fragt, ob eine irrelevante Änderung, etwa eine andere Datensatzkennung, das Verhalten unangemessen verändert. Ein Modell kann dieselbe falsche Antwort endlos wiederholen und dabei deterministisch sein. Es kann auch geringfügig schwanken, während der umgebende Ablauf zuverlässig bleibt.
Keine dieser Eigenschaften löst das Risiko im Lebenszyklus. Ein Unternehmen muss wissen, welche Modellversion eine Entscheidung hervorgebracht hat, ob diese Version verfügbar bleibt und wie ein Ersatzmodell bewertet wird. Eine Verbesserung bei den Tests des Anbieters kann das Verhalten eines sorgfältig abgestimmten Kundenablaufs trotzdem verändern.
Sinnvoll ist es, repräsentative Fälle aufzubewahren, Versionen zu protokollieren und Ersatzmodelle vor der Umstellung zu vergleichen, insbesondere wenn es um folgenreiche Aufgaben geht. Auch eine Ausweichlösung ist wichtig: Selbst ein ansonsten genauer Entscheidungsdienst kann ausfallen. Hat die Anwendung keine sichere Möglichkeit, die Arbeit zu unterbrechen oder anderweitig weiterzuleiten, wird die Verfügbarkeit praktisch Teil der Entscheidungsqualität.
Hier wird aus einer attraktiven API eine betriebliche Abhängigkeit. Beschaffung, Überwachung und Migrationsplanung verschwinden nicht, wenn das Modell schneller wird. Sie lassen sich leichter vernachlässigen, weil der einzelne Aufruf so einfach wirkt.
## Warum Geschwindigkeits- und Preisangaben Kontext brauchen
TypeSafes herausgestellte Ergebnisse für Arbeitsabläufe umfassen eine 193,6-fache Geschwindigkeitssteigerung und eine 444,6-fache Kostensenkung. Laut Ankündigung handelt es sich um Höchstwerte aus vom Unternehmen erstellten Abläufen. Als Referenzantworten dienten Wahrscheinlichkeitsschätzungen anderer Modelle statt unabhängig überprüfter, abschließend festgestellter Fallklassifikationen. Das Unternehmen weist zudem darauf hin, dass die kurze Vorführung Jev begünstigt und eine dauerhaft tragfähige Preisgestaltung noch nicht feststeht. [TypeSafes Einschränkungen zur Evaluierung](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
Diese Einschränkungen müssen zusammen mit den Zahlen genannt werden. Die Übereinstimmung mit einem Referenzmodell kann aufschlussreich sein, misst aber etwas anderes als die Korrektheit anhand eines abschließend geklärten Kundenfalls. Ein vom Anbieter entworfener Ablauf kann für einen Käufer relevant sein, muss aber nicht die Verteilung seiner Anfragen abbilden.
Ein sinnvoller Vergleich sollte die gesamte Aufgabe umfassen: Kontext beschaffen, Entscheidungen treffen, Regeln anwenden, Ausnahmen bearbeiten und sich von Fehlern erholen. Ein günstigerer Modellaufruf kann mit höheren Gesamtkosten einhergehen, wenn zu viele Fälle an Prüfer weitergereicht werden. Ein langsamerer Aufruf kann sich rechnen, wenn er kostspielige Nacharbeit vermeidet.
Auch die Latenz muss von der tatsächlichen Region der Anwendung aus gemessen werden. Eine Vorführung in der Nähe der Dienstinfrastruktur verspricht nicht dieselbe Erfahrung für Nutzer an anderen Orten. Interaktive Systeme sollten neben dem Durchschnitt auch langsame Anfragen untersuchen. Bei Hintergrundverarbeitung können Durchsatz und Gesamtkosten wichtiger sein.
Jevs Name spielt auf die Idee an, dass höhere Effizienz den Verbrauch ausweiten kann. Für ein einzelnes Unternehmen wirft das eine Budgetfrage auf: Welche zusätzlichen Entscheidungen lohnen sich nun zu prüfen, und welche werden lediglich so billig, dass man sie unnötig prüft? Mehr Modellaufrufe sind für sich genommen kein Ergebnis.
## Ein anderes Forschungsziel und noch offene Belege
Almeidas Forschungsargument verbindet Daten, die Auswahl von Aufgaben und RLCD mit seiner Kritik an der Optimierung anhand menschlicher Präferenzen. [Interview, 7:23](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=443s) sowie [22:12](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=1332s)
RLCD steht für Reinforcement Learning for Calibrated Decisions, also bestärkendes Lernen für kalibrierte Entscheidungen. TypeSafe beschreibt damit ein Trainingsziel, das auf nutzbare Entscheidungen und Wahrscheinlichkeiten ausgerichtet sei, im Gegensatz zu Ansätzen mit menschlichen Präferenzen oder überprüfbaren Belohnungen. Das ist die Darstellung des Unternehmens zu seinem Ziel. Sie ist nicht mit einer unabhängigen Überprüfung des gesamten Trainingsverfahrens gleichzusetzen. [TypeSafes KI-Einführung](https://docs.typesafe.ai/introduction/machine-learning-primer)
Die allgemeinere Frage ist es wert, untersucht zu werden, auch wenn die Methode noch bewertet wird: Welches Verhalten belohnt ein Trainingsziel? Ein Modell, das auf überzeugende Erklärungen optimiert ist, kann angenehm zu bedienen sein, ohne Unsicherheit so offenzulegen, dass Code damit arbeiten kann. Eine entscheidungsorientierte Schnittstelle kann den Umgang mit Unsicherheit erleichtern. Ihre Ausgaben müssen dennoch extern an der Realität geprüft werden.
TypeSafe bringt diese Sorge mit Mode Dropping in Verbindung: Die Optimierung anhand von Präferenzen könne die Bandbreite wahrscheinlicher Ausgaben auf Antworten verengen, die Menschen belohnen. Das ist TypeSafes Beschreibung eines möglichen Fehlermodus, kein Beleg dafür, dass sich jedes anhand von Präferenzen trainierte Modell nicht für Entscheidungen eignet. [TypeSafes Erörterung der Präferenzoptimierung](https://docs.typesafe.ai/introduction/machine-learning-primer)
Almeidas Werdegang macht dieses Argument besonders interessant. Er ist Mitautor der InstructGPT-Arbeit, in der untersucht wurde, wie sich Sprachmodelle mithilfe menschlichen Feedbacks auf das Befolgen von Anweisungen trainieren lassen. Diese Mitautorenschaft ist belegbar; weitreichende Behauptungen darüber, worin sich jedes Labor irrt, sind eine andere Sache. [Die InstructGPT-Arbeit](https://arxiv.org/abs/2203.02155)
Seine Einwände gegen Ausgaben für Vortraining und gegen neue Labore ohne klare Ausrichtung gehören zum selben Argument, nützliche Aufgaben gezielt auszuwählen. [Interview, 1:49:32](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6572s) sowie [2:03:10](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7390s)
Für Käufer lautet die relevante Lehre, nach den konkreten Fähigkeiten für einen klar definierten Prozess zu fragen. Der wissenschaftliche Hintergrund, die Ausgaben für Rechenleistung und eine besondere Modellarchitektur können erklären, wie ein Unternehmen zu seinem Angebot gekommen ist. Sie belegen nicht, dass sich das Modell wirtschaftlich im Unternehmen eines anderen einsetzen lässt.
Im Interview geht es außerdem um Almeidas Weggang von OpenAI, schwierige erste Schritte bei der Einführung und entwicklergetriebenes Wachstum. [Interview, 1:31:27](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5487s) sowie [1:56:48](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7008s)
Diese Rückblicke erklären die Prioritäten des Unternehmens. Sie sind keine geprüften Belege für die Verbreitung des Produkts. Eine Entwicklerplattform sollte letztlich anhand dauerhaft nützlicher Arbeitslasten und der Unterstützung bewertet werden, die sie bei deren Ausfall bietet. Begeisterung nach einer Produkteinführung ist ein Anlass zur Prüfung, kein Ersatz für diese Erfolgsbilanz.
## Bestehende Software könnte stärker profitieren als ein neues Chatfenster
Almeida erwartet bessere SaaS-Produkte und KI, die zunehmend im Hintergrund verschwindet. [Interview, 1:19:57](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4797s)
Das ist eine plausible Richtung für weitere Untersuchungen, denn bestehende Software enthält bereits Stellen, an denen ein nützliches Urteil den nächsten Schritt verändern könnte. Eine Terminplanungsanwendung könnte eine unklare Anfrage vor der Buchung erkennen. Ein Medienarchiv könnte Material für Forschende ordnen. Ein Serviceportal könnte eine routinemäßige Aktualisierung von einer Beschwerde unterscheiden, die Aufmerksamkeit erfordert. Das sind mögliche Entwürfe, keine gemeldeten Jev-Einsätze.
Die Benutzeroberfläche könnte sich kaum verändern. Nutzer würden weniger Fehler, weniger wiederholte Klassifizierungen oder kürzere Wartezeiten bis zur zuständigen Person bemerken. Der wirtschaftliche Vorteil könnte Unternehmen zufallen, die ihre Arbeitsabläufe bereits gut kennen und bessere Entscheidungen darin verankern können.
Bestehende Softwareunternehmen stünden weiterhin im Wettbewerb. Wird dasselbe Urteil vielen Entwicklern zugänglich, bietet der Modellaufruf allein kaum Unterscheidung. Das umgebende Produkt muss nützlichen Datenzugriff, durchdachte Interaktion und einen verlässlichen Weg zum Abschluss der Arbeit bieten.
Bei Beschäftigungsaussagen ist größere Zurückhaltung geboten. Weniger Aufwand für eine Aufgabe könnte den Personalbedarf verändern, das Servicevolumen erhöhen oder die Arbeit auf Ausnahmefälle verlagern. Diese Folgen hängen vom jeweiligen Unternehmen und der Nachfrage nach seinen Leistungen ab. Weder ein Interview noch ein Early-Access-Start belegt, dass eine bestimmte Zahl von Arbeitsplätzen geschützt, abgebaut oder geschaffen wird.
Für den Branchenüberblick von BIG CHANGE ist das messbare Ereignis, dass ein weiterer Ansatz zur Automatisierung von Entscheidungen verfügbar wird. Breite Einführung, Produktivitätsgewinne und Folgen für den Arbeitsmarkt sind spätere Fragen, für die andere Belege nötig sind.
## Dunkle Daten, Software in Echtzeit und die Grenzen einer Vorführung
Im Interview geht es um gespeicherte Daten, interaktive Anwendungen, Verifikation und Vorführungen zur Computernutzung. [Interview, 1:34:50](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5690s)
Jede Kategorie legt eine andere Evaluierung nahe. Ein Auftrag zur Verarbeitung eines Archivs kann Verzögerungen verkraften, braucht aber einen Plan zur Stichprobenkontrolle und zur Rückverfolgung der Ergebnisse auf die Originaldatensätze. Eine Echtzeitschnittstelle braucht vorhersehbare Reaktionszeiten. Ein Prüfsystem, das die Ausgaben eines anderen Modells bewertet, muss anhand der tatsächlichen Fehler dieses Modells getestet werden, auch anhand von Fällen, in denen beide Systeme denselben Fehler machen.
Bei der Computernutzung ist die Auswahl einer Handlung nur ein Teil des Systems. Es braucht außerdem eine genaue Darstellung der Benutzeroberfläche, eine Möglichkeit zur Ausführung der Handlung und eine Prüfung, ob die erwartete Änderung eingetreten ist. Eine überzeugende Vorführung kann belegen, dass eine Abfolge einmal funktioniert hat. Verlässliche Automatisierung erfordert wiederholte Tests und die Wiederherstellung nach Unterbrechungen.
Dieselbe Vorsicht gilt für Spiele. Eine durch ein Modell gesteuerte Spielfigur könnte auf einen umfangreicheren Zustand reagieren, während die Spiel-Engine weiterhin festlegt, welche Aktionen möglich sind. Ob das Spielerlebnis dadurch besser wird, hängt von Reaktionsgeschwindigkeit, Konsistenz und Gestaltung ab. Schlussfolgerungen in jedem einzelnen Bild würden ein Spiel nicht automatisch interessanter machen.
Diese Unterschiede verhindern einen Kategorienfehler: Eine nützliche Komponente sollte für ihre tatsächliche Funktion gewürdigt werden, ohne dass man ihr alle Fähigkeiten der umfassenderen Anwendung zuschreibt.
Feinabstimmung, Bildverarbeitung und weitere Modellformen kommen im Interview als Möglichkeiten zur Sprache. [Interview, 1:10:27](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4227s) sowie [1:26:23](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5183s)
Ein Gespräch über die Produktplanung sollte nicht zur Abhängigkeit in einem Produkteinführungsplan werden. Entwickeln Sie auf Grundlage der verfügbaren Schnittstelle, bestimmen Sie, welche Leistungen eine separate Komponente erbringen muss, und bewerten Sie neue Fähigkeiten, sobald sie tatsächlich verfügbar sind. So bleibt Raum, von künftigen Verbesserungen zu profitieren, ohne Spekulation als Produktmerkmal darzustellen.
## Programmieragenten könnten die Arbeit anders aufteilen
Almeida schlägt eine günstigere Zustandsverarbeitung und einen gemeinsam genutzten Kontext für Programmieragenten vor, die über die Schleife eines einzelnen Modells hinausgehen. [Interview, 1:40:17](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6017s) sowie [2:09:29](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7769s)
Eine mögliche Architektur könnte ein leistungsfähiges Programmiermodell eine Änderung entwickeln lassen, kleinere Entscheidungsaufrufe relevante Dateien klassifizieren und herkömmliche Software die daraus entstehenden Aufgaben verwalten lassen. Ein separater Prüfer könnte den fertigen Patch untersuchen. Das ist ein Architekturvorschlag, keine durch Benchmarks belegte Empfehlung und kein Nachweis, dass Jev bereits einen vorhandenen Programmieragenten ersetzt.
Der attraktive Teil ist der gezielte Kontext. Braucht eine Teilaufgabe nur eine Schnittstelle und einige Einschränkungen, kann es unnötig sein, ihr ein ganzes Gespräch zu übermitteln. Ausdrückliche Aufgabenprotokolle könnten die Feststellung erleichtern, welche Fakten wichtig sind, was bereits entschieden wurde und welche Änderungen noch ausstehen.
Gefährlich wäre es, einen Koordinierungsvorschlag mit einer Garantie für nebenläufige Abläufe zu verwechseln. Zwei Agenten können beide annehmen, dieselbe Datei bearbeiten zu sollen. Ein probabilistisches Modell darf nicht die Softwaremechanismen ersetzen, die widersprüchliche Schreibzugriffe verhindern. Berechtigungen, Versionsprüfungen und Sperren müssen das Ergebnis weiterhin erzwingen.
Ebenso könnte ein günstigerer Abruf früherer Arbeit die Speicherverwaltung verbessern, ohne jedes Problem zu lösen, das als kontinuierliches Lernen bezeichnet wird. Sich an einen früheren Versuch zu erinnern, seinen Fehlschlag zu verstehen und sich zuverlässig auf eine neue Situation einzustellen, sind unterschiedliche Fähigkeiten. Eine aussagekräftige Bewertung würde erledigte Aufgaben, Rückschritte, Konflikte und menschliche Eingriffe untersuchen, nicht einfach Agenten oder Aufrufe zählen.
## Sicherheit durchzieht das System; sie verschwindet nicht
Almeida bevorzugt Sicherheitskontrollen auf Anwendungsebene gegenüber Verweigerungen des Modells; swyx hinterfragt die Folgen. [Interview, 13:11](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=791s) sowie [1:42:29](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6149s)
Hier liegt ein reales Gestaltungsproblem: Eine unbeaufsichtigte Anwendung muss damit umgehen können, dass eine Abhängigkeit eine Anfrage ablehnt, ausfällt oder ein unsicheres Ergebnis liefert. Dafür braucht sie einen klar festgelegten Reaktionsweg. Diese Beobachtung entscheidet jedoch nicht abschließend, wo jede Schutzmaßnahme angesiedelt sein sollte.
Eine Anwendung sollte Zugriffsberechtigungen auch dann durchsetzen, wenn ein Modell die beabsichtigte Handlung korrekt erkannt hat. Eine Aufforderung, einen Datensatz zu löschen, kann völlig eindeutig und trotzdem unbefugt sein. Eine Anfrage kann außerdem technisch gültig sein und dennoch gegen die Richtlinie des Betreibers verstoßen. Ohne geeigneten Kontext kann der Entscheidungsdienst solche Fragen nicht verantwortungsvoll beantworten, und die Anwendung muss die Kontrolle über die Handlung behalten.
Wer mehr Entscheidungen in Software verlagert, macht es daher umso wichtiger, Grenzen vor dem Einsatz festzulegen. Teams müssen entscheiden, welche Belege erforderlich sind, welche Vorgänge rückgängig gemacht werden können und wie ein Mensch ein Ergebnis anfechten oder korrigieren kann. Eine umständliche Interaktion mit einem Modell zu entfernen, beweist noch nicht, dass das Gesamtsystem sicher ist.
## Woran sich eine große Veränderung erkennen ließe
Die Markteinführung ermöglicht ein klar umrissenes Experiment. Wählen Sie einen begrenzten Prozess mit einem beobachtbaren Ergebnis aus. Dokumentieren Sie den heutigen Ablauf, einschließlich Fehlern und der Zeit, die Menschen für deren Behebung aufwenden. Testen Sie eine entscheidungsbasierte Variante anhand repräsentativer Fälle, bevor Sie ihr Handlungsvollmacht erteilen.
Messen Sie den Anteil der Fälle, die ohne Eingriff korrekt abgeschlossen werden, die der Prüfung entgehenden Fehler, den an Menschen weitergeleiteten Arbeitsaufwand und die Gesamtkosten pro abgeschlossenem Fall. Bewahren Sie die ursprünglichen Belege auf, damit Prüfer nachvollziehen können, warum ein Ergebnis akzeptiert wurde. Wiederholen Sie den Vergleich, wenn sich Modell, Richtlinie oder Eingaben verändern.
Die Evaluierung kann zeigen, dass erst ein Teil des Prozesses einsatzbereit ist. Auch das ist ein nützliches Ergebnis. Die routinemäßige Klassifizierung zu automatisieren und mehrdeutige Fälle bei einer erfahrenen Person zu belassen, kann sich lohnen, ohne umfassendere Autonomie zu rechtfertigen.
Jevs Markteinführung und Almeidas Interview liefern eine ehrgeizige Hypothese darüber, wie KI in die Wirtschaft gelangt: Wiederholbare, klar eingegrenzte Entscheidungen können die Software, auf die Menschen bereits angewiesen sind, leistungsfähiger machen. Die nächsten Belege sollten von Systemen kommen, die diese Arbeit über längere Zeit verrichten und dabei Fehler und Ausnahmen vollständig erfassen. So wird aus einer interessanten Modellarchitektur eine Veränderung, die Leser tatsächlich beobachten können.
## Sources
- [Originalinterview bei Latent Space](https://www.youtube.com/watch?v=cFx9Z3ZXca0) — Interview von Latent Space mit Diogo Almeida, veröffentlicht am 21. September 2026. In dieser Analyse finden sich Links mit Zeitmarken.
- [Introducing System One Models & Jev](https://typesafe.ai/blog/introducing-system-one-models-and-jev) — 15. September 2026. Ankündigung des Early Access von Jev durch TypeSafe, einschließlich Leistungsversprechen und Einschränkungen der Evaluierung.
- [Einführung](https://docs.typesafe.ai/introduction) — TypeSafe-Dokumentation zu Eingabezustand und den Fragen Choice, Score und Noul des Modells.
- [Konfidenz](https://docs.typesafe.ai/confidence) — TypeSafe-Dokumentation zur Abgrenzung von Konfidenz und Wahrscheinlichkeit und zur Verwendung von Schwellenwerten in Anwendungen.
- [KI-Einführung](https://docs.typesafe.ai/introduction/machine-learning-primer) — TypeSafes Erläuterung des Trainingsziels und der Bedeutung von Kalibrierung über Gruppen von Prognosen hinweg.
- [Muster](https://docs.typesafe.ai/patterns) — TypeSafe-Beispiele, wie Modellentscheidungen mit Anwendungslogik kombiniert werden können.
- [Introducing Structured Outputs in the API](https://openai.com/index/introducing-structured-outputs-in-the-api/) — 6. August 2024. OpenAIs Einführung schema-beschränkter Ausgaben und deren Einschränkungen.
- [On Calibration of Modern Neural Networks](https://arxiv.org/abs/1706.04599) — Forschungsarbeit von Chuan Guo und Mitautoren aus dem Jahr 2017 zur Kalibrierung neuronaler Netze. Diese Arbeit bewertet Jev nicht.
- [Training language models to follow instructions with human feedback](https://arxiv.org/abs/2203.02155) — InstructGPT-Forschungsarbeit aus dem Jahr 2022, mit Diogo Almeida als Mitautor, zum Befolgen von Anweisungen mithilfe menschlichen Feedbacks.
Der Newsletter von BIG CHANGE
Das große Ganze. In Ihrem Tempo.
Aktuelle Storys über KI und Robotik, beobachtenswerte Veränderungen und praktische Ideen zur Anwendung. Wählen Sie ein tägliches Briefing, eine wöchentliche Zusammenfassung oder eine monatliche Perspektive.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ihr Datenschutz, Ihre Entscheidung.
Notwendiger Speicher schützt die Website und merkt sich Ihre Einstellungen. Optionales Google Analytics bleibt deaktiviert, bis Sie es erlauben. Sie können alle Geschichten auch nur mit notwendigem Speicher lesen. Datenschutzdetails