AI-translated from English; not yet reviewed by a fluent editor.
# NVIDIA veröffentlicht Nemotron 3 Diarization für Audio mit bis zu acht Sprechern
> NVIDIAs Modell zur Sprechererkennung mit offenen Gewichten kennzeichnet seit dem 23. September bis zu acht Sprecher in aufgezeichnetem oder gestreamtem Audio. Die kürzeste empfohlene Einstellung von 0,32 Sekunden bezeichnet gepufferte Eingabe; die Genauigkeitswerte stammen aus eigenen Tests von NVIDIA.
By BIG CHANGE Editorial
Published: 2026-09-27T15:28:31.966Z
Updated: 2026-09-27T15:28:31.966Z
Canonical: https://bigchange.ai/blog/nvidia-nemotron-3-speaker-diarization-model
AI-generated conceptual illustration by BIG CHANGE.
NVIDIA veröffentlichte [Nemotron 3 Diarization](https://huggingface.co/nvidia/Nemotron-3-Diarization) am 23. September. Das Modell mit offenen Gewichten und rund 100 Millionen Parametern markiert, wann bis zu acht Sprecher in aufgezeichnetem oder gestreamtem Audio sprechen. Es liefert Entwicklern Sprecheraktivität und Zeitmarken für eine Unterhaltung. Für ein Transkript mit Wörtern ist zusätzlich Spracherkennung erforderlich.
## Die große Änderung
- **Was sich geändert hat:** NVIDIAs früherer Streaming-Sortformer-Checkpoint unterstützt vier Sprecher. Die neue Version bietet acht in der Reihenfolge ihres Auftretens zugewiesene Sprecherkanäle über einen einzigen Checkpoint, der sowohl mit aufgezeichnetem Audio als auch mit eingehenden Audioblöcken funktioniert.
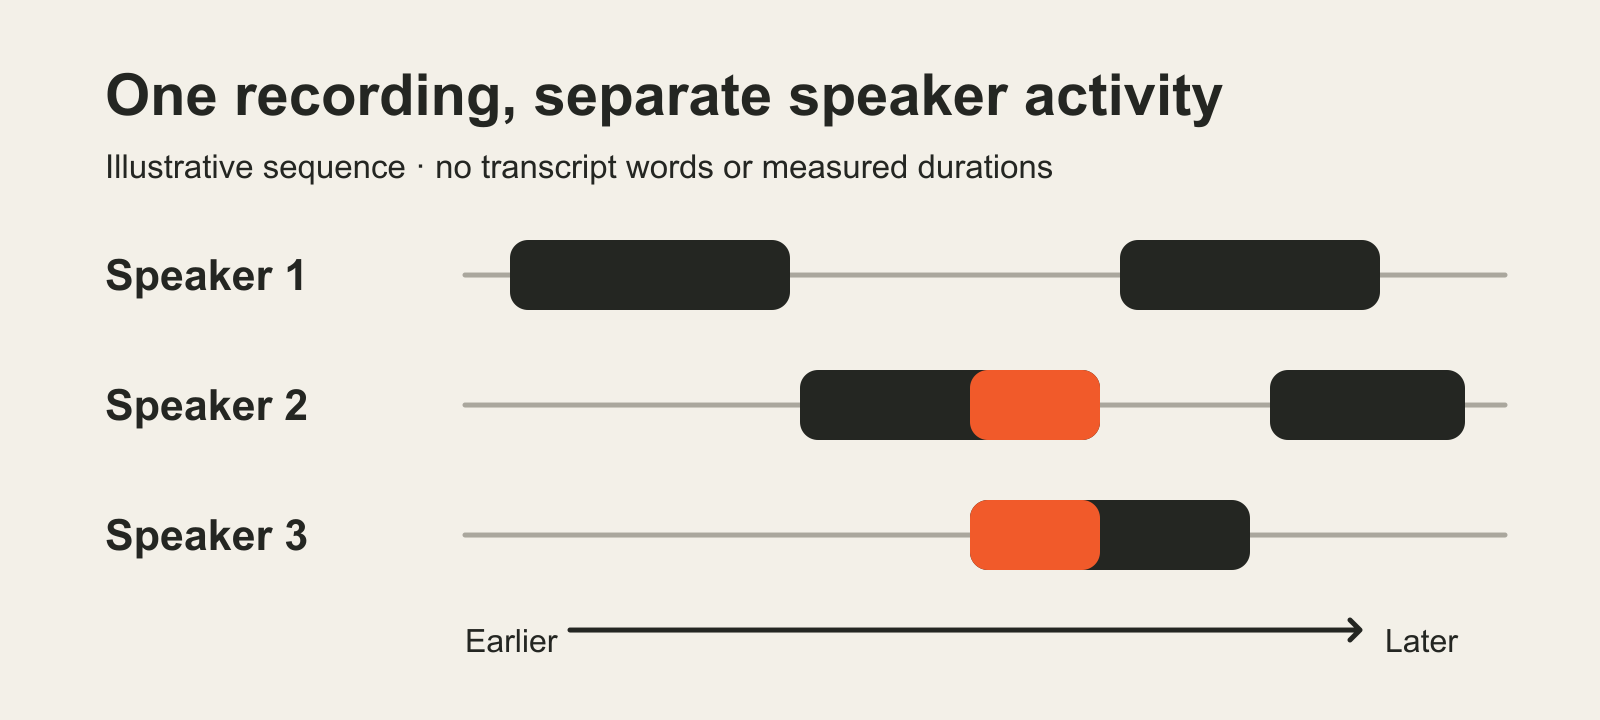
- **Warum das wichtig ist:** Entwickler, die Sitzungen oder Anrufe transkribieren, können mit dem Modell allgemeinen Sprecherkennungen Zeitabschnitte zuordnen – auch bei überlappender Sprache – und diese anschließend mit den Wörtern aus einer separaten Spracherkennung kombinieren. Damit erhöht sich die dokumentierte Obergrenze für Sprecher bei dieser Aufgabe.
- **Worauf es ankommt:** Entscheidend für die Praxis ist, wie viel Audio vor jedem Streaming-Ergebnis gepuffert wird. NVIDIAs kürzeste empfohlene Einstellung wartet 0,32 Sekunden Audio ab, bevor die Berechnung beginnt. Die eigenen Genauigkeitstabellen zeigen, dass diese Einstellung Einbußen mit sich bringt. Teams müssen weiterhin die gesamte Pipeline mit ihren eigenen Aufnahmen messen.
## Welche Ausgabe das Modell liefert
Die [Modellkarte](https://huggingface.co/nvidia/Nemotron-3-Diarization) legt Audio mit 16 kHz und einem Kanal fest. Als Dateiformate nennt sie WAV, FLAC, Opus und MP3; die NeMo-Schnittstelle akzeptiert Dateipfade, Audio-Arrays oder ein JSON-Manifest mit einer Zeile pro Eintrag. Bei Audio-Arrays muss die passende Abtastrate an den `diarize()` Aufruf übergeben werden. Für blockweise Inferenz nennt die Modellkarte keine feste maximale Aufzeichnungsdauer.
Das Modell wandelt Audio in einen `[T, 8]` Tensor mit Wahrscheinlichkeiten für die Aktivität einzelner Sprecher um; die Ausgabe erfolgt standardmäßig in 10-Millisekunden-Schritten. Bei überlappender Sprache können mehrere Kanäle gleichzeitig aktiv sein. Die Nachverarbeitung wandelt diese Wahrscheinlichkeiten in Zeitabschnitte mit Start- und Endzeiten sowie allgemeinen Sprecherkennungen um. Die Kennungen folgen der Reihenfolge, in der Stimmen erstmals auftreten; sie identifizieren Personen nicht namentlich. NVIDIA nutzt einen Sprecher-Cache für frühere Audioblöcke und eine First-in-first-out-Warteschlange für jüngere Frames, damit das Streaming-Modell den Kontext behält.
Für Entwickler, die ein Transkript mit Sprecherkennungen benötigen, ist dieser Unterschied entscheidend. [NVIDIAs Integrationsleitfaden](https://huggingface.co/blog/nvidia/nemotron-diarization) verknüpft Zeitmarken der Sprechererkennung mit einer separaten automatischen Spracherkennung. Die dort vorgestellte Zuordnungsregel anhand des Wortmittelpunkts lässt ein Wort ohne zugeordneten Sprecher, wenn gerade kein Sprecher aktiv ist, und kennzeichnet gleichzeitige Aktivität als mehrdeutig. Das Sprechererkennungsmodell allein entscheidet nicht, welche überlappende Stimme ein erkanntes Wort gesprochen hat.
## Pufferzeit ist nicht gleich Antwortzeit
NVIDIA empfiehlt Eingabepuffer von 30,4, 1,04, 0,64 und 0,32 Sekunden. Die Einstellung von 0,32 Sekunden besteht aus drei Verarbeitungsframes zu je 80 Millisekunden und einem 80-Millisekunden-Frame als Kontext nach dem aktuellen Zeitpunkt. Die [Modellkarte definiert die Latenz ausdrücklich](https://huggingface.co/nvidia/Nemotron-3-Diarization) als die Zeit, in der Audio vor der Inferenz zurückgehalten wird; die Berechnungszeit ist darin nicht enthalten. Ein Transkriptionssystem verursacht außerdem Zeitaufwand für Erkennung, Übertragung und Anwendung.
Der dokumentierte NeMo-Weg erfordert Python 3.12 oder höher, Cython, eine aktuelle PyTorch-Version und NeMo Speech. NVIDIA stellt ein `SortformerEncLabelModel.from_pretrained()` Beispiel, einen `diarize()` Aufruf mit Sprecherabschnitten sowie einen Schalter zur Ausgabe von Wahrscheinlichkeitstensoren bereit. Laut Modellkarte wird ein Hugging-Face-Token benötigt, um den gehosteten Checkpoint über diesen NeMo-Aufruf zu laden. Außerdem sind eine Offline- und eine Streaming-Schnittstelle für Transformers dokumentiert, die aus dem Quellrepository von Transformers installiert wird, sowie ein [Befehlszeilenweg über NeMo-Speech.cpp](https://github.com/NVIDIA/NeMo-Speech.cpp/blob/main/docs/cli.md). Das sind dokumentierte Schnittstellen; BIG CHANGE hat sie nicht ausgeführt. Für die NeMo-Integration nennt die Modellkarte Linux sowie NVIDIA-GPU-Familien der Generationen Ampere, Hopper und Blackwell. Der Hardwarebedarf und die Verarbeitungskosten einer konkreten Arbeitslast hängen vom gewählten Weg und Gerät ab; NVIDIA nennt in der Modellkarte keinen Betriebspreis pro Stunde.
Die Gewichte stehen unter der [OpenMDW-Lizenz 1.1](https://openmdw.ai/license/1-1/). Die Lizenz erlaubt Nutzung, Änderung und Weitergabe ohne Lizenzgebühr, vorbehaltlich ihrer Bedingungen. Bei einer Weitergabe müssen die Lizenz und die jeweils geltenden Herkunftshinweise erhalten bleiben. Die Lizenz schränkt die Nutzung oder Weitergabe erzeugter Ausgaben nicht ein und überträgt den Nutzern die Verantwortung, nötige Rechte und Einwilligungen für ihre Audiodateien einzuholen. NVIDIA beschreibt das Modell als kommerziell und nicht kommerziell nutzbar.
## Was NVIDIA gemessen hat
NVIDIAs [Auswertung in der Modellkarte](https://huggingface.co/nvidia/Nemotron-3-Diarization) vergleicht Nemotron 3 mit dem früheren Streaming-Sortformer v2.1 für vier Sprecher. Für den vollständigen Evaluierungssatz DIHARD III gibt NVIDIA eine Sprechererkennungsfehlerrate von 13,18 Prozent für Nemotron 3 bei einem Eingabepuffer von 1,04 Sekunden an. Beim früheren Modell seien es bei derselben angegebenen Puffereinstellung 19,60 Prozent. Für Nemotron 3 beträgt der Wert bei 0,32 Sekunden 13,55 Prozent. Die Sprechererkennungsfehlerrate umfasst übersehene Sprache, Fehlalarme und Sprecherverwechslungen, geteilt durch die Referenzsprechzeit. Ein niedrigerer Wert ist besser.
Diese Werte gelten für ein klar definiertes Prüfverfahren. NVIDIA zufolge berücksichtigen alle eigenen Auswertungen überlappende Sprache. DIHARD III verwendet einen Randabstand („Collar“) von null Sekunden, während CALLHOME-Part2 einen Abstand von 0,25 Sekunden nutzt. Für AMI, AliMeeting und NOTSOFAR1 verwendet NVIDIA verknüpfte, per Forced Alignment zeitlich angepasste Referenzannotationen statt der ursprünglichen Segmentkennzeichnungen. Eine Änderung dieser Kennzeichnungen verändert die Werte. Die [Anleitung zur Evaluierung](https://huggingface.co/nvidia/Nemotron-3-Diarization/blob/main/diarization_evaluation.md) nennt das NeMo-Skript und verlangt für einen vergleichbaren Durchlauf eine RTTM-Referenzdatei, Einstellungen für Überlappungen und Randabstände, Streaming-Konfigurationen und Angaben zur Nachverarbeitung. NVIDIAs Messungen der Inferenzgeschwindigkeit verwendeten BF16 auf einer RTX PRO 5000, mit und ohne `torch.compile()`. Das sind vom Anbieter berichtete Tests, keine Reproduktion durch BIG CHANGE.
Die Obergrenze von acht Sprechern ist weiterhin relevant. DIHARD III enthält Aufnahmen mit bis zu neun annotierten Sprechern. Laut Modellkarte kann Sprache oberhalb der acht Kanäle des Modells übersehen oder einem anderen Kanal zugeordnet werden. Für AMI-Testaufnahmen meldet NVIDIA eine niedrigere Sprechererkennungsfehlerrate bei Nemotron 3 als bei der früheren Vergleichsversion, aber zugleich eine geringere Genauigkeit bei der exakten Sprecherzahl. Die Genauigkeit hängt daher von Aufgabe, Messgröße und Audio ab. Ein Team, das eine Integration erwägt, kann bei den veröffentlichten Schnittstellen von NVIDIA beginnen und die vollständige Pipeline aus Sprechererkennung und Transkription mit Aufnahmen testen, die dem vorgesehenen Einsatz entsprechen.
## Sources
- [NVIDIA: Modellkarte zu Nemotron 3 Diarization](https://huggingface.co/nvidia/Nemotron-3-Diarization) — Zentrale Spezifikation für Veröffentlichungsdatum, Größe der 100-Millionen-Parameter-Klasse, Eingaben, Ausgaben, Streaming-Konfigurationen und NVIDIA-Auswertungstabellen. Genauigkeits- und Geschwindigkeitsmessungen stammen vom Anbieter; die angegebene Einstellung von 0,32 Sekunden bezeichnet die Eingabepufferzeit und schließt die Berechnung aus.
- [NVIDIA: Ankündigung „Know Who Spoke When“](https://huggingface.co/blog/nvidia/nemotron-diarization) — Die datierte Veröffentlichungsbeschreibung erläutert Sprecherkanäle in der Reihenfolge ihres Auftretens und zeigt, wie allgemeine Sprecherabschnitte mit einer separaten Spracherkennung kombiniert werden können. Das Zuordnungsbeispiel anhand des Wortmittelpunkts kennzeichnet Überlappungen als mehrdeutig und ist eine einfache Heuristik, kein validiertes Transkriptionsergebnis.
- [NVIDIA: Unterkarte zur Diarisierungsevaluierung](https://huggingface.co/nvidia/Nemotron-3-Diarization/blob/main/diarization_evaluation.md) — Nennt das NeMo-Auswertungsskript, die erforderliche RTTM-Referenz, Regeln zu Überlappungen und Randabständen sowie die Angaben, die für eine vergleichbare Sprechererkennungsfehlerrate nötig sind. Es handelt sich um ein Prüfprotokoll, nicht um eine unabhängige Reproduktion.
- [OpenMDW-Lizenzvereinbarung, Version 1.1](https://openmdw.ai/license/1-1/) — Maßgebliche Nutzungsrechte und Pflichten: kostenlose Nutzung und Weitergabe von Modellmaterialien unter den Bedingungen der Lizenz, Beibehaltung der Lizenz und Herkunftshinweise bei Weitergabe, keine Einschränkung für erzeugte Ausgaben und Verantwortung der Nutzer für notwendige Rechte und Einwilligungen.
- [NVIDIA NeMo-Speech.cpp: Befehlszeilenleitfaden](https://github.com/NVIDIA/NeMo-Speech.cpp/blob/main/docs/cli.md) — Dokumentiert die lokale Sprechererkennung über die Kommandozeile und den Wechsel von der Vier-Sprecher-Grenze der Vorgängerversion V2 auf acht Sprecher bei V3. Die Unterstützung der Kommandozeile belegt weder, dass diese Redaktion das Modell ausgeführt hat, noch die NeMo-Benchmarkgeschwindigkeit aus der Modellkarte.
Der Newsletter von BIG CHANGE
Das große Ganze. In Ihrem Tempo.
Aktuelle Storys über KI und Robotik, beobachtenswerte Veränderungen und praktische Ideen zur Anwendung. Wählen Sie ein tägliches Briefing, eine wöchentliche Zusammenfassung oder eine monatliche Perspektive.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ihr Datenschutz, Ihre Entscheidung.
Notwendiger Speicher schützt die Website und merkt sich Ihre Einstellungen. Optionales Google Analytics bleibt deaktiviert, bis Sie es erlauben. Sie können alle Geschichten auch nur mit notwendigem Speicher lesen. Datenschutzdetails