AI-translated from English; not yet reviewed by a fluent editor.
# Im Programmier-Test von Vals AI gewann ein Agententeam 7,3 Punkte bei 2,5-fachen Kosten
> Vals AI stellte einen statistisch signifikanten Teamgewinn nur bei GPT 6 Sol mit mittlerem Aufwand über 50 App-Builds fest; diese Konfiguration kostete 3,07 $ statt 1,22 $ pro App.
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
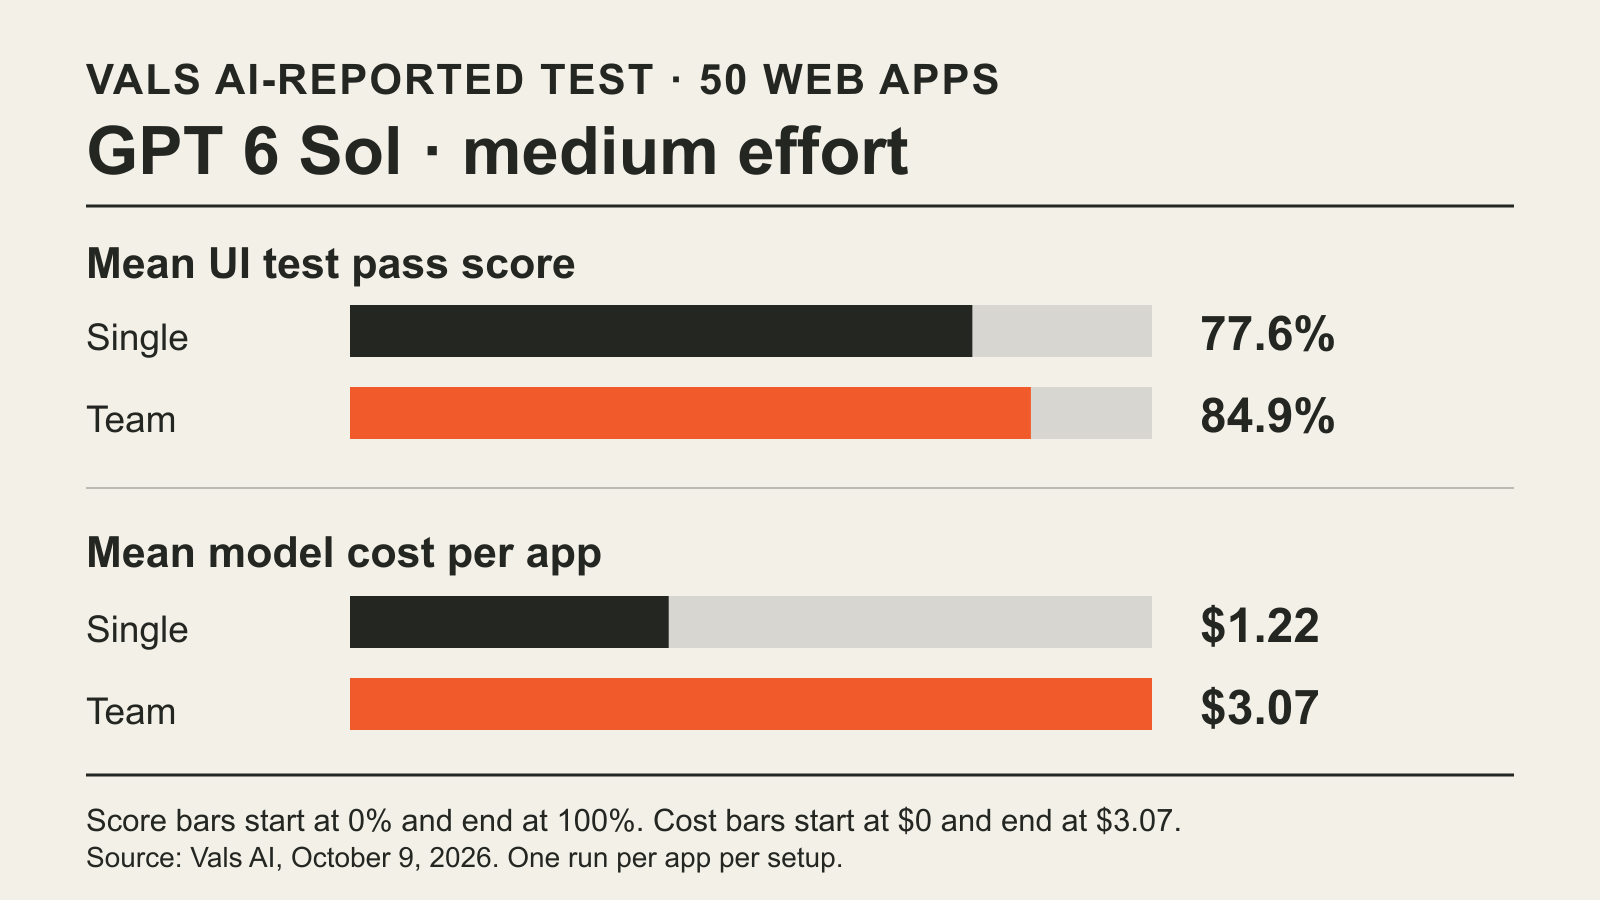
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
In der am 9. Oktober veröffentlichten Studie von [Vals AI zu Vibe Code Bench](https://www.vals.ai/blogs/multi-agent-vibe-code-bench). Ein GPT-6-Sol-Team mit mittlerem Reasoning-Aufwand bestand 84,9 % der App-Tests des Benchmarks, gegenüber 77,6 % bei einem einzelnen Sol-Agenten. Der Zuwachs von 7,3 Prozentpunkten kostete durchschnittlich 3,07 $ statt 1,22 $ pro App. Vals meldete für den Zuwachs ein 95-%-Intervall von 2,3 bis 12,4 Punkten und einen p-Wert von 0,005 im gepaarten Test. Bei keinem der drei anderen Vergleiche zwischen Team und Einzelagent zeigte sich ein statistisch signifikanter Punktunterschied.
Das Ergebnis liefert Entwicklern eine genauere Budgetfrage als die, ob Teams „besser“ sind. Bei dieser Auswahl von Web-App-Builds brachte Sol mit mittlerem Aufwand einen messbaren Qualitätsgewinn für rund 1,85 $ mehr pro App, bei nahezu gleicher medianer Laufzeit. Bei höherem Aufwand und mit Claude Opus 5.5 bei beiden Aufwandsstufen belegten die zusätzlichen Teamkosten in diesem Test keine Punktverbesserung.
## Die große Veränderung
- **Was sich geändert hat:** Vals verglich einzelne Programmieragenten mit Teams bei denselben 50 Web-App-Aufgaben und zwei Reasoning-Stufen. Nur Sol mit mittlerem Aufwand erzielte einen statistisch signifikanten Team-Punktgewinn.
- **Warum es wichtig ist:** Die siegreiche Teamkonfiguration kostete pro App 2,5-mal so viel; die anderen Teams kosteten das 1,8- bis 5,1-Fache, ohne einen signifikanten Punktgewinn. Teamdesign und Modelleinstellungen gehören zur selben Kaufentscheidung.
- **Worauf zu achten ist:** Wiederholte Durchläufe und Tests mit anderen Softwareaufgaben könnten zeigen, ob der Gewinn über diese konkreten Apps hinaus verlässlich ist. In dieser Studie wurde jede Konfiguration nur einmal ausgeführt.
## Was die acht Durchläufe maßen
Vals bat GPT 6 Sol und Claude Opus 5.5, anhand von Produktspezifikationen 50 vollständige Web-Apps zu erstellen. Die Apps wurden mit Docker Compose bereitgestellt und von Browseragenten anhand von UI-Tests bewertet. Der berichtete Wert ist der durchschnittliche Anteil der Tests jeder App, die bestanden wurden. Die [Benchmark-Methode](https://www.vals.ai/benchmarks/vibe-code) besagt, dass jede App-Spezifikation 20 bis 60 automatisierte Tests enthält und ein Test als bestanden gilt, wenn mindestens 90 % seiner Schritte erfolgreich sind.
Für jedes Modell verglich Vals einen einzelnen Agenten mit einem Leiter, der bei mittlerem und maximalem Reasoning-Aufwand gleichzeitig an bis zu fünf Subagenten delegieren konnte. Zusätzlich sollten die Leiter die Arbeit aufteilen, delegieren, zusammenführen und überprüfen. Aufgabenprompt, Sandbox und Bewertung blieben innerhalb jedes Modellvergleichs gleich. Jede der acht Konfigurationen erstellte jede der 50 Apps einmal.
| Modell und Aufwand | Einzelwert | Teamwert | Durchschnittskosten pro App: einzeln → Team | Medianlaufzeit: einzeln → Team |
| --- | --- | --- | --- | --- |
| GPT 6 Sol, mittel | 77,6 % | 84,9 % | 1,22 $ → 3,07 $ | 12,4 → 11,9 Min. |
| GPT 6 Sol, maximal | 89,0 % | 90,4 % | 4,82 $ → 8,54 $ | 38,4 → 27,6 Min. |
| Claude Opus 5.5, mittel | 91,5 % | 91,2 % | 4,08 $ → 9,10 $ | 20,3 → 26,6 Min. |
| Claude Opus 5.5, maximal | 89,8 % | 93,2 % | 23,77 $ → 122 $ | 74,7 → 174,1 Min. |
Das sind laut Vals durchschnittliche Modellkosten für den Aufbau einer App, keine Abonnementpreise oder Kosten pro bestandenem UI-Test. Die Laufzeiten sind Mediane der verstrichenen Zeit; Kosten und Dauer einer Zeile fassen die 50 Durchläufe also unterschiedlich zusammen. Der Mittelwert des Opus-Teams mit maximalem Aufwand enthält einen abgelaufenen Durchlauf, dessen Kosten Vals anhand der Tokenzahl auf ungefähr 189 $ schätzte.
## Warum das Ergebnis von der Konfiguration abhängt
Vals verglich jedes Team mit dem passenden Einzelagenten auf denselben Apps mithilfe eines gepaarten t-Tests. Das Sol-Team mit maximalem Aufwand gewann 1,4 Punkte, bei einem 95-%-Intervall von −1,7 bis 4,5 Punkten. Das Opus-Team mit mittlerem Aufwand lag 0,3 Punkte niedriger, bei einem Intervall von −3,2 bis 2,5; bei maximalem Aufwand gewann es 3,4 Punkte, bei einem Intervall von −1,4 bis 8,3. Diese Intervalle schließen einen Gewinn von null ein. Sie beweisen nicht, dass Teams diesen Konfigurationen nie helfen, aber dieses Experiment belegte keinen Gewinn.
Bei Sol war der Reasoning-Aufwand eine weitere getestete Wahl. Als ein einzelner Sol-Agent von mittlerem auf maximalen Aufwand wechselte, stieg sein Wert von 77,6 % auf 89,0 %; Vals bezeichnet das als statistisch signifikant. Dieser Einzelagent mit maximalem Aufwand kostete 4,82 $ pro App und hatte eine mediane Laufzeit von 38,4 Minuten, gegenüber 3,07 $ und 11,9 Minuten beim Team mit mittlerem Aufwand. Der Punktunterschied von 4,1 zwischen diesen beiden Konfigurationen war statistisch nicht signifikant (p = 0,08). Die Zahlen zeigen Entwicklern den gemessenen Preis-Zeit-Kompromiss, ohne vorauszusetzen, dass eine Konfiguration bei einem neuen Projekt gewinnt.
Auch die Teams teilten ihre Zeit unterschiedlich ein. Laut Vals delegierte Sols Leiter früh und testete die zusammengesetzte App selbst. Sein Team mit maximalem Aufwand beendete den Durchlauf nach median 27,6 Minuten, gegenüber 38,4 Minuten beim Einzelagenten. Opus-Leiter formulierten eher einen gemeinsamen Vertrag und delegierten in Wellen. Bei maximalem Aufwand benötigte das Team median 174,1 Minuten gegenüber 74,7 Minuten beim Einzelagenten und kostete pro App ungefähr fünfmal so viel. Vals führt einen großen Teil der Zusatzkosten auf zwischengespeicherte Eingabetokens in den getrennten Kontexten der Subagenten zurück.
## Wie weit diese Erkenntnis trägt
Die Signifikanzintervalle spiegeln Unterschiede zwischen den 50 Apps wider, nicht Schwankungen zwischen wiederholten Versuchen derselben App. Ein anderer Durchlauf könnte den Vergleich ändern. Die Teamläufe erhielten außerdem die zusätzliche Delegationsanweisung; das Experiment untersuchte daher die Kombination aus Team und Anweisung. Sol nutzte die OpenAI Agents API, Opus Claude Code; Modellvergleiche vermischen somit auch unterschiedliche Harnesses. Vals’ Kostenschätzungen für Sol setzen voraus, dass die gemeldete Tokenverwendung Subagenten einschließt, und berücksichtigen keinen möglichen Aufpreis für Anfragen über der Langkontextschwelle, da Nutzungsdaten auf Anfrageebene fehlten.
Die Studie stützt eine begrenzte Entscheidung: Beim Aufbau ähnlicher Full-Stack-Apps mit diesen Konfigurationen zeigte ein Sol-Team mit mittlerem Aufwand einen messbaren Gewinn bei höheren Kosten, während die anderen Teams keinen verlässlichen Punktgewinn zeigten. Sie klärt nicht, ob sich Teams bei einer anderen Codebasis, einem anderen Modell oder einem Arbeitsablauf mit anderer Aufgabenaufteilung und Prüfung lohnen. BIG CHANGE hat den veröffentlichten Vals-Beitrag und seine Methode geprüft; den Benchmark selbst hat BIG CHANGE weder ausgeführt noch reproduziert.
## Sources
- [Vals AI, Lohnt sich der Einsatz von Agententeams? Eine Fallstudie zu Vibe Code Bench](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — Bericht des Originalexperiments. Seine Werte, Kosten, Laufzeiten, Intervalle und p-Werte der gepaarten Tests, Teamverhalten, Implementierungsdetails und Einschränkungen stützen den Artikel. Jede der acht Konfigurationen lief einmal auf jeder der 50 Apps; die berichtete Unsicherheit variiert zwischen Apps, nicht zwischen Wiederholungsversuchen.
- [Vals AI, Methodik von Vibe Code Bench v1.1](https://www.vals.ai/benchmarks/vibe-code) — Beschreibung und Methodik des verlinkten Benchmarks: App-Spezifikationen, 20–60 UI-Tests pro App und Bewertungsregeln. Die allgemeine Rangliste verwendet andere Harness-Konfigurationen und ersetzt nicht die Ergebnisse der Fallstudie zu Agententeams.
- [The Decoder, KI-Agententeams verschwenden massenhaft Tokens für kaum messbare Qualitätsgewinne, zeigt eine Studie](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — Unabhängige zeitgenössische Berichterstattung, die zur Entdeckung und Einordnung diente. Die Zahlen und methodischen Aussagen des Artikels werden anhand des Originalberichts von Vals geprüft; BIG CHANGE übernimmt die weiter gefasste Schlussfolgerung der Überschrift nicht.
Der Newsletter von BIG CHANGE
Das große Ganze. In Ihrem Tempo.
Aktuelle Storys über KI und Robotik, beobachtenswerte Veränderungen und praktische Ideen zur Anwendung. Wählen Sie ein tägliches Briefing, eine wöchentliche Zusammenfassung oder eine monatliche Perspektive.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ihr Datenschutz, Ihre Entscheidung.
Notwendiger Speicher schützt die Website und merkt sich Ihre Einstellungen. Optionales Google Analytics bleibt deaktiviert, bis Sie es erlauben. Sie können alle Geschichten auch nur mit notwendigem Speicher lesen. Datenschutzdetails