AI-translated from English; not yet reviewed by a fluent editor.
# La programación con IA convierte la entrega fiable en el próximo reto de ingeniería
> Cuando la IA aumenta la producción de código, los responsables de ingeniería necesitan saber dónde se esperan los cambios, cuánto cuesta validarlos y si el software publicado funciona como se espera.
By BIG CHANGE Editorial
Published: 2026-09-22T05:31:05.772Z
Updated: 2026-09-22T05:31:05.772Z
Canonical: https://bigchange.ai/blog/ai-coding-ci-bottleneck-dependable-delivery
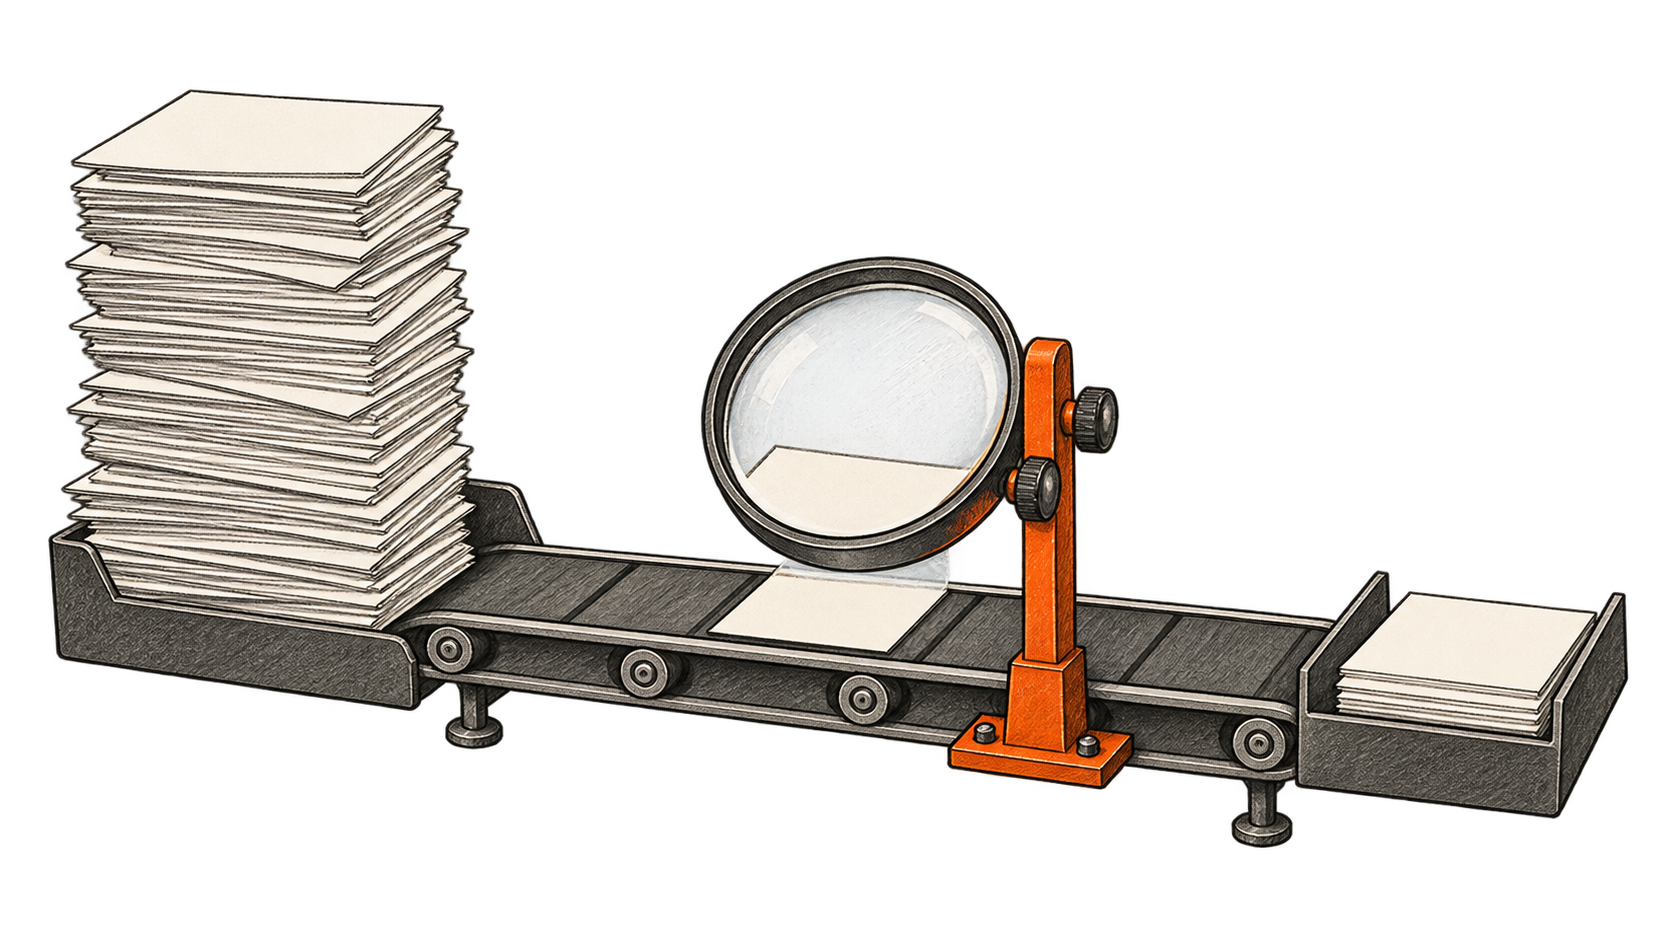
AI-generated conceptual illustration by BIG CHANGE. More proposed changes can put pressure on validation. Conceptual illustration of a queue and inspection stage; stack sizes are not measurements, and passing checks does not guarantee dependable delivery.
Un agente de programación con IA puede terminar un parche mientras aún se ejecutan las comprobaciones del parche anterior. Para quien dirige ingeniería, esto crea una distinción incómoda: el equipo ha producido más código, pero el cliente aún no ha recibido nada.
Linear ofrece un caso útil. En un informe de ingeniería del 21 de septiembre, Mufeez Amjad cuenta que sus conjuntos de pruebas casi se cuadruplicaron desde principios de 2026, mientras que las esperas de integración continua en las solicitudes de cambios bajaron de más de seis minutos a poco más de cinco. El tiempo de ejecución por prueba en los ejecutores se redujo aproximadamente a la mitad. Son mejoras distintas; la última cifra no significa que se haya reducido a la mitad la factura total de CI. Linear atribuye a la programación asistida por agentes la creciente presión sobre la validación, pero su relato no es un experimento controlado que demuestre el efecto de productividad de la IA. [Informe de ingeniería de Linear](https://linear.app/now/ci-bottleneck-reworked).
La integración continua, o CI, ejecuta comprobaciones automatizadas en los cambios de software propuestos. Se sitúa entre un parche plausible y un cambio que el equipo está dispuesto a aceptar. Cuando la programación con IA aumenta la cantidad de parches, la capacidad de revisión se convierte en una cuestión empresarial: ¿cuánto trabajo útil puede absorber la organización de forma segura?
A nuestro juicio, los responsables deberían hacer visibles a la vez tres resultados: el tiempo necesario para obtener información fiable, el trabajo informático total y la fiabilidad de los cambios publicados. Una respuesta más rápida solo es valiosa si el equipo entiende qué demuestra.
## Esperar menos puede requerir más trabajo
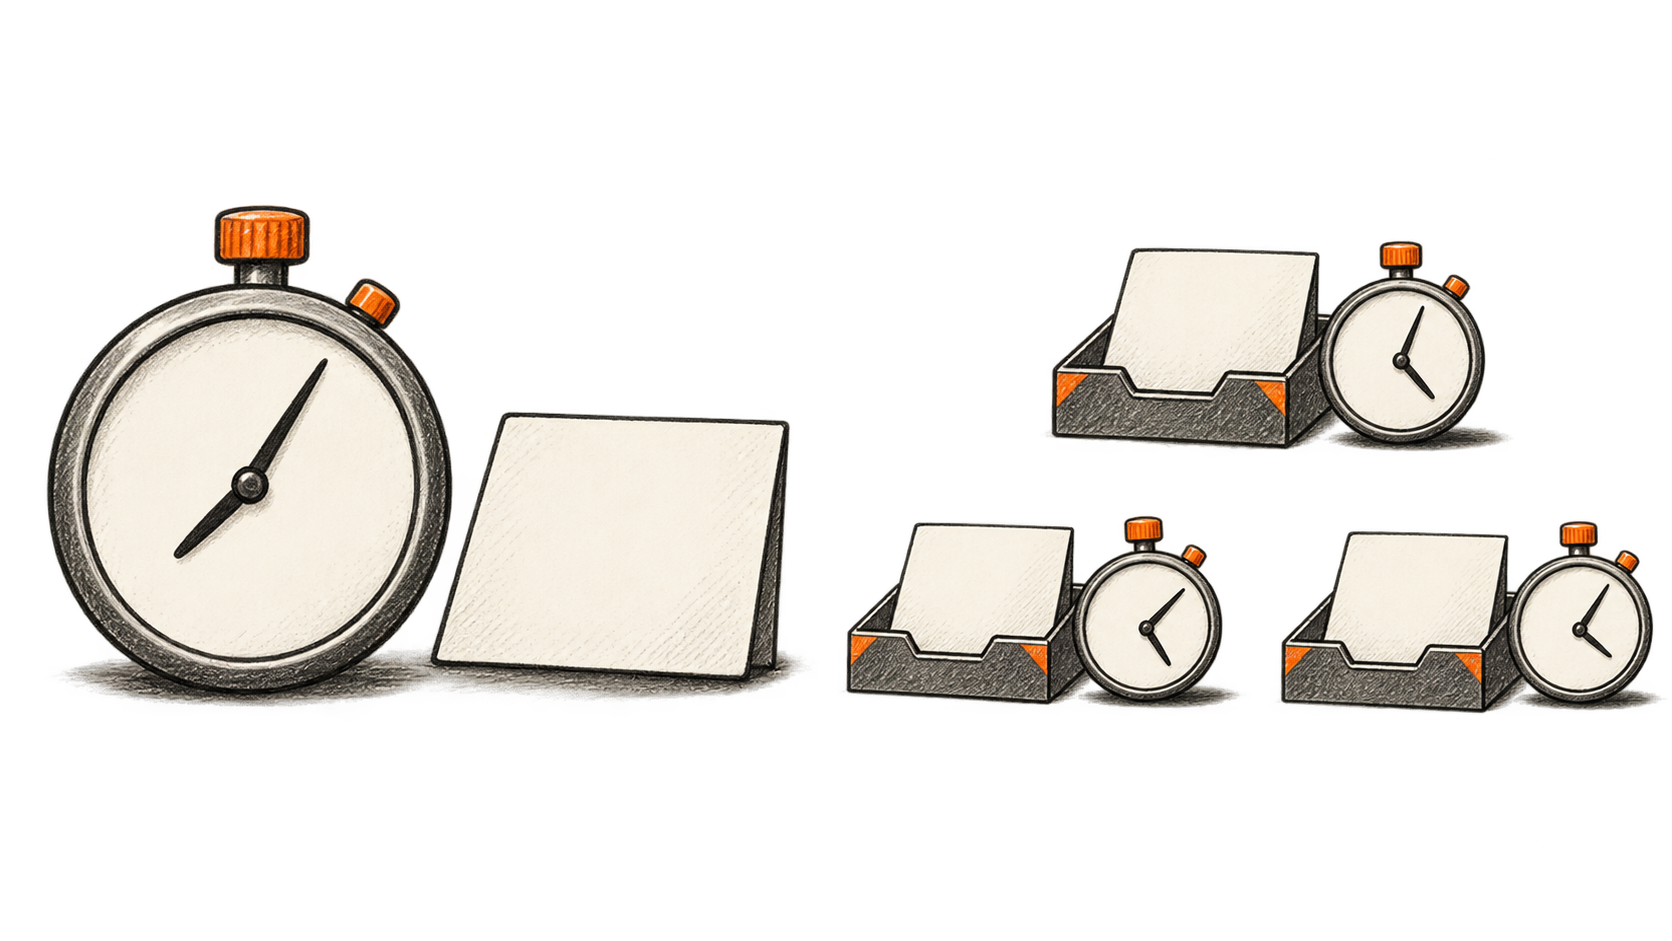
Imaginemos un conjunto de pruebas que tarda doce minutos en ejecutarse en una máquina. Dividirlo de forma equitativa entre cuatro máquinas podría reducir el tiempo a tres minutos. Este ejemplo hipotético supone un reparto perfecto e ignora todo lo demás. Las máquinas siguen ejecutando doce minutos de trabajo en total.
Ahora añadamos un minuto de preparación para cada máquina. La versión de cuatro máquinas tarda cuatro minutos y consume dieciséis minutos de ejecutor. La versión de una máquina tarda trece minutos y consume trece minutos de ejecutor. La espera mejora mucho mientras aumenta el consumo total de máquinas. Los cargos reales también dependen del tipo de ejecutor, los precios y las reglas de facturación.
Esta distinción importa cuando un panel celebra una barra verde más corta. Al adquirir capacidad paralela, la empresa paga por obtener antes los resultados, posiblemente con un coste adicional. Puede ser un buen intercambio si elimina una limitación real. Cuesta más justificarlo cuando el cambio terminado espera horas a que haya una persona disponible para revisarlo.
El análisis debería abarcar algo más que una ejecución de CI. Un parche que provoca revisiones reiteradas, nuevas ejecuciones y una segunda ronda de revisión puede consumir mucho más trabajo de lo que su ejecución individual más rápida sugiere. Cuenta los intentos necesarios para aceptar un cambio, incluidos los abandonados. De lo contrario, una canalización que parece eficiente puede ocultar un proceso de desarrollo costoso.
Tampoco cada minuto de espera equivale a un coste laboral. Si un desarrollador empieza otra tarea útil mientras se ejecutan las comprobaciones, no necesariamente ha perdido todo ese intervalo. Las interrupciones repetidas y el regreso a tareas sin terminar sí pueden perjudicar. Para medir esos efectos hay que observar cómo trabaja el equipo, no multiplicar los minutos transcurridos por los salarios.
## La investigación muestra un panorama mixto
El análisis de DORA de marzo de 2026 presenta dos conjuntos de pruebas distintos. Su investigación de 2025 asoció una mayor adopción de IA tanto con más entregas de software como con mayor inestabilidad. Por separado, los investigadores analizaron 1.110 respuestas abiertas de ingenieros de Google recopiladas durante el tercer trimestre de 2025. Los ingenieros describieron ayudas para redactar y realizar otras tareas, junto con trabajo adicional de verificación. El estudio cualitativo interno no corresponde a la población de la asociación general de DORA, y ninguno de los dos demuestra que la IA causara problemas en las versiones de un equipo concreto. [Análisis y metodología de DORA](https://dora.dev/insights/balancing-ai-tensions/).
También hay pruebas experimentales más sólidas, pero de alcance más limitado. En el estudio aleatorizado de julio de 2025 de METR, se asignaron 246 tareas a 16 desarrolladores experimentados de código abierto que trabajaban en repositorios conocidos. Al permitir herramientas de IA de principios de 2025, las tareas tardaron un 19 % más en completarse. Aun así, los participantes creían que la IA les había ayudado a trabajar más rápido. El hallazgo se refiere a esos desarrolladores, esas tareas y esas herramientas; no permite determinar el valor de todos los agentes de programación disponibles hoy. [Experimento original de METR](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/).
En febrero de 2026, METR dijo que su estudio de seguimiento había producido una estimación poco fiable de los efectos actuales sobre la productividad. Cada vez más desarrolladores rechazaban tareas que no pudieran realizar con IA o elegían cuáles presentar; además, los agentes concurrentes complicaban la medición del tiempo. Los investigadores consideraron plausible que la aceleración fuera mayor, pero dijeron que los datos solo aportaban pruebas débiles sobre su magnitud. Repetir la antigua cifra de ralentización sin esta salvedad induciría a error. [Estudio de seguimiento de METR](https://metr.org/blog/2026-02-24-uplift-update/).
Para quien dirige un equipo, estos estudios justifican una postura práctica: conservar las herramientas útiles, investigar sus efectos y evitar convertir tanto el entusiasmo como el escepticismo en una fórmula universal para determinar la plantilla. Un equipo puede obtener grandes beneficios en una clase de trabajo y perder tiempo en otra. El proceso de entrega debe permitir ver esa diferencia.
## Asigna a cada limitación su propia solución
Antes de comprar más capacidad de CI, sigue un cambio desde el primer parche propuesto hasta producción. Distingue el trabajo que se ejecuta del que está esperando. Identifica qué comprobación retrasa realmente una decisión, qué persona debe revisarla y qué condiciones de publicación siguen pendientes.
Un registro sencillo de tiempos suele bastar para revelar una inversión equivocada. Si la mayor parte de la demora ocurre antes de que empiece la revisión, reducir unos segundos el tiempo de las pruebas no resolverá el problema. Si los revisores esperan repetidamente a que termine una comprobación larga y obligatoria, mejorarla tiene un propósito directo. Si los fallos se producen sobre todo después de la implementación, el equipo debe examinar qué aspectos no detectan las pruebas.
El almacenamiento en caché de dependencias muestra por qué hay que medir incluso una optimización conocida. GitHub explica que la caché permite reutilizar archivos costosos de volver a crear en ejecutores limpios. También indica que los trabajos deben poder recrear o descargar esos archivos cuando la caché no está disponible. Por tanto, el comportamiento de la caché debe evaluarse tanto cuando funciona como cuando falla. [Documentación de GitHub sobre la caché de dependencias](https://docs.github.com/en/actions/concepts/workflows-and-actions/dependency-caching).
Para quien dirige el equipo, la pregunta útil es cuán predecibles se vuelven los resultados. Un promedio excelente puede coexistir con alguna espera prolongada que interrumpa una versión. Sigue los casos más lentos de la distribución y distingue un fallo de prueba legítimo de una descarga fallida o de la falta de ejecutores. Cada problema requiere una respuesta distinta.
Una respuesta fiable y rápida da tanto a las personas como a los agentes más oportunidades de corregir errores. Mejorar esa infraestructura compartida puede beneficiar muchos tipos de desarrollo, incluidos los cambios escritos sin IA. Esto da a los responsables motivos para financiarla aunque cambien las herramientas de programación que elijan.
## Las pruebas más rápidas también deben detectar errores
Algunos cambios de rendimiento alteran las condiciones en que se ejecuta una prueba. Eso merece más atención que un procesador más rápido.
Vitest, una herramienta de pruebas para JavaScript y TypeScript, aísla de forma predeterminada los archivos de prueba para impedir que el estado de uno afecte a otro. Su documentación describe cómo desactivar el aislamiento de forma selectiva en pruebas adecuadas, e identifica el estado mutable de los módulos, las variables globales modificadas y otras dependencias como motivos para mantenerlo. Por tanto, un ajuste que reduce el tiempo de preparación también puede cambiar una barrera de corrección. [Guía de aislamiento de Vitest](https://vitest.dev/guide/recipes/disable-isolation).
Linear adoptó un método opcional para compartir el estado, añadió tareas de limpieza y mantuvo el aislamiento en los archivos que no podía trasladar de forma segura. La mejora de rendimiento dependió de decidir qué pruebas podían compartir ese entorno sin riesgos. [Implementación de Linear](https://linear.app/now/ci-bottleneck-reworked).
Hay otro reto cuando un agente escribe tanto un cambio como sus pruebas. Imaginemos una regla de descuentos hipotética que solo se aplica a las suscripciones anuales. Un agente podría implementarla por error también para los planes mensuales y luego escribir pruebas que confirmen su propia interpretación. Superar esas pruebas solo demostraría que el código es coherente con el error.
El revisor necesita pruebas basadas en elementos ajenos a esa implementación: el requisito acordado, ejemplos del comportamiento esperado y casos que deberían fallar. Pedirle más pruebas a un agente puede ayudar, pero un número mayor de pruebas no demuestra por sí solo que se haya cuestionado una interpretación equivocada del requisito. La responsabilidad humana consiste en decidir qué debe hacer el software y si las pruebas responden a esa pregunta.
Los equipos que recompensan la cantidad de pruebas sin examinar qué demuestran corren el riesgo de dar a los revisores más material y menos confianza. Al asignar el trabajo, los responsables deberían reservar tiempo para ese examen, en vez de tratarlo como una demora inexplicable después de que termine el agente.
## Mide el cambio que llega a los clientes
Las métricas de entrega de DORA ofrecen una comprobación útil de los resultados posteriores. Incluyen el tiempo desde que se confirma el código hasta que pasa a producción, la frecuencia de implementación, la recuperación tras una implementación fallida, la proporción de implementaciones que requieren intervención inmediata y la proporción que corresponde a trabajo imprevisto para rehacer incidentes. Describen resultados de entrega que van más allá de superar una ejecución de pruebas. [Definiciones de métricas de DORA](https://dora.dev/guides/dora-metrics/).
Para investigar el flujo de trabajo de programación con IA de un equipo, combinaríamos esos resultados con un pequeño registro de diagnóstico:
- Información: tiempo transcurrido hasta completar las comprobaciones requeridas, incluidas las ejecuciones lentas y las esperas por falta de capacidad.
- Consumo: trabajo total de los ejecutores y cantidad de intentos repetidos asociados a un cambio aceptado.
- Revisión: tiempo de espera hasta recibir atención, revisiones sustanciales solicitadas y motivo de cada una.
- Impacto en el cliente: si el cambio publicado produjo el comportamiento previsto y si fue necesario corregirlo después.
Usa el registro para investigar un flujo de trabajo concreto. No se deben tratar como unidades de productividad intercambiables una pequeña edición de documentación y una migración de base de datos. Cuando sea posible, compara trabajos similares a lo largo del tiempo y anota otros cambios, como un nuevo proveedor de ejecutores o un proceso de publicación revisado. Que una mejora coincida con la adopción de IA no demuestra que esta la haya causado.
Así, los responsables pueden tomar una decisión concreta: financiar la limitación que impide que cambios útiles lleguen a los clientes con suficiente confianza. A veces hará falta más capacidad informática. Otras, requisitos más claros, mejores pruebas o suficiente tiempo de revisión con experiencia para comprender las propuestas que ya están llegando.
## Sources
- [Linear: programación con IA y el cuello de botella de la CI](https://linear.app/now/ci-bottleneck-reworked) — 21 de septiembre de 2026. El informe de implementación de Mufeez Amjad aporta las cifras iniciales y el ejemplo del aislamiento selectivo. Las mediciones de primera mano describen el sistema de Linear; no son una estimación controlada de la productividad de la IA ni del gasto total.
- [DORA: cómo equilibrar las tensiones de la IA](https://dora.dev/insights/balancing-ai-tensions/) — 10 de marzo de 2026. Distingue la asociación detectada por DORA en 2025 del análisis cualitativo de las respuestas de ingenieros de Google. Ese estudio interno describe experiencias, no efectos causales medidos; las preguntas previas quizá influyeran en las respuestas.
- [METR: IA de principios de 2025 y productividad de desarrolladores experimentados](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/) — Experimento aleatorizado del 10 de julio de 2025 con repositorios conocidos de código abierto y herramientas de principios de 2025. Respalda la conclusión acotada sobre la ralentización y la discrepancia con las percepciones. No estima el efecto para todos los desarrolladores ni para los modelos de septiembre de 2026.
- [METR: cambios en el experimento sobre productividad de desarrolladores](https://metr.org/blog/2026-02-24-uplift-update/) — Actualización del 24 de febrero de 2026. Explica la selección de participantes y tareas, los cambios en la remuneración y los problemas para medir el trabajo concurrente. Los investigadores consideran poco fiable la nueva estimación; no presentamos sus cifras brutas como una aceleración actual.
- [GitHub: almacenamiento en caché de dependencias](https://docs.github.com/en/actions/concepts/workflows-and-actions/dependency-caching) — Documentación actual consultada el 22 de septiembre de 2026. Describe la reutilización en ejecutores limpios y la necesidad de que los trabajos funcionen cuando no hay una caché disponible. No establece el rendimiento ni la factura de un repositorio concreto.
- [Vitest: ajustes de aislamiento por archivo](https://vitest.dev/guide/recipes/disable-isolation) — Documentación actual consultada el 22 de septiembre de 2026. Explica el aislamiento predeterminado, la configuración selectiva y las dependencias de estado que deben protegerse. Esta orientación técnica respalda la existencia de una disyuntiva; BIG CHANGE no ejecutó una prueba comparativa ni modificó un conjunto de pruebas.
- [DORA: métricas de rendimiento de entrega de software](https://dora.dev/guides/dora-metrics/) — Actualizado el 5 de enero de 2026. Define cinco métricas de entrega y su aplicación a nivel de servicio. Ofrecen medidas de resultados que van más allá de la duración de la CI; los ejemplos de diagnóstico del artículo son análisis, no resultados de un experimento nuevo.
El boletín de BIG CHANGE
La visión global, a tu ritmo.
Historias recientes sobre IA y robótica, cambios que vale la pena observar e ideas prácticas para usar. Elige un informe diario, un resumen semanal o una perspectiva mensual.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Tu privacidad, tu elección.
El almacenamiento necesario ayuda a proteger el sitio y a recordar tus preferencias. Google Analytics opcional permanece desactivado hasta que lo autorices. Puedes leer todas las historias usando solo el almacenamiento necesario. Detalles de privacidad