AI-translated from English; not yet reviewed by a fluent editor.
# SageMaker multi-turn RL: Ano ang dapat tiyakin ng search team bago magsanay
> Iniulat ng AWS ang pagbuti sa tatlo sa apat na search benchmark na hindi ginamit sa training para sa Qwen3.6-27B agent nito. Inilalahad ng gabay na ito ang setup sa SageMaker, mga gastos at pagsusuring kailangan bago magsubok.
By BIG CHANGE Editorial
Published: 2026-10-04T17:55:25.736Z
Updated: 2026-10-04T17:55:25.736Z
Canonical: https://bigchange.ai/blog/fine-tune-search-agent-sagemaker-multi-turn-rl
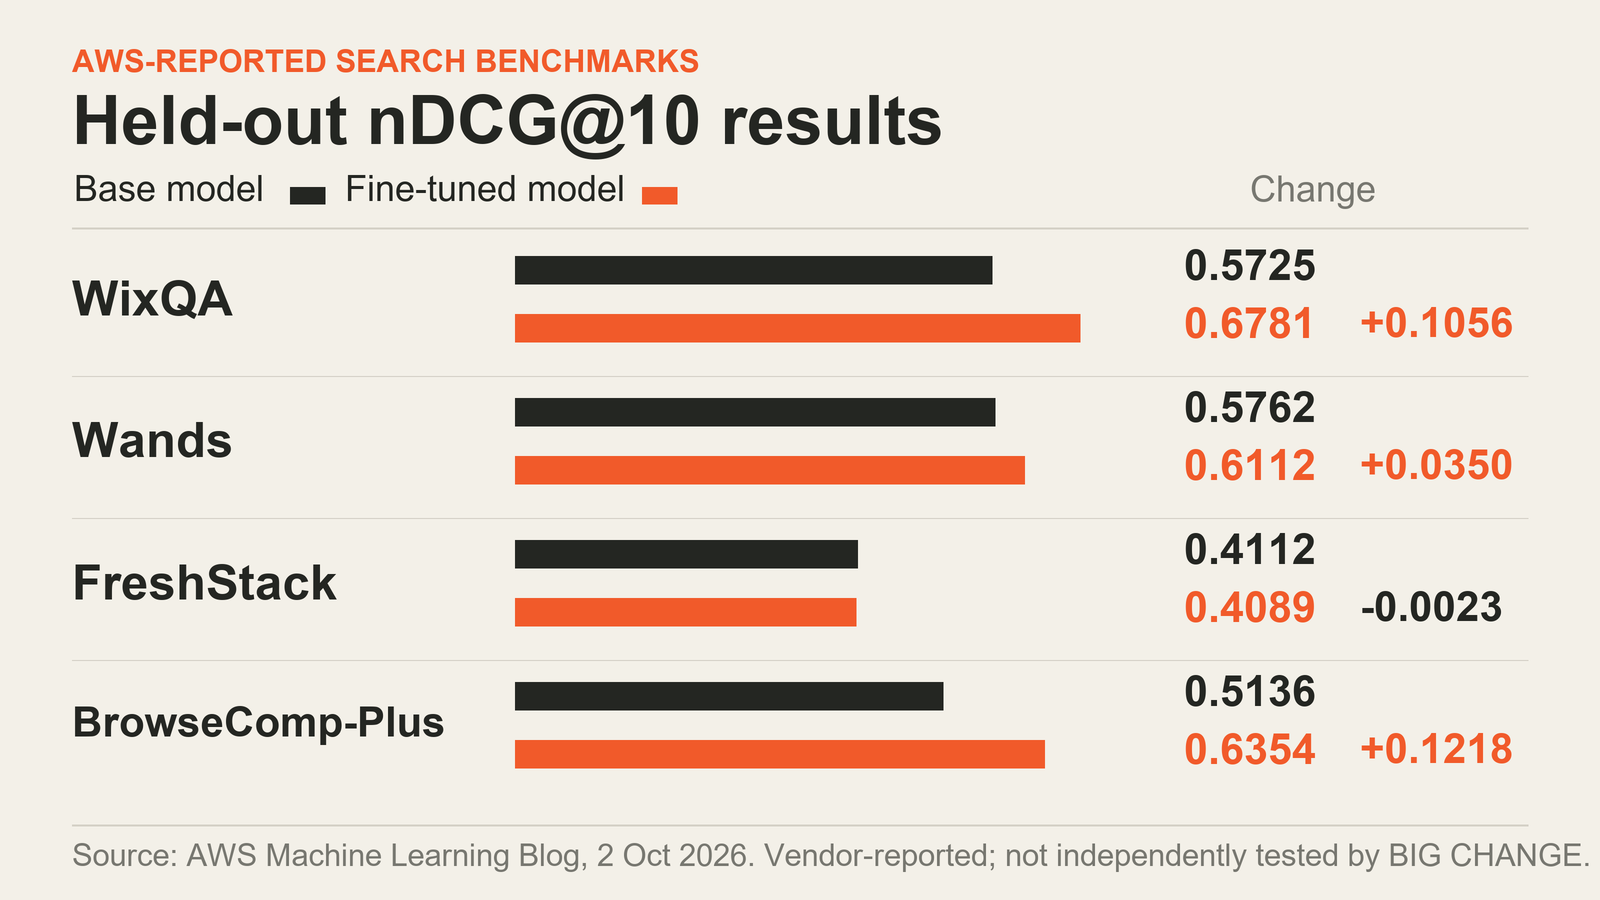
BIG CHANGE graphic; data: AWS Machine Learning Blog
## Ang malaking pagbabago
Sa [walkthrough ng AWS noong Oktubre 2](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/), inilalarawan ng AWS kung paano i-fine-tune ang Qwen3.6-27B search agent gamit ang multi-turn reinforcement learning (MTRL) sa SageMaker AI. Ipinapakita ng tsart sa itaas ang iniulat ng AWS na nDCG@10 score sa mga held-out set: tumaas ang mga ito sa WixQA, Wands at BrowseComp-Plus, at bahagyang bumaba sa FreshStack. Ginawa ng BIG CHANGE ang tsart mula sa mga bilang ng AWS; hindi namin independiyenteng sinubukan ang agent o inulit ang mga resulta. Sinasanay ng paraang ito ang modelo batay sa kinalabasan ng sunod-sunod na desisyong gumagamit ng mga tool.
Bago magsumite ng job, kailangang tiyakin ng ML engineer na suportado ang modelo at rehiyon, makakalahok ang agent sa rollout loop ng SageMaker, kinakatawan ng mga prompt at reward ang nilalayong search task, at makakakita ng regression ang hiwalay na evaluation set. Batay ang gabay na ito sa dokumentasyon ng AWS; hindi nagpatakbo ng AWS job o tumawag ng API ang BIG CHANGE.
## Ano ang binabago ng MTRL sa training loop
Sa supervised fine-tuning, kailangan ng team ng mga halimbawa ng trajectory na nagpapakita ng ninanais na kilos. Sa paglalarawan ng AWS sa MTRL, sa halip ay nagpapadala ang SageMaker ng mga prompt sa agent; tinatawag ng agent ang policy model at mga tool nito sa maraming turn; at nag-uulat ito ng reward matapos makumpleto ang rollout. Ina-update ang modelo gamit ang feedback na iyon. Para sa paghahanap, maaaring bigyan ng score ang huling ranking bilang reward, kaya ino-optimize ang mga unang pagpili ng query batay sa buong search episode.
Mahalaga ang pagkakaibang ito kapag nakadepende ang mga tool call sa naunang resulta. Kung mahina ang unang query ng modelo, mahina rin ang nakuhang resulta at kailangan nitong magtanong muli sa ibang paraan, maipapakita ng end-of-task reward kung nakakuha sa huli ng mga kaugnay na dokumento ang sunod-sunod na hakbang. Hindi nito inaalis ang pangangailangang tukuyin ang ibig sabihin ng “kaugnay” o bumuo ng agent na kayang tumawag sa mga search tool ng team.
## Unahin ang access, modelo at rehiyon
Tumakbo ang halimbawa noong Oktubre 2 sa US West (Oregon), `us-west-2`, at ginamitan ito ng fine-tuned na Qwen3.6-27B. Ayon sa [ talahanayan ng mga modelong suportado ng SageMaker MTRL](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html), na sinuri noong Oktubre 4, 2026, may apat na modelo sa anim na pares ng modelo at rehiyon: Nova Lite 2.0 at GPT-OSS-20B sa US East (N. Virginia), `us-east-1`, at US West (Oregon), `us-west-2`; sa Oregon lamang ang Gemma-4-31B-it at Qwen 3.6 27B. Tiyakin ang kasalukuyang talahanayan sa rehiyong gagamitin mo sa paggawa ng job; hindi nangangahulugang magagamit sa ibang lugar ang modelong nakalista.
Kailangan din ng team ng AWS account at, kung Studio interface ang gagamitin, SageMaker Studio domain; access sa S3 para sa mga dataset at output; at mga IAM role na naka-configure para sa bagong MTRL job at runtime call. Ayon sa dokumento ng AWS tungkol sa mga prerequisite, kailangan ng tumatawag ang `CreateJob` at mga kaugnay na job action, pati pahintulot na ipasa ang execution role sa `job.sagemaker.amazonaws.com`. Kailangan ng execution role ang `AmazonSageMakerJobFullAccess` policy at ang service principal na iyon sa trust policy nito. Kailangan ng agent runtime role ang `AmazonSageMakerJobRuntimeAccess`; kailangan din ng AgentCore runtime ng sarili nitong trust relationship. Nangangailangan ang runtime picker ng Studio ng mga pahintulot para ilista ang AgentCore. Ayon sa AWS, hindi kasama sa dating malawak na SageMaker access lamang ang lahat ng bagong job action na ito.
May dalawang dokumentadong paraan para ikonekta ang agent. I-deploy ito sa Bedrock AgentCore para sa pinamamahalaang hosting—sinabi ng AWS na pinakamainam ito para sa mga agent na ginawa gamit ang Strands—o mag-host ng custom agent at idaan ito sa Lambda forwarder. Tumatanggap ang agent ng mga prompt para sa rollout, tumatawag sa policy model sa pamamagitan ng job runtime ng SageMaker, gumagamit ng search tool, kumukumpleto sa bawat rollout at nag-uulat ng reward. Marami sa integrasyong ito ang pinangangasiwaan ng SDK decorator ng AWS; maaari ring direktang tumawag sa runtime API ang custom framework. Kung hindi karaniwan ang pangalan ng Lambda function, maaaring kailanganing tahasang idagdag ang ARN nito sa permission policy, ayon sa AWS. Nangangailangan pa ng karagdagang setup ang customer-managed VPC o KMS key.
## Ihanda ang mga prompt at reward para sa aktuwal na search task
Tumatanggap ang asset guide ng SageMaker ng Parquet, JSON Lines, JSON o CSV. Hinahanap nito ang column na pinangalanang `prompt`; kung wala iyon, ang unang column ang gagamitin at ipapasa nang walang pagbabago sa agent. Hindi bina-parse, bine-validate o binabago ng serbisyo ang laman ng prompt. Para sa paghahanap na gumagamit ng tool, maaaring maglaman ang prompt ng mga mensahe ng usapan, task metadata, detalye ng reward at configuration ng tool sa format na inaasahan ng agent. Nagbabala ang AWS na ipinapasa ang mga prompt nang hindi sinusuri; kaya responsibilidad pa rin ng team na protektahan ang sensitibong datos. Dapat pagplanuhan ang encryption o iba pang angkop na proteksiyon sa storage at sa daloy papunta sa agent.
Ang reward ang layuning ino-optimize ng modelo. Gumagamit ang halimbawa ng AWS ng nDCG@10 sa mga dokumentong nakuha sa huli at nagbibigay ng reward na -1 kapag umabot ang agent sa limitasyon ng turn o sampling token. Konkretong panimulang disenyo ito para sa retrieval task na niraranggo ang mga resulta, pero mahalaga ang mga pasya sa pagsusuri: kailangan ng maaasahang relevance label o iba pang matibay na paraan ng pagmamarka. Tiyakin ding hindi pinapaboran ng reward ang mababaw na pagtaas sa ranking kapalit ng kalidad ng sagot, latency o gastos sa tool.
Ayon sa blog, kabilang sa training mix nito ang FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique at MLQA; inilaan bilang validation set ang limang porsiyento ng training instance sa bawat dataset. Binubuo ang held-out test set ng FreshStack, WixQA, BrowseComp-Plus at Wands. Hindi kapalit ng mga pampubliko o sintetikong dataset na ito ang pagsusuri sa pribadong corpus at distribusyon ng query na balak gamitin ng team.
## Magsumite ng maliit at madaling siyasating job
Gumagamit ang snippet sa [blog ng AWS noong Oktubre 2](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) ng ibang SDK import at pangalan ng argumento. Ipinapakita naman ng kasalukuyang [reference para sa SageMaker training job](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) ang ganitong API format para sa Bedrock AgentCore runtime. Ginagamit ng halimbawang ito ang kasalukuyang model identifier ng GPT-OSS-20B sa dokumentasyon ng AWS. Pumili ng modelong available sa target na rehiyon at tingnan ang live na talahanayan ng mga suportadong modelo bago baguhin ang halimbawa. Nangangailangan din ang kasalukuyang halimbawa ng MLflow app ARN, role ARN at pagtanggap sa EULA.
```python
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer
trainer = MultiTurnRLTrainer(
model="openai-reasoning-gpt-oss-20b",
agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
training_dataset="s3://my-bucket/prompts/prompts.parquet",
mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
s3_output_path="s3://my-bucket/output/",
role="arn:aws:iam::123456789012:role/SageMakerRole",
accept_eula=True,
)
trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
```
Halimbawa ito mula sa kasalukuyang dokumentasyon ng AWS, hindi command na sinubukan ng BIG CHANGE. Iba ang `sagemaker.modules.train` import, `model_id`, `agent_endpoint`, `training_dataset_s3_uri` at `output_s3_uri` na argumento sa blog ng AWS noong Oktubre 2. Dahil iba ang mga ito sa kasalukuyang job guide, sundin ang kasalukuyang reference para sa bagong implementasyon at tiyakin sa sarili mong environment ang SDK version at mga requirement ng modelo. Hindi namin natukoy kung lumang SDK revision ang ipinapakita ng halimbawa sa blog o may hindi pagkakatugma ang mga dokumento. Iba pang dokumentadong paraan ng pagsusumite ang Studio UI: pumili ng suportadong JumpStart model, piliin ang Multi-Turn Reinforcement Learning, itakda ang AgentCore runtime o Lambda forwarder, magbigay ng training data at isumite.
Sa unang run, itala ang modelo, rehiyon, bersyon ng dataset, reward, mga limitasyon, hyperparameter at output path upang maikumpara ang susunod na pagsusuri sa parehong baseline. Kung customer-managed VPC ang gagamitin, tinutukoy sa hiwalay na gabay ng AWS para sa VPC ang mga private subnet sa dalawang Availability Zone, VPC endpoint para sa S3 at CloudWatch Logs, at AgentCore o Lambda endpoint kung kailangan; kailangan din ng endpoint para sa MLflow kung gagamitin ito. Kailangan ng execution role ang pahintulot sa pamamahala ng ENI. Sa opsyonal na customer-managed KMS, kailangan ng karagdagang pahintulot at setup ng key policy para sa tumatawag, execution role at runtime; default ang AWS-owned KMS encryption at rest. Basahin ang mga gabay sa VPC at encryption bago gamitin ang alinmang configuration. Bago magsumite, suriin ang quota ng account: bilang default, inililista ng AWS ang tig-isang sabayang MTRL fine-tuning job at evaluation job, at maaaring baguhin ang dalawa sa Service Quotas. Hindi maaaring baguhin ang limitasyon sa throttling ng job-management API.
## Suriin muna ang held-out prompt bago mag-deploy
Ayon sa dokumentasyon ng AWS tungkol sa evaluation, huwag isama sa training ang evaluation prompt; gamitin ang parehong format ng prompt; saklawin ang mahahalagang tool at kombinasyon ng tool; isama ang mga dating pumalyang kaso; at protektahan ang sensitibong nilalaman. Kayang patakbuhin ng evaluator ng SageMaker ang candidate model laban sa set ng prompt at iulat ang reward, pass@k at mga metric ng trajectory. Ipinapakita ng mga dokumento kung paano suriin ang fine-tuned model at, opsyonal, ang base model sa parehong comparison pipeline.
Itakda ang evaluation protocol bago magsanay. Panatilihin ang nakapirming held-out set na kumakatawan sa mga query, pahintulot at pagbabago ng dokumentong kakaharapin ng live agent. Ihambing ang base at fine-tuned na modelo gamit ang parehong tool, limitasyon at scoring code. Siyasatin hindi lang ang average retrieval score, kundi pati ang mga task failure, bilang ng turn, latency, paggamit ng token at mga kasong nawawala sa matataas na ranggo ang mga kaugnay na dokumento. Ipinapakita ng dokumentasyon kung paano magsumite ng AWS evaluation job; hindi nito pinatutunayang sapat ang iisang metric upang masukat ang kalidad ng paghahanap sa production.
Iniulat ng post ng AWS ang mga sumusunod na resulta sa held-out data:
| Dataset (bilang ng tanong) | Base nDCG@10 | Fine-tuned nDCG@10 | Failure rate ng base | Failure rate ng fine-tuned |
| --- | --- | --- | --- | --- |
| WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
| Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
| FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
| BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
Tatlong pagtaas at isang maliit na pagbaba sa FreshStack ang ipinapakita ng talahanayan para sa nDCG@10. Iniuugnay ng AWS ang mas mababang failure rate sa BrowseComp-Plus sa parusang ipinapataw kapag umabot ang agent sa limitasyon ng turn o token. Walang inilalahad ang blog na confidence interval o pagsusuri ng statistical significance kasama ng mga bilang. Iniulat din nito na gumamit ang fine-tuned model ng average na 4.5 laban sa 4.3 turn sa WixQA, at 2.9 laban sa 2.2 sa Wands; kaya hindi laging mas kaunti ang turn. Ituring itong eksperimento na iniulat ng vendor, hindi independiyenteng validation o patunay na gaganda ang resulta sa ibang corpus.
## I-budget ang buong pagsubok
Inilalarawan ng dokumentasyon ng AWS para sa MTRL ang tatlong bahagi ng singil sa training: mga prefill token na naproseso bilang input, mga sampling token na nalikha habang nagro-rollout, at mga training update. Nagbibigay ang pahina ng presyo ng rate ayon sa modelo; ang mga rate at dami ng rollout, haba ng sequence, bilang ng epoch at runtime ng team ang magtatakda ng estimate. Hindi inilalathala sa halimbawang artikulo ang kabuuang bill, at walang iisang pangkalahatang presyo ng trial sa dokumentasyon. Tingnan ang kasalukuyang rate para sa piniling modelo at rehiyon, at mag-estimate batay sa inaasahang paggamit ng job sa halip na ipagpalagay ang nakapirming gastos.
Isama sa pagtataya ang mga kaugnay na gastos: storage at request sa S3 para sa training, validation, checkpoint at output artifact; AgentCore runtime o Lambda at anumang search infrastructure habang nagro-rollout; logging at MLflow; pagsusuri sa held-out set; at anumang endpoint o Bedrock deployment matapos magsanay. Partikular na ipinapayo ng post ng AWS na ihinto o burahin ang tumatakbong MTRL job, burahin ang mga hindi na kailangang S3 model artifact at alisin ang mga evaluation endpoint upang maiwasan ang patuloy na singil. Hiwalay na pasya at kategorya ng gastos ang pag-deploy ng endpoint kumpara sa training.
## Magpasya kung magpapatuloy
Pinakaangkop ang workflow kapag nangangailangan ang search task ng maraming magkakaugnay na tool call at kayang bigyan ng team ng score ang huling resulta. Magagamit lamang sa pagpapasya ang trial kung suportado ang kombinasyon ng modelo at rehiyon, gumagana ang integrasyon ng agent, kumakatawan sa tunay na gawain ang prompt data, tumutugma sa task ang reward, may paghahambing sa held-out set, at kasama sa pagtataya ang gastos ng mga kaugnay na serbisyo. Dahilan upang siyasatin ang pamamaraan ang magagandang resulta sa apat na benchmark ng AWS, hindi dahilan upang ipagpalagay na ganoon din ang epekto sa ibang index, halo ng query o hangganan ng pahintulot.
**Mga sanggunian at karagdagang babasahin**
- [AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (Oktubre 2, 2026)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — gabay ng vendor sa hakbang-hakbang na setup, pagpili ng dataset at mga iniulat na resulta ng evaluation.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — mga kasalukuyang suportadong modelo, rehiyon at bahagi ng pagsingil.
- [Mga prerequisite](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html),[Paghahanda sa agent](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-agent.html),[Configuration ng VPC](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-vpc.html) at[encryption at rest](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-encryption-at-rest.html) — mga pahintulot, pagpili ng runtime, integrasyon at opsyonal na setup ng network at encryption.
- [Paggawa ng asset](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html),[Pagsusumite ng training job](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html),[evaluation](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-evaluation.html),[hyperparameter](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-hyperparams.html) at[quota](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-quotas.html) — mga kasalukuyang reference sa implementasyon.
- [Presyo ng SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/) — mga kasalukuyang detalye ng presyo sa model customization; nagbabago ang rate at nag-iiba ayon sa modelo at rehiyon.
*Paalala sa pag-uulat: Pagsusuri lamang ito ng dokumentasyon. Hindi nag-access ng AWS account, nagsumite o nagsiyasat ng SageMaker job, tumawag ng AWS API o independiyenteng umulit ng iniulat na mga metric ang BIG CHANGE. AWS ang sumulat ng gabay sa implementasyon at nag-ulat ng sarili nitong eksperimento.*
## Sources
- [AWS Machine Learning Blog: Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI (Oktubre 2, 2026)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — Walkthrough ng implementasyon at pagpili ng dataset ng AWS, kasama ang iniulat ng vendor na held-out evaluation.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — Kasalukuyang kombinasyon ng modelo at rehiyon, pangkalahatang daloy ng trabaho at mga bahagi ng singil sa training.
- [Mga prerequisite at setup ng agent para sa SageMaker AI MTRL](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html) — Mga kinakailangang pahintulot, pagpili ng runtime, integrasyon ng agent at opsyonal na configuration ng network at encryption.
- [Dokumentasyon ng training at evaluation ng SageMaker AI MTRL](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html) — Kasalukuyang mga input data at workflow; naka-link din sa artikulo ang mga reference para sa training job at evaluation.
- [Pagsusumite ng SageMaker AI MTRL training job](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) — Kasalukuyang Python SDK import, pangalan ng argumento, halimbawa para sa AgentCore at mga hakbang sa pagsusumite gamit ang Studio; sinuri noong Oktubre 4, 2026.
- [Presyo ng SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/) — Kasalukuyang impormasyon ng presyo ayon sa modelo; nag-iiba ang rate batay sa modelo at rehiyon.
Newsletter ng BIG CHANGE
Ang kabuuang larawan, sa sarili mong bilis.
Mga kamakailang kuwento tungkol sa AI at robotics, mga pagbabagong dapat bantayan, at mga praktikal na ideyang magagamit. Pumili ng araw-araw na briefing, lingguhang digest, o buwanang pananaw.
Susunod na nakaiskedyul na pagpapadala (UTC): . Darating ang unang edisyon sa susunod na nakaiskedyul na pagpapadala matapos mong kumpirmahin.
Privacy mo, pasya mo.
Tumutulong ang kinakailangang storage na panatilihing ligtas ang site at tandaan ang mga pinili mo. Nananatiling naka-off ang opsyonal na Google Analytics hangga’t hindi mo ito pinapahintulutan. Mababasa mo ang lahat ng kuwento gamit lamang ang kinakailangang storage. Mga detalye tungkol sa privacy