AI-translated from English; not yet reviewed by a fluent editor.
# Inilunsad ang Grok 4.7 sa parehong presyo kada token. Mas mahalaga ang gastos sa natapos na trabaho.
> Nangangako ang paglulunsad ng Grok 4.7 ng mas mahusay na coding at gawaing pang-opisina. Sinusuri namin ang coverage ni Matthew Berman, mga malayang pagsubok at dapat sukatin ng mga pangkat bago lumipat.
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
Dumating ang Grok 4.7 noong Setyembre 21, 2026. Para sa mga pangkat na bumibili ng AI para magsulat ng code o magsuri ng impormasyon sa negosyo, nagbubukas ang paglulunsad nito ng praktikal na tanong: ginagawa bang mas mura ng mas mahusay na modelo ang natapos na trabaho? Higit pa sa ipinapaskil na presyo ng token ang nakaaapekto sa sagot. [Opisyal na tala sa paglulunsad](https://docs.x.ai/developers/release-notes)
Tungkol sa magkahalong resultang ito ang bidyo ni Matthew Berman noong Setyembre 22, na pinamagatang *Hindi ko alam ang mararamdaman ko tungkol sa Grok 4.7…*. Kinukuwestiyon niya ang pagpili sa mga paghahambing at ikinakatuwirang mas mahalaga ang gastos kada natapos na gawain kaysa presyo ng token. Sinasabi rin niyang hindi pa niya lubusang nasusubok ang modelo. Maagang pagtatasa ito sa ebidensiya, hindi komprehensibong pagsusuri sa aktuwal na paggamit. [Pambungad ni Berman, 0:00](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
Nararapat bigyang-pansin ang paglulunsad dahil hindi kailangang manguna sa bawat benchmark ng kapaki-pakinabang na modelo para mabago nito ang kayang i-automate ng negosyo. Pero kailangan nitong matapos nang tama ang sapat na dami ng trabaho para bigyang-katwiran ang kabuuang gastos. Inilalantad na ng malayang pagsusuri ang tensiyon: maaaring mas maganda ang resulta ng Grok 4.7 pero mas marami rin itong malikhaing output.
Kaya praktikal ang pasiya para sa mga developer, maliliit na negosyo at pangkat na bumubuo ng mga agent. Aling gawain ang matatapos nang sapat ang kalidad ng modelong ito? Gaano karaming pagsisikap ang kailangan nito? At gaano karaming trabaho ang matitira sa tao matapos sabihing tapos na ang modelo?
Sinuri namin ang buong caption ng humigit-kumulang 17-minutong bidyo ni Berman at tiningnan ang anunsiyo ng paglulunsad, dokumentasyon ng produkto at pagsusuri ng Artificial Analysis. Walang benchmark na isinagawa ang BIG CHANGE o pahayag ng unang-kamay na pagsubok namin sa Grok sa sumusunod na pagsusuri.
## Ano ang inilunsad, at saan ito available
Available ang karaniwang modelo sa API ng xAI bilang `grok-4.7`, gayundin sa Cursor at Grok Build. Tumatanggap ang API ng teksto at larawan at lumilikha ng teksto. 500,000 token ang nakadokumentong laki ng konteksto nito at may apat itong setting sa pangangatwiran: low, medium, high at xhigh. High ang default. [Opisyal na tala sa paglulunsad](https://docs.x.ai/developers/release-notes)
Iniuugnay ng SpaceXAI ang pagbuti sa mas malaking batayang modelo at mas mahabang reinforcement learning sa mas mahihirap na gawain. Paliwanag ito ng developer. [Teknikal na pangkalahatang-ideya sa paglulunsad](https://x.ai/news/grok-4-7)
Mayroon ding Grok 4.7 Fast. Inilalarawan ito sa dokumentasyon bilang parehong modelo sa mas mabilis na imprastraktura, na sinisingil nang doble sa karaniwang presyo kada token. Iniaalok ito sa Cursor at Grok Build, hindi kasama sa libreng antas ng Grok Build at hindi available sa pampublikong API ng xAI. [Dokumentasyon ng produkto ng Grok 4.7](https://docs.x.ai/developers/grok-4-7)
Mahalaga ang mga pagkakaibang ito kapag nagkukumpara ng screenshot, demonstrasyon at singil. Magkakahiwalay na pagpili ang bersiyon ng modelo, pagsisikap sa pangangatwiran at antas ng serbisyo. Hindi pagtatantiya sa karanasan o gastos ng API call na karaniwang bilis at medium effort ang demonstrasyong gumagamit ng Fast sa xhigh.
Dapat ding ihiwalay ang paghahambing ng pahina ng paglulunsad sa ibang modelo at paghahambing sa pag-upgrade. Sinasabi ng SpaceXAI na kapareho ng Grok 4.6 ang presyo at bilis ng karaniwang Grok 4.7. Hindi nito sinasabing awtomatikong mahahati sa dalawa ang singil ng customer kapag nag-upgrade mula 4.6.
## May hangganan para sa mahabang konteksto ang kard ng presyo
Ganito ang inilathalang karaniwang presyo ng API:
- Hanggang 200,000 prompt token: $2 para sa input, $0.50 para sa naka-cache na input at $6 para sa output kada isang milyong token.
- Lampas 200,000 prompt token: $4 para sa input, $1 para sa naka-cache na input at $12 para sa output kada isang milyong token.
Presyo kada token ang mga ito, hindi kumpletong presyo ng agent na tumatapos ng gawain. Nagbabala ang pahina ng modelo sa mas mataas na presyo para sa kahilingang lumalampas sa 200,000 token, at tinutukoy ng tala sa paglulunsad ang mas mataas na singil. Sinuri ang presyo at availability noong Setyembre 22. [Presyo ng modelo](https://docs.x.ai/developers/models/grok-4.7) at [tala sa paglulunsad](https://docs.x.ai/developers/release-notes)
Samakatuwid, hindi ibig sabihin ng 500,000-token na laki ng konteksto na gagamit ng pinakamababang presyo ang bawat kahilingan. Hindi rin patunay ang malaking konteksto na palagiang mahahanap ng modelo ang lahat ng kaugnay na detalye sa malaking pangkat ng mga file.
Nagpapakilala ang Cursor ng isa pang pagkakaiba sa antas ng produkto: nakalista sa dokumentasyon nito ang karaniwang kontekstong 256,000 token at pinakamataas na 500,000. Maaaring magkaiba ang kapasidad na nakikita sa editor sa espesipikasyon ng API, o nakadepende ito sa napiling mode. [Dokumentasyon ng Cursor tungkol sa Grok 4.7](https://prod.cursor.com/docs/models/grok-4-7)
Para sa pangkat na nagpoproseso ng mahahabang ulat, mahalagang tanong kung sapat ang pagbuti ng resulta mula sa pagpapadala ng lahat ng materyal para bigyang-katwiran ang gastos. Maaaring mas mura at mas madaling siyasatin ang pagkuha sa mga kaugnay na seksiyon. Kailangan kung minsan ang buong dokumento; kung minsan naman, pinakamadali lang itong paraan ng paggawa ng prompt. Hindi dapat ipagpalagay na magkapareho ang badyet sa dalawang sitwasyong ito.
## Maaaring mas maraming token ang konsumo ng mas mahusay na pagganap
Binigyan ng pagsusuri ng Artificial Analysis noong Setyembre 21 ang Grok 4.7 sa xhigh ng markang 46 sa Intelligence Index nito, dalawang puntos na mas mataas sa Grok 4.6. Iniulat nito na humigit-kumulang 81,000 output token ang ginamit kada gawain, kumpara sa 36,000 para sa Grok 4.6 sa high effort. Iniulat naman sa parehong pagsusuri na 38,000 token ang ginamit ng Grok 4.6 sa xhigh, kaya sa paghahambing na parehong antas ng effort ay mahigit doble pa rin ang output token. [Pagsusuri sa paglulunsad ng Artificial Analysis](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
Kongkretong dahilan ito para ibukod ang presyo ng token sa gastos ng gawain. Kung gagamit ng 81,000 output token sa batayang singil na $6 kada isang milyong token, $0.486 ang halimbawang singil para sa output. Kung 38,000 token naman, $0.228 ito. Sadyang hindi kasama sa mga kalkulasyong ito ang input, asal ng cache, singil sa tool, mas mataas na presyo sa malaking konteksto at mga pumalyang pagtatangka. Aritmetika ito batay sa iniulat na bilang ng token, hindi nasukat na kumpletong presyo ng gawain.
Hindi awtomatikong aksaya ang mas maraming output. Maaaring gumugol ng dagdag na pagsisikap ang modelo sa pagsusuri ng sagot para maiwasan ang pagkabigong mangangailangan sana ng pakikialam ng tao. Maaari rin itong magtagal sa maling pamamaraan. Hindi kayang ibukod ng bilang lang ng token ang mabungang pagpupursigi sa magastos na pag-uulit.
Bumabalik si Berman sa problemang ito sa bandang huli ng bidyo, kung saan binabanggit niya ang mas mataas na paggamit ng token na iniulat ng Artificial Analysis. [Bidyo, 15:43](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
Ang kapaki-pakinabang na resulta ay naaprubahang maihahatid na output. Naiiba ang pagbabagong pang-code na pumapasa sa angkop na test at pagsusuri, spreadsheet na nagtutugma ang mga pormula o ulat na natutunton ang mga pahayag sa ebidensiya sa sagot na mabilis lang dumating.
## Ipinakikita ng mga benchmark ang mahusay pero hindi pantay na modelo
Ayon sa talaan ng paglulunsad, 46.3% ang nakuha ng Grok 4.7 xhigh sa CursorBench 4.0, mas mababa sa 51.8% ng Fable 5.1 max. Nangunguna rin ang Fable sa paghahambing nito sa Terminal-Bench. [Talaan ng benchmark ng vendor](https://x.ai/news/grok-4-7)
Iginuguhit naman sa kasamang grap ang iskor sa benchmark laban sa output token, na bumababa habang lumilipat pakanan. Naghahambing ang mga linya nito ng mga setting sa pangangatwiran. [Orihinal na interaktibong grap: piliin ang Tokens](https://x.ai/news/grok-4-7). [Buksan ang buong laki ng grap](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png).
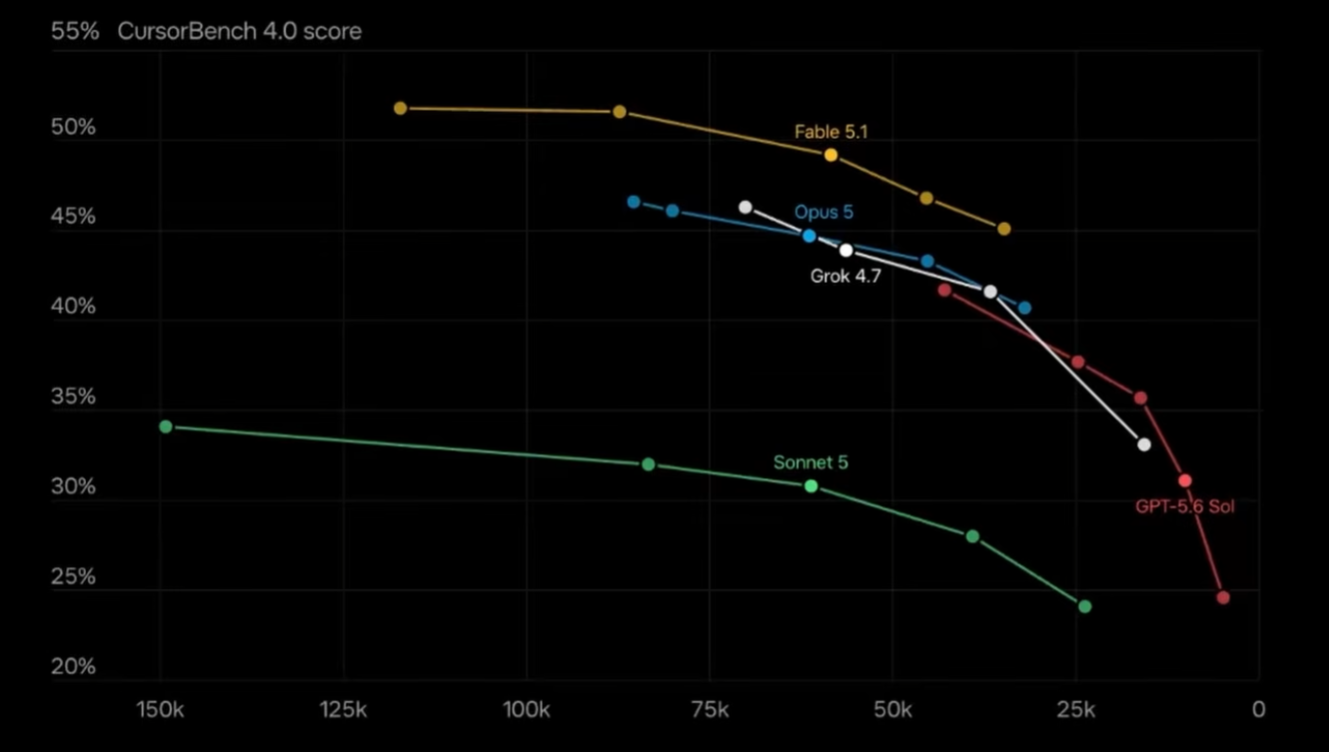
Nangangahulugan ang pag-angat ng mas mataas na iskor; nangangahulugan naman ang paglipat pakanan ng mas kaunting nabuong token sa pagsusuring ito. Hindi ito nangangahulugan ng mas mababang kabuuang presyo: mahalaga pa rin ang singil kada token, paggamit ng input at nakapaligid na agent. Naiiba rin ang pagsusuring ito sa mga bilang ng token ng Artificial Analysis sa itaas. Buburahin ng pagsasama sa bilang ng mga ito ang pagkakaiba sa gawain at pamamaraan na kailangan para maunawaan ang bawat resulta.
Sapat na ito para tanggihan ang pangkalahatang pahayag na nangunguna ang Grok 4.7 sa bawat uri ng gawaing pang-code. Sapat din ito para mas masusing suriin ang mga partikular na gawain. Hindi itinatakda ng laki ng pagbuti sa isang pagsusuri kung paano hahawakan ng modelo ang di-pamilyar na repository, kulang na ulat sa bug o di-pangkaraniwang kapaligiran ng tool.
Nagbibigay ang Artificial Analysis ng kapaki-pakinabang na hiwalay na paghahambing. Nakakuha ang Grok 4.7 kasama ang Grok Build ng markang 56 sa Coding Agent Index nito, mas mataas sa 47 ng Grok 4.6 kasama ang agent na iyon. Tahasan nitong ibinubukod ang mga katutubong resultang gumagamit ng agent sa istandardisadong setup ng Intelligence Index nito. [Malayang pagsusuri at mga tala sa pamamaraan](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
Mahalaga ang nakapaligid na agent. Nagbibigay ito ng mga tool, namamahala sa konteksto at nagpapasya kung paano isasagawa ang mga kahilingan ng modelo. Maaaring magbago ang resulta kapag nagbago ang kapaligirang ito kahit pareho ang pangalan ng modelo. Maaaring lumikha ng kapani-paniwalang talahanayan na hindi naman naglalarawan sa aktuwal na sinubok na sistema ang pagsasama sa marka ng terminal mula sa isang setup at marka sa software engineering mula sa iba.
Itinuturo ni Berman na wala ang GPT-6 Astra sa isang talaan ng paglulunsad at gumagamit siya ng muling binuong datos na likha ng AI para idagdag ito. Kapaki-pakinabang itong hudyat para siyasatin pa ang paghahambing; hindi ito malayang pinagmulan ng benchmark. Hindi namin inaampon ang mga idinagdag na bilang nito nang hindi sinusuri ang pinagbabatayang pagsusuri. [Bidyo, 6:03](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
Dapat ding tandaan ang komersiyal na ugnayan. Sinasabi sa anunsiyo ng Cursor noong Agosto 14 na nakuha na ito ng SpaceX. Kapaki-pakinabang pa ring ebidensiya ang benchmark na inilathala sa loob ng kaparehong pamilya ng produkto, pero hindi ito walang-kinikilingang pagtatasa sa karibal na supplier. [Anunsiyo ng pagkakabili sa Cursor](https://cursor.com/blog/joining-spacex)
## Maaaring mas kawili-wili ang oportunidad sa gawaing pang-opisina
Iniulat sa malayang pagsusuri na 1,657 Elo ang iskor ng Grok 4.7 sa xhigh sa AA-Briefcase, mas mataas nang 111 sa Grok 4.6 sa high. Iniuugnay nito ang malaking bahagi ng pagbuti sa kalidad ng pagsusuri, habang bahagyang mas mababa naman ang kalidad ng presentasyon kaysa resulta ng naunang modelo. [Mga resulta ng Artificial Analysis sa gawaing kaalaman](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
Kapaki-pakinabang ang pagkakahating iyon sa sinumang nagpapagawa ng ulat, spreadsheet o presentasyon. Maaaring mas matibay ang pagsusuri sa sagot habang kailangan pa rin itong i-edit o muling idisenyo. Sa kabilang banda, maaaring itago ng makinis na slide deck ang mababaw na pangangatwiran. Nanganganib gantimpalaan ng pagsusuri sa nakikitang pagtatapos lang ang maling pagbuti.
Maaaring subukan ng pangkat ng operasyon ang modelo sa regular na ulat ng pagganap. Dapat suriin sa kapaki-pakinabang na pagsubok kung tama ang panahong ginamit nito, nagtutugma ang mga bilang sa pinagmulang datos at naibubukod nito ang naobserbahang pagbabago sa iminungkahing paliwanag. Dapat itala ng nagsusuri kung gaano karaming pagwawasto ang kinailangan, hindi lang kung propesyonal ang unang tingin sa ulat.
Maaaring hindi gaanong mahalaga sa isang maliit na negosyo ang manguna sa pinakamahirap na benchmark kaysa gawing pangkaraniwan ang pagsusuring hindi nito kayang bayaran noon. Kapani-paniwalang landas ito tungo sa mas malawak na pag-aampon. Nagiging totoo ito kapag sapat ang kawastuhan ng output, dumarating ito sa oras at mas kaunting trabaho ang naiiwan sa may-ari kaysa manu-manong paggawa.
Huwag ipagkamali ang mga pangalan ng propesyonal na benchmark bilang kwalipikasyong propesyonal. Inilalarawan ng resulta sa legal na gawain o klinikal na pangangatwiran ang pagganap sa pagsusuring iyon. Hindi nito itinatatag na kaya ng modelo na asikasuhin nang mag-isa ang legal na usapin ng kliyente o gumawa ng pasiya sa pangangalaga sa pasyente. Walang rekomendasyon sa paggamit ng Grok sa mga pasiyang iyon sa artikulong ito.
## Kailangang suriin batay sa konteksto ang isa pang pahayag tungkol sa pananggalang
Sinasabi ng SpaceXAI na may bagong pangkat ng pananggalang at mas matibay na resistensiya sa jailbreak ang Grok 4.7. Pahayag ito sa paglulunsad, hindi garantiya ng kaligtasan sa bawat aplikasyon ng modelo. [Paliwanag ng developer tungkol sa kaligtasan](https://x.ai/news/grok-4-7)
Nananatili ang hindi bababa sa dalawang tanong para sa business agent. Angkop ba ang tugon ng modelo sa mga natatanggap nitong kahilingan? Nililimitahan ba ng aplikasyon kung ano talaga ang nagagawa ng modelo?
Maaaring tama ang pagkaunawa ng modelo sa tagubilin na baguhin ang rekord ng customer pero wala itong pahintulot na gawin iyon. Maaari rin itong makatagpo ng mapanlinlang na tagubiling nakabaon sa dokumentong dapat sana nitong ibuod. Dapat manatiling bahagi ng nakapaligid na sistema ang mga kontrol sa access at tuntunin sa pag-apruba; hindi kapalit ng mga ito ang mas mahusay na asal sa pagtanggi.
Ang praktikal na implikasyon ay subukan ang buong workflow. Magsama ng mga lehitimong kahilingang dapat magtagumpay, mga ipinagbabawal na pagkilos na dapat harangin at malabong kasong dapat huminto para humingi ng paglilinaw. Hindi magagamit ang produktong napakadalas tumanggi sa di-nakakapinsalang gawain; mas malala naman ang maaaring idulot ng nagsasagawa ng di-awtorisadong pagkilos. Hindi nasasaklaw ng iisang headline score ang alinman sa mga ito.
## Ano ang hindi nasasagot ng bidyo
Nagtataas ng ilang tanong ang coverage ni Berman na dapat manatiling mga tanong. Interpretasyon sa merkado ang paliwanag niyang nag-uugnay sa presyo at magagamit na kapasidad sa kompyutasyon, hindi isiniwalat na talaan ng gastos bawat yunit. Inaasahan ang mga hula niya tungkol sa social media, hindi ebidensiya ng naihatid na pagganap. May sarili rin siyang pagkilala sa demonstrasyon ng paghahambing sa dulo na hindi niya alam ang mga setting na ginamit. [Talakayan tungkol sa presyo, 8:44](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s), [mga inaasahan, 11:51](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s) at [talakayan sa demonstrasyon, 15:20](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
Tinatalakay rin sa bidyo ang mga modelong bukas ang timbang. Hindi dapat ipagkamali ang mas malawak na kompetisyong ito sa lisensiya ng Grok 4.7: kinikilala ng Artificial Analysis na pag-aari ng kompanya ang modelong ito at inililista nitong hindi available ang mga timbang nito. [Profile sa paglulunsad ng Grok 4.7](https://artificialanalysis.ai/models/releases/grok-4-7)
Pinananatiling nakatuon sa pagsusuri ang mga pagkakaibang ito. Maaaring kaakit-akit ang presyo ng produkto kahit hindi alam ng publiko kung bakit iyon ang pinili ng supplier nito. Maaaring tumukoy ng test na dapat ulitin ang kapansin-pansing palpak na demonstrasyon nang hindi nito itinatatag na pangkalahatang mahina ang modelo. Maaaring kapaki-pakinabang ang available na modelo nang hindi nito natutupad ang naunang hula ng tagapagtatag.
May hangganan din sa sponsorship. May patalastas ng Zapier sa bidyo ni Berman. Hindi ito malayang ebidensiya sa pagganap ng Grok, at hindi rekomendasyon ng BIG CHANGE ang mga pahayag na pang-promosyon nito.
## Mas mahusay na sukatan sa pagbili: gastos sa bawat tinanggap na gawain
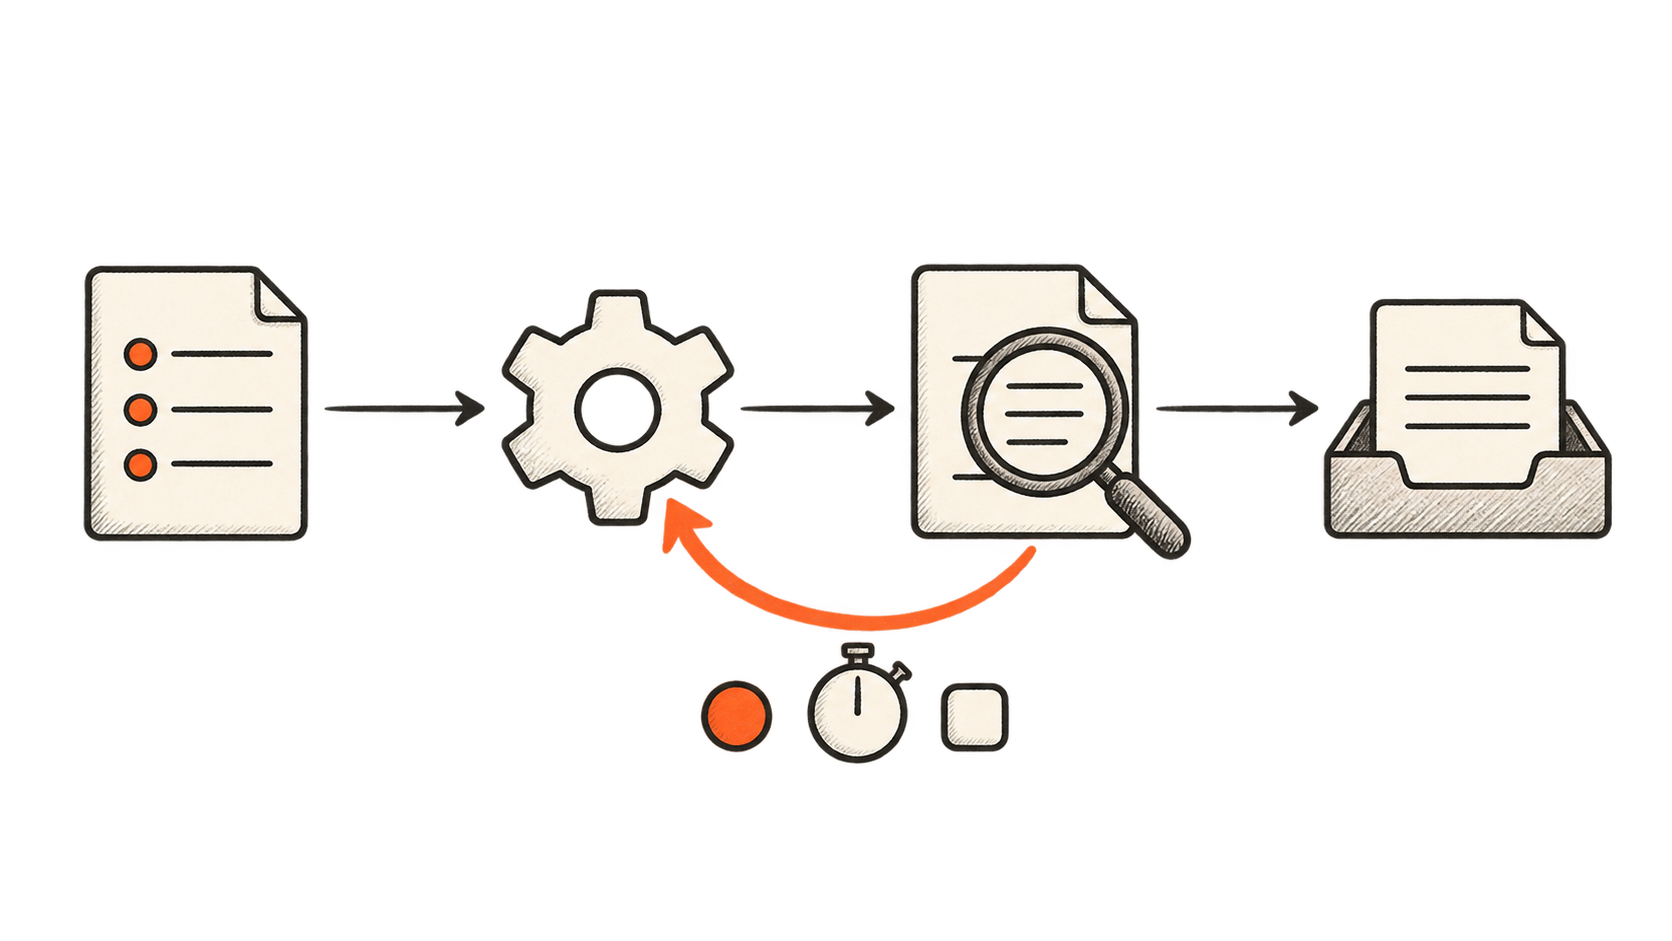
Dapat ihambing ng pangkat na nag-iisip gumamit ng Grok 4.7 ang modelo at kasalukuyan nitong proseso sa maliit at kumakatawang hanay ng mga gawain. Itakda ang pamantayan sa pagtanggap bago makita ang mga output. Para sa coding, maaaring kabilang dito ang mga kaugnay na test, nababasang patch at kawalan ng di-kaugnay na pagbabago. Para sa pagsusuri, maaaring kailanganing tama ang mga kalkulasyon at may ebidensiya para sa mahahalagang pahayag.
Pagkatapos, itala ang buong singil: paggamit ng input at output, mga tool, muling pagsubok at oras sa pagrepaso o pagkukumpuni sa resulta. Bilangin pati ang mga bigong pagtatangka. Hatiin ang gastos sa bilang ng mga naihatid na pumapasa sa pamantayan ng pagtanggap.
Ipinakikita ng halimbawang paglalarawan kung bakit mahalaga ang pagkakaiba. Ipagpalagay na nagkakahalaga ng $20 ang isang konpigurasyon sa isang batch at naglalabas ito ng 80 tinanggap na resulta. $0.25 bawat tinanggap na resulta ang nasukat na gastos nito bago ang paggawa ng tao. Nagkakahalaga naman ng $12 ang isa pa pero 30 lang ang tinanggap nitong resulta, kaya $0.40 bawat tinanggap na resulta ito. Mas mahal ang batch na mas mura bilang pinagmumulan ng magagamit na trabaho. Mga kathang-isip na bilang ito, hindi sukat sa Grok.
Dapat isama sa pagsubok ang pagsisikap sa pangangatwiran. Maaaring sulit ang gastos ng setting na high-effort sa mahirap na gawain habang kaunti lang ang naidaragdag nito sa karaniwan. Maaaring mas matipid na palakihin lang ang pagsisikap sa mga kasong kailangan ito kaysa patakbuhin ang bawat kahilingan sa xhigh, basta sinusuri rin ang pasiya sa pagdidirekta sa mga ito.
Panatilihing pare-pareho sa bawat modelo ang pamantayan sa pagsusuri. Nagmumukhang nakatipid sa pamamagitan ng pagtanggap sa mas masamang trabaho kapag ibinaba ang pamantayan para sa mas murang modelo. Nagkakaroon naman ng kabaligtarang pagbaluktot kapag itinaas lang ang pamantayan sa kasalukuyang modelo. Layunin ang maaasahang resulta na may malinaw na salaysay sa trabahong kailangan pa ring gawin ng mga tao.
## Ang pagbabagong dapat subaybayan
Nagbibigay sa mga pangkat ng isa pang pagpipiliang subukan ang Grok 4.7. Para piliin ito, kailangang tingnan ang buong gawain: ano ang nalilikha ng modelo, ano ang nakokonsumo nito at ano pa ang kailangang kumpunihin ng isang tao.
Maaaring mas piliin ang paggamit ng AI sa karaniwang trabaho bilang mas malawak na bunga. Maaaring pumili ang pangkat ng isang konpigurasyon para sa karaniwang pagsusuri, isa pa para sa mahirap na coding at tao naman para sa kasong hindi maipagkakatiwala ang hatol o pananagutan. Nagbibigay ng isa pang mapagpipiliang subukan ang mas matinding kompetisyon; hindi nito itinatakda kung alin ang dapat manaig.
Para sa BIG CHANGE, masusukat na nakumpletong trabaho na mas kaunti ang kabuuang pagsisikap ang susunod na mahalagang hakbang. Kung binabawasan ng Grok 4.7 ang gastos sa mga tinanggap na resulta, maaari nitong gawing available sa mas maraming organisasyon ang kapaki-pakinabang na automation. Kung inililipat lang ng dagdag na pangangatwiran ang gastos mula sa presyo ng token tungo sa dami ng nakokonsumo, kakaunti ang sinasabi ng headline price sa mga mamimili. Malalaman ang sagot mula sa mga nakumpletong gawain, kabilang ang mga pumalya muna.
## Sources
- [Matthew Berman: Hindi ko alam ang mararamdaman ko tungkol sa Grok 4.7…](https://www.youtube.com/watch?v=MJllZbpvrAc) — Setyembre 22, 2026. Bidyong nagpasimula sa pagsusuring ito. Tinutukoy ng mga link na may oras ang mga tinatalakay; inilalarawan ni Berman bilang paunang pagtatasa ang pagsusuri niya. Hiwalay sa ebidensiya tungkol sa modelo ang bahagi nitong naka-sponsor.
- [Ipinapakilala ang Grok 4.7](https://x.ai/news/grok-4-7) — Setyembre 21, 2026. Anunsiyo at mga interaktibong grap ng benchmark ng SpaceXAI. Kailangang tingnan ang setting sa pagsisikap sa mga resulta ng vendor; hindi ito pangkalahatang ranggo.
- [Mga tala sa paglulunsad para sa developer ng xAI](https://docs.x.ai/developers/release-notes) — Itinatatag sa entry noong Setyembre 21 ang availability, konteksto, setting sa pagsisikap at karaniwang presyo ng API pati sa mahabang konteksto. Sinuri noong Setyembre 22; maaaring magbago ang presyo at access sa produkto.
- [Dokumentasyon ng produkto ng Grok 4.7](https://docs.x.ai/developers/grok-4-7) — Ipinapaliwanag ang karaniwang modelo at opsiyon sa serbisyong Fast. Mas makitid ang availability ng Fast kaysa karaniwang modelo ng API, kaya dapat tukuyin ang antas sa demonstrasyon at badyet.
- [Presyo ng modelo ng Grok 4.7](https://docs.x.ai/developers/models/grok-4.7) — Kard ng presyo ng modelo at hangganan ng mas mataas na singil sa prompt na lampas sa 200,000 token. Hindi kasama sa presyo ng token lang ang muling pagsubok, tool at pagsusuri ng tao.
- [Dokumentasyon ng Cursor tungkol sa Grok 4.7](https://prod.cursor.com/docs/models/grok-4-7) — Ibinubukod ang karaniwang laki ng konteksto sa Cursor sa pinakamataas nito. Maaaring naiiba ang setting ng produkto sa kapasidad ng batayang API.
- [Artificial Analysis: Paghahambing sa Grok 4.7](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — Setyembre 21, 2026. Malayang pagsusuri na pinagbabatayan ng talakayan sa paggamit ng token at gawaing kaalaman. Ibinubukod sa ulat ang istandardisadong pagsusuri sa mga resulta ng katutubong agent; hindi dapat pagsamahin ang mga setup na iyon.
- [Artificial Analysis: Profile sa paglulunsad ng Grok 4.7](https://artificialanalysis.ai/models/releases/grok-4-7) — Tinutukoy ang lisensiyang pag-aari ng kompanya ng release at hindi available na mga timbang nito. Hindi patunay na bukas ang timbang ng modelong ito ang pagtalakay sa bidyo sa mga modelong bukas ang timbang.
- [Bahagi na ngayon ng SpaceX ang Cursor](https://cursor.com/blog/joining-spacex) — Agosto 14, 2026. Nagbibigay ng konteksto sa pagsusuri ng benchmark na pino-promote sa kaparehong pamilya ng kompanya ang anunsiyo ng Cursor tungkol sa pagbili rito.
Newsletter ng BIG CHANGE
Ang kabuuang larawan, sa sarili mong bilis.
Mga kamakailang kuwento tungkol sa AI at robotics, mga pagbabagong dapat bantayan, at mga praktikal na ideyang magagamit. Pumili ng araw-araw na briefing, lingguhang digest, o buwanang pananaw.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Privacy mo, pasya mo.
Tumutulong ang kinakailangang storage na panatilihing ligtas ang site at tandaan ang mga pinili mo. Nananatiling naka-off ang opsyonal na Google Analytics hangga’t hindi mo ito pinapahintulutan. Mababasa mo ang lahat ng kuwento gamit lamang ang kinakailangang storage. Mga detalye tungkol sa privacy