AI-translated from English; not yet reviewed by a fluent editor.
# Claude est de retour. Votre entreprise a toujours besoin d’un plan de reprise
> L’incident de Claude du 22 septembre est résolu. Ce guide pratique explique comment les entreprises peuvent maintenir un service réduit, préserver les tâches inachevées et résorber leur propre retard après une panne d’IA.
By BIG CHANGE Editorial
Published: 2026-09-22T08:51:37.833Z
Updated: 2026-09-22T08:51:37.833Z
Canonical: https://bigchange.ai/blog/claude-outage-ai-business-continuity
AI-generated conceptual illustration by BIG CHANGE. When an AI service pauses, a business still needs accessible records of unfinished work. The bookmarked ledger represents preserving the stopping place. Conceptual illustration, not evidence of damaged equipment or lost data.
Le 22 septembre, Claude a connu une hausse des erreurs sur plusieurs modèles. La mise à jour finale de l’incident par Anthropic indique une période d’impact allant de 00 h 50 à 02 h 10 UTC, soit 80 minutes. L’entreprise a déclaré l’incident résolu à 02 h 35 UTC. Les composants touchés répertoriés comprennent claude.ai, l’API, Code et Cowork. Le compte rendu ne dit pas que chaque requête a échoué et ne publie aucune explication de la cause première. [Compte rendu de l’incident par Anthropic.](https://status.claude.com/incidents/7g1qpkyz5gxh)
Pour une entreprise qui utilise l’IA dans un processus de travail, le rétablissement du service ne règle qu’une partie du problème. Des demandes de clients attendent peut-être toujours. Quelqu’un peut avoir commencé à traiter un dossier manuellement tandis qu’une tentative automatisée reste en cours. Un responsable doit savoir quelles tâches peuvent reprendre et lesquelles doivent d’abord être examinées.
Une indisponibilité occasionnelle de l’assistant est gênante lorsqu’il sert à trouver des idées. Quand le même service aide à classer les demandes entrantes, rédiger des réponses et mettre à jour des dossiers, l’interruption devient un problème opérationnel. Une préparation utile consiste en un petit plan de continuité que le personnel peut suivre même sans accès au service d’IA.
Ce guide s’appuie sur un centre de service à la clientèle hypothétique pour illustrer le fonctionnement possible d’un tel plan. Les procédures sont des propositions à adapter et à répéter, et non un test réalisé par BIG CHANGE ni une description de clients touchés par cet incident.
## Choisissez le service que vous pouvez maintenir sans IA
Imaginons un petit fournisseur d’équipements dont l’assistant classe les demandes d’assistance entrantes et prépare des réponses à partir d’informations approuvées sur ses produits. Le personnel relit les réponses avant de les envoyer. L’entreprise compte sur le système pour organiser la file d’attente, même si les réponses restent sous la responsabilité des personnes.
Si l’assistant cesse de répondre, la première décision du responsable consiste à déterminer ce que le centre peut encore promettre. Le personnel pourrait continuer à accuser réception des demandes et à traiter les dossiers dont l’échéance est proche, tout en reportant les explications courantes sur les produits. Il doit pouvoir accéder aux messages d’origine et aux documents de référence approuvés sans passer par l’assistant. Sinon, « passer au traitement manuel » est une consigne sans moyens de l’appliquer.
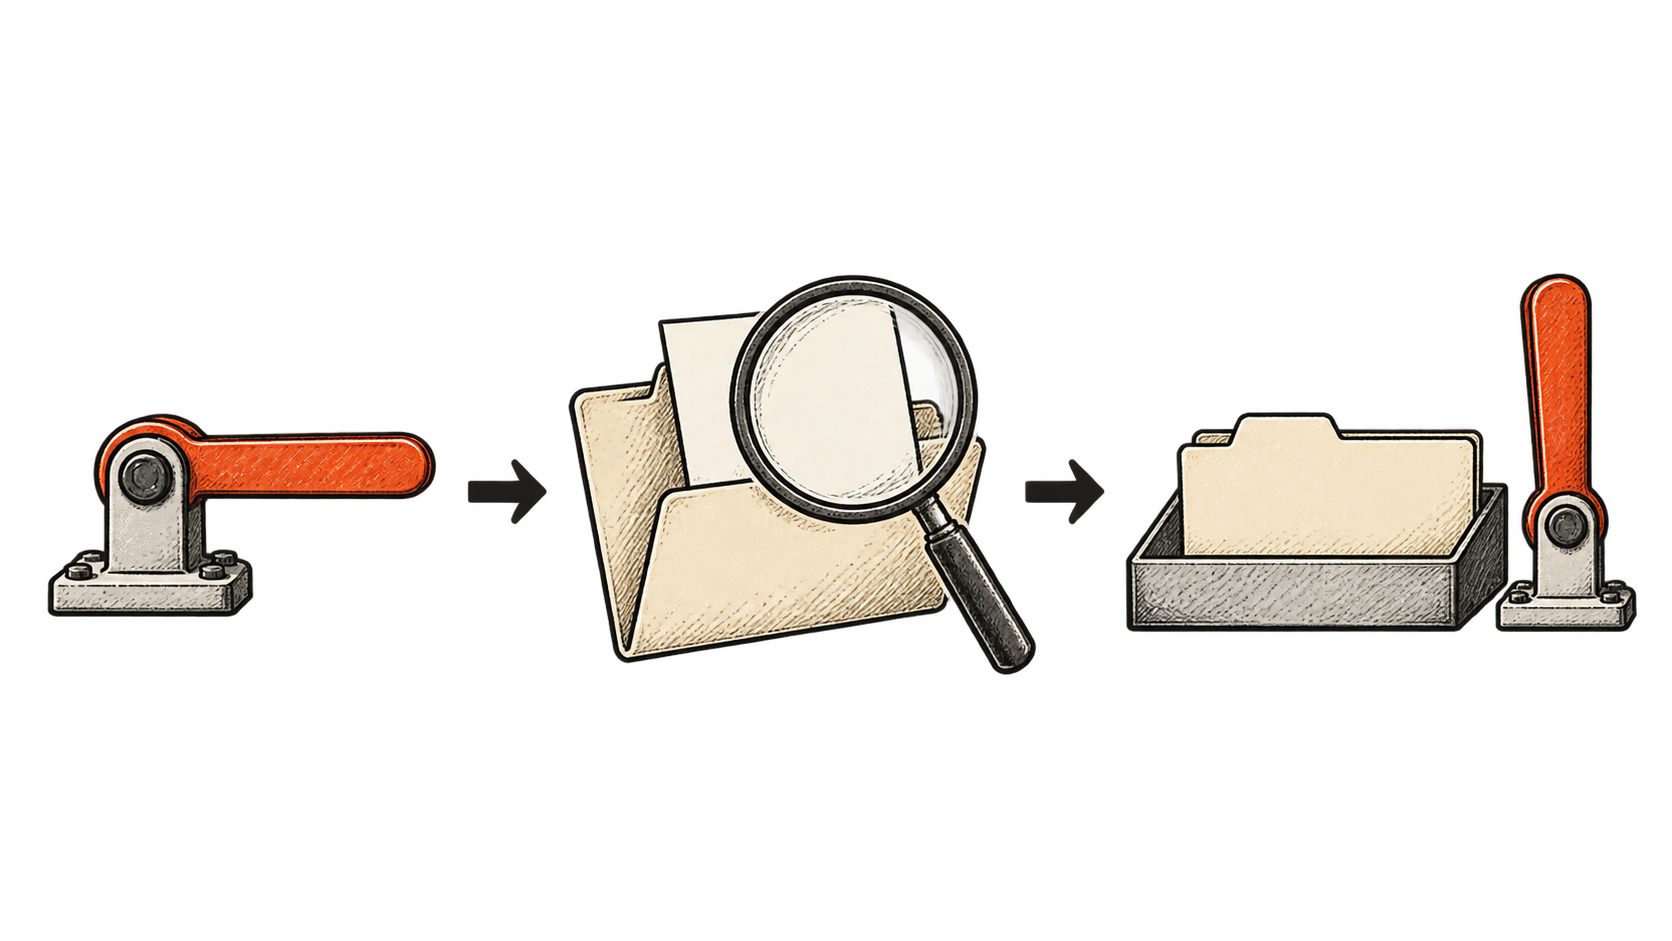
Choisissez à l’avance ce service réduit. Désignez la personne qui peut l’activer, les tâches à suspendre et le personnel chargé des autres tâches. Fixez une heure de réévaluation afin que la solution temporaire ne se prolonge pas tout l’après-midi sans que personne ne la réexamine. Les avis adressés aux clients devraient expliquer le retard et indiquer comment obtenir de l’aide urgente, sans promettre ce que l’équipe ne peut assurer.
Les recommandations techniques de Google sur la gestion des surcharges décrivent des méthodes qui consistent à assurer des fonctionnalités réduites, limiter le trafic et donner la priorité aux demandes importantes lorsque les ressources sont limitées. Ce sont des techniques de fiabilité établies, pas un diagnostic de cet incident de Claude. Adaptées à un centre de service, elles justifient une réduction délibérée du périmètre lorsque le traitement normal ne peut pas se poursuivre. [Google SRE : gestion des surcharges.](https://sre.google/sre-book/handling-overload/)
Le service réduit doit également respecter une limite de capacité. Deux personnes ne peuvent pas absorber en silence la charge d’un système automatisé qui traite normalement bien plus de demandes. Consignez ce qu’elles peuvent traiter, ce qui attendra et à quel moment une aide supplémentaire devient nécessaire. Une indication crédible du délai de réponse aide davantage les clients qu’un accusé de réception automatisé laissant croire que le service fonctionne normalement.
## Consignez les tâches en dehors de la conversation
Le centre de service a besoin d’un dossier qu’il peut consulter lorsque le modèle est indisponible. Il peut s’agir de son système d’assistance existant. L’essentiel est que l’entreprise puisse établir ce qui s’est passé sans demander à l’assistant interrompu de le reconstituer.
Pour chaque dossier, conservez la demande d’origine, la personne ou le processus responsable et la dernière action confirmée. Un brouillon enregistré n’est pas une réponse envoyée. Une modification proposée à un dossier client n’est pas une modification confirmée par ce système. Conservez les éléments nécessaires pour les distinguer, avec les mêmes restrictions d’accès que celles appliquées aux renseignements sous-jacents sur les clients.
Pendant une interruption, répartissez les tâches dans les catégories pratiques suivantes :
- Prête à commencer : aucun traitement ni aucune action externe n’a commencé.
- Partiellement préparée : un classement ou un brouillon existe, mais l’étape suivante n’est pas terminée.
- Terminée et confirmée : le système destinataire consigne l’action prévue.
- Incertaine : une action a été tentée, mais aucune confirmation n’est disponible.
Confiez les dossiers incertains à une personne capable d’examiner le système pertinent avant de les reprendre. Si l’assistant préparait une réponse au moment d’une perte de connexion, un nouveau brouillon peut être sans conséquence. Si un outil distinct était en train d’envoyer cette réponse, répéter toute la tâche pourrait provoquer un double envoi. Le dossier de suivi du processus doit rendre cette distinction visible.
La documentation de l’API d’Anthropic indique qu’une réponse en continu peut échouer après une première réponse HTTP 200 signalant un succès. Voir apparaître le premier texte ou recevoir ce statut initial ne prouve pas que la réponse complète est arrivée. Exigez que l’intégration détecte la fin du traitement et conserve tout travail partiel comme tel. [Documentation sur les erreurs de l’API Claude.](https://platform.claude.com/docs/en/api/errors)
## Limitez les nouvelles tentatives et désignez un responsable
Une nouvelle tentative peut résoudre une défaillance temporaire. Elle peut aussi prolonger l’incertitude si chaque couche répète indépendamment la même tâche. Demandez au fournisseur du logiciel si sa bibliothèque cliente effectue déjà des nouvelles tentatives avant d’ajouter un autre bouton « réessayer » ou une boucle automatique.
Anthropic indique que ses SDK officiels effectuent par défaut deux nouvelles tentatives automatiques en cas de défaillance passagère, avec des délais croissants et le respect d’une instruction Retry-After lorsqu’elle est présente. Sa documentation sur les erreurs distingue également les problèmes temporaires du serveur des échecs d’authentification, d’autorisation ou de requête mal formée. Il ne faut pas supposer que répéter la même requête corrigera toutes les catégories. [Comportement documenté de Claude en matière de nouvelles tentatives.](https://platform.claude.com/docs/en/api/errors)
Pour le centre de service, la règle opérationnelle devrait préciser à quel moment les tentatives automatiques s’arrêtent et qui reçoit ensuite le dossier. Conservez l’identifiant de la requête pour faciliter le diagnostic. Le personnel doit pouvoir voir si une tâche est en attente, en cours de nouvelle tentative ou confiée à une personne, afin de ne pas lancer par inadvertance des opérations concurrentes.
AWS explique qu’une action peut réussir même si sa réponse n’arrive jamais. Ses API idempotentes utilisent un identifiant de requête explicite pour reconnaître les répétitions et empêcher des effets secondaires supplémentaires. Le service destinataire doit appliquer ce mécanisme ; joindre uniquement un numéro de dossier interne ne fournit aucune protection de ce type. [AWS : sécuriser les nouvelles tentatives.](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/)
Posez des questions précises sur les actions de votre processus. Une répétition peut-elle créer un autre ticket d’assistance ou envoyer un autre courriel ? Si la prévention des doublons n’est pas disponible, le plan doit prévoir de vérifier le dossier destinataire avant une nouvelle tentative. Réessayer une génération de texte et répéter tout un processus métier exigent des décisions différentes.
## Un modèle de secours doit avoir une mission plus limitée
Un autre service d’IA peut aider à maintenir le travail, mais ouvrir un deuxième compte n’est que la première étape d’une solution de secours. Le service de remplacement doit disposer des consignes adéquates, des documents de référence approuvés et de l’autorisation de traiter les données. Il lui faut aussi de la capacité au moment où l’entreprise en a besoin.
Choisissez une tâche de secours bien délimitée avant d’essayer de remplacer entièrement le système. Dans notre centre hypothétique, un autre modèle pourrait classer les demandes courantes pendant que le personnel traite les réponses destinées aux clients. L’équipe pourrait l’évaluer sur des cas représentatifs, notamment des noms de produits ambigus et des demandes à transmettre à une personne. Une réponse fluide ne prouverait pas à elle seule que le modèle respecte les règles d’assistance de l’entreprise.
Décidez avant l’incident quelles informations peuvent être envoyées au service de remplacement. Le personnel ne devrait pas improviser en copiant des dossiers clients dans des comptes personnels. Lors de l’achat, examinez les conditions de traitement des données et les modalités d’accès du service de secours, en plus de la qualité et du prix de ses réponses.
Des noms de modèles différents ne garantissent pas non plus une disponibilité indépendante. La solution de secours peut encore dépendre du même identifiant de connexion, réseau, dépôt documentaire ou logiciel d’orchestration. Cartographiez les dépendances que votre solution proposée évite réellement. Vous constaterez peut-être qu’une file d’attente manuelle avec des documents de référence accessibles protège mieux l’activité qu’un autre modèle derrière la même connexion défaillante.
Les solutions de remplacement nécessitent une maintenance à mesure que les consignes changent et que les connaissances sur les produits vieillissent. Le personnel doit s’exercer aux procédures qu’il utilise rarement. Une petite entreprise peut raisonnablement maintenir un service manuel plus lent plutôt que de payer pour dupliquer toute l’opération. Le choix devrait dépendre du coût des retards et des risques d’une réponse erronée.
## Reprenez le travail à partir d’une file d’attente vérifiée
Lorsque le fournisseur annonce le rétablissement, vérifiez un petit échantillon de votre propre processus avant de reprendre le traitement normal. Incluez un dossier qui met à l’épreuve la recherche documentaire et la mise à jour de dossiers dont votre entreprise a besoin. Une réponse réussie du modèle ne prouve pas que tous les systèmes connectés sont prêts.
Examinez ensuite les tâches en attente. Retirez les dossiers déjà traités manuellement, vérifiez les actions incertaines et repérez les demandes dont la situation a changé. Un client a peut-être fourni de nouvelles informations pendant l’interruption. Rédiger une réponse à partir d’une ancienne version du dossier pourrait créer un nouveau problème après la fin de la défaillance technique.
Remettez le travail restant en circulation par lots contrôlés. Gardez de la capacité pour les nouvelles demandes urgentes et vérifiez si la file d’attente diminue. Si les nouvelles demandes absorbent toute la capacité de traitement disponible, l’arriéré persistera même si chaque nouvelle tentative réussit. Le rattrapage peut nécessiter du personnel supplémentaire, une réduction temporaire du service ou une prolongation annoncée des délais de réponse.
Prenons un autre exemple chiffré. Supposons que 24 dossiers arrivent par heure et que le traitement s’interrompe pendant 30 minutes. Il y en aura alors 12 en attente. Si le centre en traite ensuite 36 par heure tandis que 24 nouveaux dossiers continuent d’arriver, il lui faudra une heure pour résorber l’arriéré. Ces hypothèses sont illustratives ; elles ne constituent pas des mesures de l’incident Claude.
Les recommandations de Google sur les objectifs de niveau de service commencent par définir le résultat important pour les utilisateurs et les dépendances nécessaires à sa réalisation. Pour ce centre, un indicateur utile pourrait être la proportion de dossiers urgents recevant une réponse appropriée dans le délai promis. La disponibilité du fournisseur est pertinente, mais l’entreprise doit aussi savoir si ses clients ont reçu le service. [Google SRE : mise en œuvre des objectifs de niveau de service.](https://sre.google/workbook/implementing-slos/)
Consignez l’heure à laquelle le service client normal a repris, le nombre de dossiers non résolus et les corrections nécessaires par la suite. Ces indicateurs révèlent le travail de rétablissement qu’une page d’état du fournisseur ne peut pas observer.
## Répétez un scénario d’interruption avant d’étendre l’automatisation
Un bref exercice sur table peut révéler des problèmes d’accès ou de responsabilité sans perturber les clients. Utilisez quelques cas d’assistance fictifs et parcourez les étapes suivantes :
1. Supposez que le modèle devienne indisponible au milieu de la préparation d’une réponse. Demandez qui active le service réduit et où le personnel trouvera la demande d’origine.
2. Attribuez à un dossier une réponse dont l’envoi est confirmé et à un autre une tentative d’envoi incertaine. Vérifiez si l’équipe sait quel système permet d’établir le résultat.
3. Supposez que le fournisseur ait rétabli son service alors que de nouveaux dossiers continuent d’arriver. Décidez quelles tâches reprendre d’abord et comment retirer de l’arriéré les dossiers déjà traités manuellement.
4. Demandez à quelqu’un d’autre que l’auteur du plan d’expliquer la procédure et d’indiquer les autorisations ou les dossiers qui lui manquent.
Notez les questions auxquelles l’exercice n’a pas permis de répondre. Les corrections nécessaires peuvent être modestes : accès à une file d’attente existante, commande de pause clairement identifiable, confirmation enregistrée ou responsable désigné pour le rétablissement. Aucune ne garantit un service ininterrompu. Chacune peut aider à contenir une interruption sans renoncer aux avantages de l’automatisation.
Avant de confier une autre responsabilité opérationnelle à un assistant, demandez à un collègue de montrer comment elle serait gérée en cas de panne. Si la réponse dépend de la mémoire de l’assistant indisponible sur ce qu’il était en train de faire, le plan de continuité reste à compléter.
## Sources
- [État de Claude : erreurs accrues sur plusieurs modèles](https://status.claude.com/incidents/7g1qpkyz5gxh) — Le compte rendu du fournisseur indique une période d’impact de 80 minutes et une heure ultérieure de résolution. Le fichier JSON public a été consulté indépendamment. Il fait état d’erreurs accrues, et non d’une panne totale, et ne publie aucune explication de la cause première.
- [Claude Platform : erreurs de l’API](https://platform.claude.com/docs/en/api/errors) — La documentation actuelle couvre les erreurs, les nouvelles tentatives par défaut des SDK et les défaillances après le début d’une réponse en continu. Ces mécanismes ne prouvent pas qu’une tâche métier est terminée et ne préviennent pas les actions en double dans les outils connectés.
- [AWS Builders’ Library : sécuriser les nouvelles tentatives avec des API idempotentes](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/) — Explication par Malcolm Featonby des réponses incertaines et de la prévention des doublons. Le service destinataire doit mettre en œuvre le contrat de l’API ; un identifiant seul ne suffit pas.
- [Google SRE : gestion des surcharges](https://sre.google/sre-book/handling-overload/) — Recommandations techniques établies sur la réduction des fonctionnalités, la priorisation et les nouvelles tentatives limitées. L’article adapte ces principes à un centre de service hypothétique ; ils ne diagnostiquent pas la cause de l’incident d’Anthropic.
- [Google SRE Workbook : mise en œuvre des SLO](https://sre.google/workbook/implementing-slos/) — Explique les objectifs de fiabilité fondés sur les résultats pour les utilisateurs et les dépendances critiques. L’indicateur proposé pour le service client et l’exemple d’arriéré sont des applications illustratives, et non des résultats observés ou une cible universelle.
La newsletter BIG CHANGE
Prendre du recul, à votre rythme.
Articles récents sur l’IA et la robotique, évolutions à surveiller et idées pratiques à utiliser. Choisissez un briefing quotidien, une synthèse hebdomadaire ou une analyse mensuelle.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Votre vie privée, votre choix.
Le stockage nécessaire contribue à la sécurité du site et mémorise vos choix. Google Analytics facultatif reste désactivé tant que vous ne l’autorisez pas. Vous pouvez lire tous les articles avec le seul stockage nécessaire. Détails sur la confidentialité