AI-translated from English; not yet reviewed by a fluent editor.
# Grok 4.7 conserve le même prix par jeton. Le coût du travail achevé compte davantage.
> Le lancement de Grok 4.7 promet de meilleures performances en programmation et en bureautique. Nous examinons la couverture de Matthew Berman, les tests indépendants et les mesures que les équipes devraient prendre avant de changer de modèle.
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
Grok 4.7 est arrivé le 21 septembre 2026. Pour les équipes qui achètent de l’IA afin d’écrire du code ou d’analyser des informations commerciales, sa sortie pose une question concrète : un meilleur modèle rend-il le travail achevé moins cher ? La réponse dépend de bien plus que des tarifs annoncés par jeton. [Notes de version officielles](https://docs.x.ai/developers/release-notes)
Cette appréciation nuancée est au cœur de la vidéo de Matthew Berman publiée le 22 septembre, *Je ne sais pas quoi penser de Grok 4.7…*. Il remet en question le choix des comparaisons et soutient que le coût par tâche accomplie compte davantage que le prix des jetons. Il précise aussi qu’il n’a pas testé le modèle en profondeur. Sa vidéo constitue une première appréciation des éléments disponibles, et non une évaluation pratique exhaustive. [Introduction de Berman, 0:00](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
Le lancement mérite l’attention, car un modèle utile n’a pas besoin de gagner tous les benchmarks pour changer ce que les entreprises peuvent automatiser à un coût abordable. Il doit toutefois accomplir correctement suffisamment de tâches pour justifier son coût total. Les tests indépendants font déjà ressortir cette tension : les meilleurs résultats de Grok 4.7 peuvent s’accompagner d’un volume de texte généré bien supérieur.
Pour les développeurs, les petites entreprises et les équipes qui construisent des agents, la décision est donc pratique. Quelles tâches ce modèle peut-il accomplir à un niveau de qualité acceptable ? De quel effort a-t-il besoin ? Et quelle part du travail reste à une personne après que le modèle a déclaré avoir terminé ?
Nous avons étudié l’intégralité des sous-titres de la vidéo d’environ 17 minutes de Berman et vérifié l’annonce du lancement, la documentation du produit et l’évaluation d’Artificial Analysis. L’analyse qui suit ne contient ni benchmark de BIG CHANGE ni affirmation selon laquelle nous aurions testé Grok de première main.
## Ce qui a été lancé et où le modèle est disponible
Le modèle standard est disponible sur l’API xAI sous le nom `grok-4.7`, ainsi que dans Cursor et Grok Build. L’API accepte le texte et les images et génère du texte. La fenêtre de contexte documentée est de 500 000 jetons, avec quatre niveaux de raisonnement : low, medium, high et xhigh. Le niveau par défaut est high. [Notes de version officielles](https://docs.x.ai/developers/release-notes)
SpaceXAI attribue l’amélioration à un modèle de base plus grand et à un apprentissage par renforcement plus long sur des tâches plus difficiles. C’est l’explication du développeur. [Présentation technique du lancement](https://x.ai/news/grok-4-7)
Il existe aussi Grok 4.7 Fast. La documentation le décrit comme le même modèle exécuté sur une infrastructure plus rapide, facturé au double des tarifs standard par jeton. Il est proposé dans Cursor et Grok Build, exclu de l’offre gratuite de Grok Build et indisponible sur l’API publique xAI. [Documentation du produit Grok 4.7](https://docs.x.ai/developers/grok-4-7)
Ces distinctions comptent lorsqu’on compare des captures d’écran, des démonstrations et des factures. La version du modèle, le niveau de raisonnement et le mode de service sont des choix distincts. Une démonstration exécutée avec Fast en mode xhigh ne permet pas d’estimer l’expérience ni le coût d’un appel à l’API standard en mode medium.
La comparaison de la page de lancement avec d’autres modèles doit également être distinguée de la comparaison entre mises à niveau. SpaceXAI indique que Grok 4.7 standard coûte le même prix et fonctionne à la même vitesse que Grok 4.6. L’entreprise ne dit pas que le passage de la version 4.6 à la 4.7 réduit automatiquement la facture du client de moitié.
## Le tarif change au-delà d’un seuil de contexte long
Les tarifs publiés pour l’API standard sont les suivants :
- Jusqu’à 200 000 jetons d’entrée : 2 $ par million de jetons d’entrée, 0,50 $ par million de jetons d’entrée mis en cache et 6 $ par million de jetons de sortie.
- Au-delà de 200 000 jetons d’entrée : 4 $ par million de jetons d’entrée, 1 $ par million de jetons d’entrée mis en cache et 12 $ par million de jetons de sortie.
Ce sont des tarifs par jeton, et non le prix tout compris d’un agent qui accomplit une tâche. La page du modèle signale des tarifs plus élevés lorsque les requêtes dépassent 200 000 jetons ; les notes de version précisent ces tarifs. Les prix et la disponibilité ont été vérifiés le 22 septembre. [Tarifs du modèle](https://docs.x.ai/developers/models/grok-4.7) et [notes de version](https://docs.x.ai/developers/release-notes)
Une fenêtre de contexte de 500 000 jetons ne signifie donc pas que toute requête qui y tient bénéficie du tarif le plus bas. Une fenêtre de contexte étendue ne garantit pas non plus que le modèle retrouvera systématiquement chaque détail pertinent dans une grande collection de fichiers.
La documentation de Cursor apporte une autre distinction au niveau du produit : elle indique une fenêtre standard de 256 000 jetons et un maximum de 500 000. La capacité disponible dans un éditeur peut différer de la spécification de l’API ou dépendre du mode choisi. [Documentation de Cursor sur Grok 4.7](https://prod.cursor.com/docs/models/grok-4-7)
Pour une équipe qui traite de longs rapports, la question immédiate est de savoir si l’envoi de l’ensemble des documents améliore suffisamment le résultat pour en justifier le coût. Extraire les sections pertinentes peut être moins cher et plus facile à vérifier. Le document entier est parfois nécessaire ; parfois, c’est simplement la façon la plus facile de préparer une requête. Ces situations ne devraient pas être budgétées comme si elles étaient identiques.
## De meilleures performances peuvent consommer plus de jetons
L’évaluation du 21 septembre d’Artificial Analysis attribue à Grok 4.7 en mode xhigh un score de 46 dans son Intelligence Index, soit deux points de plus que Grok 4.6. Elle indique environ 81 000 jetons de sortie par tâche, contre 36 000 pour Grok 4.6 en mode high. Le même rapport indique 38 000 jetons pour Grok 4.6 en mode xhigh ; même cette comparaison à effort égal fait donc état d’un volume de sortie plus de deux fois supérieur. [Évaluation du lancement par Artificial Analysis](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
C’est une raison concrète de distinguer le prix des jetons du coût d’une tâche. L’utilisation de 81 000 jetons de sortie au tarif de base de 6 $ par million produit un coût indicatif de 0,486 $. Avec 38 000 jetons, le montant serait de 0,228 $. Ces calculs excluent délibérément les jetons d’entrée, la mise en cache, les frais d’outils, le tarif majoré au-delà du seuil de contexte et les tentatives infructueuses. Il s’agit de calculs arithmétiques à partir des volumes rapportés, et non de prix mesurés pour des tâches complètes.
Un volume de sortie plus important n’est pas automatiquement du gaspillage. Le modèle peut consacrer davantage d’efforts à vérifier une réponse et éviter une erreur qui nécessiterait sinon l’intervention d’une personne. Il peut aussi s’attarder plus longtemps à poursuivre une mauvaise approche. Le nombre de jetons ne suffit pas à distinguer la persévérance productive de la répétition coûteuse.
Berman revient sur ce problème vers la fin de sa vidéo, où il relève la consommation de jetons plus élevée rapportée par Artificial Analysis. [Vidéo, 15:43](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
Le résultat utile est un livrable accepté. Une modification de code qui passe les tests appropriés et l’examen, un tableur dont les formules se recoupent ou un rapport dont les affirmations sont étayées ont une valeur différente de celle d’une réponse qui arrive simplement vite.
## Les benchmarks montrent un modèle capable, mais inégal
Le tableau du lancement attribue à Grok 4.7 en mode xhigh un score de 46,3 % sur CursorBench 4.0, inférieur aux 51,8 % de Fable 5.1 en mode max. Fable est également en tête dans la comparaison Terminal-Bench. [Tableau de benchmarks du fournisseur](https://x.ai/news/grok-4-7)
Le graphique associé représente le score du benchmark en fonction du nombre de jetons de sortie, qui diminue vers la droite. Ses courbes comparent différents niveaux de raisonnement. [Graphique interactif original : sélectionner « Tokens »](https://x.ai/news/grok-4-7). [Ouvrir le graphique en taille réelle](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png).
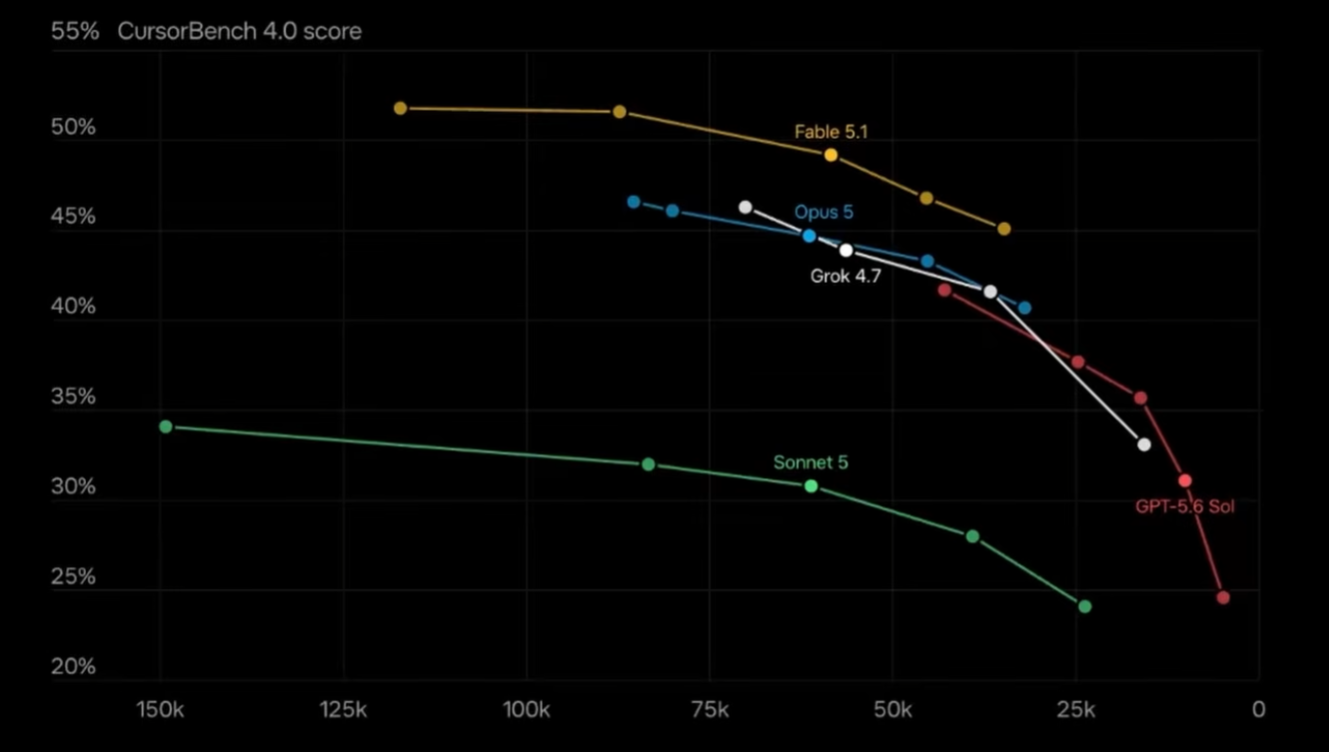
Se déplacer vers le haut signifie obtenir un score plus élevé ; se déplacer vers la droite signifie générer moins de jetons dans cette évaluation. Cela ne signifie pas que le prix tout compris est inférieur : les tarifs par jeton, la consommation en entrée et l’agent utilisé autour du modèle comptent aussi. Il s’agit également d’un test différent des volumes de jetons rapportés plus haut par Artificial Analysis. Combiner ces résultats ferait disparaître les différences de tâches et de méthodologie qui permettent de les interpréter.
Cela suffit pour écarter toute affirmation générale selon laquelle Grok 4.7 serait en tête dans toutes les formes de programmation. Cela justifie aussi d’examiner de plus près certains types de tâches. L’ampleur d’un progrès sur une évaluation ne permet pas de déterminer comment un modèle traitera un dépôt de code inconnu, un rapport de bug incomplet ou un environnement d’outils inhabituel.
Artificial Analysis met en évidence une autre distinction utile. Son rapport attribue à Grok 4.7 utilisé avec Grok Build un score de 56 dans le Coding Agent Index, contre 47 pour Grok 4.6 avec le même agent. Il distingue explicitement ces résultats avec agent natif de la configuration standardisée de son Intelligence Index. [Évaluation indépendante et notes méthodologiques](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
L’agent utilisé autour du modèle compte. Il fournit des outils, gère le contexte et décide comment exécuter les requêtes du modèle. Changer cet environnement peut modifier les résultats même si le nom du modèle reste identique. Combiner un score de terminal obtenu dans une configuration avec un score de génie logiciel obtenu dans une autre peut produire un tableau convaincant qui ne décrit aucun système réellement testé.
Berman relève l’absence de GPT-6 Astra dans l’un des tableaux du lancement et le reconstitue à l’aide d’un contenu généré par IA. C’est une bonne raison d’examiner la comparaison ; cette reconstitution ne constitue pas une source de benchmark indépendante. Nous ne reprenons pas les chiffres ajoutés sans vérifier l’évaluation sous-jacente. [Vidéo, 6:03](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
Il faut aussi tenir compte d’une relation commerciale. L’annonce de l’entreprise Cursor, datée du 14 août, indique qu’elle a été rachetée par SpaceX. Un benchmark publié au sein de la même famille de produits reste un élément utile, mais ce n’est pas une évaluation désintéressée d’un fournisseur concurrent. [Annonce du rachat de Cursor](https://cursor.com/blog/joining-spacex)
## La bureautique est peut-être une occasion plus intéressante
L’évaluation indépendante attribue à Grok 4.7 en mode xhigh un score de 1 657 Elo dans AA-Briefcase, soit 111 points de plus que Grok 4.6 en mode high. Elle attribue une grande part de l’amélioration à la qualité de l’analyse, tandis que la qualité de présentation est légèrement inférieure au résultat du modèle précédent. [Résultats d’Artificial Analysis sur le travail intellectuel](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
Cette différence est utile à toute personne qui commande des rapports, des tableurs ou des présentations. Une réponse peut proposer une meilleure analyse tout en nécessitant des retouches ou une nouvelle mise en page. À l’inverse, une présentation soignée peut masquer un raisonnement superficiel. Ne juger que le résultat visible risque de récompenser la mauvaise amélioration.
Une équipe opérationnelle pourrait tester le modèle sur un rapport de performance récurrent. Un essai utile vérifierait s’il utilise la bonne période, rapproche les chiffres des données sources et distingue une variation observée d’une explication proposée. La personne qui le relit devrait noter les corrections nécessaires, et pas seulement si le rapport paraît professionnel au premier regard.
Une petite entreprise pourrait accorder moins d’importance à la victoire sur le benchmark le plus difficile qu’à la possibilité de rendre courante une analyse jusque-là trop coûteuse. C’est une voie plausible vers une adoption plus large. Elle devient concrète lorsque le résultat est suffisamment exact, arrive à temps et laisse au dirigeant moins de travail que l’exécution manuelle.
Les intitulés des benchmarks professionnels ne doivent pas être confondus avec des qualifications professionnelles. Un résultat en matière juridique ou de raisonnement clinique décrit les performances lors de cette évaluation. Il ne prouve pas qu’un modèle peut traiter seul le dossier juridique d’un client ni prendre une décision de soins pour un patient. Cet article ne recommande pas d’utiliser Grok pour de telles décisions.
## Les garanties sont aussi à évaluer dans leur contexte
SpaceXAI affirme que Grok 4.7 dispose d’un nouvel ensemble de garanties et résiste mieux aux tentatives de contournement. C’est une affirmation liée au lancement, pas une garantie que toutes les applications utilisant le modèle seront sûres. [Présentation de la sécurité par le développeur](https://x.ai/news/grok-4-7)
Pour un agent d’entreprise, au moins deux questions restent ouvertes. Le modèle répond-il comme il convient aux requêtes qu’il reçoit ? Et l’application limite-t-elle ce que le modèle peut réellement faire ?
Un modèle peut comprendre correctement une consigne de modification d’un dossier client sans avoir le droit d’effectuer cette modification. Il peut aussi rencontrer des instructions malveillantes incorporées dans un document qu’il devait résumer. Les contrôles d’accès et les règles d’approbation doivent rester intégrés au système environnant ; un comportement de refus amélioré ne les remplace pas.
La conséquence pratique est qu’il faut tester l’ensemble du processus. Inclure des requêtes légitimes qui devraient aboutir, des actions interdites qui devraient être bloquées et des cas ambigus qui devraient entraîner une demande de précision. Un produit qui refuse trop souvent des tâches inoffensives peut devenir inutilisable ; un produit qui exécute des actions non autorisées peut faire bien pire. Aucun de ces problèmes n’apparaît dans un simple score de référence.
## Ce que la vidéo laisse en suspens
La couverture de Berman soulève plusieurs questions qui doivent rester ouvertes. Son explication reliant les prix aux capacités de calcul disponibles relève d’une interprétation du marché, et non d’une comptabilité des coûts unitaires publiée. Les prévisions diffusées sur les réseaux sociaux qu’il évoque sont des attentes, pas des preuves de performances obtenues. Sa comparaison finale de démonstrations s’accompagne de son propre aveu qu’il ignore quels paramètres ont été utilisés. [Discussion sur les prix, 8:44](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s), [prévisions, 11:51](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s) et [discussion de la démonstration, 15:20](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
La vidéo aborde aussi les modèles à poids ouverts. Cette tendance concurrentielle plus large ne doit pas être confondue avec la licence de Grok 4.7 : Artificial Analysis indique que cette version est propriétaire et que ses poids ne sont pas disponibles. [Fiche de lancement de Grok 4.7](https://artificialanalysis.ai/models/releases/grok-4-7)
Ces distinctions permettent de garder l’évaluation centrée sur l’essentiel. Un produit peut être proposé à un prix attrayant sans que le public sache pourquoi son fournisseur l’a choisi. Une démonstration ratée et frappante peut mettre en évidence un test à répéter sans prouver que le modèle est généralement mauvais. Un modèle disponible peut être utile sans correspondre aux prévisions antérieures de son fondateur.
Il faut également tenir compte d’une limite liée au parrainage. La vidéo de Berman comprend une publicité pour Zapier. Elle ne constitue pas une preuve indépendante des performances de Grok, et ses arguments promotionnels ne sont pas des recommandations de BIG CHANGE.
## Une meilleure mesure d’achat : le coût par tâche acceptée
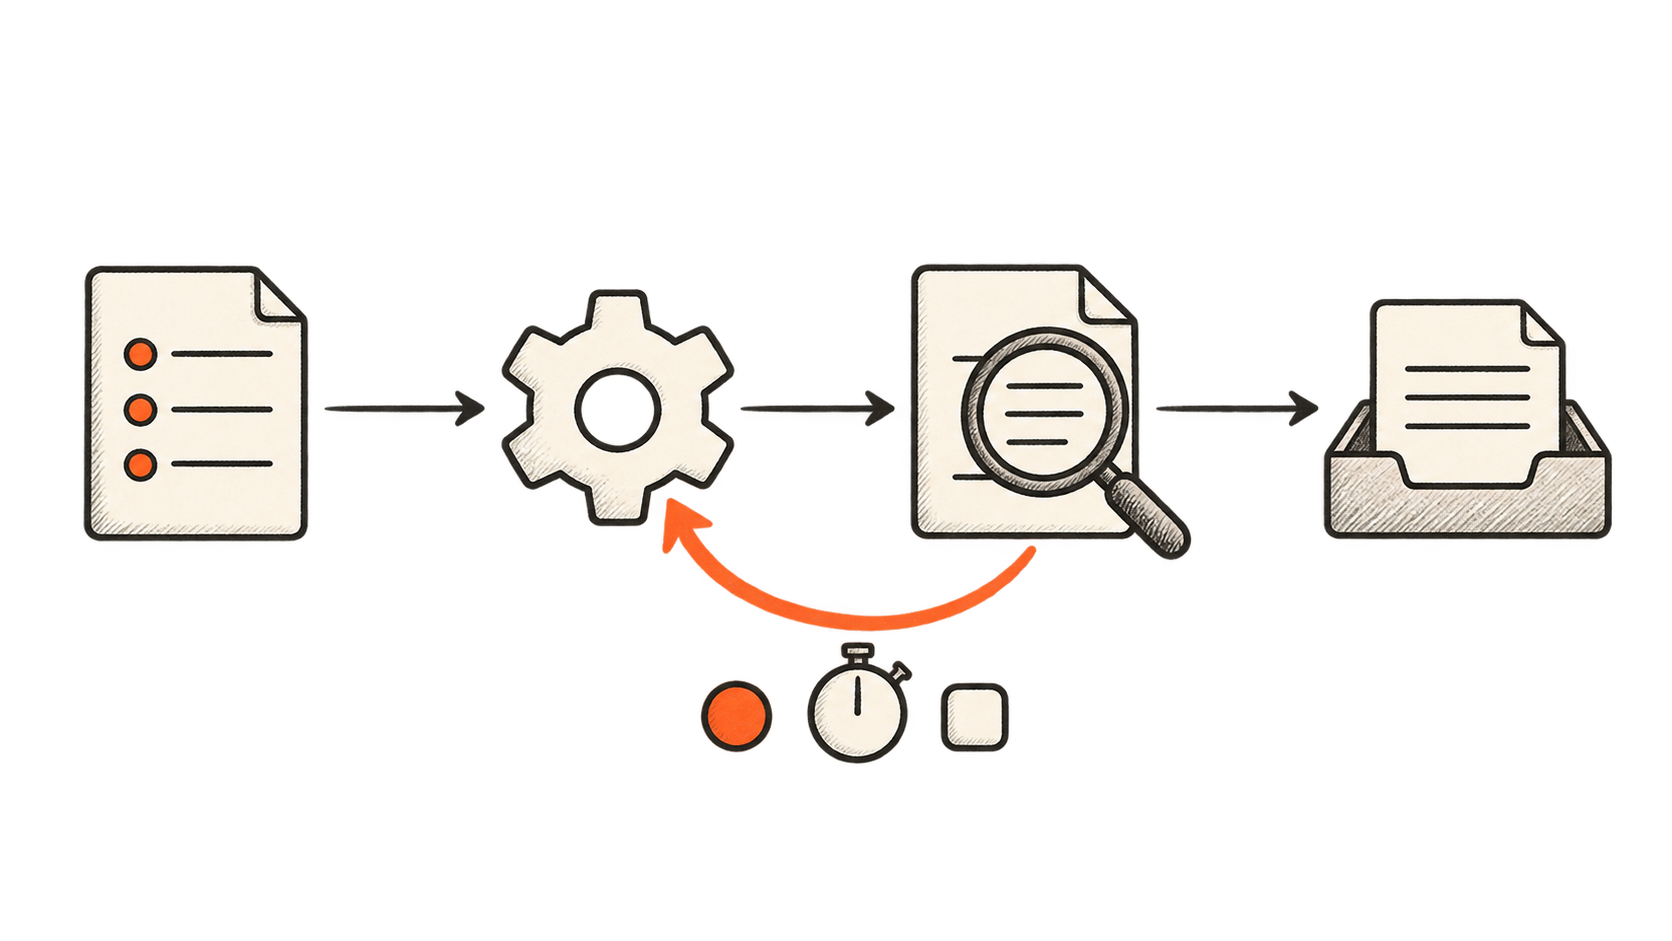
Une équipe qui envisage Grok 4.7 devrait le comparer à son processus actuel sur un petit ensemble représentatif de tâches. Il faut définir les critères d’acceptation avant de voir les résultats. Pour le code, cela pourrait comprendre des tests pertinents, un correctif lisible et l’absence de changements sans rapport avec la tâche. Pour l’analyse, des calculs exacts et des preuves à l’appui des affirmations importantes.
Consigner ensuite la facture complète : consommation d’entrée et de sortie, outils, nouvelles tentatives et temps passé à examiner ou réparer le résultat. Compter aussi les tentatives infructueuses. Diviser ce coût par le nombre de livrables qui répondent aux critères d’acceptation.
Un exemple indicatif montre pourquoi cette distinction compte. Supposons qu’une configuration coûte 20 $ pour un lot et produise 80 résultats acceptés. Son coût mesuré est de 0,25 $ par résultat accepté, avant le travail humain. Une autre coûte 12 $, mais ne produit que 30 résultats acceptés : elle revient à 0,40 $ par résultat accepté. Le lot le moins cher est la source de travail exploitable la plus coûteuse. Ces chiffres sont hypothétiques et ne mesurent pas Grok.
Le niveau de raisonnement devrait faire partie de cet essai. Le niveau high peut justifier son coût pour une tâche difficile et n’apporter que peu sur une tâche courante. N’intensifier l’effort que pour les cas qui en ont besoin pourrait coûter moins cher que d’exécuter chaque requête en xhigh, à condition d’évaluer également la décision d’aiguillage.
Maintenir les critères d’examen identiques pour tous les modèles. Abaisser la barre pour un modèle moins cher donne l’illusion d’une économie en acceptant un travail de moindre qualité. Rehausser la barre uniquement pour le modèle déjà utilisé crée la distorsion inverse. L’objectif est d’acheter un résultat fiable et de préciser ce que les personnes doivent encore faire.
## Le changement à suivre
Grok 4.7 offre aux équipes une option supplémentaire à tester. Pour le choisir, il faut examiner toute la tâche : ce que le modèle produit, ce qu’il consomme et ce qu’une personne doit encore réparer.
La conséquence plus large pourrait être un usage plus sélectif de l’IA dans le travail quotidien. Une équipe peut choisir une configuration pour les analyses courantes, une autre pour les tâches de programmation difficiles et une personne lorsque le jugement ou la responsabilité ne peuvent être délégués. Une concurrence accrue donne une option de plus à tester ; elle ne détermine pas laquelle doit l’emporter.
Pour BIG CHANGE, la prochaine étape mesurable consiste à achever des tâches avec moins d’effort total. Si Grok 4.7 réduit le coût des livrables acceptés, il peut rendre l’automatisation utile accessible à davantage d’organisations. Si un raisonnement supplémentaire ne fait que déplacer les dépenses du prix par jeton vers le volume consommé, le prix affiché renseignera peu les acheteurs. Seules les tâches menées à terme, y compris celles qui ont d’abord échoué, permettront de trancher.
## Sources
- [Matthew Berman : je ne sais pas quoi penser de Grok 4.7…](https://www.youtube.com/watch?v=MJllZbpvrAc) — 22 septembre 2026. Vidéo à l’origine de cette analyse. Les liens horodatés renvoient aux discussions examinées ; Berman présente son appréciation comme préliminaire. Le segment de parrainage est distinct des éléments sur le modèle.
- [Présentation de Grok 4.7](https://x.ai/news/grok-4-7) — 21 septembre 2026. Annonce et graphiques interactifs de benchmarks de SpaceXAI. Les résultats du fournisseur doivent être interprétés en tenant compte du niveau d’effort ; ils ne constituent pas un classement universel.
- [Notes de version des développeurs xAI](https://docs.x.ai/developers/release-notes) — L’entrée du 21 septembre établit la disponibilité, le contexte, les niveaux d’effort et les tarifs standard et long contexte de l’API. Vérifiée le 22 septembre ; les prix et l’accès aux produits peuvent évoluer.
- [Documentation du produit Grok 4.7](https://docs.x.ai/developers/grok-4-7) — Explique le modèle standard et l’option de service Fast. Fast est disponible dans moins de produits que le modèle standard de l’API ; les démonstrations et les budgets doivent préciser le niveau utilisé.
- [Tarifs du modèle Grok 4.7](https://docs.x.ai/developers/models/grok-4.7) — Grille tarifaire et seuil à partir duquel le prix augmente pour les requêtes dépassant 200 000 jetons. Les tarifs par jeton seuls ne comprennent pas les nouvelles tentatives, les outils ni la relecture humaine.
- [Documentation de Cursor sur Grok 4.7](https://prod.cursor.com/docs/models/grok-4-7) — Distingue la fenêtre de contexte standard de Cursor de sa capacité maximale. Les paramètres du produit peuvent différer de la capacité de l’API sous-jacente.
- [Artificial Analysis : évaluation comparative de Grok 4.7](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — 21 septembre 2026. Tests indépendants à l’origine de l’analyse de la consommation de jetons et du travail intellectuel. Le rapport distingue l’évaluation standardisée des résultats avec agent natif ; ces configurations ne doivent pas être confondues.
- [Artificial Analysis : fiche de lancement de Grok 4.7](https://artificialanalysis.ai/models/releases/grok-4-7) — Indique que la licence de cette version est propriétaire et que ses poids ne sont pas disponibles. La concurrence des modèles à poids ouverts évoquée dans la vidéo ne prouve pas que ce modèle soit lui-même à poids ouverts.
- [Cursor fait désormais partie de SpaceX](https://cursor.com/blog/joining-spacex) — 14 août 2026. L’annonce du rachat de Cursor donne un contexte utile pour évaluer un benchmark promu au sein du même groupe d’entreprises.
La newsletter BIG CHANGE
Prendre du recul, à votre rythme.
Articles récents sur l’IA et la robotique, évolutions à surveiller et idées pratiques à utiliser. Choisissez un briefing quotidien, une synthèse hebdomadaire ou une analyse mensuelle.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Votre vie privée, votre choix.
Le stockage nécessaire contribue à la sécurité du site et mémorise vos choix. Google Analytics facultatif reste désactivé tant que vous ne l’autorisez pas. Vous pouvez lire tous les articles avec le seul stockage nécessaire. Détails sur la confidentialité