AI-translated from English; not yet reviewed by a fluent editor.
# Dans le test de codage de Vals AI, une équipe d’agents a gagné 7,3 points, à un coût 2,5 fois supérieur
> Vals AI n’a constaté un gain statistiquement significatif pour une équipe que pour GPT 6 Sol à effort moyen, sur 50 créations d’applications ; cette configuration a coûté 3,07 $ contre 1,22 $ par application.
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
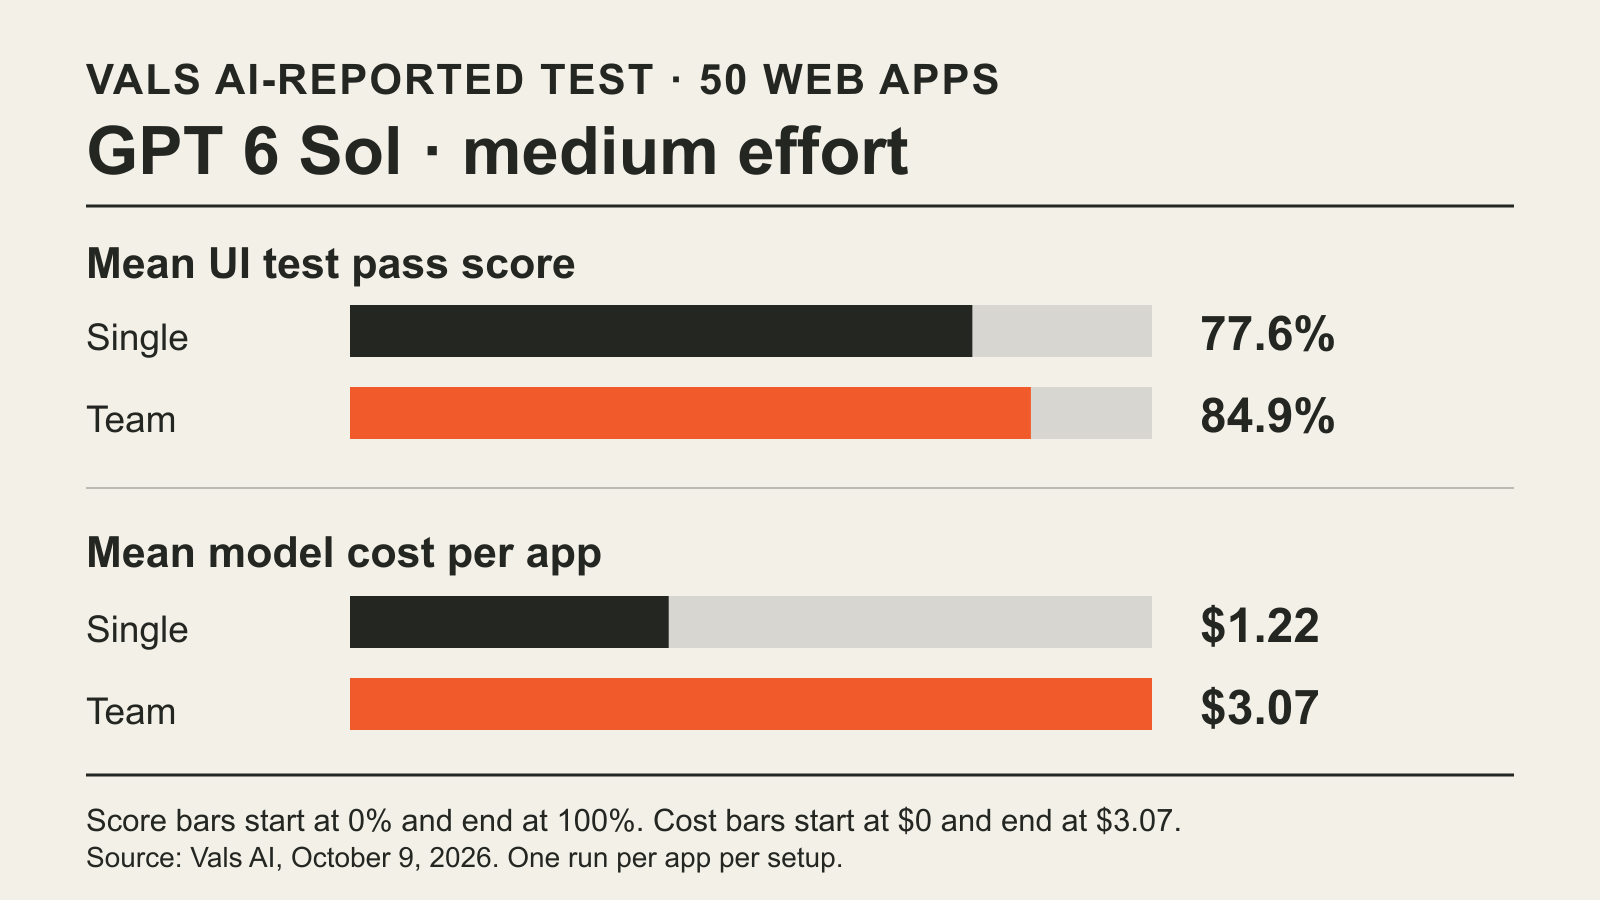
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
Dans l’étude de [Vibe Code Bench de Vals AI, publiée le 9 octobre](https://www.vals.ai/blogs/multi-agent-vibe-code-bench). Une équipe GPT 6 Sol à effort de raisonnement moyen a réussi 84,9 % des tests d’applications du benchmark, contre 77,6 % pour un agent Sol seul. Le gain de 7,3 points de pourcentage a coûté en moyenne 3,07 $ plutôt que 1,22 $ par application. Vals a indiqué un intervalle à 95 % de 2,3 à 12,4 points pour ce gain et une valeur p de 0,005 au test apparié. Aucune des trois autres comparaisons équipe-agent seul n’a montré de différence de score statistiquement significative.
Le résultat pose aux développeurs une question budgétaire plus précise que celle de savoir si les équipes sont « meilleures ». Pour cet ensemble de créations d’applications web, Sol à effort moyen a procuré un gain de qualité mesurable pour environ 1,85 $ de plus par application, avec un temps médian presque identique. À effort élevé, et avec Claude Opus 5.5 quel que soit l’effort, la dépense supplémentaire liée aux équipes n’a pas établi d’amélioration du score dans ce test.
## Le grand changement
- **Ce qui a changé :** Vals a comparé des agents de codage seuls à des équipes sur les mêmes 50 tâches d’applications web, selon deux niveaux de raisonnement. Seul Sol à effort moyen a obtenu un gain de score d’équipe statistiquement significatif.
- **Pourquoi c’est important :** La configuration d’équipe gagnante a coûté 2,5 fois plus par application ; les autres équipes ont coûté de 1,8 à 5,1 fois plus sans gain de score significatif. La conception de l’équipe et les paramètres du modèle font partie d’une même décision d’achat.
- **À surveiller :** Des exécutions répétées et des tests sur d’autres tâches logicielles pourraient montrer si ce gain est fiable au-delà de ces applications précises. Cette étude n’a exécuté chaque configuration qu’une fois.
## Ce que mesuraient les huit exécutions
Vals a demandé à GPT 6 Sol et Claude Opus 5.5 de créer 50 applications web complètes à partir de spécifications produit. Les applications ont été déployées avec Docker Compose et évaluées par des agents de navigateur qui exécutaient des tests d’interface. Le score publié correspond à la part moyenne des tests de chaque application réussis. La [méthode du benchmark](https://www.vals.ai/benchmarks/vibe-code) précise que chaque spécification d’application comporte de 20 à 60 tests automatisés et qu’un test est considéré comme réussi si au moins 90 % de ses étapes aboutissent.
Pour chaque modèle, Vals a comparé un agent seul à un responsable pouvant déléguer simultanément à cinq sous-agents au maximum, à effort de raisonnement moyen et maximal. Les responsables devaient aussi répartir, déléguer, intégrer et vérifier le travail. Pour chaque comparaison de modèle, l’invite de tâche, le bac à sable et l’évaluateur restaient identiques. Chacune des huit configurations a créé une fois chacune des 50 applications.
| Modèle et effort | Score seul | Score de l’équipe | Coût moyen par application : seul → équipe | Durée médiane : seul → équipe |
| --- | --- | --- | --- | --- |
| GPT 6 Sol, moyen | 77,6 % | 84,9 % | 1,22 $ → 3,07 $ | 12,4 → 11,9 min |
| GPT 6 Sol, maximal | 89,0 % | 90,4 % | 4,82 $ → 8,54 $ | 38,4 → 27,6 min |
| Claude Opus 5.5, moyen | 91,5 % | 91,2 % | 4,08 $ → 9,10 $ | 20,3 → 26,6 min |
| Claude Opus 5.5, maximal | 89,8 % | 93,2 % | 23,77 $ → 122 $ | 74,7 → 174,1 min |
Il s’agit des coûts moyens des modèles selon Vals pour la création d’une application, et non de tarifs d’abonnement ou de coûts par test d’interface réussi. Les durées sont des médianes de temps écoulé ; le coût et la durée d’une ligne résument donc différemment les 50 exécutions. La moyenne de l’équipe Opus à effort maximal comprend une exécution ayant dépassé le délai, dont Vals a estimé le coût à environ 189 $ à partir du nombre de jetons.
## Pourquoi le résultat dépend de la configuration
Vals a comparé chaque équipe à l’agent seul correspondant sur les mêmes applications au moyen d’un test t apparié. L’équipe Sol à effort maximal a gagné 1,4 point, avec un intervalle à 95 % de −1,7 à 4,5 points. L’équipe Opus à effort moyen a obtenu un score inférieur de 0,3 point, avec un intervalle de −3,2 à 2,5 ; à effort maximal, elle a gagné 3,4 points, avec un intervalle de −1,4 à 8,3. Ces intervalles incluent l’absence de gain. Ils ne prouvent pas que les équipes n’aident jamais ces configurations, mais cette expérience n’a pas établi de gain.
Pour Sol, l’effort de raisonnement constituait un autre choix testé. Faire passer un agent Sol seul de l’effort moyen à l’effort maximal a fait progresser son score de 77,6 % à 89,0 %, un résultat que Vals qualifie de statistiquement significatif. Cet agent seul à effort maximal a coûté 4,82 $ par application et affiché une durée médiane de 38,4 minutes, contre 3,07 $ et 11,9 minutes pour l’équipe à effort moyen. L’écart de 4,1 points entre ces deux configurations n’était pas statistiquement significatif (p = 0,08). Ces chiffres permettent aux développeurs d’évaluer le compromis mesuré entre coût et durée sans supposer qu’une configuration l’emportera sur un nouveau projet.
Les équipes répartissaient aussi leur temps différemment. Selon Vals, le responsable Sol a délégué tôt et testé lui-même l’application assemblée. Son équipe à effort maximal a terminé en 27,6 minutes de durée médiane, contre 38,4 pour l’agent seul. Les responsables Opus avaient tendance à rédiger un contrat commun et à déléguer par vagues. À effort maximal, l’équipe a pris 174,1 minutes en médiane, contre 74,7 pour l’agent seul, et coûté environ cinq fois plus par application. Vals attribue une grande partie de la facture supplémentaire aux jetons d’entrée mis en cache dans les contextes distincts des sous-agents.
## Jusqu’où pousser cette conclusion
Les intervalles de significativité reflètent les différences entre les 50 applications, et non la variation entre plusieurs tentatives sur une même application. Une autre exécution pourrait modifier la comparaison. Les équipes ont également reçu l’instruction supplémentaire de déléguer ; l’expérience a donc mesuré la combinaison équipe-instruction. Sol utilisait l’API OpenAI Agents et Opus Claude Code ; les comparaisons de score entre modèles mêlent aussi des environnements d’exécution différents. Les estimations de coût de Sol par Vals supposent que l’usage de jetons publié inclut les sous-agents et ne tiennent pas compte d’un éventuel surcoût des requêtes dépassant le seuil de long contexte, car les données d’usage au niveau des requêtes n’étaient pas disponibles.
L’étude étaye une décision circonscrite : pour créer des applications complètes similaires avec ces configurations, une équipe Sol à effort moyen a montré un gain mesurable à un coût supérieur, tandis que les autres équipes n’ont pas affiché de gain de score fiable. Elle ne permet pas de trancher si les équipes sont rentables avec une autre base de code, un autre modèle ou un flux de travail répartissant et vérifiant les tâches différemment. BIG CHANGE a examiné l’article publié par Vals et sa méthode ; il n’a ni réalisé ni reproduit le benchmark.
## Sources
- [Vals AI, Les équipes d’agents sont-elles rentables ? Étude de cas sur Vibe Code Bench](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — Rapport de l’expérience originale. Ses scores, coûts, durées, intervalles et valeurs p des tests appariés, comportements des équipes, détails d’implémentation et réserves étayent l’article. Chacune des huit configurations a été exécutée une fois sur chacune des 50 applications ; l’incertitude rapportée varie entre applications, pas entre tentatives répétées.
- [Vals AI, Méthodologie Vibe Code Bench v1.1](https://www.vals.ai/benchmarks/vibe-code) — Description et méthodologie du benchmark lié : spécifications des applications, 20 à 60 tests d’interface par application et règles de notation. Le classement général utilise d’autres configurations d’environnement et ne remplace pas les résultats de l’étude de cas sur les équipes d’agents.
- [The Decoder, Les équipes d’agents IA gaspillent énormément de jetons pour des gains de qualité à peine mesurables, selon une étude](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — Couverture contemporaine indépendante utilisée pour la découverte et le contexte. Les chiffres et les affirmations méthodologiques de l’article sont vérifiés à partir du rapport original de Vals ; BIG CHANGE ne reprend pas la conclusion plus générale du titre.
La newsletter BIG CHANGE
Prendre du recul, à votre rythme.
Articles récents sur l’IA et la robotique, évolutions à surveiller et idées pratiques à utiliser. Choisissez un briefing quotidien, une synthèse hebdomadaire ou une analyse mensuelle.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Votre vie privée, votre choix.
Le stockage nécessaire contribue à la sécurité du site et mémorise vos choix. Google Analytics facultatif reste désactivé tant que vous ne l’autorisez pas. Vous pouvez lire tous les articles avec le seul stockage nécessaire. Détails sur la confidentialité