AI-translated from English; not yet reviewed by a fluent editor.
# Grok 4.7 उसी टोकन क़ीमत पर लॉन्च हुआ। असली सवाल पूरे हुए काम की लागत है।
> Grok 4.7 के लॉन्च में कोडिंग और ऑफ़िस के काम में सुधार का वादा है। हम Matthew Berman की कवरेज, स्वतंत्र परीक्षण और बदलाव से पहले टीमों को क्या मापना चाहिए—यह देखते हैं।
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
Grok 4.7, 21 सितंबर 2026 को आया। कोड लिखने या कारोबारी जानकारी का विश्लेषण करने के लिए एआई ख़रीद रही टीमों के सामने व्यावहारिक सवाल है: क्या बेहतर मॉडल से पूरा काम सस्ता पड़ता है? जवाब उसकी बताई टोकन दरों से आगे की बातों पर निर्भर है। [आधिकारिक रिलीज़ नोट](https://docs.x.ai/developers/release-notes)
इसी मिले-जुले परिदृश्य पर Matthew Berman का 22 सितंबर का वीडियो है, *Grok 4.7 को लेकर मेरी राय साफ़ नहीं…*। वे तुलना के तरीक़े पर सवाल उठाते हैं और कहते हैं कि टोकन क़ीमत से ज़्यादा पूरे हुए काम की लागत मायने रखती है। वे यह भी कहते हैं कि उन्होंने मॉडल को विस्तार से नहीं परखा है। उनका वीडियो प्रमाणों का शुरुआती आकलन है, व्यापक व्यावहारिक मूल्यांकन नहीं। [Berman का परिचय, 0:00](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
लॉन्च पर ध्यान देना चाहिए, क्योंकि कारोबार कितने काम स्वचालित कर सकता है, इसे बदलने के लिए किसी उपयोगी मॉडल का हर बेंचमार्क जीतना ज़रूरी नहीं। लेकिन कुल लागत को सही ठहराने के लिए उसे पर्याप्त काम सही ढंग से पूरा करना होगा। स्वतंत्र परीक्षण इस तनाव को दिखाते हैं: Grok 4.7 के बेहतर नतीजों के साथ कहीं अधिक आउटपुट भी आ सकता है।
डेवलपरों, छोटे कारोबारों और एजेंट बना रही टीमों के लिए फ़ैसला इसलिए व्यावहारिक है। यह मॉडल कौन-से काम स्वीकार्य गुणवत्ता के साथ पूरा कर सकता है? उसे कितनी मेहनत लगती है? और मॉडल के काम पूरा कहने के बाद इंसान के लिए कितना काम बचता है?
हमने Berman के लगभग 17 मिनट के वीडियो के पूरे कैप्शन देखे और लॉन्च, उत्पाद दस्तावेज़ों तथा Artificial Analysis के मूल्यांकन की जाँच की। नीचे के विश्लेषण में BIG CHANGE का कोई बेंचमार्क या Grok को ख़ुद परखने का दावा नहीं है।
## क्या लॉन्च हुआ और कहाँ उपलब्ध है
मानक मॉडल xAI API पर `grok-4.7`, साथ ही Cursor और Grok Build में भी उपलब्ध है। API पाठ और चित्र स्वीकार कर पाठ बनाती है। दस्तावेज़ों में संदर्भ सीमा 500,000 टोकन और तर्क के चार स्तर—low, medium, high और xhigh—दिए गए हैं। डिफ़ॉल्ट high है। [आधिकारिक रिलीज़ नोट](https://docs.x.ai/developers/release-notes)
SpaceXAI इस सुधार का श्रेय बड़े आधार मॉडल और कठिन कार्यों पर लंबे रीइन्फ़ोर्समेंट लर्निंग प्रशिक्षण को देता है। यह डेवलपर की व्याख्या है। [लॉन्च का तकनीकी परिचय](https://x.ai/news/grok-4-7)
Grok 4.7 Fast भी है। दस्तावेज़ों के अनुसार यह तेज़ इन्फ़्रास्ट्रक्चर पर वही मॉडल है और मानक टोकन दर से दोगुने पर बिल किया जाता है। यह Cursor और Grok Build से मिलता है, Grok Build के मुफ़्त स्तर में नहीं है और सार्वजनिक xAI API से उपलब्ध नहीं। [Grok 4.7 के उत्पाद दस्तावेज़](https://docs.x.ai/developers/grok-4-7)
स्क्रीनशॉट, प्रदर्शन और बिल की तुलना करते समय ये अंतर अहम हैं। मॉडल संस्करण, तर्क का स्तर और सेवा का स्तर अलग चुनाव हैं। xhigh पर Fast का प्रदर्शन, मानक गति और medium स्तर वाली API कॉल के अनुभव या लागत का अनुमान नहीं है।
लॉन्च पेज की दूसरे मॉडलों से तुलना को अपग्रेड तुलना से अलग रखना चाहिए। SpaceXAI के अनुसार मानक Grok 4.7 की क़ीमत और गति Grok 4.6 जैसी है। वह यह नहीं कहता कि 4.6 से अपग्रेड करने पर ग्राहक का बिल अपने-आप आधा हो जाता है।
## क़ीमत-सूची में लंबा संदर्भ रखने की सीमा
मानक API की प्रकाशित दरें हैं:
- 200,000 प्रॉम्प्ट टोकन तक: हर दस लाख टोकन पर इनपुट $2, कैश किया हुआ इनपुट $0.50 और आउटपुट $6।
- 200,000 प्रॉम्प्ट टोकन से ऊपर: हर दस लाख टोकन पर इनपुट $4, कैश किया हुआ इनपुट $1 और आउटपुट $12।
ये टोकन दरें हैं, किसी एजेंट द्वारा काम पूरा करने की कुल क़ीमत नहीं। मॉडल पेज 200,000 टोकन से ज़्यादा के अनुरोधों पर ऊँची क़ीमत बताता है और रिलीज़ नोट ऊँची दरें निर्दिष्ट करते हैं। क़ीमत और उपलब्धता 22 सितंबर को जाँची गई। [मॉडल की क़ीमतें](https://docs.x.ai/developers/models/grok-4.7) तथा [रिलीज़ नोट](https://docs.x.ai/developers/release-notes)
इसलिए 500,000 टोकन की संदर्भ सीमा का मतलब नहीं कि उसके भीतर हर अनुरोध पर सबसे कम दर लगेगी। बड़ी संदर्भ सीमा से यह भी स्थापित नहीं होता कि मॉडल फ़ाइलों के बड़े संग्रह में हर प्रासंगिक जानकारी लगातार ढूँढ़ लेगा।
Cursor एक और उत्पाद-स्तरीय अंतर पेश करता है: उसके दस्तावेज़ में मानक सीमा 256,000 टोकन और अधिकतम 500,000 है। एडिटर में उपलब्ध क्षमता API विनिर्देश से अलग हो सकती है या चुने गए मोड पर निर्भर हो सकती है। [Cursor के Grok 4.7 दस्तावेज़](https://prod.cursor.com/docs/models/grok-4-7)
लंबी रिपोर्ट सँभालने वाली टीम को तुरंत पूछना चाहिए कि क्या सारी सामग्री भेजने से नतीजा इतना बेहतर होता है कि लागत वसूल हो। प्रासंगिक हिस्से निकालना सस्ता और जाँचने में आसान हो सकता है। कभी पूरा दस्तावेज़ ज़रूरी होता है; कभी प्रॉम्प्ट बनाने का बस सबसे आसान तरीका। इन दोनों स्थितियों का बजट एक जैसा नहीं रखना चाहिए।
## बेहतर प्रदर्शन में अधिक टोकन लग सकते हैं
Artificial Analysis के 21 सितंबर के मूल्यांकन में xhigh पर Grok 4.7 को Intelligence Index में 46 अंक मिले—Grok 4.6 से दो ज़्यादा। रिपोर्ट प्रति कार्य लगभग 81,000 आउटपुट टोकन बताती है, जबकि high स्तर पर Grok 4.6 के लिए 36,000 हैं। उसी रिपोर्ट में xhigh पर Grok 4.6 के 38,000 टोकन हैं; यानी समान स्तर की तुलना में भी आउटपुट टोकन दोगुने से अधिक हैं। [Artificial Analysis का लॉन्च मूल्यांकन](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
यही ठोस वजह है कि टोकन की क़ीमत को काम की लागत से अलग रखें। आधार दर $6 प्रति दस लाख पर 81,000 आउटपुट टोकन से उदाहरण के तौर पर $0.486 का आउटपुट शुल्क बनेगा। 38,000 टोकन पर यह $0.228 होगा। इन गणनाओं में जानबूझकर इनपुट, कैश का व्यवहार, टूल शुल्क, ऊँची संदर्भ दर और असफल प्रयास शामिल नहीं हैं। ये रिपोर्ट किए गए टोकन पर आधारित गणित है, पूरे काम की मापी हुई लागत नहीं।
अधिक आउटपुट अपने-आप में बर्बादी नहीं। मॉडल जवाब जाँचने में अतिरिक्त मेहनत करके ऐसी विफलता बचा सकता है जिसमें वरना इंसान को दख़ल देना पड़ता। वह ग़लत रास्ते पर अधिक समय भी लगा सकता है। केवल टोकन संख्या से उत्पादक जमे रहने और महँगी दोहराई का फ़र्क नहीं दिखता।
वीडियो के अंत के पास Berman इसी समस्या पर लौटते हैं और Artificial Analysis की बताई अधिक टोकन खपत पर ध्यान देते हैं। [वीडियो, 15:43](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
काम का नतीजा ऐसा स्वीकार्य सुपुर्दगी योग्य उत्पाद है जो काम आता हो। उपयुक्त परीक्षण और समीक्षा पास करने वाला कोड बदलाव, मिलान करने वाले फ़ॉर्मूले वाली स्प्रेडशीट या सबूत से जुड़े दावों वाली रिपोर्ट—इनका मूल्य सिर्फ़ जल्दी आए जवाब से अलग है।
## बेंचमार्क सक्षम, मगर हर काम में समान नहीं, ऐसा मॉडल दिखाते हैं
लॉन्च तालिका में Grok 4.7 xhigh को CursorBench 4.0 पर 46.3% मिला, जो Fable 5.1 max के 51.8% से कम है। Fable, Terminal-Bench की तुलना में भी आगे है। [विक्रेता की बेंचमार्क तालिका](https://x.ai/news/grok-4-7)
साथ के चार्ट में बेंचमार्क अंक और आउटपुट टोकन दिखाए हैं; दाईं ओर जाने पर अंक घटते हैं। रेखाएँ तर्क के स्तरों की तुलना करती हैं। [मूल संवादात्मक चार्ट: Tokens चुनें](https://x.ai/news/grok-4-7)। [पूरा आकार वाला चार्ट खोलें](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png)।
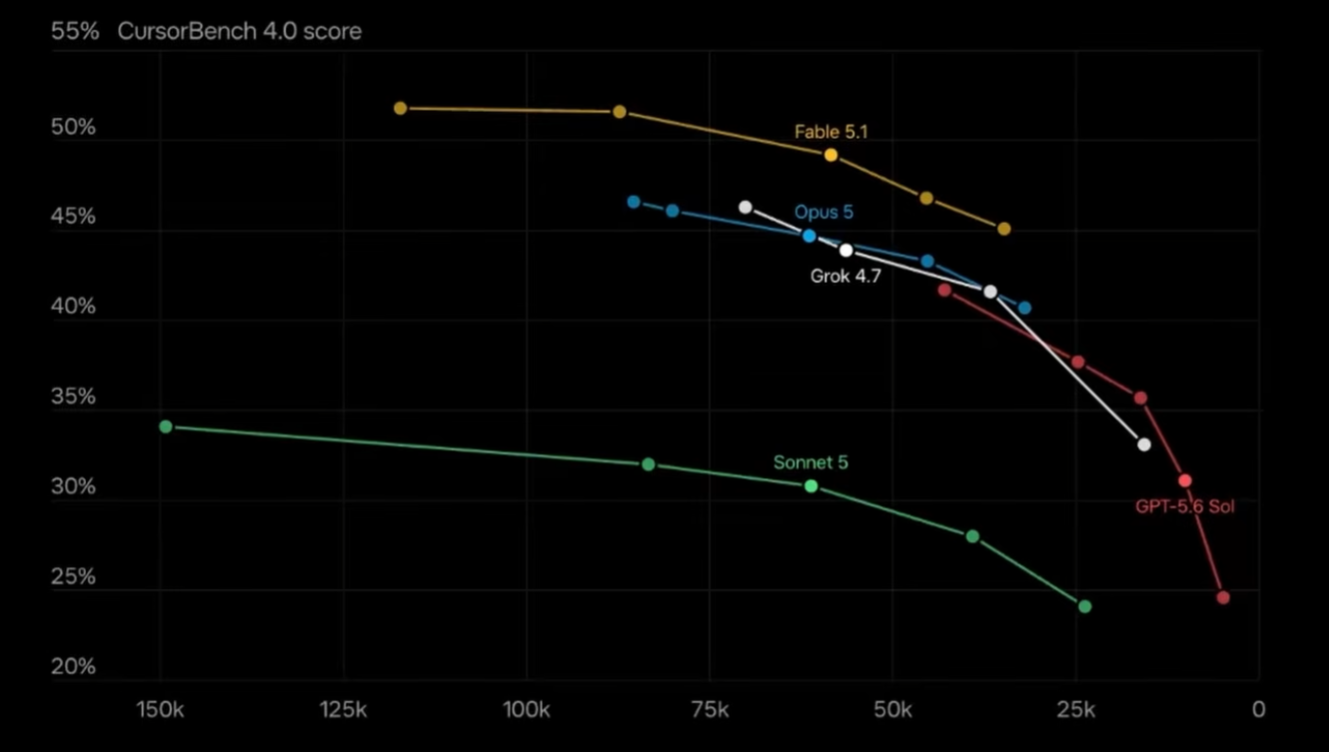
ऊपर जाने का मतलब अधिक अंक और दाईं ओर जाने का मतलब इस मूल्यांकन में कम बने हुए टोकन हैं। इसका अर्थ कम कुल बिल नहीं: टोकन दर, इनपुट इस्तेमाल और आसपास का एजेंट भी मायने रखते हैं। यह Artificial Analysis के ऊपर दिए टोकन आँकड़ों से अलग परीक्षण भी है। दोनों के आँकड़े जोड़ना उन कार्यों और तरीक़ों के अंतर मिटा देगा जिनसे हर नतीजे को समझा जा सकता है।
यह इतना ज़रूर दिखाता है कि Grok 4.7 हर तरह के कोडिंग काम में आगे है, ऐसा व्यापक दावा नहीं किया जा सकता। कुछ ख़ास कामों के लिए उसे ग़ौर से परखने की वजह भी मिलती है। एक मूल्यांकन में सुधार का आकार यह तय नहीं करता कि मॉडल अनजान रिपॉज़िटरी, अधूरी बग रिपोर्ट या असामान्य टूल वातावरण में कैसा काम करेगा।
Artificial Analysis एक उपयोगी स्वतंत्र अंतर बताता है। उसकी रिपोर्ट में Grok Build के साथ Grok 4.7 को Coding Agent Index में 56 अंक मिले, जबकि उसी एजेंट के साथ Grok 4.6 को 47 मिले थे। रिपोर्ट इन मूल एजेंट वाले नतीजों को अपने मानकीकृत Intelligence Index सेटअप से स्पष्ट रूप से अलग रखती है। [स्वतंत्र मूल्यांकन और तरीक़े पर टिप्पणियाँ](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
आसपास का एजेंट मायने रखता है। वही टूल देता है, संदर्भ सँभालता है और तय करता है कि मॉडल के अनुरोध कैसे चलेंगे। यह वातावरण बदलने पर मॉडल का नाम वही रहने के बावजूद नतीजे बदल सकते हैं। एक सेटअप का टर्मिनल स्कोर दूसरे के सॉफ़्टवेयर-इंजीनियरिंग स्कोर के साथ जोड़ने से ऐसी प्रभावशाली तालिका बन सकती है जो किसी वास्तविक परीक्षण-प्रणाली का वर्णन ही न करे।
Berman एक लॉन्च तालिका में GPT-6 Astra न होने की ओर ध्यान दिलाते हैं और उसे जोड़ने के लिए एआई-निर्मित पुनर्निर्माण करते हैं। तुलना की पड़ताल का यह उपयोगी कारण है; पुनर्निर्माण स्वतंत्र बेंचमार्क स्रोत नहीं। मूल मूल्यांकन जाँचे बिना हम उसके जोड़े हुए आँकड़े नहीं अपनाते। [वीडियो, 6:03](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
एक व्यावसायिक संबंध भी ध्यान में रखना चाहिए। Cursor की 14 अगस्त की कंपनी घोषणा कहती है कि उसे SpaceX ने ख़रीद लिया है। उसी कॉरपोरेट समूह में प्रचारित बेंचमार्क उपयोगी प्रमाण हो सकता है, मगर प्रतिस्पर्धी प्रदाता का निष्पक्ष मूल्यांकन नहीं। [Cursor के अधिग्रहण की घोषणा](https://cursor.com/blog/joining-spacex)
## ऑफ़िस का काम शायद अधिक दिलचस्प अवसर हो
स्वतंत्र मूल्यांकन में xhigh पर Grok 4.7 को AA-Briefcase में 1,657 Elo अंक मिले—high पर Grok 4.6 से 111 अधिक। रिपोर्ट अधिकतर सुधार का श्रेय विश्लेषण की गुणवत्ता को देती है; प्रस्तुति की गुणवत्ता पुराने मॉडल के नतीजे से थोड़ी कम है। [Artificial Analysis के ज्ञान-काम नतीजे](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
रिपोर्ट, स्प्रेडशीट या प्रस्तुति बनवाने वालों के लिए यह अंतर उपयोगी है। जवाब में विश्लेषण बेहतर हो सकता है, फिर भी संपादन या नए डिज़ाइन की ज़रूरत हो सकती है। उलट, सजी हुई प्रस्तुति में उथला तर्क छिप सकता है। केवल दिखने वाले अंतिम रूप को परखने से ग़लत सुधार को इनाम मिल सकता है।
संचालन टीम मॉडल को नियमित प्रदर्शन रिपोर्ट पर परख सकती है। उपयोगी परीक्षण में देखना चाहिए कि उसने सही अवधि ली, स्रोत आँकड़ों से हिसाब मिलाया और देखे गए बदलाव को प्रस्तावित व्याख्या से अलग रखा या नहीं। समीक्षा करने वाला व्यक्ति यह भी दर्ज करे कि कितना सुधार करना पड़ा, सिर्फ़ यह नहीं कि पहली नज़र में रिपोर्ट पेशेवर दिखी।
छोटे कारोबार के लिए सबसे कठिन बेंचमार्क जीतने से ज़्यादा यह मायने रख सकता है कि विश्लेषण का ऐसा काम रोज़मर्रा का हो जाए जिसे वह पहले वहन नहीं कर सकता था। व्यापक अपनाव का यह संभव रास्ता है। यह तभी सच होगा जब आउटपुट काफ़ी सटीक हो, समय पर मिले और मालिक का काम हाथ से करने से कम छोड़े।
पेशेवर बेंचमार्क के नाम को पेशेवर योग्यता न समझें। क़ानूनी काम या चिकित्सकीय तर्क के नतीजे उस मूल्यांकन पर प्रदर्शन बताते हैं। वे यह स्थापित नहीं करते कि मॉडल किसी मुवक्किल का क़ानूनी मामला स्वतंत्र रूप से सँभाल सकता है या मरीज़ की देखभाल का निर्णय ले सकता है। यह लेख ऐसे फ़ैसलों के लिए Grok इस्तेमाल करने की सिफ़ारिश नहीं करता।
## सुरक्षा उपायों के दावे भी संदर्भ में परखें
SpaceXAI का कहना है कि Grok 4.7 में नई सुरक्षा परत और जेलब्रेक का बेहतर प्रतिरोध है। यह लॉन्च का दावा है, इस मॉडल का इस्तेमाल करने वाले हर ऐप की सुरक्षा की गारंटी नहीं। [डेवलपर का सुरक्षा विवरण](https://x.ai/news/grok-4-7)
कारोबारी एजेंट के लिए कम-से-कम दो सवाल बाक़ी हैं। क्या मॉडल मिले अनुरोधों का उपयुक्त जवाब देता है? और क्या ऐप असल में मॉडल की कार्रवाई सीमित करता है?
मॉडल ग्राहक रिकॉर्ड बदलने का निर्देश ठीक से समझ सकता है, लेकिन उसके पास ऐसा करने की अनुमति न हो। उसे उस दस्तावेज़ में दुर्भावनापूर्ण निर्देश भी मिल सकते हैं जिसका सार बताने को कहा गया था। पहुँच नियंत्रण और मंज़ूरी के नियम आसपास की प्रणाली का हिस्सा बने रहने चाहिए; मना करने का बेहतर व्यवहार उनकी जगह नहीं लेता।
व्यावहारिक निहितार्थ है कि पूरा कार्यप्रवाह परखें। उसमें ऐसे वैध अनुरोध रखें जिन पर काम होना चाहिए, ऐसे प्रतिबंधित काम जिन्हें रोका जाए और अस्पष्ट मामले जिनमें स्पष्टीकरण माँगकर रुकना चाहिए। हानिरहित काम को बार-बार रोकने वाला उत्पाद बेकार हो सकता है; अनधिकृत कार्रवाई करने वाला कहीं बदतर। एक सुर्ख़ी वाला स्कोर दोनों में से कुछ नहीं पकड़ता।
## वीडियो में कौन-से सवाल अनसुलझे हैं
Berman की कवरेज कई सवाल उठाती है जिन्हें सवाल ही रहना चाहिए। क़ीमत को उपलब्ध कंप्यूट से जोड़ने वाली उनकी व्याख्या बाज़ार का विश्लेषण है, प्रकाशित इकाई-लागत का लेखा नहीं। सोशल मीडिया की जिन भविष्यवाणियों की वे चर्चा करते हैं, वे अपेक्षाएँ हैं, दिए जा चुके प्रदर्शन के सबूत नहीं। अंत में प्रदर्शन की तुलना करते समय वे ख़ुद मानते हैं कि इस्तेमाल की गई सेटिंग नहीं जानते। [क़ीमत पर चर्चा, 8:44](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s), [अपेक्षाएँ, 11:51](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s) और [प्रदर्शन पर चर्चा, 15:20](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
वीडियो में ओपन-वेट मॉडल की भी बात है। इस व्यापक प्रतिस्पर्धी रुझान को Grok 4.7 के लाइसेंस से भ्रमित न करें: Artificial Analysis इस रिलीज़ को मालिकाना बताता है और कहता है कि उसके वेट उपलब्ध नहीं। [Grok 4.7 रिलीज़ प्रोफ़ाइल](https://artificialanalysis.ai/models/releases/grok-4-7)
ये अंतर मूल्यांकन को केंद्रित रखते हैं। सार्वजनिक रूप से यह जाने बिना भी उत्पाद की क़ीमत आकर्षक हो सकती है कि प्रदाता ने वह क़ीमत क्यों तय की। नाकाम प्रदर्शन की चौंकाने वाली मिसाल दोबारा किए जाने लायक परीक्षण सुझा सकती है, लेकिन इससे मॉडल का सामान्य प्रदर्शन ख़राब साबित नहीं होता। कोई उपलब्ध मॉडल उपयोगी हो सकता है, भले ही वह संस्थापक की पुरानी भविष्यवाणी से मेल न खाए।
प्रायोजन की सीमा भी है। Berman के वीडियो में Zapier का विज्ञापन शामिल है। वह Grok के प्रदर्शन का स्वतंत्र प्रमाण नहीं और उसके प्रचार के दावे BIG CHANGE की सिफ़ारिशें नहीं हैं।
## खरीदने का बेहतर माप: हर स्वीकार्य काम की लागत
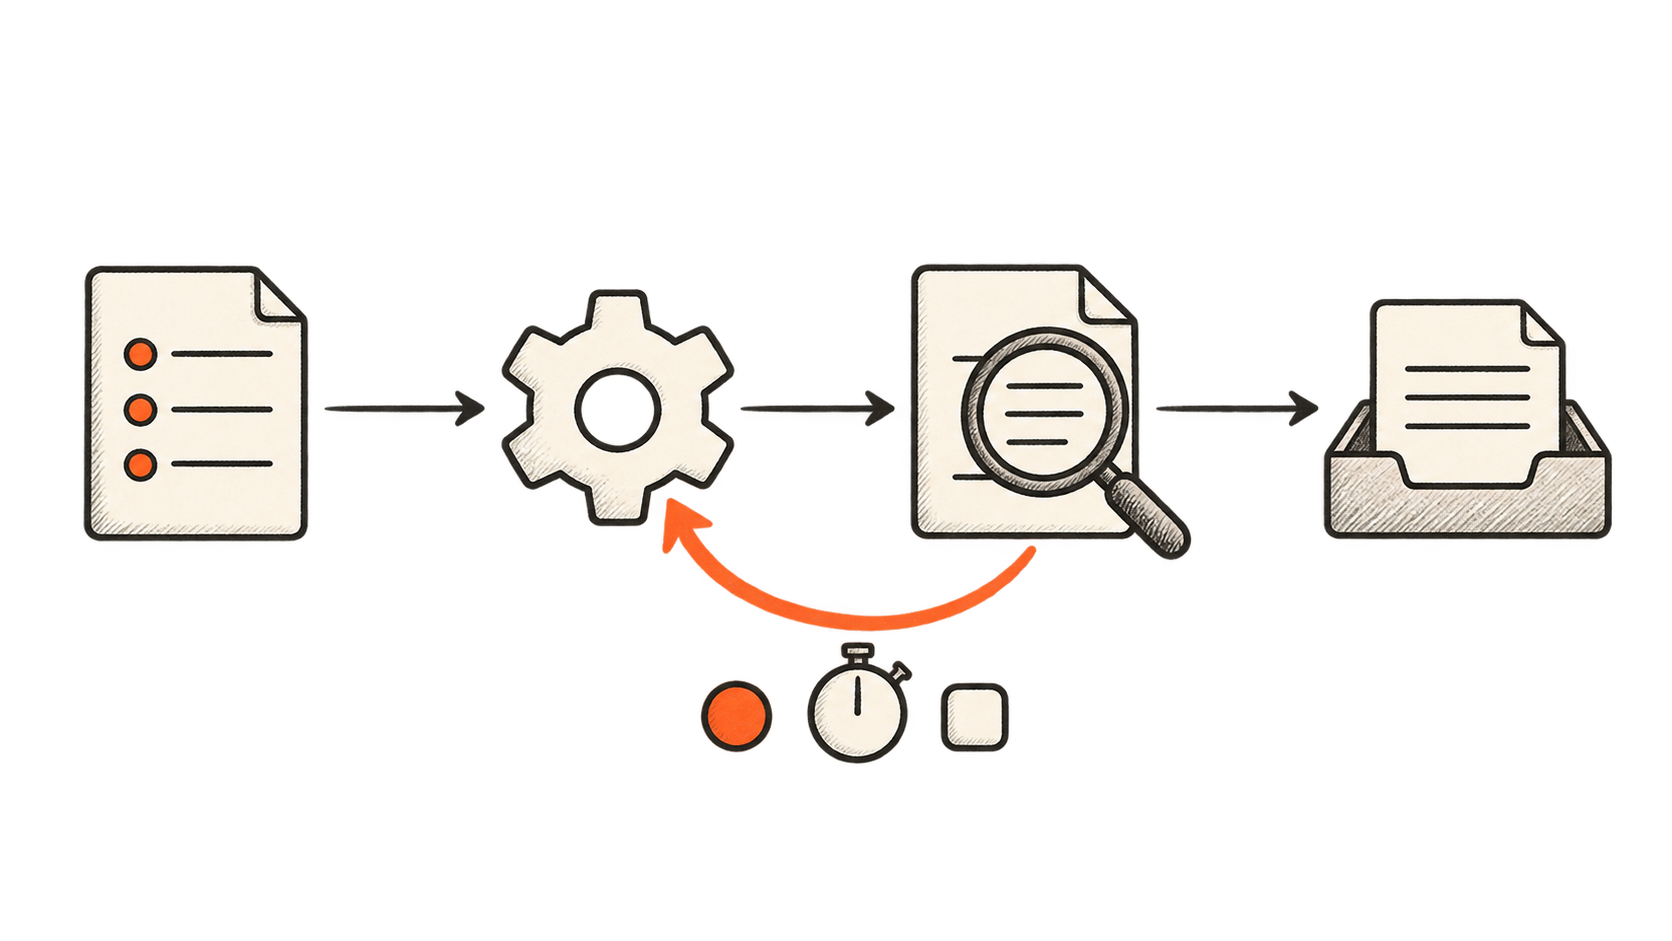
Grok 4.7 पर विचार कर रही टीम को मौजूदा प्रक्रिया के साथ छोटे, प्रतिनिधि कामों के समूह पर इसकी तुलना करनी चाहिए। आउटपुट देखने से पहले ही स्वीकृति की कसौटी तय करें। कोडिंग में उपयुक्त परीक्षण, पढ़ने योग्य पैच और असंबंधित बदलाव न होना शामिल हो सकता है। विश्लेषण के लिए सही गणना और अहम दावों के सबूत चाहिए हो सकते हैं।
फिर पूरा बिल दर्ज करें: इनपुट और आउटपुट का इस्तेमाल, टूल, दोबारा कोशिशें और नतीजा सुधारने या जाँचने में लगा समय। नाकाम प्रयास भी गिनें। इस लागत को स्वीकृति की कसौटी पर खरे उतरने वाले सुपुर्द कार्यों की संख्या से भाग दें।
एक उदाहरण दिखाता है कि यह अंतर क्यों मायने रखता है। मान लें कि एक सेटअप पर कामों के समूह में $20 लगे और 80 नतीजे स्वीकार हुए। इंसानी मेहनत से पहले प्रति स्वीकार्य नतीजे की मापी लागत $0.25 है। दूसरे में $12 लगे लेकिन केवल 30 नतीजे स्वीकार हुए, जिससे प्रति स्वीकार्य नतीजे की लागत $0.40 हुई। सस्ता समूह उपयोगी काम का महँगा स्रोत है। ये काल्पनिक संख्याएँ हैं, Grok के माप नहीं।
तर्क का स्तर भी उस परीक्षण में शामिल होना चाहिए। अधिक तर्क वाली सेटिंग कठिन काम पर लागत वसूल कर सकती है और नियमित काम में कम फ़ायदा दे सकती है। हर अनुरोध xhigh पर चलाने के बजाय सिर्फ़ ज़रूरत वाले मामलों को ऊँचे स्तर पर भेजना सस्ता पड़ सकता है—बशर्ते यह रास्ता चुनने का फ़ैसला भी परखा जाए।
सभी मॉडलों पर समीक्षा के मानक एक जैसे रखें। सस्ते मॉडल के लिए कसौटी घटाने से ख़राब काम स्वीकार कर बचत का भ्रम बनता है। मौजूदा मॉडल के लिए ही कसौटी बढ़ाने से उलटा भ्रम होगा। मक़सद भरोसेमंद नतीजा ख़रीदना है और साफ़ बताना है कि लोगों को अब भी क्या करना पड़ता है।
## देखने लायक बदलाव
Grok 4.7 टीमों को परखने के लिए एक और विकल्प देता है। उसे चुनते समय पूरे काम को देखना होगा: मॉडल क्या बनाता है, कितना खर्च करता है और किसी व्यक्ति को अब भी क्या सुधारना पड़ता है।
व्यापक असर रोज़मर्रा के काम में एआई का अधिक चुनिंदा उपयोग हो सकता है। टीम नियमित विश्लेषण के लिए एक सेटिंग, कठिन कोडिंग के लिए दूसरी और जहाँ निर्णय या जवाबदेही सौंपी नहीं जा सकती वहाँ इंसान चुन सकती है। बढ़ती प्रतिस्पर्धा टीम को एक और विकल्प देती है; यह नहीं तय करती कि कौन-सा विकल्प जीते।
BIG CHANGE के लिए अगला पड़ाव कम कुल मेहनत में मापा जा सकने वाला पूरा काम है। अगर Grok 4.7 स्वीकार्य सुपुर्दगियों की लागत घटाता है, तो उपयोगी स्वचालन अधिक संस्थाओं की पहुँच में आ सकता है। अगर अतिरिक्त तर्क बस टोकन की क़ीमत से ख़र्च को खपत की मात्रा में खिसकाता है, तो सुर्ख़ी की क़ीमत ख़रीदार को बहुत कम बताती है। इस सवाल का जवाब पूरे किए गए कामों से मिलेगा—उनसे भी जो पहले नाकाम हुए।
## Sources
- [Matthew Berman: Grok 4.7 को लेकर मेरी राय साफ़ नहीं…](https://www.youtube.com/watch?v=MJllZbpvrAc) — 22 सितंबर 2026। इस विश्लेषण को प्रेरित करने वाला वीडियो। समय-चिह्नित कड़ियाँ चर्चा के संबंधित हिस्से दिखाती हैं; Berman अपना मूल्यांकन शुरुआती बताते हैं। प्रायोजन वाला हिस्सा मॉडल के प्रमाण से अलग है।
- [Grok 4.7 का परिचय](https://x.ai/news/grok-4-7) — 21 सितंबर 2026। SpaceXAI की घोषणा और संवादात्मक बेंचमार्क चार्ट। विक्रेता के नतीजों में तर्क के स्तर पर ध्यान देना ज़रूरी है; वे हर जगह लागू रैंकिंग नहीं हैं।
- [xAI डेवलपर रिलीज़ नोट](https://docs.x.ai/developers/release-notes) — 21 सितंबर की प्रविष्टि उपलब्धता, संदर्भ सीमा, तर्क की सेटिंग और मानक तथा लंबा संदर्भ—दोनों API दरें बताती है। 22 सितंबर को जाँचा; क़ीमत और उत्पाद तक पहुँच बदल सकती है।
- [Grok 4.7 के उत्पाद दस्तावेज़](https://docs.x.ai/developers/grok-4-7) — मानक मॉडल और Fast सेवा-विकल्प की व्याख्या करते हैं। Fast की उपलब्धता मानक API मॉडल से सीमित है, इसलिए प्रदर्शन और बजट में स्तर का नाम साफ़ होना चाहिए।
- [Grok 4.7 मॉडल की क़ीमत](https://docs.x.ai/developers/models/grok-4.7) — मॉडल की दर-सूची और 200,000 से अधिक प्रॉम्प्ट टोकन पर ऊँची क़ीमत की सीमा। सिर्फ़ टोकन क़ीमतों में दोबारा कोशिशें, टूल और मानवीय समीक्षा शामिल नहीं हैं।
- [Cursor के Grok 4.7 दस्तावेज़](https://prod.cursor.com/docs/models/grok-4-7) — Cursor की मानक संदर्भ सीमा को उसकी अधिकतम सीमा से अलग करते हैं। उत्पाद की सेटिंग मूल API की क्षमता से अलग हो सकती है।
- [Artificial Analysis: Grok 4.7 का बेंचमार्क](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — 21 सितंबर 2026। टोकन इस्तेमाल और ज्ञान-काम की चर्चा के पीछे स्वतंत्र परीक्षण। रिपोर्ट मानकीकृत मूल्यांकन को मूल एजेंट नतीजों से अलग करती है; इन सेटअपों को नहीं मिलाना चाहिए।
- [Artificial Analysis: Grok 4.7 रिलीज़ प्रोफ़ाइल](https://artificialanalysis.ai/models/releases/grok-4-7) — रिलीज़ का मालिकाना लाइसेंस और अनुपलब्ध वेट बताती है। वीडियो में ओपन-वेट प्रतिस्पर्धा की चर्चा से यह मॉडल ओपन-वेट नहीं हो जाता।
- [Cursor अब SpaceX का हिस्सा है](https://cursor.com/blog/joining-spacex) — 14 अगस्त 2026। Cursor की अधिग्रहण घोषणा उसी कॉरपोरेट समूह में प्रचारित बेंचमार्क को परखने का संदर्भ देती है।
BIG CHANGE न्यूज़लेटर
बड़ी तस्वीर। आपकी गति से।
AI और रोबोटिक्स पर ताज़ा लेख, ध्यान देने योग्य बदलाव और उपयोगी विचार। दैनिक ब्रीफ़िंग, साप्ताहिक सारांश या मासिक परिप्रेक्ष्य चुनें।
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
आपकी गोपनीयता, आपकी पसंद।
ज़रूरी स्टोरेज साइट की सुरक्षा में मदद करता है और आपकी पसंद याद रखता है। आपकी अनुमति मिलने तक वैकल्पिक Google Analytics बंद रहता है। आप हर लेख केवल आवश्यक स्टोरेज के साथ पढ़ सकते हैं। गोपनीयता का विवरण