AI-translated from English; not yet reviewed by a fluent editor.
# NVIDIA ने आठ-वक्ता वाले ऑडियो के लिए Nemotron 3 Diarization जारी किया
> NVIDIA का 23 सितंबर का ओपन-वेट डायरीज़ेशन मॉडल रिकॉर्ड किए गए या स्ट्रीमिंग ऑडियो में आठ तक वक्ताओं को लेबल करता है। उसकी सबसे छोटी सुझाई गई सेटिंग 0.32 सेकंड के बफ़र किए ऑडियो पर आधारित है; सटीकता के आँकड़े NVIDIA के अपने परीक्षणों से हैं।
By BIG CHANGE Editorial
Published: 2026-09-27T15:28:31.966Z
Updated: 2026-09-27T15:28:31.966Z
Canonical: https://bigchange.ai/blog/nvidia-nemotron-3-speaker-diarization-model
AI-generated conceptual illustration by BIG CHANGE.
NVIDIA ने [Nemotron 3 Diarization](https://huggingface.co/nvidia/Nemotron-3-Diarization) 23 सितंबर को जारी किया। लगभग 100 मिलियन पैरामीटर वाला यह ओपन-वेट मॉडल रिकॉर्ड किए गए या स्ट्रीमिंग ऑडियो में आठ तक वक्ताओं की बातचीत के दौरान उनके बोलने का समय बताता है। इससे डेवलपर को बातचीत के लिए वक्ता गतिविधि और टाइमस्टैम्प मिलते हैं; शब्दों वाला ट्रांसक्रिप्ट बनाने के लिए अलग वाक्-पहचान भी चाहिए।
## बड़ा बदलाव
- **क्या बदला:** NVIDIA का पिछला स्ट्रीमिंग Sortformer चेकपॉइंट चार वक्ताओं को संभालता था। इस रिलीज़ में एक ही चेकपॉइंट से आने के क्रम में आठ वक्ता-चैनल मिलते हैं, जो रिकॉर्डेड ऑडियो और आने वाले खंडों—दोनों पर काम करता है।
- **यह क्यों मायने रखता है:** बैठक या कॉल के प्रतिलेखन की व्यवस्था बना रहा डेवलपर समय-अंतरालों को सामान्य वक्ता लेबल दे सकता है, जिसमें एक-दूसरे पर चढ़कर बोला गया अंश भी शामिल है, और फिर इन अंतरालों को अलग speech recognizer के शब्दों से जोड़ सकता है। यह रिलीज़ उस काम के लिए दस्तावेज़ित वक्ता सीमा बढ़ाती है।
- **क्या देखना है:** व्यावहारिक चुनाव यह है कि हर स्ट्रीमिंग नतीजा देने से पहले कितना ऑडियो बफ़र किया जाए। NVIDIA की सबसे छोटी सुझाई गई सेटिंग में गणना शुरू होने से पहले 0.32 सेकंड का ऑडियो बफ़र होता है; उसके अपने सटीकता आँकड़े इस सेटिंग के साथ सटीकता पर पड़ने वाला असर दिखाते हैं। टीमों को पूरी प्रक्रिया अपने रिकॉर्ड किए गए ऑडियो पर मापनी चाहिए।
## मॉडल क्या लौटाता है
इस [मॉडल कार्ड](https://huggingface.co/nvidia/Nemotron-3-Diarization) में 16 kHz, एकल-चैनल ऑडियो की शर्त है। इसमें WAV, FLAC, Opus और MP3 फ़ाइलें सूचीबद्ध हैं; NeMo इंटरफ़ेस फ़ाइल पथ, ऑडियो ऐरे या पंक्ति-दर-पंक्ति JSON manifest स्वीकार करता है। ऑडियो ऐरे के साथ सही सैंपल दर भी `diarize()` फ़ंक्शन को देनी होती है। कार्ड में खंडों में अनुमान के लिए रिकॉर्डिंग की कोई तय अधिकतम अवधि नहीं बताई गई है।
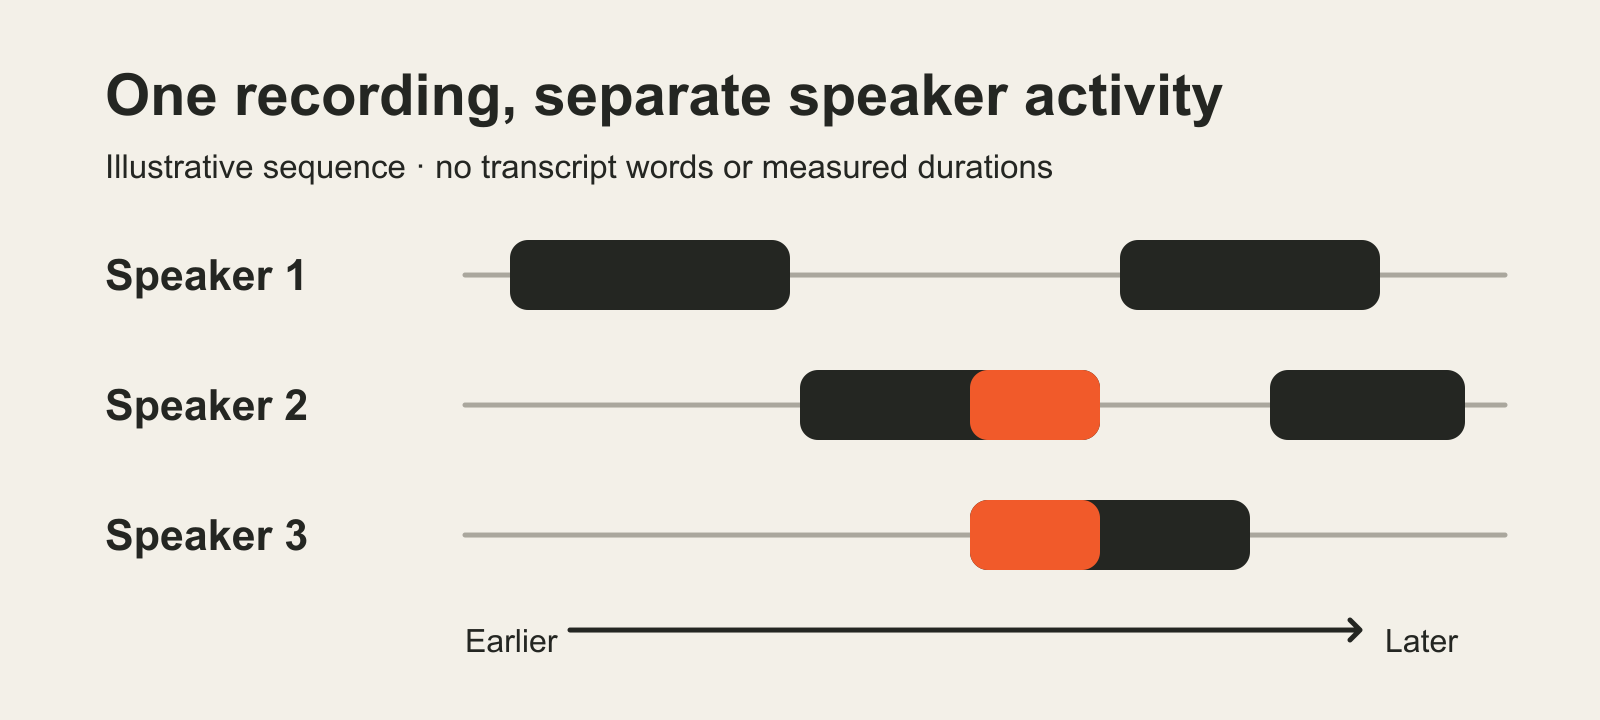
मॉडल ऑडियो को वक्ता गतिविधि की संभावनाओं वाले `[T, 8]` टेंसर में बदलता है; डिफ़ॉल्ट आउटपुट चरण 10 मिलीसेकंड है। लोग एक साथ बोलें तो कई चैनल सक्रिय रह सकते हैं। बाद की प्रक्रिया इन संभावनाओं को आरंभ और समाप्ति समय तथा सामान्य वक्ता लेबल वाले अंतरालों में बदलती है। लेबल आवाज़ों के पहली बार आने के क्रम में होते हैं; वे लोगों की पहचान नाम से नहीं करते। स्ट्रीमिंग मॉडल संदर्भ बनाए रखने के लिए पुराने खंडों का वक्ता-कैश और हालिया फ़्रेमों की first-in, first-out कतार इस्तेमाल करता है।
वक्ता-चिह्नित ट्रांसक्रिप्ट चाहने वाले डेवलपर के लिए यह अंतर महत्वपूर्ण है। [NVIDIA की एकीकरण मार्गदर्शिका](https://huggingface.co/blog/nvidia/nemotron-diarization) डायरीज़ेशन टाइमस्टैम्प को अलग स्वचालित वाक्-पहचान नतीजे से जोड़ती है। उसका उदाहरण वाला midpoint नियम, जिस शब्द के समय कोई वक्ता सक्रिय न हो उसे किसी वक्ता से नहीं जोड़ता, और एक साथ कई आवाज़ें सक्रिय हों तो नतीजे को अस्पष्ट मानता है। केवल डायरीज़ेशन मॉडल यह तय नहीं करता कि पहचाना गया शब्द किस साथ-साथ बोलती आवाज़ का था।
## बफ़र समय, जवाब देने का समय नहीं
NVIDIA 30.4, 1.04, 0.64 और 0.32 सेकंड के सुझाए इनपुट-बफ़र विकल्प देता है। 0.32 सेकंड की सेटिंग में तीन 80-मिलीसेकंड प्रोसेसिंग फ़्रेम और 80 मिलीसेकंड का दायाँ संदर्भ-फ़्रेम होता है। [कार्ड में latency की स्पष्ट परिभाषा](https://huggingface.co/nvidia/Nemotron-3-Diarization) है: अनुमान लगाने से पहले रोके गए ऑडियो की अवधि; इसमें गणना का समय शामिल नहीं। ट्रांसक्रिप्शन प्रणाली में वाक्-पहचान, डेटा-आवागमन और ऐप्लिकेशन का समय भी जुड़ता है।
दस्तावेज़ित NeMo तरीके के लिए Python 3.12 या बाद का संस्करण, Cython, हाल का PyTorch और NeMo Speech चाहिए। NVIDIA इसमें `SortformerEncLabelModel.from_pretrained()` का उदाहरण और `diarize()` कॉल भी देता है, जो वक्ता-खंड लौटाती है; साथ ही संभावना टेंसर शामिल करने का स्विच भी। कार्ड के अनुसार NeMo कॉल के ज़रिये होस्टेड चेकपॉइंट लोड करने के लिए Hugging Face टोकन चाहिए। इसमें Transformers का ऑफलाइन और स्ट्रीमिंग इंटरफ़ेस भी है, जिसे Transformers स्रोत रिपॉज़िटरी से इंस्टॉल किया जाता है, साथ में [NeMo-Speech.cpp कमांड-लाइन तरीका](https://github.com/NVIDIA/NeMo-Speech.cpp/blob/main/docs/cli.md)। ये दस्तावेज़ित इंटरफ़ेस हैं; BIG CHANGE ने इन्हें चलाकर नहीं देखा। NeMo एकीकरण के लिए मॉडल कार्ड Linux तथा NVIDIA Ampere, Hopper और Blackwell GPU परिवार सूचीबद्ध करता है। किसी खास कार्यभार के लिए हार्डवेयर और गणना लागत चुने रास्ते और मशीन पर निर्भर है; कार्ड प्रति घंटे की परिचालन कीमत नहीं देता।
वज़न [OpenMDW 1.1](https://openmdw.ai/license/1-1/) लाइसेंस के तहत दिए गए हैं। इसकी शर्तों के अनुसार लाइसेंस शुल्क के बिना उपयोग, संशोधन और वितरण की अनुमति है। वितरण में लाइसेंस और लागू मूल-स्रोत सूचनाएँ रखनी होंगी। लाइसेंस आउटपुट के उपयोग या साझा करने को सीमित नहीं करता और ऑडियो के लिए आवश्यक अधिकार व सहमतियाँ हासिल करने की ज़िम्मेदारी उपयोगकर्ता पर रखता है। NVIDIA मॉडल को व्यावसायिक और गैर-व्यावसायिक उपयोग के लिए उपलब्ध बताता है।
## NVIDIA ने क्या मापा
NVIDIA का [मॉडल-कार्ड मूल्यांकन](https://huggingface.co/nvidia/Nemotron-3-Diarization) Nemotron 3 की तुलना उसके पहले के चार-वक्ता स्ट्रीमिंग Sortformer v2.1 से करता है। पूरे DIHARD III मूल्यांकन सेट पर NVIDIA, Nemotron 3 के 1.04 सेकंड इनपुट-बफ़र के लिए 13.18% डायरीज़ेशन त्रुटि दर बताता है, जबकि पहले मॉडल के लिए उसी बताए बफ़र पर 19.60% है। 0.32 सेकंड पर Nemotron 3 का नतीजा 13.55% है। डायरीज़ेशन त्रुटि दर छूटी हुई वाणी, ग़लत पहचान और वक्ता-भ्रम को जोड़कर संदर्भ वक्ता-समय से भाग देती है। कम दर बेहतर है।
ये आँकड़े परिभाषित प्रोटोकॉल के हैं। NVIDIA कहता है कि उसके सभी मूल्यांकन एक-दूसरे पर चढ़ती वाणी को गिनते हैं। DIHARD III में सीमा-कॉलर शून्य सेकंड है, जबकि CALLHOME-Part2 में 0.25 सेकंड। AMI, AliMeeting और NOTSOFAR1 के लिए NVIDIA मूल खंड-लेबल के बजाय जुड़ी हुई, समय-संरेखित संदर्भ टिप्पणियाँ इस्तेमाल करता है; लेबल बदलने से नतीजे बदलते हैं। [मूल्यांकन निर्देश](https://huggingface.co/nvidia/Nemotron-3-Diarization/blob/main/diarization_evaluation.md) NeMo स्क्रिप्ट की पहचान करते हैं और तुलनीय परीक्षण के लिए संदर्भ RTTM फ़ाइल, overlap सेटिंग, collar, स्ट्रीमिंग सेटिंग तथा postprocessing के विवरण माँगते हैं। NVIDIA के inference-speed परिणाम RTX PRO 5000 पर BF16 में मापे गए, `torch.compile()` के साथ और उसके बिना। ये विक्रेता द्वारा बताए गए परीक्षण हैं, BIG CHANGE द्वारा दोहराए गए परिणाम नहीं।
आठ वक्ताओं की सीमा अब भी मायने रखती है। DIHARD III की कुछ रिकॉर्डिंगों में नौ तक वक्ता दर्ज हैं; कार्ड कहता है कि आठ चैनलों से अधिक वाणी छूट सकती है या दूसरे चैनल को दी जा सकती है। AMI की परीक्षण रिकॉर्डिंगों पर NVIDIA अपने पुराने आधार-मॉडल से कम डायरीज़ेशन त्रुटि बताता है, लेकिन वक्ताओं की सही संख्या पहचानने की सटीकता कम है। इसलिए नतीजे कार्य, माप और ऑडियो पर निर्भर करते हैं। मॉडल को शामिल करने पर विचार कर रही टीम NVIDIA के प्रकाशित इंटरफ़ेस से शुरुआत कर सकती है और अपने इच्छित उपयोग जैसी रिकॉर्डिंगों पर वक्ता और शब्दों की पूरी प्रक्रिया जाँच सकती है।
## Sources
- [NVIDIA: Nemotron 3 Diarization मॉडल कार्ड](https://huggingface.co/nvidia/Nemotron-3-Diarization) — इसमें रिलीज़ की तारीख़, लगभग 100M पैरामीटर आकार, इनपुट, आउटपुट, स्ट्रीमिंग कॉन्फ़िगरेशन और NVIDIA के मूल्यांकन तालिकाओं का मुख्य विवरण है। सटीकता और गति के माप विक्रेता द्वारा बताए गए हैं; 0.32 सेकंड का सेटिंग इनपुट-बफ़र समय बताता है और गणना को शामिल नहीं करता।
- [NVIDIA: “कौन कब बोला” रिलीज़ लेख](https://huggingface.co/blog/nvidia/nemotron-diarization) — तारीख़ वाला रिलीज़ लेख आने के क्रम में वक्ता चैनलों की व्याख्या करता है और दिखाता है कि सामान्य वक्ता-अंतराल को अलग ASR आउटपुट के साथ कैसे जोड़ा जा सकता है। उसका midpoint matching उदाहरण overlap को अस्पष्ट चिह्नित करता है; यह सरल अनुमान है, प्रमाणित ट्रांसक्रिप्ट नतीजा नहीं।
- [NVIDIA: डायरीज़ेशन मूल्यांकन उप-कार्ड](https://huggingface.co/nvidia/Nemotron-3-Diarization/blob/main/diarization_evaluation.md) — NeMo मूल्यांकन स्क्रिप्ट, संदर्भ RTTM की शर्त, overlap और collar की परिभाषाएँ, तथा तुलनीय डायरीज़ेशन त्रुटि दर बताने के लिए आवश्यक फ़ील्ड सूचीबद्ध करता है। यह प्रोटोकॉल दस्तावेज़ है, स्वतंत्र पुनरुत्पादन नहीं।
- [OpenMDW लाइसेंस समझौता, संस्करण 1.1](https://openmdw.ai/license/1-1/) — उपयोग और दायित्व बताता है: शर्तों के अधीन मॉडल सामग्री का निःशुल्क उपयोग और पुनर्वितरण, वितरण में लाइसेंस व मूल-स्रोत सूचनाएँ बनाए रखना, तैयार आउटपुट पर कोई रोक नहीं, और आवश्यक अधिकार व सहमतियों की ज़िम्मेदारी उपयोगकर्ता की।
- [NVIDIA NeMo-Speech.cpp कमांड-लाइन मार्गदर्शिका](https://github.com/NVIDIA/NeMo-Speech.cpp/blob/main/docs/cli.md) — स्थानीय CLI डायरीज़ेशन और पुराने V2 के चार-वक्ता बनाम V3 की आठ-वक्ता सीमा का दस्तावेज़ देती है। CLI समर्थन यह साबित नहीं करता कि इस न्यूज़रूम ने मॉडल चलाया या कार्ड की NeMo बेंचमार्क गति स्थापित करता है।
BIG CHANGE न्यूज़लेटर
बड़ी तस्वीर। आपकी गति से।
AI और रोबोटिक्स पर ताज़ा लेख, ध्यान देने योग्य बदलाव और उपयोगी विचार। दैनिक ब्रीफ़िंग, साप्ताहिक सारांश या मासिक परिप्रेक्ष्य चुनें।
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
आपकी गोपनीयता, आपकी पसंद।
ज़रूरी स्टोरेज साइट की सुरक्षा में मदद करता है और आपकी पसंद याद रखता है। आपकी अनुमति मिलने तक वैकल्पिक Google Analytics बंद रहता है। आप हर लेख केवल आवश्यक स्टोरेज के साथ पढ़ सकते हैं। गोपनीयता का विवरण