AI-translated from English; not yet reviewed by a fluent editor.
# Vals AI के कोडिंग परीक्षण में एजेंटों की एक टीम को 7.3 अंक का लाभ मिला, लेकिन लागत 2.5 गुना थी
> 50 ऐप बनाने के परीक्षण में Vals AI को केवल GPT 6 Sol के मध्यम प्रयास वाले सेटअप में टीम का सांख्यिकीय रूप से महत्वपूर्ण लाभ मिला; इसकी लागत प्रति ऐप $3.07 थी, जबकि अकेले एजेंट की लागत $1.22 थी।
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
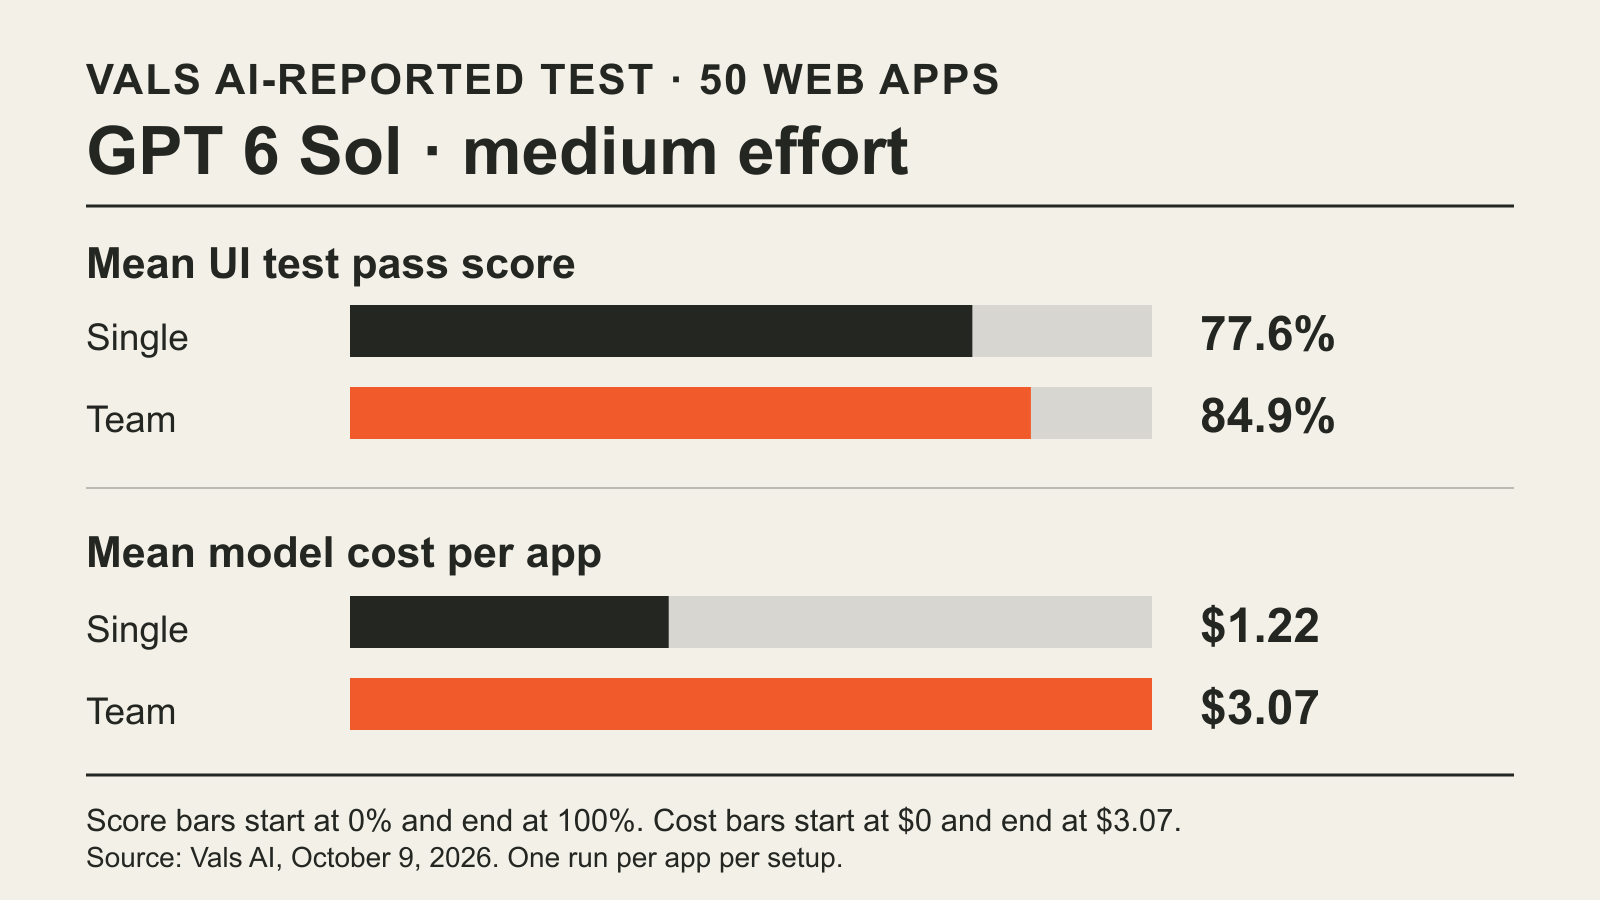
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
Vals AI के 9 अक्टूबर के अध्ययन में चार युग्मित तुलनाओं में से एक में कोडिंग एजेंट को साथी देने से मदद मिली [Vals AI का 9 अक्टूबर का Vibe Code Bench अध्ययन](https://www.vals.ai/blogs/multi-agent-vibe-code-bench)। मध्यम तर्क-प्रयास वाली GPT 6 Sol टीम ने बेंचमार्क के 84.9% ऐप परीक्षण पास किए, जबकि अकेले Sol एजेंट ने 77.6% पास किए। 7.3 प्रतिशत-अंक के इस लाभ की औसत लागत प्रति ऐप $1.22 के बजाय $3.07 थी। Vals ने इस लाभ के लिए 95% अंतराल 2.3 से 12.4 अंक और युग्मित परीक्षण का p-value 0.005 बताया। टीम और अकेले एजेंट की बाकी तीन तुलनाओं में स्कोर का कोई सांख्यिकीय रूप से महत्वपूर्ण अंतर नहीं था।
यह नतीजा डेवलपरों को यह पूछने से बेहतर बजट-संबंधी सवाल देता है कि टीमें “बेहतर” हैं या नहीं। इन वेब-ऐप निर्माणों में मध्यम प्रयास वाले Sol ने प्रति ऐप करीब $1.85 अधिक खर्च पर गुणवत्ता में मापने योग्य लाभ दिया, जबकि समय का मध्यक लगभग समान रहा। अधिक प्रयास पर, और Claude Opus 5.5 के दोनों प्रयास-स्तरों पर, टीम पर अतिरिक्त खर्च से इस परीक्षण में स्कोर सुधरना साबित नहीं हुआ।
## बड़ा बदलाव
- **क्या बदला:** Vals ने तर्क के दो स्तरों पर उन्हीं 50 वेब-ऐप कार्यों में अकेले कोडिंग एजेंटों और टीमों की तुलना की। मध्यम प्रयास वाले Sol को ही टीम के स्कोर में सांख्यिकीय रूप से महत्वपूर्ण लाभ मिला।
- **यह क्यों मायने रखता है:** विजेता टीम सेटअप की प्रति ऐप लागत 2.5 गुना थी; अन्य टीमों की लागत 1.8 से 5.1 गुना तक थी, पर स्कोर में कोई महत्वपूर्ण लाभ नहीं मिला। टीम का डिज़ाइन और मॉडल की सेटिंग एक ही खरीद-निर्णय का हिस्सा हैं।
- **क्या देखना है:** बार-बार चलाए गए परीक्षण और दूसरे सॉफ्टवेयर कार्यों पर जांच बता सकती है कि इन खास ऐप से आगे भी यह लाभ भरोसेमंद है या नहीं। इस अध्ययन में हर सेटअप केवल एक बार चलाया गया।
## आठ रन ने क्या मापा
Vals ने GPT 6 Sol और Claude Opus 5.5 से उत्पाद विनिर्देशों के आधार पर 50 पूरे वेब ऐप बनाने को कहा। ऐप Docker Compose से तैनात किए गए और ब्राउज़र एजेंटों ने यूज़र-इंटरफ़ेस परीक्षण करके उन्हें स्कोर दिया। रिपोर्ट किया गया स्कोर हर ऐप के पास हुए परीक्षणों का औसत अनुपात है। [बेंचमार्क की विधि ](https://www.vals.ai/benchmarks/vibe-code)कहती है कि हर ऐप विनिर्देश में 20 से 60 स्वचालित परीक्षण हैं और कोई परीक्षण तभी पास होता है जब उसके कम-से-कम 90% चरण सफल हों।
हर मॉडल के लिए Vals ने अकेले एजेंट की तुलना ऐसे लीड एजेंट से की जो मध्यम और अधिकतम तर्क-प्रयास—दोनों पर एक साथ अधिकतम पांच सबएजेंट को काम सौंप सकता था। लीड एजेंटों को काम बांटने, सौंपने, एकीकृत करने और जांचने का अतिरिक्त निर्देश भी मिला। हर मॉडल तुलना में कार्य का प्रॉम्प्ट, सैंडबॉक्स और मूल्यांकनकर्ता समान रहे। आठों विन्यासों ने 50 में से हर ऐप एक बार बनाया।
| मॉडल और प्रयास | अकेले एजेंट का स्कोर | टीम का स्कोर | प्रति ऐप औसत लागत: अकेले → टीम | समय का मध्यक: अकेले → टीम |
| --- | --- | --- | --- | --- |
| GPT 6 Sol, मध्यम | 77.6% | 84.9% | $1.22 → $3.07 | 12.4 → 11.9 मिनट |
| GPT 6 Sol, अधिकतम | 89.0% | 90.4% | $4.82 → $8.54 | 38.4 → 27.6 मिनट |
| Claude Opus 5.5, मध्यम | 91.5% | 91.2% | $4.08 → $9.10 | 20.3 → 26.6 मिनट |
| Claude Opus 5.5, अधिकतम | 89.8% | 93.2% | $23.77 → $122 | 74.7 → 174.1 मिनट |
ये Vals के अनुसार एक ऐप बनाने में मॉडल की औसत लागत हैं, न कि सदस्यता शुल्क या प्रति सफल UI परीक्षण की लागत। समय दीवार-घड़ी के समय का मध्यक है, इसलिए हर पंक्ति की लागत और समय 50 रन के अलग-अलग सार हैं। अधिकतम प्रयास वाली Opus टीम के औसत में एक समय-सीमा पार करने वाला रन शामिल है; Vals ने टोकन की संख्या से उसकी लागत करीब $189 आंकी।
## नतीजा सेटअप पर निर्भर क्यों है
Vals ने युग्मित t-परीक्षण से हर टीम की तुलना उन्हीं ऐप पर उसके अनुरूप अकेले एजेंट से की। अधिकतम प्रयास वाली Sol टीम को 1.4 अंक का लाभ मिला, जिसका 95% अंतराल −1.7 से 4.5 अंक था। मध्यम प्रयास वाली Opus टीम का स्कोर 0.3 अंक कम था, अंतराल −3.2 से 2.5; अधिकतम प्रयास वाली टीम को 3.4 अंक का लाभ मिला, अंतराल −1.4 से 8.3। इन अंतरालों में शून्य लाभ शामिल है। इससे यह साबित नहीं होता कि उन सेटअप में टीमें कभी मदद नहीं करतीं, लेकिन इस प्रयोग ने लाभ स्थापित नहीं किया।
Sol के लिए तर्क-प्रयास भी एक और परखी गई पसंद थी। अकेले Sol एजेंट को मध्यम से अधिकतम प्रयास पर ले जाने से उसका स्कोर 77.6% से बढ़कर 89.0% हुआ, जिसे Vals ने सांख्यिकीय रूप से महत्वपूर्ण बताया। अधिकतम प्रयास वाले उस अकेले एजेंट की लागत प्रति ऐप $4.82 और समय का मध्यक 38.4 मिनट था; मध्यम प्रयास वाली टीम के लिए ये $3.07 और 11.9 मिनट थे। इन दो सेटअप के बीच 4.1 अंक का स्कोर-अंतर सांख्यिकीय रूप से महत्वपूर्ण नहीं था (p = 0.08)। ये आंकड़े डेवलपर को मापे गए कीमत-समय समझौते को देखने देते हैं, बिना यह माने कि नया प्रोजेक्ट किसी एक सेटअप को जिताएगा।
टीमों ने अपना समय भी अलग-अलग बांटा। Vals के अनुसार Sol लीड ने जल्दी काम सौंपा और तैयार ऐप का परीक्षण खुद किया। अधिकतम प्रयास वाली उसकी टीम ने 27.6 मिनट के मध्यक में काम पूरा किया, जबकि अकेले एजेंट को 38.4 मिनट लगे। Opus लीड साझा अनुबंध लिखकर चरणों में काम सौंपते थे। अधिकतम प्रयास पर टीम को 174.1 मिनट का मध्यक लगा, जबकि अकेले एजेंट को 74.7 मिनट; प्रति ऐप लागत करीब पांच गुना थी। Vals अतिरिक्त बिल का बड़ा हिस्सा सबएजेंटों के अलग-अलग संदर्भों में कैश किए गए इनपुट टोकन को मानता है।
## इस निष्कर्ष को कितनी दूर तक लागू करें
सांख्यिकीय महत्व के अंतराल 50 ऐप के बीच के अंतर दिखाते हैं, एक ही ऐप पर बार-बार कोशिशों के बीच का उतार-चढ़ाव नहीं। दूसरा रन तुलना बदल सकता है। टीम रन को काम सौंपने का अतिरिक्त निर्देश भी मिला, इसलिए प्रयोग ने टीम और निर्देश के संयुक्त सेटअप को मापा। Sol ने OpenAI Agents API और Opus ने Claude Code का उपयोग किया; मॉडल के स्कोर की तुलना में अलग-अलग harness भी शामिल हैं। Sol की लागत के Vals अनुमान मानते हैं कि बताए गए टोकन उपयोग में सबएजेंट शामिल हैं और लंबा-संदर्भ सीमा पार करने वाले अनुरोधों की संभावित ऊंची कीमत शामिल नहीं करते, क्योंकि अनुरोध-स्तर का उपयोग डेटा उपलब्ध नहीं था।
यह अध्ययन सीमित निर्णय का समर्थन करता है: इन विन्यासों से मिलते-जुलते फुल-स्टैक ऐप बनाते समय मध्यम प्रयास वाली Sol टीम ने अधिक लागत पर मापने योग्य लाभ दिखाया, जबकि दूसरी टीमों ने भरोसेमंद स्कोर लाभ नहीं दिखाया। इससे यह तय नहीं होता कि दूसरी कोडबेस, मॉडल या काम बांटने और जांचने के अलग तरीके वाले वर्कफ़्लो में टीमें लाभकारी होंगी या नहीं। BIG CHANGE ने Vals की प्रकाशित पोस्ट और विधि की समीक्षा की; उसने बेंचमार्क चलाया या दोहराया नहीं।
## Sources
- [Vals AI, क्या एजेंट टीमों पर खर्च करना उचित है? Vibe Code Bench का केस अध्ययन](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — मूल प्रयोग की रिपोर्ट। इसके स्कोर, लागत, समय, युग्मित परीक्षणों के अंतराल और p-value, टीमों का व्यवहार, कार्यान्वयन विवरण और सावधानियां लेख को आधार देते हैं। आठों सेटअप में से हर एक को 50 ऐप में प्रत्येक पर एक बार चलाया गया; रिपोर्ट की गई अनिश्चितता ऐप के बीच बदलती है, दोहराए प्रयासों के बीच नहीं।
- [Vals AI, Vibe Code Bench v1.1 की कार्यविधि](https://www.vals.ai/benchmarks/vibe-code) — लिंक किए गए बेंचमार्क का विवरण और विधि: ऐप विनिर्देश, प्रति ऐप 20–60 UI परीक्षण और स्कोरिंग नियम। इसकी सामान्य लीडरबोर्ड में दूसरे harness विन्यास हैं और वह एजेंट-टीम केस अध्ययन के नतीजों का स्थानापन्न नहीं है।
- [The Decoder, अध्ययन के अनुसार AI एजेंट टीमें लगभग न के बराबर गुणवत्ता लाभ के लिए बहुत सारे टोकन खर्च करती हैं](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — खोज और संदर्भ के लिए उपयोग की गई स्वतंत्र समकालीन रिपोर्टिंग। लेख के संख्यात्मक और विधि-संबंधी दावों को Vals की मूल रिपोर्ट से जांचा गया है; BIG CHANGE शीर्षक के व्यापक निष्कर्ष को नहीं अपनाता।
BIG CHANGE न्यूज़लेटर
बड़ी तस्वीर। आपकी गति से।
AI और रोबोटिक्स पर ताज़ा लेख, ध्यान देने योग्य बदलाव और उपयोगी विचार। दैनिक ब्रीफ़िंग, साप्ताहिक सारांश या मासिक परिप्रेक्ष्य चुनें।
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
आपकी गोपनीयता, आपकी पसंद।
ज़रूरी स्टोरेज साइट की सुरक्षा में मदद करता है और आपकी पसंद याद रखता है। आपकी अनुमति मिलने तक वैकल्पिक Google Analytics बंद रहता है। आप हर लेख केवल आवश्यक स्टोरेज के साथ पढ़ सकते हैं। गोपनीयता का विवरण