AI-translated from English; not yet reviewed by a fluent editor.
# Claude sudah pulih. Bisnis Anda tetap memerlukan rencana pemulihan
> Insiden Claude pada 22 September telah ditangani. Panduan praktis ini menjelaskan cara bagi bisnis untuk mempertahankan layanan terbatas, menyimpan pekerjaan yang belum selesai, dan memulihkan backlog mereka sendiri setelah gangguan AI.
By BIG CHANGE Editorial
Published: 2026-09-22T08:51:37.833Z
Updated: 2026-09-22T08:51:37.833Z
Canonical: https://bigchange.ai/blog/claude-outage-ai-business-continuity
AI-generated conceptual illustration by BIG CHANGE. When an AI service pauses, a business still needs accessible records of unfinished work. The bookmarked ledger represents preserving the stopping place. Conceptual illustration, not evidence of damaged equipment or lost data.
Pada 22 September, Claude mengalami peningkatan kesalahan di beberapa model. Pembaruan insiden terakhir dari Anthropic menetapkan rentang dampak pada pukul 00.50 hingga 02.10 UTC, atau 80 menit. Insiden ditandai selesai pada pukul 02.35 UTC. Komponen yang terdampak mencakup claude.ai, API, Code, dan Cowork. Catatan tersebut tidak menyatakan bahwa setiap permintaan gagal dan tidak memuat penjelasan akar masalah yang dipublikasikan. [Catatan insiden Anthropic](https://status.claude.com/incidents/7g1qpkyz5gxh)
Bagi bisnis yang menggunakan AI dalam proses kerja, pulihnya layanan baru menjawab sebagian masalah. Permintaan pelanggan mungkin masih menunggu. Seseorang mungkin mulai menangani kasus secara manual sementara upaya otomatis masih berjalan. Supervisor perlu mengetahui pekerjaan mana yang dapat dilanjutkan dan mana yang harus diperiksa lebih dahulu.
Asisten yang sesekali tidak tersedia memang merepotkan saat digunakan untuk bertukar pikiran. Namun, ketika layanan yang sama membantu mengelompokkan kasus masuk, menyusun balasan, dan memperbarui catatan, gangguan berubah menjadi masalah operasional. Persiapan yang berguna adalah rencana kelangsungan sederhana yang dapat diikuti staf tanpa mengakses layanan AI itu sendiri.
Panduan ini memakai meja layanan pelanggan hipotetis untuk menunjukkan bagaimana rencana tersebut dapat dijalankan. Prosedur yang diusulkan perlu disesuaikan dan dilatih; BIG CHANGE tidak mengujinya dan prosedur ini bukan gambaran tentang pelanggan yang terdampak insiden tersebut.
## Pilih layanan yang dapat dipertahankan tanpa AI
Bayangkan pemasok peralatan kecil yang asistennya mengelompokkan pesan dukungan masuk dan menyiapkan balasan berdasarkan informasi produk yang disetujui. Staf meninjau balasan sebelum mengirimkannya. Bisnis itu mengandalkan sistem untuk mengatur antrean, meski manusialah yang tetap bertanggung jawab atas jawabannya.
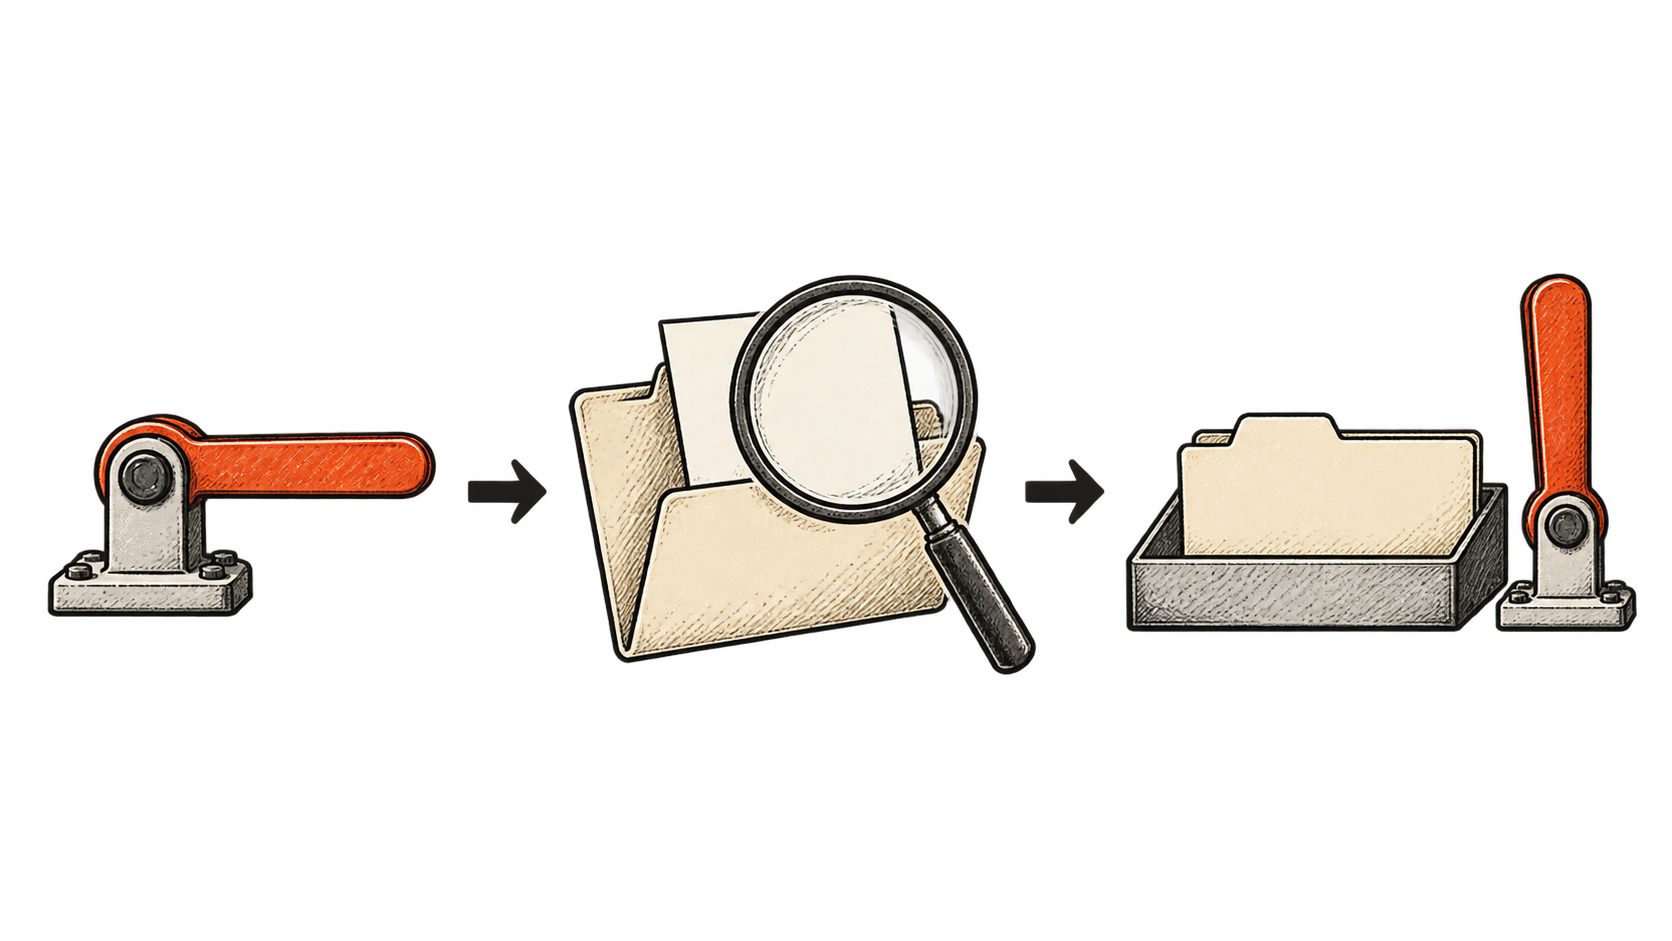
Jika asisten berhenti merespons, keputusan pertama manajer adalah menentukan apa yang masih dapat dijanjikan oleh meja layanan. Staf mungkin terus mengonfirmasi penerimaan permintaan dan menangani kasus dengan tenggat mendesak, sambil menunda penjelasan produk rutin. Mereka perlu mengakses pesan asli dan bahan referensi yang disetujui tanpa bergantung pada asisten. Jika tidak, instruksi “beralih ke cara manual” tidak disertai sarana untuk melaksanakannya.
Tentukan layanan terbatas itu sebelumnya. Sebutkan orang yang dapat mengaktifkannya, pekerjaan yang perlu dihentikan sementara, dan staf yang akan menangani tugas-tugas tersisa. Tetapkan waktu peninjauan agar pengaturan sementara tidak berjalan hingga sore tanpa dievaluasi ulang. Pemberitahuan kepada pelanggan sebaiknya menjelaskan keterlambatan dan jalur bantuan mendesak yang tersedia, dengan janji yang dapat dipenuhi tim.
Panduan rekayasa Google tentang beban berlebih menjelaskan cara menyediakan fungsi yang dikurangi, membatasi lalu lintas, dan memprioritaskan permintaan penting ketika sumber daya terbatas. Itu merupakan teknik keandalan yang sudah mapan, bukan diagnosis atas insiden Claude ini. Jika diterapkan pada meja layanan, prinsip-prinsip tersebut mendukung pengurangan cakupan secara terencana ketika pemrosesan normal tidak dapat diteruskan. [Google SRE: menangani beban berlebih](https://sre.google/sre-book/handling-overload/)
Layanan terbatas itu juga memerlukan batas kapasitas. Dua orang tidak dapat begitu saja mewarisi beban kerja sistem otomatis yang biasanya melayani jauh lebih banyak permintaan. Catat berapa banyak yang dapat mereka tangani, apa yang harus menunggu, dan kapan bantuan tambahan diperlukan. Pelanggan lebih terbantu oleh perkiraan waktu tanggapan yang realistis daripada konfirmasi otomatis yang memberi kesan layanan berjalan normal.
## Simpan catatan pekerjaan di luar percakapan
Meja layanan memerlukan catatan kasus yang dapat dibaca saat model tidak tersedia. Catatan itu bisa berada di sistem dukungan yang sudah digunakan. Hal terpenting ialah bisnis dapat memastikan apa yang terjadi tanpa meminta asisten yang sedang terganggu untuk merekonstruksinya.
Untuk setiap kasus, simpan permintaan asli, orang atau proses yang bertanggung jawab, dan tindakan terakhir yang telah dikonfirmasi. Draf tersimpan berbeda dari balasan yang telah dikirim. Usulan perubahan pada catatan pelanggan berbeda dari perubahan yang telah dikonfirmasi oleh sistem tersebut. Simpan bukti yang diperlukan untuk membedakan keduanya, dengan pembatasan akses yang sama seperti untuk informasi pelanggan terkait.
Saat terjadi gangguan, pisahkan pekerjaan ke dalam kategori praktis berikut:
- Siap dimulai: pemrosesan atau tindakan eksternal belum dimulai.
- Baru disiapkan sebagian: klasifikasi atau draf sudah ada, tetapi langkah berikutnya belum selesai.
- Dipastikan selesai: sistem tujuan mencatat tindakan yang dimaksud.
- Belum pasti: tindakan sudah dicoba, tetapi konfirmasi belum ada.
Berikan kasus yang belum pasti kepada seseorang yang dapat memeriksa sistem terkait sebelum pekerjaan dilanjutkan. Jika asisten sedang menyusun balasan ketika koneksi terputus, membuat draf baru mungkin tidak berbahaya. Namun, jika alat terpisah sedang mengirim balasan itu, mengulangi seluruh tugas dapat mengirimkannya dua kali. Perbedaan ini harus dicatat dalam alur kerja.
Dokumentasi API Anthropic menyatakan bahwa respons streaming dapat gagal setelah respons HTTP 200 awal berhasil diterima. Munculnya teks pertama atau diterimanya status awal itu tidak membuktikan bahwa seluruh jawaban telah sampai. Integrasi perlu mengenali penyelesaian dan menyimpan pekerjaan parsial sebagai pekerjaan parsial. [Dokumentasi kesalahan API Claude](https://platform.claude.com/docs/en/api/errors)
## Batasi percobaan ulang dan tetapkan penanggung jawab
Percobaan ulang dapat mengatasi kegagalan sementara. Namun, percobaan itu juga dapat memperpanjang ketidakpastian jika setiap lapisan mengulangi pekerjaan yang sama secara terpisah. Tanyakan kepada pemasok perangkat lunak apakah percobaan ulang sudah terjadi di dalam pustaka kliennya sebelum menambahkan tombol coba lagi atau putaran otomatis lain.
Anthropic mendokumentasikan dua percobaan ulang otomatis sebagai setelan bawaan untuk kegagalan sementara di SDK resminya, menggunakan jeda yang makin panjang dan mengikuti instruksi retry-after bila tersedia. Dokumentasi kesalahannya juga membedakan masalah server sementara dari kegagalan autentikasi, izin, dan permintaan yang formatnya keliru. Mengulangi permintaan yang sama belum tentu memperbaiki semua kategori tersebut. [Perilaku percobaan ulang Claude yang didokumentasikan](https://platform.claude.com/docs/en/api/errors)
Untuk meja layanan, aturan operasional perlu menentukan kapan percobaan otomatis berhenti dan siapa yang menerima kasus setelahnya. Simpan pengenal permintaan untuk pemecahan masalah. Pastikan staf dapat melihat apakah pekerjaan sedang menunggu, dicoba ulang, atau menunggu penanganan seseorang, agar mereka tidak tanpa sengaja memulai upaya yang saling bersaing.
AWS menjelaskan bahwa suatu tindakan dapat berhasil meski responsnya tidak pernah diterima. API idempoten mereka menggunakan pengenal permintaan khusus untuk mengenali permintaan berulang dan mencegah efek samping tambahan. Layanan penerima harus menerapkan kontrak tersebut; mencantumkan nomor kasus internal saja tidak memberi perlindungan seperti itu. [AWS tentang membuat percobaan ulang aman](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/)
Tanyakan secara spesifik tentang tindakan yang dilakukan alur kerja Anda. Dapatkah percobaan ulang membuat tiket dukungan lain atau mengirim email tambahan? Jika pencegahan duplikasi tidak tersedia, rencana tersebut perlu mewajibkan pemeriksaan catatan di sistem tujuan sebelum upaya berikutnya. Mengulangi pembuatan teks dan mengulang seluruh proses bisnis memerlukan keputusan yang berbeda.
## Model cadangan memerlukan uraian tugas yang lebih terbatas
Layanan AI alternatif dapat membantu pekerjaan terus berjalan, tetapi memiliki akun kedua baru merupakan langkah awal untuk menyiapkan cadangan. Penggantinya memerlukan instruksi yang tepat, bahan referensi yang disetujui, serta izin untuk menangani data tersebut. Layanan itu juga harus memiliki kapasitas ketika dibutuhkan bisnis.
Pilih tugas cadangan yang terbatas sebelum mencoba mengganti seluruh sistem. Dalam contoh hipotetis meja layanan tadi, model lain mungkin mengelompokkan pesan rutin sementara staf menangani balasan kepada pelanggan. Tim dapat mengujinya dengan kasus yang mewakili kondisi nyata, termasuk nama produk yang ambigu dan permintaan yang harus ditangani seseorang. Jawaban yang fasih saja tidak membuktikan bahwa model mengikuti aturan dukungan perusahaan.
Sebelum terjadi insiden, tentukan informasi mana yang boleh dikirim ke layanan alternatif. Staf tidak boleh berimprovisasi dengan menempelkan catatan pelanggan ke akun pribadi. Periksa ketentuan penanganan data dan pengaturan akses layanan pengganti sebagai bagian dari pengadaan, selain menilai mutu keluarannya dan harganya.
Nama model yang berbeda juga tidak membuktikan bahwa ketersediaannya independen. Cadangan mungkin masih bergantung pada login, koneksi jaringan, penyimpanan dokumen, atau perangkat lunak orkestrasi yang sama. Petakan dependensi yang benar-benar dapat dihindari oleh alternatif yang diusulkan. Langkah ini mungkin menunjukkan bahwa antrean manual dengan dokumen referensi yang bisa diakses memberi perlindungan lebih berguna daripada model lain di balik koneksi yang sama-sama gagal.
Alternatif memerlukan pemeliharaan seiring perubahan instruksi dan usangnya pengetahuan produk. Staf perlu berlatih menggunakan prosedur yang jarang mereka pakai. Bisnis kecil dapat secara wajar mempertahankan layanan manual yang lebih lambat alih-alih membayar untuk menduplikasi seluruh operasi. Pilihan itu sebaiknya mempertimbangkan biaya pekerjaan yang tertunda dan dampak jawaban yang keliru.
## Lanjutkan kembali dengan antrean yang telah ditinjau
Setelah penyedia melaporkan pemulihan, uji sampel kecil dari alur kerja Anda sendiri sebelum membuka kembali pemrosesan normal. Sertakan kasus yang menguji pencarian dokumen dan pembaruan catatan yang dibutuhkan bisnis. Respons model yang berhasil tidak membuktikan bahwa setiap sistem terhubung telah siap.
Kemudian periksa pekerjaan yang menunggu. Singkirkan kasus yang sudah ditangani secara manual, periksa tindakan yang belum pasti, dan identifikasi permintaan yang keadaannya telah berubah. Pelanggan mungkin memberikan informasi baru selama gangguan. Membuat balasan dari versi kasus yang lebih lama dapat menimbulkan masalah baru setelah gangguan teknis berakhir.
Lepaskan sisa pekerjaan dalam kelompok-kelompok yang terkendali. Sisakan kapasitas untuk permintaan mendesak yang baru dan pantau apakah antrean menyusut. Jika permintaan masuk menyerap semua kapasitas pemrosesan yang tersedia, backlog akan tetap ada meski setiap upaya baru berhasil. Mengejar ketertinggalan mungkin memerlukan staf tambahan, layanan yang dikurangi sementara, atau perpanjangan waktu tanggapan yang disampaikan dengan jujur.
Sebagai contoh hitungan terpisah, misalkan 24 kasus masuk per jam dan pemrosesan berhenti selama 30 menit. Sebanyak 12 kasus akan menunggu. Jika meja layanan kemudian menangani 36 kasus per jam sementara 24 kasus baru terus masuk, diperlukan satu jam untuk mengosongkan backlog. Ini asumsi ilustratif, bukan pengukuran insiden Claude.
Panduan Google tentang sasaran tingkat layanan dimulai dari hasil yang penting bagi pengguna dan dependensi yang diperlukan untuk mewujudkannya. Bagi meja layanan ini, ukuran yang berguna dapat berupa proporsi kasus mendesak yang menerima tanggapan tepat dalam rentang waktu yang dijanjikan. Ketersediaan penyedia memang relevan, tetapi bisnis juga perlu mengetahui apakah pelanggan menerima layanan tersebut. [Google SRE: menerapkan sasaran tingkat layanan](https://sre.google/workbook/implementing-slos/)
Catat waktu ketika layanan pelanggan normal kembali, jumlah kasus yang belum terselesaikan, dan koreksi apa pun yang diperlukan setelahnya. Ukuran tersebut mengungkap pekerjaan pemulihan yang tidak dapat dilihat halaman status penyedia.
## Latih satu skenario gangguan sebelum memperluas otomatisasi
Latihan meja singkat dapat mengungkap akses atau tanggung jawab yang belum jelas tanpa mengganggu pelanggan sesungguhnya. Gunakan beberapa kasus dukungan rekaan dan ikuti urutan ini:
1. Anggap model tidak tersedia saat sedang menyiapkan balasan. Tanyakan siapa yang mengaktifkan layanan terbatas dan di mana staf dapat menemukan permintaan aslinya.
2. Buat satu kasus dengan balasan yang dipastikan telah dikirim dan satu lagi dengan upaya pengiriman yang belum pasti. Periksa apakah tim mengetahui sistem mana yang dapat memastikan hasilnya.
3. Anggap penyedia telah pulih sementara kasus baru terus masuk. Tentukan pekerjaan mana yang dilanjutkan lebih dahulu dan bagaimana kasus yang sudah selesai secara manual dikeluarkan dari backlog.
4. Minta orang yang bukan penulis rencana menjelaskan prosedurnya dan menunjukkan izin atau catatan apa yang tidak mereka miliki.
Catat pertanyaan yang tidak dapat dijawab oleh latihan tersebut. Perbaikannya mungkin sederhana: akses ke antrean yang sudah ada, kontrol jeda yang jelas, konfirmasi tersimpan, atau penanggung jawab pemulihan yang ditetapkan. Tidak satu pun menjamin layanan tanpa gangguan. Namun, masing-masing dapat membantu membatasi dampak gangguan tanpa meniadakan manfaat otomatisasi.
Sebelum memberi asisten tanggung jawab operasional lain, minta seorang kolega menunjukkan bagaimana tanggung jawab itu akan ditangani selama gangguan. Jika jawabannya bergantung pada asisten yang tidak tersedia untuk mengingat apa yang sedang dikerjakannya, rencana kelangsungan itu masih perlu diperbaiki.
## Sources
- [Claude Status: Peningkatan kesalahan pada beberapa model](https://status.claude.com/incidents/7g1qpkyz5gxh) — Catatan insiden penyedia memberikan rentang dampak 80 menit dan waktu penyelesaian yang lebih akhir. JSON publik telah dibaca secara independen. Catatan itu melaporkan peningkatan kesalahan, bukan kegagalan universal, dan tidak memuat penjelasan akar masalah yang dipublikasikan.
- [Claude Platform: Kesalahan API](https://platform.claude.com/docs/en/api/errors) — Dokumentasi terkini mencakup kesalahan, percobaan ulang SDK secara default, serta kegagalan setelah streaming dimulai. Mekanisme ini tidak membuktikan bahwa tugas bisnis selesai atau mencegah tindakan ganda pada alat yang terhubung.
- [AWS Builders’ Library: Membuat percobaan ulang aman dengan API idempoten](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/) — Penjelasan Malcolm Featonby tentang respons yang tidak pasti dan pencegahan duplikasi. Kontrak API harus diterapkan oleh layanan penerima; pengenal saja tidak cukup.
- [Google SRE: Menangani beban berlebih](https://sre.google/sre-book/handling-overload/) — Panduan rekayasa yang mapan tentang fungsi terbatas, prioritas, dan percobaan ulang dengan batas. Artikel ini mengadaptasi prinsip tersebut untuk meja layanan hipotetis; prinsip itu tidak mendiagnosis penyebab insiden Anthropic.
- [Google SRE Workbook: Menerapkan SLO](https://sre.google/workbook/implementing-slos/) — Menjelaskan sasaran keandalan berdasarkan hasil bagi pengguna dan dependensi penting. Ukuran layanan pelanggan dan contoh backlog yang diusulkan merupakan penerapan ilustratif, bukan hasil pengamatan atau target universal.
Buletin BIG CHANGE
Gambaran besar. Sesuai tempo Anda.
Kisah terbaru tentang AI dan robotika, perubahan yang patut diikuti, serta gagasan praktis yang dapat diterapkan. Pilih rangkuman harian, mingguan, atau perspektif bulanan.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Privasi Anda, pilihan Anda.
Penyimpanan yang diperlukan membantu menjaga keamanan situs dan mengingat pilihan Anda. Google Analytics opsional tetap nonaktif sampai Anda mengizinkannya. Anda dapat membaca semua artikel hanya dengan penyimpanan yang diperlukan. Detail privasi