AI-translated from English; not yet reviewed by a fluent editor.
# Dalam uji coding Vals AI, satu tim agen naik 7,3 poin dengan biaya 2,5 kali lipat
> Dari 50 pembuatan aplikasi, Vals AI menemukan kenaikan tim yang signifikan secara statistik hanya pada GPT 6 Sol dengan tingkat upaya penalaran sedang; konfigurasi itu berbiaya $3,07 per aplikasi dibanding $1,22.
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
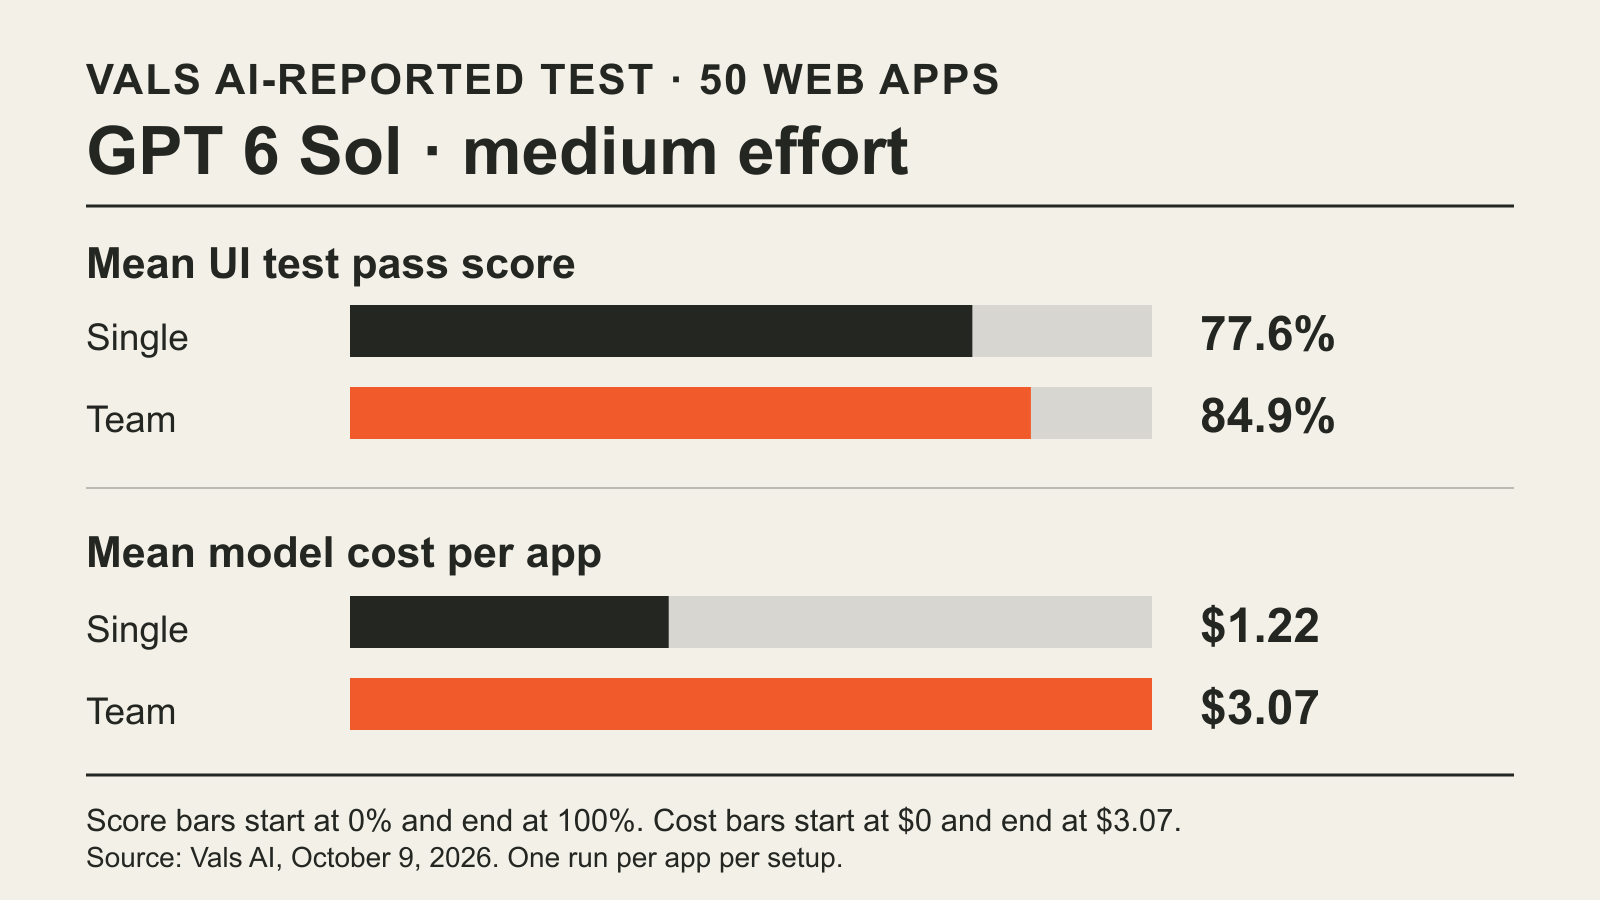
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
Dalam studi Vals AI pada 9 Oktober, tim membantu agen coding pada satu dari empat perbandingan berpasangan [Studi Vibe Code Bench oleh Vals AI, 9 Oktober](https://www.vals.ai/blogs/multi-agent-vibe-code-bench). Tim GPT 6 Sol dengan upaya penalaran sedang melewati 84,9% pengujian aplikasi benchmark, dibanding 77,6% untuk agen Sol tunggal. Kenaikan 7,3 poin persentase itu rata-rata berbiaya $3,07, bukan $1,22 per aplikasi. Vals melaporkan interval 95% sebesar 2,3 hingga 12,4 poin untuk kenaikan tersebut dan nilai p uji berpasangan 0,005. Tak satu pun dari tiga perbandingan tim dengan agen tunggal lainnya menunjukkan perbedaan skor yang signifikan secara statistik.
Hasil ini memberi pengembang pertanyaan anggaran yang lebih tepat daripada sekadar bertanya apakah tim “lebih baik”. Dalam rangkaian pembuatan aplikasi web ini, Sol dengan upaya sedang memberi kenaikan kualitas terukur dengan tambahan sekitar $1,85 per aplikasi dan median waktu yang hampir sama. Pada upaya lebih tinggi, serta dengan Claude Opus 5.5 pada kedua tingkat upaya, biaya tambahan untuk tim tidak menunjukkan peningkatan skor dalam uji ini.
## Perubahan besar
- **Apa yang berubah:** Vals membandingkan agen coding tunggal dengan tim pada 50 tugas aplikasi web yang sama, dengan dua tingkat penalaran. Hanya Sol dengan upaya sedang yang memperoleh kenaikan skor tim yang signifikan secara statistik.
- **Mengapa penting:** Konfigurasi tim yang unggul berbiaya 2,5 kali lebih tinggi per aplikasi; tim lain berbiaya 1,8 hingga 5,1 kali lebih tinggi tanpa kenaikan skor signifikan. Desain tim dan pengaturan model merupakan bagian dari keputusan pembelian yang sama.
- **Apa yang perlu dipantau:** Pengulangan uji dan pengujian pada tugas perangkat lunak lain dapat menunjukkan apakah kenaikan bertahan di luar aplikasi khusus ini. Dalam studi ini, setiap konfigurasi dijalankan satu kali.
## Apa yang diukur oleh delapan rangkaian uji
Vals meminta GPT 6 Sol dan Claude Opus 5.5 membuat 50 aplikasi web lengkap dari spesifikasi produk. Aplikasi diimplementasikan dengan Docker Compose dan dinilai oleh agen browser yang menjalankan pengujian antarmuka. Skor yang dilaporkan adalah proporsi rata-rata pengujian tiap aplikasi yang lulus. [metode benchmark ](https://www.vals.ai/benchmarks/vibe-code) menyebutkan bahwa setiap spesifikasi aplikasi mencakup 20 hingga 60 pengujian otomatis, dan satu pengujian dianggap lulus bila setidaknya 90% langkahnya berhasil.
Untuk tiap model, Vals membandingkan agen tunggal dengan agen pemimpin yang dapat mendelegasikan pekerjaan secara bersamaan kepada hingga lima subagen, pada upaya penalaran sedang dan maksimum. Pemimpin juga menerima instruksi tambahan untuk membagi, mendelegasikan, mengintegrasikan, dan memverifikasi pekerjaan. Prompt tugas, sandbox, dan penilai tetap sama dalam tiap perbandingan model. Masing-masing dari delapan konfigurasi membuat setiap 50 aplikasi satu kali.
| Model dan upaya | Skor agen tunggal | Skor tim | Biaya rata-rata per aplikasi: tunggal → tim | Waktu median: tunggal → tim |
| --- | --- | --- | --- | --- |
| GPT 6 Sol, sedang | 77,6% | 84,9% | $1,22 → $3,07 | 12,4 → 11,9 menit |
| GPT 6 Sol, maksimum | 89,0% | 90,4% | $4,82 → $8,54 | 38,4 → 27,6 menit |
| Claude Opus 5.5, sedang | 91,5% | 91,2% | $4,08 → $9,10 | 20,3 → 26,6 menit |
| Claude Opus 5.5, maksimum | 89,8% | 93,2% | $23,77 → $122 | 74,7 → 174,1 menit |
Ini adalah biaya rata-rata model Vals untuk satu pembuatan aplikasi, bukan harga langganan atau biaya per pengujian UI yang berhasil. Waktu adalah median jam dinding, sehingga biaya dan waktu pada tiap baris merangkum 50 proses dengan cara berbeda. Rata-rata tim Opus berupaya maksimum mencakup satu proses yang melewati batas waktu; Vals memperkirakan biayanya sekitar $189 dari jumlah token.
## Mengapa hasil bergantung pada konfigurasi
Vals membandingkan setiap tim dengan agen tunggal pasangannya pada aplikasi yang sama menggunakan uji t berpasangan. Tim Sol berupaya maksimum naik 1,4 poin, dengan interval 95% dari −1,7 hingga 4,5 poin. Tim Opus berupaya sedang mendapat skor 0,3 poin lebih rendah, dengan interval −3,2 hingga 2,5; pada upaya maksimum, naik 3,4 poin dengan interval −1,4 hingga 8,3. Interval tersebut mencakup kemungkinan tanpa kenaikan. Ini tidak membuktikan bahwa tim tak pernah membantu konfigurasi tersebut, tetapi eksperimen ini tidak menetapkan adanya kenaikan.
Untuk Sol, tingkat upaya penalaran juga menjadi pilihan yang diuji. Menaikkan agen Sol tunggal dari upaya sedang ke maksimum meningkatkan skornya dari 77,6% menjadi 89,0%, yang menurut laporan Vals signifikan secara statistik. Agen tunggal berupaya maksimum itu berbiaya $4,82 per aplikasi dan memiliki median waktu 38,4 menit, dibanding $3,07 dan 11,9 menit untuk tim berupaya sedang. Selisih skor 4,1 poin di antara kedua konfigurasi itu tidak signifikan secara statistik (p = 0,08). Angka-angka ini menunjukkan pertukaran harga dan waktu yang terukur kepada pengembang tanpa menganggap satu konfigurasi akan menang pada proyek baru.
Tim juga menggunakan waktu dengan cara berbeda. Menurut Vals, pemimpin Sol mendelegasikan lebih awal lalu menguji sendiri aplikasi yang telah dirakit. Tim berupaya maksimum selesai dalam median 27,6 menit, turun dari 38,4 menit untuk agen tunggal. Pemimpin Opus cenderung menulis kontrak bersama lalu mendelegasikan secara bertahap. Pada upaya maksimum, tim memerlukan median 174,1 menit dibanding 74,7 menit untuk agen tunggal, dan biayanya sekitar lima kali lebih tinggi per aplikasi. Vals mengaitkan sebagian besar tagihan tambahan dengan token masukan yang tersimpan dalam konteks terpisah para subagen.
## Batas kesimpulan ini
Interval signifikansi mencerminkan perbedaan di antara 50 aplikasi, bukan variasi dari percobaan berulang pada aplikasi yang sama. Proses berbeda dapat mengubah perbandingan. Proses tim juga mendapat instruksi delegasi tambahan, sehingga eksperimen mengukur gabungan konfigurasi tim dan instruksi. Sol memakai OpenAI Agents API dan Opus memakai Claude Code; perbandingan skor lintas model juga mencampur harness yang berbeda. Estimasi biaya Sol oleh Vals mengasumsikan penggunaan token yang dilaporkan mencakup subagen dan tidak memperhitungkan harga lebih tinggi untuk permintaan yang melewati ambang konteks panjang, karena data penggunaan per permintaan tidak tersedia.
Studi ini mendukung keputusan yang terbatas: saat membangun aplikasi full-stack serupa dengan konfigurasi ini, tim Sol berupaya sedang menunjukkan kenaikan terukur dengan biaya lebih tinggi, sedangkan tim lain tidak menunjukkan kenaikan skor yang dapat diandalkan. Studi ini tidak menentukan apakah tim akan sepadan pada codebase lain, model berbeda, atau alur kerja dengan cara membagi dan memeriksa tugas yang berbeda. BIG CHANGE menelaah tulisan Vals yang diterbitkan dan metodenya; kami tidak menjalankan atau mereplikasi benchmark tersebut.
## Sources
- [Vals AI, Apakah Tim Agen Sepadan? Studi Kasus Vibe Code Bench](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — Laporan eksperimen asli. Skor, biaya, waktu, interval dan nilai p uji berpasangan, perilaku tim, rincian implementasi, serta batasannya mendukung artikel ini. Masing-masing dari delapan konfigurasi dijalankan sekali pada tiap 50 aplikasi; ketidakpastian yang dilaporkan bervariasi antar aplikasi, bukan antar percobaan berulang.
- [Vals AI, Metodologi Vibe Code Bench v1.1](https://www.vals.ai/benchmarks/vibe-code) — Uraian benchmark tertaut dan metodologinya: spesifikasi aplikasi, 20–60 pengujian UI per aplikasi, serta aturan penilaian. Papan peringkat umumnya menggunakan konfigurasi harness lain dan tidak menggantikan hasil studi kasus tim agen.
- [The Decoder, Tim agen AI membuang banyak token demi kenaikan kualitas yang nyaris tak terukur, menurut studi](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — Liputan independen kontemporer yang digunakan untuk penemuan dan konteks. Klaim numerik dan metodologis artikel diperiksa terhadap laporan asli Vals, dan BIG CHANGE tidak mengadopsi kesimpulan luas pada judul tersebut.
Buletin BIG CHANGE
Gambaran besar. Sesuai tempo Anda.
Kisah terbaru tentang AI dan robotika, perubahan yang patut diikuti, serta gagasan praktis yang dapat diterapkan. Pilih rangkuman harian, mingguan, atau perspektif bulanan.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Privasi Anda, pilihan Anda.
Penyimpanan yang diperlukan membantu menjaga keamanan situs dan mengingat pilihan Anda. Google Analytics opsional tetap nonaktif sampai Anda mengizinkannya. Anda dapat membaca semua artikel hanya dengan penyimpanan yang diperlukan. Detail privasi