AI-translated from English; not yet reviewed by a fluent editor.
# AIコーディングが広がる今、次の課題は信頼できるソフトウェアを届けること
> AIでコード生成が増えるとき、エンジニアリング管理者には、変更がどこで滞留し、検証にいくらかかり、公開したソフトウェアが意図どおり動くかを把握する必要がある。
By BIG CHANGE Editorial
Published: 2026-09-22T05:31:05.772Z
Updated: 2026-09-22T05:31:05.772Z
Canonical: https://bigchange.ai/blog/ai-coding-ci-bottleneck-dependable-delivery
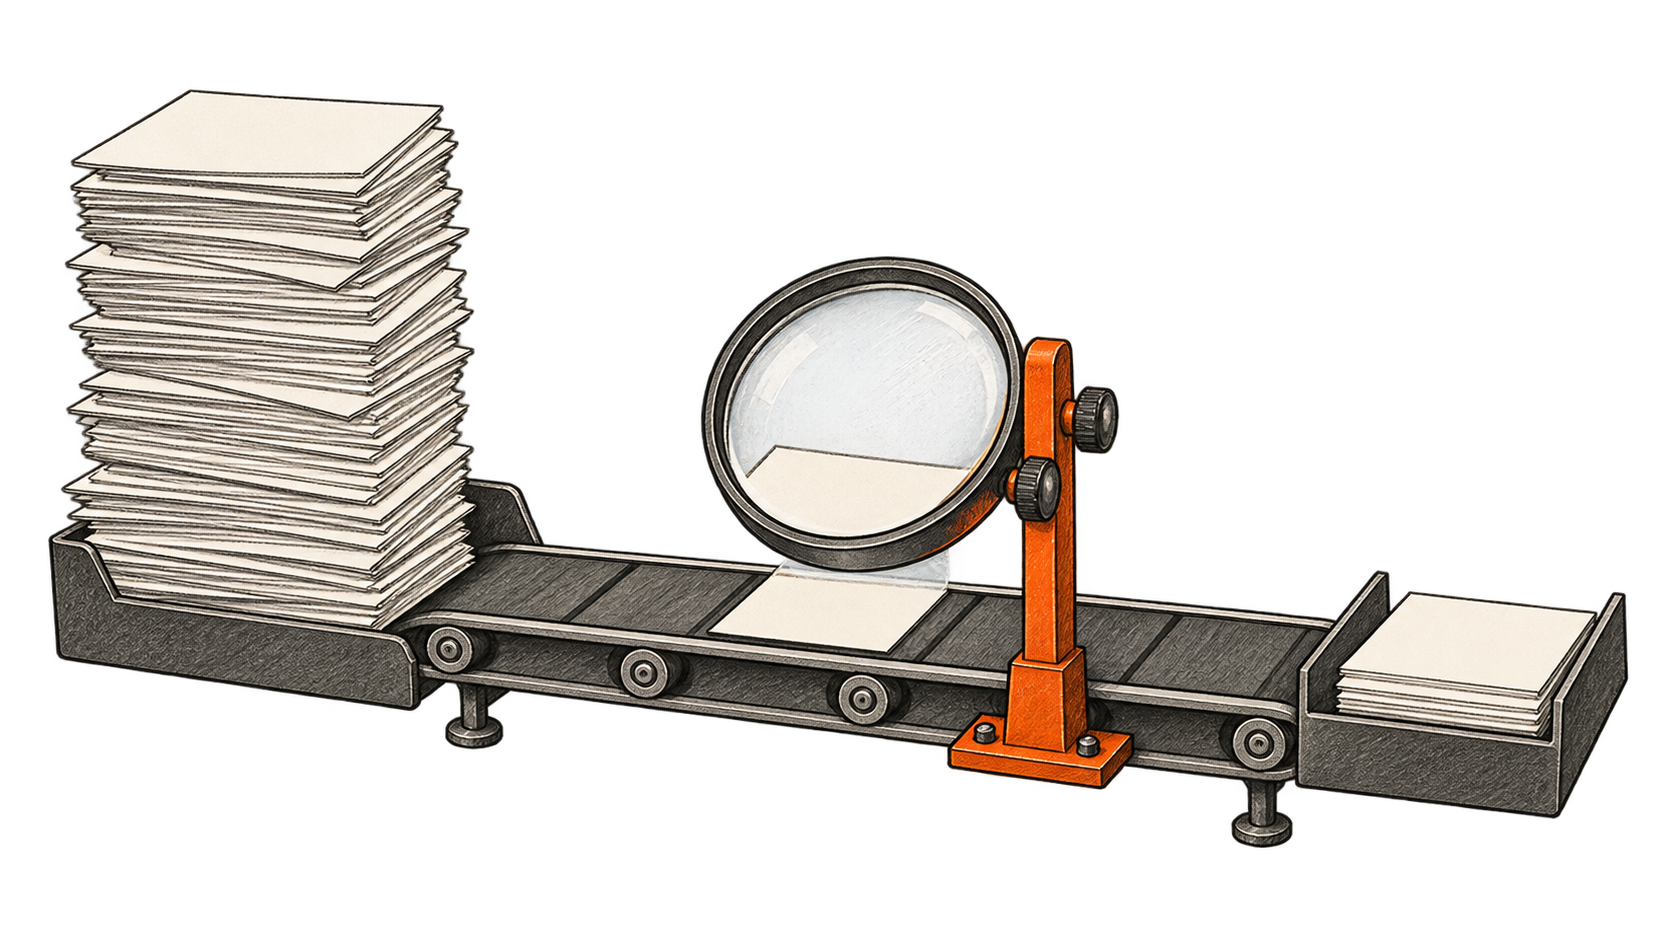
AI-generated conceptual illustration by BIG CHANGE. More proposed changes can put pressure on validation. Conceptual illustration of a queue and inspection stage; stack sizes are not measurements, and passing checks does not guarantee dependable delivery.
AIコーディングエージェントは、ひとつ前のパッチのチェックが動いている間に、次の修正を終えることがある。エンジニアリング管理者にとって厄介なのは、チームがコードをより多く作った一方で、顧客にはまだ何も届いていないという違いだ。
Linearは有用な事例を示している。9月21日のエンジニアリング報告でMufeez Amjadは、2026年の初めからテストスイートがほぼ4倍になった一方、継続的インテグレーション(CI)でのプルリクエスト待ち時間は6分超から5分強に減ったと報告した。テスト一つ当たりの実行環境時間はおよそ半分になった。これらは別々の改善であり、最後の数値はCI請求額全体が半減したことを意味しない。Linearは、エージェント支援型開発によって検証への圧力が増したとしているが、この報告はAIの生産性効果を立証する統制実験ではない。[Linearのエンジニアリング報告](https://linear.app/now/ci-bottleneck-reworked)。
継続的インテグレーション(CI)は、提案されたソフトウェア変更に対して自動チェックを実行する。もっともらしい修正案と、チームが受け入れる用意のある変更の間に位置する。AIコーディングによってパッチの供給が増えると、検証能力は経営上の問題になる。組織は、どれほどの有用な作業を安全に受け入れられるのか。
私たちは、信頼できるフィードバックまでの時間、計算作業の総量、リリースした変更の信頼性という三つの結果を、管理者が一緒に見えるようにすべきだと考える。回答が速くても、その回答で何が確認できたかをチームが理解して初めて価値がある。
## 待ち時間を短くしても、作業が増えることがある
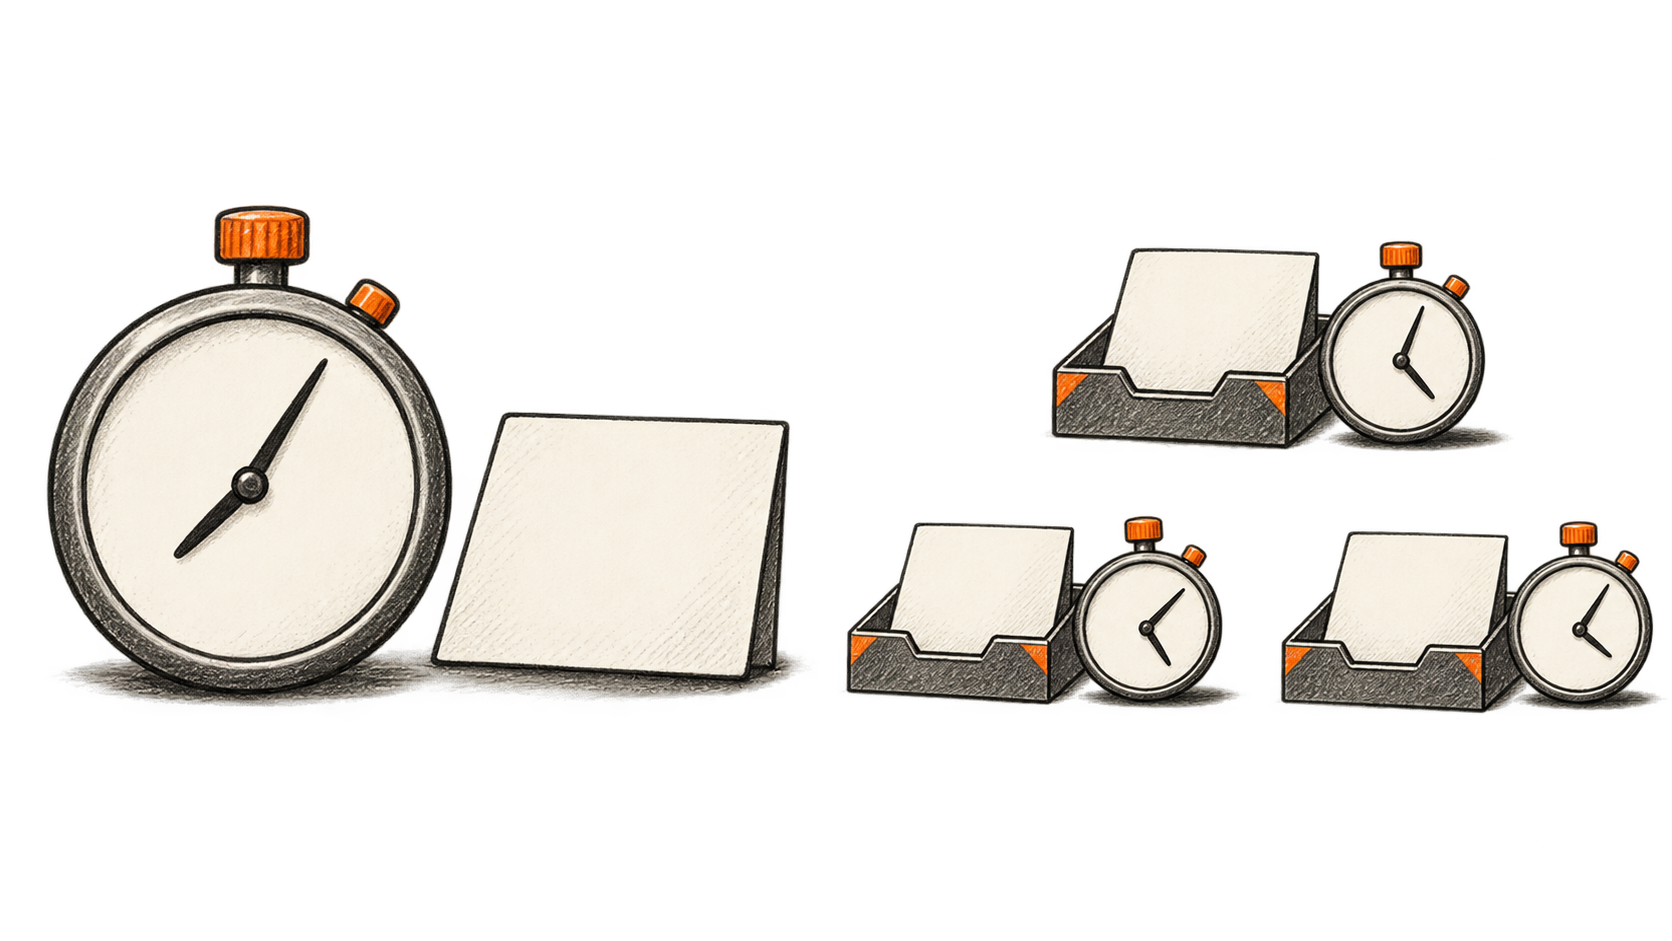
一台のマシンで12分かかるテストスイートを考えてみよう。四台に均等分割できれば、3分で終わる可能性がある。この仮定例は完全に均等分割できるとし、それ以外を無視している。それでもマシンが実行する作業は、合計12分のままだ。
各マシンの準備に1分かかるとしよう。四台の場合、完了まで4分かかり、実行環境時間は合計16分になる。一台の場合は13分かかり、実行環境時間は13分だ。待ち時間は大幅に改善する一方、マシンの総使用量は増える。実際の料金は、実行環境の種類、価格、課金規則にも左右される。
ダッシュボードに短い緑色のバーが表示されると、この区別が重要になる。並列処理の能力を購入する管理者は、より早いフィードバックに対価を払うのであり、費用が追加されることもある。本当の制約を取り除くなら、優れた交換条件になりうる。完了した変更が、その後、レビュー担当者の空きを何時間も待つなら正当化は難しい。
分析単位は、個々のCI実行より広くすべきだ。何度もの修正、再実行、二回目のレビューを引き起こすパッチは、最速の一回だけから想像するより多くの作業を消費することがある。放棄された試行も含め、変更を受け入れるまでに必要な試行回数を数えよう。そうしなければ、効率がよさそうなパイプラインの裏に、高コストの開発プロセスが隠れてしまう。
待ち時間のすべてが同じ人件費になるわけでもない。開発者がチェックの実行中に別の有用な作業を始められるなら、その時間全体を失ったとは限らない。それでも、頻繁な中断や未完了作業への復帰は負担になる。その影響を測るには、経過分数に給与を掛けるのではなく、チームの実際の働き方を見る必要がある。
## 研究結果が示すのは複合的な状況だ
DORAによる2026年3月の分析では、異なる二つの証拠群が報告されている。2025年の研究は、AI導入の拡大と、ソフトウェア納品のスループット向上および不安定性の増大の両方に関連があるとした。別に、研究者は2025年第3四半期にGoogleのエンジニアから集めた自由記述回答1,110件を分析した。エンジニアは、草稿作成などの支援と並んで、検証の負担も述べている。この社内定性調査は、より広いDORAの関連分析を構成する調査対象ではなく、どちらも特定チームのリリース問題をAIが引き起こしたとは立証しない。[DORAの分析と方法論](https://dora.dev/insights/balancing-ai-tensions/)。
対象範囲は狭いものの、より強い実験的証拠もある。METRの2025年7月の無作為化研究は、慣れたリポジトリで働く経験豊富なオープンソース開発者16人に、246件のタスクを割り当てた。2025年初頭のAIツールを利用できる条件では、タスク完了に19%長くかかった。それにもかかわらず、参加者はAIが作業を速めたと考えていた。この結果は、対象となった開発者、タスク、ツールについてのものであり、現在利用できるすべてのコーディングエージェントの価値を決めるものではない。[METRの原実験](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/)。
2026年2月、METRは追跡調査の結果から、現在の生産性効果を信頼できる形で推定できなかったと説明した。開発者がAIなしの仕事を断ったり、提出するタスクを選んだりする傾向が強まり、同時に動くエージェントも時間測定を難しくした。研究者はより大きな加速の可能性を考慮したが、規模についてデータが与える証拠は弱いと述べた。この留保を示さず、以前の作業遅延の数値だけを繰り返せば、読者を誤解させる。[METRの追跡調査](https://metr.org/blog/2026-02-24-uplift-update/)。
管理者にとって、これらの研究が支持するのは実務的な姿勢だ。有用なツールは使い続け、その影響を調べ、楽観も懐疑も一律の人員配置の方針にしない。一種類の作業では大きな利益を得て、別の作業では時間を失うチームもありうる。納品プロセスでその違いを明らかにする必要がある。
## 制約ごとに対策を分ける
CI能力を増やす前に、一つの変更が最初の提案パッチから本番環境に至るまでを図にしよう。実行中の作業と待機中の作業を分ける。判断を実際に遅らせるチェック、注意を要するレビュー担当者、その後に残るリリース条件を特定する。
単純な時間記録でも、誤った投資を明らかにできることが多い。遅延の大半がレビュー開始前に起きているなら、テスト時間を数秒縮めても解決しない。担当者が必須チェックの完了を何度も待つなら、そのチェックの改善には直接の意味がある。デプロイ後に失敗が起きるなら、検証で何を見落とすか調べる必要がある。
依存関係のキャッシュは、よく知られた最適化にも測定が要る理由を示す。GitHubの文書によると、クリーンな実行環境で再作成に費用がかかるファイルを再利用する方法としてキャッシュがある。また、キャッシュが使えなくても、ジョブは該当ファイルを再作成またはダウンロードできる必要がある。したがってキャッシュの挙動は、ヒットとミスの両方で評価すべきだ。[GitHubの依存関係キャッシュに関する文書](https://docs.github.com/en/actions/concepts/workflows-and-actions/dependency-caching)。
管理者にとって有用な問いは、フィードバックがどれほど予測可能になるかだ。平均が優秀でも、ときおり極端に長い待ちがリリースを乱すことがある。分布の遅い側も記録し、正当なテスト失敗とダウンロード失敗や実行環境の枯渇を区別しよう。それぞれに異なる対処が必要だ。
信頼できる迅速なフィードバックがあれば、人間にもエージェントにも、誤りをより早く直す機会が生まれる。共有基盤の改善は、AIを使わずに書かれた変更を含め、さまざまな開発作業に役立つ。コーディングツールの選択が変わる間も、その基盤に資金を投じる理由になる。
## テストの高速化でも誤りを見つける必要がある
一部の性能変更は、テストを実行する条件そのものを変えることがある。より高速なプロセッサを使う場合より、慎重に調べる必要がある。
JavaScriptとTypeScriptのテストツールVitestは、既定でテストファイルを隔離し、一つのファイルの状態がほかに影響しないようにする。同社の文書は、適切なテストについて隔離を選択的に解除する方法を説明する一方、可変なモジュール状態、変更されたグローバル変数、その他の依存関係がある場合は、隔離を維持すべきとしている。準備時間を短縮する設定が、正しさを保つ境界を変えることがある。[Vitestの隔離に関する指針](https://vitest.dev/guide/recipes/disable-isolation)。
Linearはオプトイン方式で共有状態を導入し、後処理を追加したうえで、安全に移行できないファイルについては隔離を維持した。性能向上の裏には、どのテストが同じ環境を安全に共有できるかという判断があった。[Linearの実装](https://linear.app/now/ci-bottleneck-reworked)。
エージェントが変更とテストの両方を書く場合には、別の課題もある。年契約に限って適用される割引ルールを想像しよう。エージェントが月契約にも誤って適用し、その解釈を肯定するテストまで書くことがある。それらのテストが通っても、誤った仕様との一貫性が示されるだけだ。
レビュー担当者には、実装の外部にある根拠が必要だ。合意済みの要件、意図された挙動の例、失敗すべきケースなどである。エージェントにテストを追加で依頼すると役立つことはあるが、テスト数が増えただけでは、誤解された要件に異議を唱えたことにはならない。ソフトウェアがどう動くべきかを判断し、その問いに証拠が答えているかを確認する責任は、人間にある。
テストの件数だけに報いるチームでは、レビューする資料が増える一方で、確信が下がるおそれがある。管理者は、エージェントが作業を終えた後の理由不明な遅れとして扱うのではなく、仕事を割り当てる段階で検討時間を確保すべきだ。
## 顧客に届く変更を測る
DORAの納品指標は、下流の結果を確認するうえで役立つ。コミットされたコードが本番環境に届くまでの時間、デプロイ頻度、失敗したデプロイからの復旧時間、即時介入が必要なデプロイの割合、計画外のインシデント対応の再作業に当たるデプロイの割合などだ。これらはテスト合格以外の納品結果を示す。[DORAの指標定義](https://dora.dev/guides/dora-metrics/)。
AIコーディングの作業フローを調査するチームには、これらの結果に小規模な診断記録を組み合わせることを勧める。
- フィードバック:低速な実行と処理能力待ちを含む、必須チェック完了までの経過時間。
- 消費量:受け入れられた変更に伴う実行環境の総作業量と、再試行の回数。
- レビュー:確認待ちの時間、大幅な修正の依頼、その理由。
- 顧客への影響:公開した変更が意図した動作を実現したか、修正作業が必要だったか。
この記録を使い、個別の作業フローを調べる。小さな文書編集とデータベースの移行を、生産性の同じ単位として扱ってはならない。可能なら、同種の作業を時系列で比較し、実行環境の提供者変更やリリースプロセス改定なども記録する。AI導入と同時期に改善が起きても、その原因がAIだとは証明されない。
管理者は具体的な選択を行える。十分な確信を持つ変更を顧客に届けるのを妨げる制約に投資しよう。計算能力の拡充が必要な場合もある。要件の明確化、テストの改善、既に届いている提案を理解できる経験豊富なレビュー担当者の時間確保が重要な場合もある。
## Sources
- [Linear:AIコーディングとCIのボトルネック](https://linear.app/now/ci-bottleneck-reworked) — 2026年9月21日付。Mufeez Amjadによる実装の説明で、冒頭の数値と選択的な隔離解除の例を示す。一次情報による自社システムの測定であり、AIの生産性や支出全体を統制して推定したものではない。
- [DORA:「AIの緊張関係のバランス」](https://dora.dev/insights/balancing-ai-tensions/) — 2026年3月10日付。2025年のDORA研究による関連分析と、Googleのエンジニア回答の定性分析を区別する。社内調査は測定された因果効果ではなく、経験を報告している。先行する問いが回答を促した可能性もある。
- [METR:2025年初頭のAIと経験豊富な開発者の生産性](https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/) — 2025年7月の無作為化実験。経験のある開発者、慣れたオープンソースのリポジトリ、2025年初頭のツールが対象。範囲を限定した遅延と認識の不一致を裏付ける。全開発者や2026年9月のモデルについての推定ではない。
- [METR:「開発者の生産性実験の変化」](https://metr.org/blog/2026-02-24-uplift-update/) — 2026年2月24日付の更新。参加者とタスクの選択、報酬変更、並行作業の測定問題を説明する。研究者は新たな推定値を信頼できないと判断しており、生の数値を現行の高速化効果として提示しない。
- [GitHub:依存関係キャッシュ](https://docs.github.com/en/actions/concepts/workflows-and-actions/dependency-caching) — 2026年9月22日に確認した現行文書。クリーンな実行環境での再利用と、キャッシュなしでもジョブが機能する必要性を説明する。特定のリポジトリの性能や請求額を示すものではない。
- [Vitest:ファイルごとの隔離設定](https://vitest.dev/guide/recipes/disable-isolation) — 2026年9月22日に確認した現行文書。既定の隔離、選択的な設定、保護が必要となる状態依存を説明する。技術的な指針を裏付ける資料であり、BIG CHANGEはベンチマークやテストスイートの変更を行っていない。
- [DORA:ソフトウェア納品パフォーマンス指標](https://dora.dev/guides/dora-metrics/) — 2026年1月5日更新。五つの納品指標とサービス単位での適用を定義する。CI時間を超えた成果指標であり、記事にある診断例は分析上の提案で、新たな実験結果ではない。
BIG CHANGEニュースレター
大局を、あなたのペースで。
AI とロボティクスの最新記事、注目すべき変化、活用できる実用的なアイデア。日刊ブリーフィング、週刊ダイジェスト、月刊展望から選べます。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.