Markdown版
AI-translated from English; not yet reviewed by a fluent editor.
# Jevの大きな賭け:日常のソフトウェアにAIの判断を組み込む
> TypeSafeのCEO Diogo Almeida氏は、ソフトウェア内の小さな判断を支えるAIを提唱する。Jevの発表と限界、意味のある変化を立証する証拠を検討する。
By BIG CHANGE Editorial
Published: 2026-09-22T00:45:03.943Z
Updated: 2026-09-22T00:45:03.943Z
Canonical: https://bigchange.ai/blog/jev-typesafe-ai-decisions-software-diogo-almeida
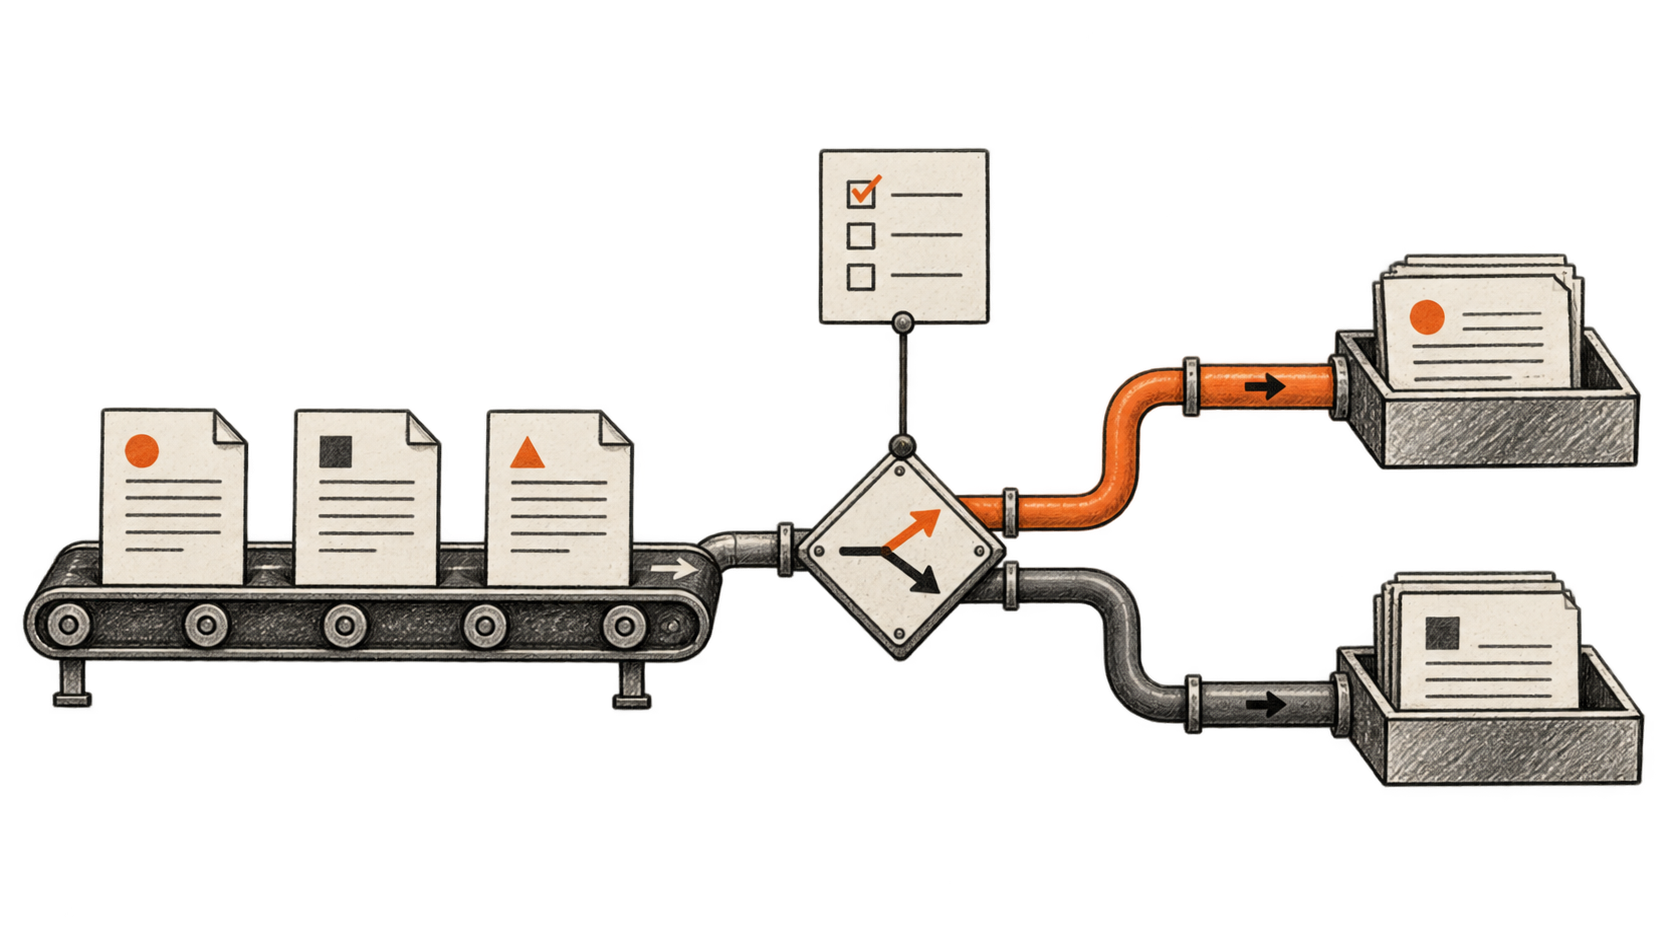
AI-generated conceptual illustration by BIG CHANGE. A decision switch inside a larger workflow; not a depiction of Jev’s internal architecture.
顧客が注文の住所変更を求める。メッセージには返金依頼、荷物の破損、同じような問題が今回で3度目だという含みもある。そのメッセージへの適切な返答を作るのが一つの仕事だ。更新する記録、対応すべきチーム、許可を要する行動を判断するのは別の仕事である。
2026年9月15日にTypeSafe AIが早期アクセス版として発表したモデルJevは、そうした判断を対象とする。ソフトウェア向けに、制約された構造化回答を出力する。今回の発表は、汎用モデルとの長い会話にアプリケーションがどれほど依存すべきかを考え直すきっかけとなる。[TypeSafeの発表](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
この主張が最も詳しく語られたのは、swyxが司会を務めたLatent Spaceによる9月21日のインタビューである。相手はTypeSafeの共同創業者兼CEO Diogo Almeida氏だ。2時間22分の会話全体の英語字幕を確認し、製品文書も照合した。これはインタビューと公開情報の分析であり、Jevを独自にベンチマークしたものではない。[元のインタビューを見る](https://www.youtube.com/watch?v=cFx9Z3ZXca0)
私たちの解釈では、Jevの最も重要な提案は自動化の単位に関わる。企業は、プロセス全体を責任を持って任せられるようになる前に、既存の業務内にある限定的な判断を自動化できるかもしれない。その判断を繰り返す費用が十分に低く、明確に測定できるなら、すべてのやり取りをチャットにせずとも、身近な業務ソフトに有用な機能が加わり得る。
それはワークフローを設計する人々にも、利用者にも影響する。どの行動が許可されるか、何を誤りとみなすか、例外を誰が処理するかは、人が決めなければならない。こうした判断の質が、信頼できるサービスを生むか、間違いを加速させるだけかを左右する。
## TypeSafeが実際に公開したもの
Jevの文書化されたインターフェースは、状態と型付きの質問を受け取る。基本機能は三つある。Choiceは指定された選択肢から選び、Scoreは評価基準に照らして採点し、Noulは文の確率を0から1の尺度で表す。ChoiceとScoreは確率分布とconfidence欄を返す。Noulには独立したconfidence欄はない。複数の質問には同じ状態を与えられるが、評価自体は個別に行われる。[TypeSafeのインターフェース文書](https://docs.typesafe.ai/introduction)
カスタマーサービスのアプリなら、開発者はこれらの機能を使い、住所変更依頼とキャンセル依頼を区別し、緊急性を評価し、メッセージに破損の証拠が含まれるか確認できるかもしれない。これは仮想例であり、Jevを導入した結果ではない。回答を受け取ったアプリケーションが次の行動を決める。
解釈と権限という異なる責任を分けられる点で、この設計には利点がある。AIは顧客が返金を望んでいると推定できる。しかし、その結論に達しただけで返金を行う許可まで得るべきではない。アプリケーションは注文を確認し、返金上限を適用し、必要なら承認を求められる。
TypeSafeはこのモデルの区分をSystem Oneと呼び、速く直感的な思考を表す言葉を借りている。この名称は想定する作業を示すものとして受け止めるべきだ。人間のような認知を認定するものでも、簡単な作業と難しい作業の境界を明確に示すものでもない。必要情報が不足していれば、短い問いにも複雑な判断が隠れていることがある。
## 工学上の変化は、より小さく検査可能な判断にある
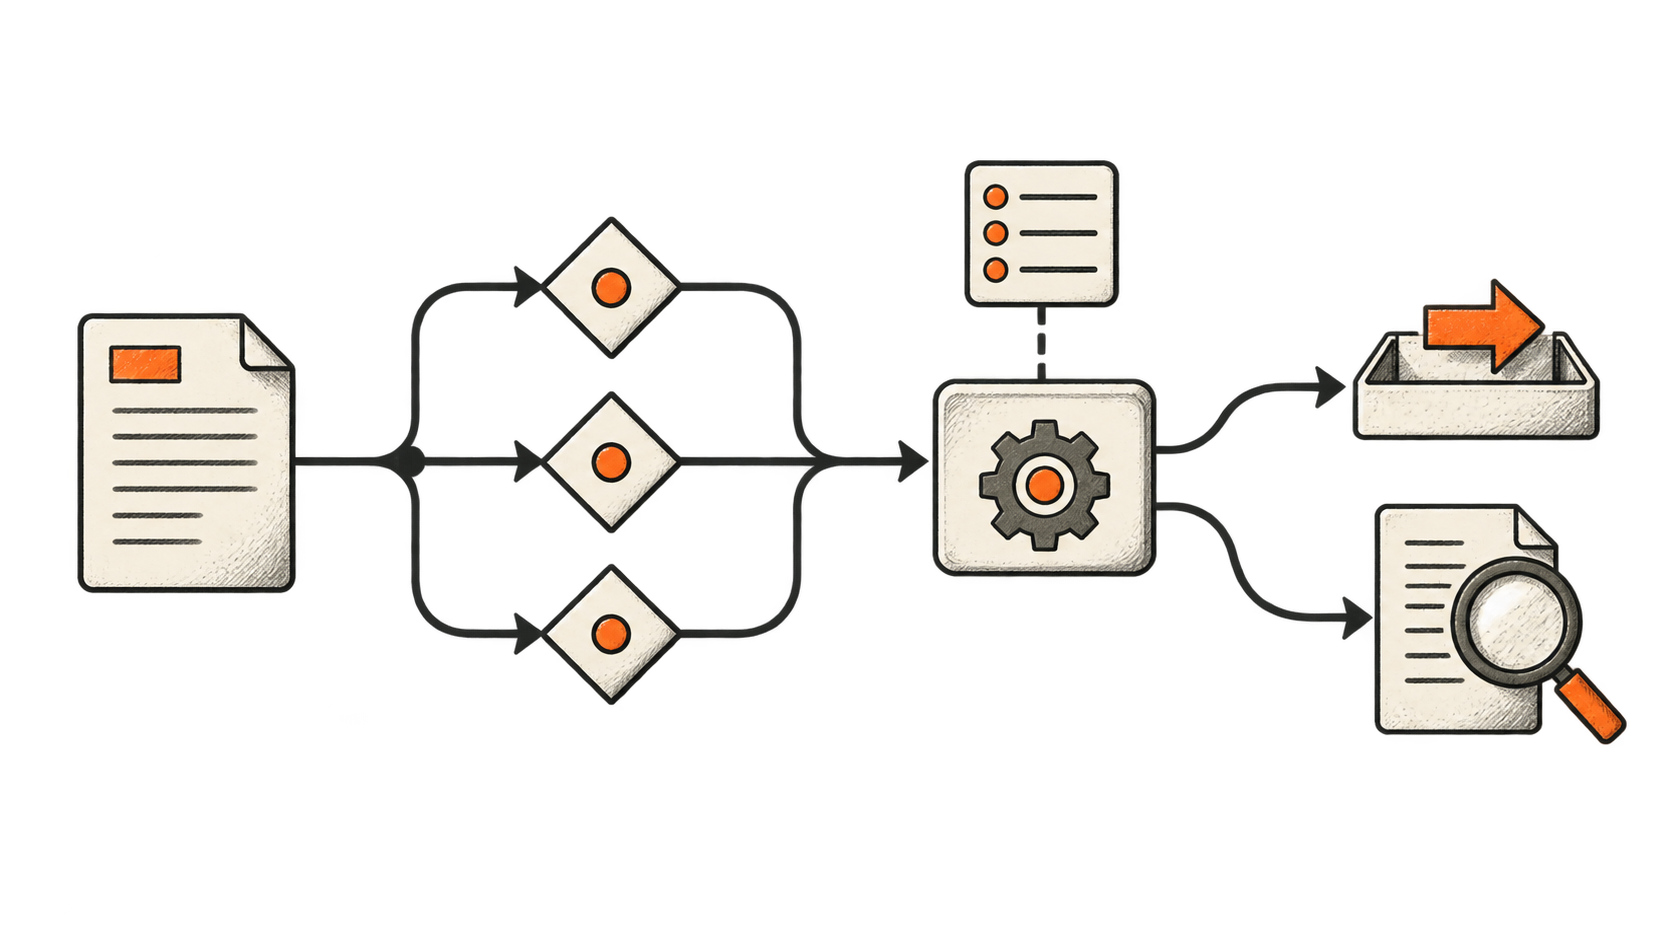
Almeida氏は、対象を絞った質問を行い、その回答をコードで組み合わせる分解方式を提唱する。[インタビュー、1時間03分02秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=3782s)
荷物破損の例に戻ろう。苦情に対応せよという一つの指示には、複数の判断が一つの回答に隠れている。検査しやすい設計なら、まず求められる対応、注文を特定できるか、入手できる証拠が破損の主張を裏付けるかを別々に確認する。方針規則はその判断から切り離しておく。
これにより失敗を調査しやすくなる。住所変更が返品担当へ回された場合、担当者は振り分け判断を調べられる。破損評価が誤っていれば、その構成要素を過去の事例で試せる。幅広い指示を書き換えてモデルが一貫して解釈すると期待しなくても、明示的な規則を変えることで方針を更新できる。
一方で費用もある。構成要素が増えるほど保守すべきインターフェースも増える。回答が明確になるために必要な文脈を質問から誤って省くこともある。一見独立した二つの判断が、同じ誤解を招く証拠に依存するかもしれない。個別には許容範囲の部品を組み合わせても、ワークフロー全体の結果は許容できない場合がある。
TypeSafeが文書化したパターンには、複数の質問をまとめて行うこと、スコアを組み合わせること、不確実な事例を追加対応へ回すことが含まれる。これらは設計上の選択肢を示すものであり、特定顧客の業務を無人運転にできる証拠ではない。[TypeSafeの設計パターン](https://docs.typesafe.ai/patterns)
有用な検証は、分解によって原因究明と結果の両方が改善するかを確かめる。どの段階が失敗したか説明できるのは価値がある。失敗の頻度と影響を減らすことが事業上の根拠となる。
## 妥当な回答でも誤っていることがある
発表での「Jevは幻覚を起こせない」という主張は、狭く解釈する必要がある。TypeSafeが保証として挙げるのは、許可された出力スキーマに一致することだ。選ばれた回答の真偽までは保証しない。同社の発表自身も、スキーマの保証と実証評価を区別している。[TypeSafeによる型安全性の説明](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
仮にアプリケーションが次の値を認めるとしよう。`damaged`、`late`、`other`。出力が`damaged`であることは、荷物が単に遅れていただけでも、形式上は完全に妥当だ。第4の分類を捏造できないモデルでも、誤った選択肢を選ぶことはある。本当に必要な選択肢が一覧から漏れていれば、スキーマ自体が問題の一部となる。
構造化出力も、すでに存在する工学的手法だ。OpenAIは2024年8月に、スキーマに制約されたStructured Outputsを導入し、返された値の範囲内でもモデルが誤る場合があると明記した。したがってJevは、構造化AI出力をすべて発明したものとしてではなく、判断の質、不確実性の報告、遅延、コストの独自の組み合わせで評価する必要がある。[OpenAIの元の発表と限界](https://openai.com/index/introducing-structured-outputs-in-the-api/)
購入者にとって、この区別は評価計画を変える。スキーマ試験はソフトウェアが回答を処理できるかを問う。事実確認では回答が証拠と一致するかを問う。方針試験では、その後の行動が許可されるかを問う。一つに合格しても、ほかへの合格の代わりにはならない。
## インタビューで最も重要な論点は確率の校正に関するものだ
1時間09分ごろ、Almeida氏は完璧に校正できるという示唆を否定し、モデルが誤りを犯すことを認める。[インタビュー、1時間08分50秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4130s)
校正とは、予測確率を、予測をまとめた集団全体で実際に観測された結果とどう比較するかを扱う。モデルは不確実性を有用に示しながらも、高確率を示した事例すべてで正しいとは限らない。TypeSafeの入門文書もこの違いを明確に保っている。[TypeSafeの校正に関する説明](https://docs.typesafe.ai/introduction/machine-learning-primer)
APIのconfidence欄についても、もう一つ区別が必要だ。TypeSafeはこれを回答分布から導いた統計量と説明する。選択した回答が正しい確率を独立に測定したものと同一ではない。同社の文書は、作業とその結果を踏まえてしきい値を決めるよう推奨する。[TypeSafeのconfidenceに関する文書](https://docs.typesafe.ai/confidence)
これは実務上の懸念である。短い英語メッセージでは高い性能を示す振り分けモデルが、複数の依頼を含む長い苦情に苦戦する場面を想像してほしい。集計スコアだけでは弱点が隠れる可能性がある。弱い集団での高confidence判断は、慣れた集団での同じ表示値より慎重に扱うべきかもしれない。
チームは、不足情報、見慣れない言い回し、意図的に分かりにくい入力を含め、想定する事例を評価すべきだ。カテゴリー別に誤りを確認し、レビューへ回す費用と誤って実行する費用を比較する。しきい値は、デモからコピーした数値ではなく、証拠に基づく運用上の判断となる。
校正に関する研究はJevよりずっと前から存在する。Chuan Guo氏らによる広く引用される2017年の論文は、現代のニューラルネットワークの校正不足と、その改善手法を調べた。この研究は問題の背景を与えるものであり、TypeSafeのモデルを検証したものではない。[現代ニューラルネットワークの校正について](https://arxiv.org/abs/1706.04599)
## 信頼性にはサービス変更時の対応も含まれる
インタビューでは、堅牢性と決定性を区別し、長期的なサポートを一般に約束せずにバージョン安定性を論じている。[インタビュー、41分24秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2484s)と[49分40秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2980s)
これらは別個の購入判断である。決定性は同じ入力に対して同じ出力が出るかを問う。堅牢性は、レコードIDを変えるなど無関係な変更が不合理な挙動の変化を招かないかを問う。モデルは間違った答えを延々と繰り返し、決定的である場合もある。わずかな変動があっても周辺ワークフロー全体は信頼できることがある。
どちらの性質もライフサイクルのリスクを解消しない。企業は、どのモデル版が判断を生成したか、その版がいつまで利用可能か、後継モデルをどう評価するかを把握する必要がある。提供者の試験での改善であっても、顧客が慎重に調整した業務フローの挙動を変えることはある。
賢明な対応は代表的な事例を保存し、版を記録し、影響の大きい業務を移行する前に後継版と比較することだ。代替手段も必要となる。判断サービスは正確でも利用不能になることがある。アプリケーションに安全な停止や別経路への振り分けがなければ、実際の判断品質には稼働率も含まれる。
魅力的なAPIが運用上の依存関係に変わるのはこの場面だ。モデルが速くなっても、調達、監視、移行計画は不要にならない。個々のAPI呼び出しが単純に見えるため、かえって見過ごしやすくなる。
## 速度と価格の数字に文脈が必要な理由
TypeSafeは見出しとなる業務フロー成果として、速度193.6倍、コスト改善444.6倍を挙げる。同社の発表によれば、これらは社内で作成したワークフローで得た最大級の改善だ。正解との比較には、独立に確かめられた顧客事例の分類ではなく、別モデルの確率推定を用いた。また短いデモはJevに有利だと警告し、持続可能な長期価格は今後確かめる必要があるとする。[TypeSafeによる評価上の留保](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
こうした留保は数字とともに伝えるべきだ。別モデルの回答との一致は参考になるが、実際に解決した顧客事例に照らした正しさとは別のものを測っている。ベンダーが設計したワークフローは購入者の参考になっても、その購入者が受ける依頼の分布を表すとは限らない。
適切な比較は、文脈の収集、判断、規則の適用、例外対応、失敗からの復旧を含む仕事全体を対象とすべきだ。モデル呼び出しが安くても、レビュアーに回る作業が増えれば総費用は上がり得る。遅い呼び出しでも、高価なやり直しを防げば経済的かもしれない。
遅延は実際のアプリケーション稼働地域で測る必要がある。サービスの基盤に近い場所でのデモは、遠隔地の利用者にも同じ体験を約束するものではない。対話型システムでは平均だけでなく遅い要求も調べるべきだ。バックグラウンド処理では、処理量や総コストがより重要な場合もある。
Jevという名前は、効率が消費の拡大につながるという考えを想起させる。個々の企業にとって、これは予算上の問いを生む。どの判断が新たに評価する価値を持つようになるのか。逆に、単に安く評価できるからという理由で、不要な判断まで増えるのか。モデル呼び出しの増加自体は成果ではない。
## 異なる研究目的と、まだ未完の証拠
Almeida氏の研究上の議論は、データ、タスク選択、RLCDを結び付け、選好最適化を批判する。[インタビュー、7分23秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=443s)と[22分12秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=1332s)
RLCDはReinforcement Learning for Calibrated Decisions(校正された判断のための強化学習)を指す。TypeSafeはこれを、人間の選好や検証可能な報酬に基づく手法と対比し、利用可能な判断と確率の学習を目的とするものとして説明している。これは同社による目的の説明であり、訓練手法全体が独立に検証されたものと取り違えるべきではない。[TypeSafeのAI入門書](https://docs.typesafe.ai/introduction/machine-learning-primer)
手法を評価している間も、より大きな問いには検討の価値がある。訓練目的は、どのような挙動に報酬を与えるのか。説得力のある説明に最適化されたモデルは使いやすくても、コードが使える形で不確実性を示せない可能性がある。判断向けインターフェースは不確実性を扱いやすくできるが、出力は現実との照合を外部から行う必要がある。
TypeSafeはこの懸念をmode droppingに結び付け、選好最適化が人に評価されやすい出力へ可能性の幅を狭め得ると説明する。これは同社が述べる失敗の仕組みであり、選好訓練を受けたすべてのモデルが判断に使えないという認定ではない。[TypeSafeによる選好最適化の説明](https://docs.typesafe.ai/introduction/machine-learning-primer)
Almeida氏の経歴を踏まえると、この議論は特に興味深い。同氏は、人間のフィードバックを使って言語モデルを指示に従わせる方法を研究したInstructGPT論文の共著者である。その著者資格は確認できる。すべての研究所が何を誤っているかに関する大きな主張は別問題だ。[InstructGPT論文](https://arxiv.org/abs/2203.02155)
事前学習への支出や、新しい研究所による方向性のない研究への異議も、有用なタスクをどう選ぶかという同じ議論に属する。[インタビュー、1時間49分32秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6572s)と[2時間03分10秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7390s)
購入者に関係する教訓は、定義した業務プロセスで製品が何をできるかを問うことだ。研究者の経歴、計算資源への支出、独自のモデル構造は、その企業がどのように製品へたどり着いたかを説明できる。他社の事業へ導入する際の採算までは立証しない。
インタビューではAlmeida氏のOpenAI退職、初期の導入の難しさ、開発者主導の成長も扱う。[インタビュー、1時間31分27秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5487s)と[1時間56分48秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7008s)
こうした回想は企業の優先事項を説明するが、監査された導入実績ではない。開発者向け基盤の評価では、継続的に役立つ業務量と、失敗時に提供される支援を確認すべきだ。発表後の熱気は調査のきっかけであり、その実績の代わりにはならない。
## 既存ソフトウェアは新たなチャット画面以上のものを得る可能性がある
Almeida氏は、SaaS製品の強化とAIが背景へ退いていくことを見込む。[インタビュー、1時間19分57秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4797s)
ソフトウェアには、有用な判断によって次の手順を変えられる場面がすでにあるため、これは調べる価値のある方向だ。予約アプリなら、予約前に曖昧な依頼を見つけられる。メディア保管庫なら、研究者向けに資料を整理できる。サービス窓口なら、定例の更新と人の注意が必要な苦情を区別できる。これらは考えられる設計であり、Jevの導入報告ではない。
画面はほとんど変わらないかもしれない。利用者が気付くのは、誤りの減少、分類作業の反復の減少、適切な担当者を待つ時間の短縮だろう。業務の流れをすでに理解し、判断の改善を製品に組み込める企業が商業的な優位を得る可能性がある。
既存のソフトウェア企業も競争に直面する。多くの開発者が同じ判断機能を利用できれば、モデル呼び出しそのものは差別化になりにくい。周辺製品に、有用なデータアクセス、考え抜かれた操作設計、確実に業務を完了する手順が必要となる。
雇用に関する主張には、より慎重さが必要だ。一つのタスクを効率化すれば、人員配置が変わったり、サービス件数が増えたり、例外対応へ仕事が移ったりする可能性がある。結果は組織とサービス需要による。インタビューも早期アクセス版の発表も、特定の数の雇用が守られたり、なくなったり、新たに生まれたりすると立証していない。
BIG CHANGEの業界概観で測定可能な出来事は、意思決定を自動化する別の方法が利用可能になったことだ。広範な導入、生産性の向上、労働市場への影響は、異なる証拠を必要とする後の課題である。
## 蓄積された未活用データ、リアルタイムソフトウェア、デモの限界
インタビューは、保存データ、対話型アプリ、検証、コンピューター操作のデモを扱う。[インタビュー、1時間34分50秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5690s)
それぞれの分野で評価方法は異なる。アーカイブ処理は多少の遅延を許容できる一方、結果を抽出確認し、元記録へたどれる計画が必要だ。リアルタイムの操作画面には予測可能な応答性が求められる。別のモデルを評価する検査器なら、両方のシステムが同じ誤りを犯す事例を含め、対象モデルが実際に犯す誤りで検証しなければならない。
コンピューター操作では、行動を選ぶのはシステムの一部にすぎない。画面の正確な状態を把握し、行動を実行し、期待した変更が起きたか確認する方法も必要だ。洗練されたデモは手順が一度行われたことを示せるが、信頼できる自動化には反復試験と中断からの復旧が要る。
ゲームにも同じ注意が当てはまる。モデルを介したキャラクターはより豊かな状態に反応できる一方、ゲームエンジンは可能な行動を制約し続ける。遊びが改善するかは応答性、一貫性、体験設計による。すべてのフレームに推論を加えれば自動的に面白くなるわけではない。
こうした違いを踏まえれば、分類の誤りを避けられる。有用な構成要素には実際に担う役割について功績を認めつつ、周りのアプリケーション全体のあらゆる能力まで帰属させない。
ファインチューニング、視覚入力、追加のモデル形態もインタビューで可能性として取り上げられる。[インタビュー、1時間10分27秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4227s)と[1時間26分23秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5183s)
将来計画についての会話を、発表時点の導入計画に組み込むべきではない。利用可能なインターフェースを前提に構築し、別の構成要素が何を担うかを明確にし、新機能が実際に提供されてから評価する。そうすれば推測を製品機能として示さずに将来の改善を活用できる。
## コーディングエージェントは異なる方法で作業を分担できる
Almeida氏は、単一モデルの反復を超えて、状態管理を安くし、コーディングエージェント間で文脈を共有する案を示す。[インタビュー、1時間40分17秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6017s)と[2時間09分29秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7769s)
一つの構成案として、能力の高いコーディングモデルで変更を作り、関連ファイルの分類には小さな判断呼び出しを用い、その後のタスクは通常のソフトウェアで管理できる。別のレビュー機能が最終パッチを検討する。この設計は提案であり、ベンチマーク済みの推奨でも、Jevがすでに既存コーディングエージェントを置き換えた証拠でもない。
魅力は必要な文脈だけを選べることだ。サブタスクが一つのインターフェースと少数の制約だけを必要とするなら、会話全文を送るのは無駄かもしれない。明示的なタスク記録があれば、どの事実が重要か、すでに何が決まり、どの変更が残っているかを確認しやすくなる。
危険なのは、調整の提案を並行処理の保証と取り違えることだ。二つのエージェントがどちらも同じファイルを書き換えるべきだと判断することはあり得る。確率的モデルを、競合書き込みを防ぐソフトウェア機構の代わりにすべきではない。権限、版の確認、ロックで結果を強制する必要がある。
同様に、過去の作業を安く検索できれば記憶管理は改善し得るが、継続学習と呼ばれる問題すべてが解決するわけではない。以前の試みを覚えること、失敗の理由を理解すること、新しい状況に確実に適応することは別々の能力だ。説得力ある評価では、エージェントや呼び出しの数ではなく、完了タスク、後退、競合、人の介入を調べるべきである。
## 安全性はシステム全体に及ぶ。消えてなくなるわけではない
Almeida氏はモデルの拒否動作よりアプリケーション側の安全策を重視し、swyxはその帰結を問い直す。[インタビュー、13分11秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=791s)と[1時間42分29秒](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6149s)
ここには実際の設計課題がある。無人で動くアプリケーションは、依存先が要求を拒否したり、失敗したり、不確かな結果を返したりしたときの対応を持たなければならない。明示的な対処経路が必要だ。この指摘だけで、あらゆる安全策をどこに置くべきか決まるわけではない。
モデルが意図された行動を正しく特定しても、アプリケーションはアクセス権を強制しなければならない。記録を削除せよという依頼を正しく理解しても、その権限がない場合がある。技術上は妥当な依頼でも、運用者の方針に反する可能性がある。適切な文脈がなければ判断サービスは責任を持って答えられないうえ、行動の統制はアプリケーション側に残す必要がある。
そのため、より多くの判断をソフトウェアに委ねるほど、導入前に境界を定義する重要性が高まる。チームは必要な証拠、取り消し可能な操作、人が結果に異議を唱えたり訂正したりする方法を決めるべきだ。モデルとの面倒なやり取りを減らしただけでは、システム全体の安全性を示したことにならない。
## 大きな変化を示す証拠とは何か
この発表によって、明確な試験が可能になる。結果を観測できる一つの限定的な業務を選ぶ。現在のやり方を、誤りや、その修正に人がかけている時間も含めて記録する。行動権限を与える前に、代表的な事例で判断方式を試す。
人の介入なしに正確に完了した件数の割合、レビューをすり抜けた誤り、人へ回された作業、完了一件あたりの総費用を測る。結果が受理された理由を確認者が調べられるよう、元の証拠を保存する。モデル、方針、入力集団が変わるたびに比較を繰り返す。
評価の結果、プロセスの一部しかまだ準備できていないと分かる場合もある。それも有用な知見だ。定型分類を自動化し、曖昧な事例を経験ある担当者に残すなら、より広い自律性が認められなくても十分価値がある。
Jevの発表とAlmeida氏のインタビューは、AIが経済へ浸透する方法について野心的な仮説を提示する。反復可能で制約された判断によって、人々がすでに頼っているソフトウェアをより有能にできるというものだ。次の証拠は、誤りや例外も含めて記録しながら、長期にわたって業務を行うシステムから得るべきだ。興味深いモデル構造が、読者にも実際に見える変化になるのはそこからである。
## Sources
- [Latent Spaceの元インタビュー](https://www.youtube.com/watch?v=cFx9Z3ZXca0) — Latent SpaceによるDiogo Almeida氏のインタビュー。2026年9月21日公開。本稿全体で時刻付きリンクを掲載している。
- [System One ModelsとJevの紹介](https://typesafe.ai/blog/introducing-system-one-models-and-jev) — 2026年9月15日。TypeSafeによるJev早期アクセス発表。性能に関する主張と評価上の留保を含む。
- [はじめに](https://docs.typesafe.ai/introduction) — モデルへの状態入力と、Choice、Score、Noul質問を説明するTypeSafeの文書。
- [Confidence](https://docs.typesafe.ai/confidence) — confidenceと確率を区別し、アプリケーションがしきい値をどう使えるか説明するTypeSafeの文書。
- [AI入門](https://docs.typesafe.ai/introduction/machine-learning-primer) — 訓練目的と、複数の予測を集めた場合に校正が意味することについてのTypeSafeの説明。
- [設計パターン](https://docs.typesafe.ai/patterns) — モデルの判断をアプリケーションロジックと組み合わせるTypeSafeの例。
- [APIにおけるStructured Outputsの紹介](https://openai.com/index/introducing-structured-outputs-in-the-api/) — 2024年8月6日。スキーマに制約された出力の導入と、その限界に関するOpenAIの説明。
- [現代ニューラルネットワークの校正について](https://arxiv.org/abs/1706.04599) — Chuan Guo氏らによるニューラルネットワークの校正に関する2017年の研究。Jevを評価した論文ではない。
- [人間のフィードバックを使った言語モデルの指示追従訓練](https://arxiv.org/abs/2203.02155) — 人間のフィードバックによる指示追従を扱う2022年のInstructGPT研究論文。Diogo Almeida氏も共著者に名を連ねる。
BIG CHANGEニュースレター
大局を、あなたのペースで。
AI とロボティクスの最新記事、注目すべき変化、活用できる実用的なアイデア。日刊ブリーフィング、週刊ダイジェスト、月刊展望から選べます。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.