Markdown版
AI-translated from English; not yet reviewed by a fluent editor.
# Vals AIのコーディングテストでは、エージェントチームが7.3ポイント向上した一方、コストは2.5倍だった
> Vals AIが50件のアプリ構築で統計的に有意なチームの向上を確認したのは、GPT 6 Solの中程度の推論努力だけだった。この設定の費用は1アプリ当たり3.07ドルで、単独エージェントの1.22ドルを上回った。
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
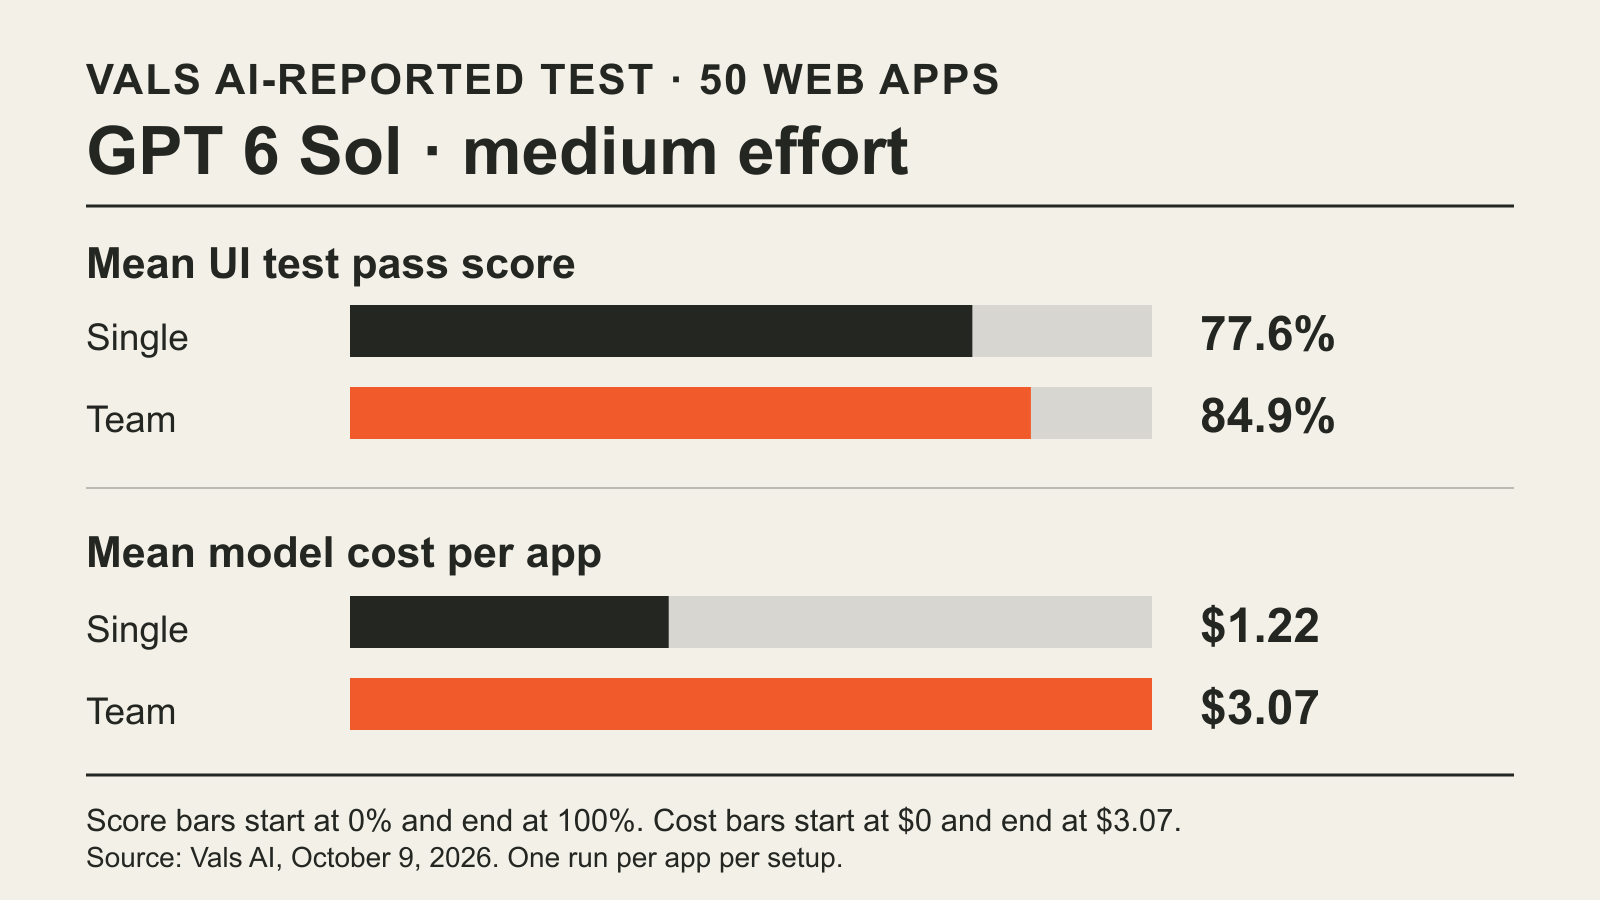
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
Vals AIが10月9日に発表した [Vibe Code Benchの研究](https://www.vals.ai/blogs/multi-agent-vibe-code-bench)。中程度の推論努力を設定したGPT 6 Solのチームは、ベンチマークのアプリテストの84.9%に合格し、Sol単独エージェントの77.6%を上回った。7.3ポイントの上昇にかかった費用は、平均で1アプリ当たり3.07ドルで、1.22ドルから増加した。Valsが報告したこの差の95%区間は2.3~12.4ポイントで、対応のある検定のp値は0.005だった。他の3つのチーム対単独エージェント比較では、スコアに統計的に有意な差はなかった。
この結果は、チームが「優れているか」という問いよりも、開発者に具体的な予算上の問いを示す。このWebアプリ構築群では、中程度の努力のSolが、アプリ当たり約1.85ドルの追加費用で測定可能な品質向上をもたらし、所要時間の中央値はほぼ同じだった。より高い努力の場合や、どちらの努力水準のClaude Opus 5.5でも、チームへの追加支出がこのテストでスコア向上につながるとは確認されなかった。
## 大きな変化
- **変わった点:** Valsは同じ50件のWebアプリ課題を2つの推論設定で実施し、単独のコーディングエージェントとチームを測定した。チームのスコアが統計的に有意に上がったのは、中程度の努力のSolだけだった。
- **重要な理由:** 最も良かったチーム設定の費用はアプリ当たり2.5倍だった。他のチームは有意なスコア向上がないまま1.8~5.1倍の費用がかかった。チーム設計とモデル設定は、同じ購入判断の一部である。
- **注目点:** 実行を繰り返し、他のソフトウェア課題でも試せば、この向上が今回のアプリ以外でも安定して得られるかが分かる可能性がある。この研究では各設定を1回ずつ実行した。
## 8回の実行で測定した内容
ValsはGPT 6 SolとClaude Opus 5.5に、製品仕様から50個の完全なWebアプリを作るよう求めた。アプリはDocker Composeでデプロイされ、ブラウザーエージェントがユーザーインターフェースのテストを行って採点した。報告されたスコアは、各アプリのテストのうち合格した割合の平均である。 [ベンチマークの方法](https://www.vals.ai/benchmarks/vibe-code)によると、各アプリ仕様には20~60件の自動テストがあり、個々のテストは手順の少なくとも90%が成功した場合に合格となる。
各モデルについてValsは、単独エージェントと、推論努力が中程度および最大の場合に同時に最大5つのサブエージェントへ委任できるリード役を比較した。リード役には、作業を分割し、委任し、統合して検証する指示も追加された。同じモデル内の比較では、タスクのプロンプト、サンドボックス、採点方法は一定だった。8つの設定はそれぞれ50個のアプリを1回ずつ構築した。
| モデルと努力水準 | 単独スコア | チームスコア | アプリ当たりの平均費用:単独 → チーム | 実行時間の中央値:単独 → チーム |
| --- | --- | --- | --- | --- |
| GPT 6 Sol、中程度 | 77.6% | 84.9% | 1.22ドル → 3.07ドル | 12.4 → 11.9分 |
| GPT 6 Sol、最大 | 89.0% | 90.4% | 4.82ドル → 8.54ドル | 38.4 → 27.6分 |
| Claude Opus 5.5、中程度 | 91.5% | 91.2% | 4.08ドル → 9.10ドル | 20.3 → 26.6分 |
| Claude Opus 5.5、最大 | 89.8% | 93.2% | 23.77ドル → 122ドル | 74.7 → 174.1分 |
これはValsによるアプリ1件の構築にかかるモデル費用の平均であり、サブスクリプション料金やUIテスト1件の合格当たりの費用ではない。実行時間は壁時計時間の中央値なので、各行の費用と時間は50回の実行を異なる要約で表している。最大努力のOpusチームの平均には時間切れの実行が1回含まれており、その費用はトークン数からValsが約189ドルと推定した。
## 結果が設定によって異なる理由
Valsは対応のあるt検定を使い、各チームを同じアプリで対応する単独エージェントと比較した。最大努力のSolチームは1.4ポイント上がり、95%区間は−1.7~4.5ポイントだった。中程度のOpusチームは0.3ポイント低く、区間は−3.2~2.5ポイントだった。最大努力のチームは3.4ポイント上がり、区間は−1.4~8.3ポイントだった。いずれの区間も改善なしを含む。これらは該当設定でチームが決して役立たないことを証明するものではないが、この実験では向上が確認されなかった。
Solでは推論努力も検証対象だった。単独のSolエージェントを中程度から最大に上げると、スコアは77.6%から89.0%に上昇し、Valsは統計的に有意だと報告した。この最大努力の単独エージェントは1アプリ当たり4.82ドル、実行時間の中央値は38.4分だった。中程度努力のチームは3.07ドル、11.9分だった。この2設定のスコア差4.1ポイントは統計的に有意ではなかった(p = 0.08)。これらの数値から、開発者は新しいプロジェクトでどれかが勝つと決めつけず、測定された費用と時間のトレードオフを確認できる。
チームごとに時間の使い方も異なった。Valsによると、Solのリード役は早い段階で作業を委任し、組み上げたアプリを自らテストした。最大努力のチームは所要時間の中央値27.6分で完了し、単独エージェントの38.4分を下回った。Opusのリード役は共有契約を作って段階的に委任する傾向があった。最大努力ではチームの所要時間の中央値は174.1分で、単独の74.7分を上回り、アプリ当たりの費用は約5倍だった。Valsは追加費用の大部分を、サブエージェントごとに分かれたコンテキスト内のキャッシュ済み入力トークンによるものと説明している。
## この知見をどこまで広げられるか
有意性の区間は50個のアプリ間の差を表しており、同じアプリを繰り返し試した場合のばらつきではない。別の実行では比較が変わる可能性がある。チームの実行には委任の追加指示もあったため、実験が測ったのはチームと指示を組み合わせた設定である。SolはOpenAI Agents API、OpusはClaude Codeを使っており、モデル間のスコア比較には異なるハーネスも混在する。ValsのSol費用推定は、報告されたトークン使用量にサブエージェント分が含まれると仮定している。リクエスト単位の使用量が得られなかったため、長いコンテキストのしきい値を超えるリクエストで料金が高くなる可能性は考慮されていない。
この研究が支えるのは限定的な判断である。これらの設定で似たフルスタックアプリを作る場合、中程度努力のSolチームは費用増と引き換えに測定可能な向上を示した一方、他のチームは信頼できるスコア向上を示さなかった。別のコードベース、モデル、または作業の分割・確認方法が異なるワークフローでもチームに価値があるかは結論づけられない。BIG CHANGEは公開済みのValsの記事と方法を確認したが、ベンチマークを実行または再現したわけではない。
## Sources
- [Vals AI「エージェントチームは費用に見合うか? Vibe Code Benchの事例研究」](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — 元の実験報告。スコア、費用、実行時間、対応検定の区間とp値、チームの動き、実装の詳細、注意点が記事の根拠となっている。8つの設定はそれぞれ50個のアプリで1回ずつ実行され、報告された不確実性はアプリ間の差であり、反復試行の差ではない。
- [Vals AI「Vibe Code Bench v1.1の方法論」](https://www.vals.ai/benchmarks/vibe-code) — リンク先のベンチマークの説明と方法:アプリ仕様、アプリごとに20~60件のUIテスト、採点ルール。一般ランキングは別のハーネス設定を使っており、エージェントチームの事例研究結果の代わりにはならない。
- [The Decoder「AIエージェントチームは膨大なトークンを無駄にし、品質向上はほとんど測れないと研究が指摘」](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — 発見と背景説明に用いた独立した同時期の報道。記事の数値と方法に関する主張はValsの原報告と照合しており、BIG CHANGEは見出しのより広い結論を採用していない。
BIG CHANGEニュースレター
大局を、あなたのペースで。
AI とロボティクスの最新記事、注目すべき変化、活用できる実用的なアイデア。日刊ブリーフィング、週刊ダイジェスト、月刊展望から選べます。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.