AI-translated from English; not yet reviewed by a fluent editor.
# SageMaker 다중 턴 강화학습: 검색팀이 학습 전에 확인할 사항
> AWS는 Qwen3.6-27B 에이전트의 보류된 검색 벤치마크 네 가지 중 세 가지에서 성능이 향상됐다고 보고한다. 이 안내서는 SageMaker 설정과 비용, 시험 전에 필요한 평가를 살펴본다.
By BIG CHANGE Editorial
Published: 2026-10-04T17:55:25.736Z
Updated: 2026-10-04T17:55:25.736Z
Canonical: https://bigchange.ai/blog/fine-tune-search-agent-sagemaker-multi-turn-rl
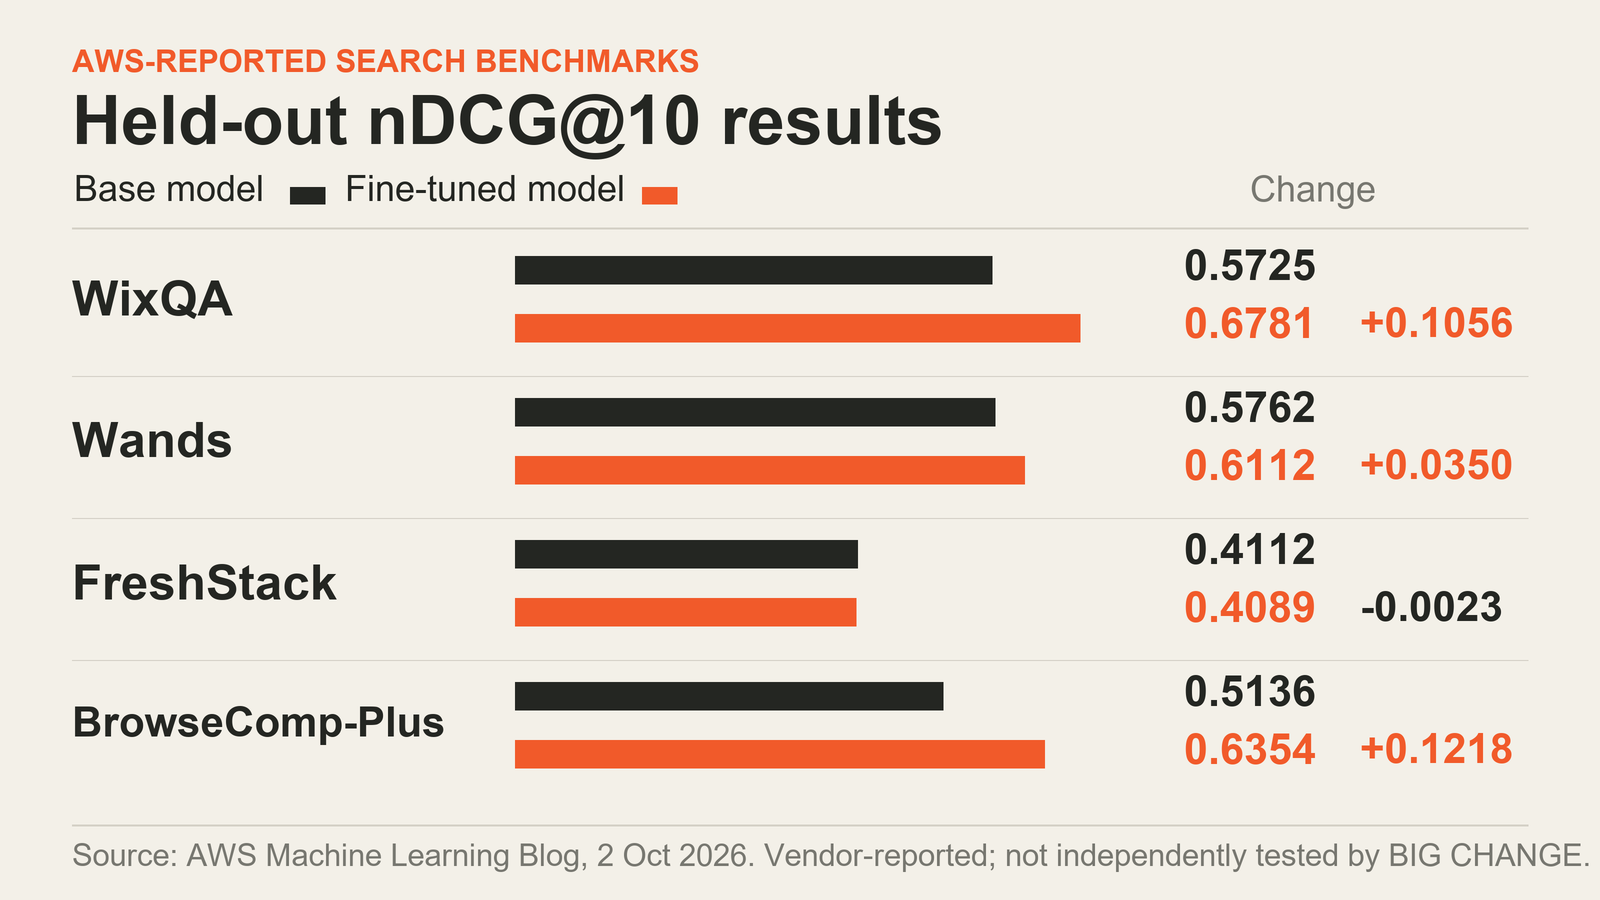
BIG CHANGE graphic; data: AWS Machine Learning Blog
## 큰 변화
AWS는 10월 2일 [워크스루](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/)에서 SageMaker AI의 다중 턴 강화학습(MTRL)으로 Qwen3.6-27B 검색 에이전트를 미세 조정하는 방법을 설명한다. 위 도표는 AWS가 보고한 보류 세트 nDCG@10 점수를 나타낸다. WixQA와 Wands, BrowseComp-Plus에서는 점수가 상승했고 FreshStack에서는 소폭 하락했다. BIG CHANGE는 AWS 수치로 도표를 만들었지만 에이전트를 독립적으로 시험하거나 결과를 재현하지는 않았다. 이 기법은 여러 차례에 걸친 도구 사용 의사결정 결과에 따라 모델을 학습시킨다.
작업을 제출하기 전에 ML 엔지니어는 모델과 리전이 지원되는지, 에이전트가 SageMaker의 롤아웃 절차에 참여할 수 있는지, 프롬프트와 보상이 의도한 검색 과제를 나타내는지, 별도 평가 세트로 성능 회귀를 확인할 수 있는지 검증해야 한다. 이 안내서는 AWS 문서를 바탕으로 작성했으며 BIG CHANGE는 AWS 작업을 실행하거나 API를 호출하지 않았다.
## MTRL이 학습 절차에서 바꾸는 점
지도형 미세 조정에서는 원하는 행동을 보여 주는 예시 궤적이 필요하다. AWS가 설명하는 MTRL에서 SageMaker는 대신 프롬프트를 에이전트에 보낸다. 에이전트는 여러 차례의 대화에 걸쳐 정책 모델과 도구를 호출하고, 롤아웃을 완료한 뒤 보상을 보고한다. 이 피드백을 사용해 모델을 업데이트한다. 검색에서는 최종 순위의 점수를 보상으로 삼을 수 있으므로 초반 검색어 선택을 전체 검색 과정의 결과를 고려해 최적화한다.
도구 호출이 앞선 결과에 의존할 때 이 차이가 중요하다. 모델이 처음에 좋지 않은 검색어를 입력해 결과가 약하다는 사실을 확인하고 검색어를 고쳐야 한다고 하자. 작업 종료 시점의 보상은 그 검색 과정이 결국 관련 문서를 찾았는지를 반영할 수 있다. 그렇다고 ‘관련성’의 의미를 정의하거나 팀의 검색 도구를 호출할 수 있는 에이전트를 만드는 일이 불필요해지는 것은 아니다.
## 먼저 접근 권한과 모델, 리전을 확인한다
10월 2일 사례는 미국 서부(오리건)에서 실행됐고 `us-west-2`에서 Qwen3.6-27B를 미세 조정했다. AWS의 [SageMaker MTRL 지원 모델 표에는](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) 2026년 10월 4일 확인 당시 6개의 모델-리전 조합으로 4개 모델이 등록돼 있었다. Nova Lite 2.0과 GPT-OSS-20B는 미국 동부(버지니아 북부) 리전의 모델로 표시돼 있었고, `us-east-1` 및 미국 서부(오리건) 리전에도 표시돼 있었다. `us-west-2`; Gemma-4-31B-it와 Qwen 3.6 27B는 오리건 리전에만 등록돼 있었다. 작업을 만들려는 리전에서 최신 표를 확인해야 한다. 한 리전에 모델이 등록돼 있다고 해서 다른 지역에서도 사용할 수 있는 것은 아니다.
Studio 인터페이스를 쓴다면 AWS 계정과 SageMaker Studio 도메인도 필요하다. 데이터셋과 출력물을 위한 S3 접근 권한, 새 MTRL 작업과 런타임 호출에 맞게 구성한 IAM 역할도 필요하다. AWS의 사전 요건 문서에 따르면 호출자에게는 `CreateJob` 권한과 관련 작업 권한, 실행 역할을 `job.sagemaker.amazonaws.com`에 전달할 수 있는 권한이 필요하다. 실행 역할에는 `AmazonSageMakerJobFullAccess` 정책과 해당 서비스 주체가 신뢰 정책에 포함돼야 한다. 에이전트 런타임 역할에는 `AmazonSageMakerJobRuntimeAccess`도 필요하다. AgentCore 런타임에는 자체 신뢰 관계도 필요하다. Studio의 런타임 선택기에는 AgentCore 목록 조회 권한이 필요하다. AWS에 따르면 기존의 포괄적인 SageMaker 접근 권한만으로는 새 작업에 필요한 권한을 모두 얻을 수 없다.
문서화된 에이전트 실행 경로는 두 가지다. AWS가 Strands로 만든 에이전트에 적합하다고 설명하는 관리형 호스팅 방식인 Bedrock AgentCore에 배포하거나, 자체 호스팅 에이전트를 Lambda 포워더로 연결할 수 있다. 에이전트는 롤아웃 프롬프트를 받고 SageMaker 작업 런타임을 통해 정책 모델을 호출하며, 검색 도구를 사용하고, 각 롤아웃을 완료한 뒤 보상을 보고한다. AWS SDK 데코레이터가 통합 과정의 상당 부분을 처리하지만, 사용자 지정 프레임워크는 런타임 API를 직접 호출할 수도 있다. Lambda 함수의 이름이 기본값과 다르면 AWS는 해당 ARN을 권한 정책에 명시적으로 추가해야 할 수 있다고 안내한다. 고객 관리형 VPC나 KMS 키를 사용하면 추가 설정이 필요하다.
## 실제 검색 과제에 맞춰 프롬프트와 보상을 준비한다
SageMaker의 자산 안내서는 Parquet와 JSON Lines, JSON, CSV를 입력으로 받는다. 서비스는 `prompt`라는 이름의 열을 찾고, 그 열이 없으면 첫 번째 열을 사용해 값을 그대로 에이전트에 전달한다. 프롬프트 내용은 파싱하거나 검증, 변환하지 않는다. 도구를 사용하는 검색에서는 에이전트가 기대하는 형식에 맞춰 대화 메시지와 과제 메타데이터, 보상 규격, 도구 설정을 프롬프트에 넣을 수 있다. AWS는 프롬프트를 검사 없이 전달한다고 경고한다. 따라서 민감한 데이터를 보호할 책임은 팀에 있으며, 저장소와 에이전트 실행 경로에 암호화 등 적절한 보호 조치를 설계해야 한다.
보상은 모델이 최적화할 목표다. AWS 예시는 최종 검색 문서의 nDCG@10을 사용하고 에이전트가 턴 수나 샘플링 토큰 한도에 도달하면 -1의 보상을 준다. 이는 순위 검색 과제의 구체적인 출발점이지만, 평가 선택이 중요해진다. 팀에는 신뢰할 만한 관련성 라벨이나 방어 가능한 다른 점수 산정 방식이 필요하다. 보상이 순위의 얕은 개선을 부추기면서 답변 품질이나 지연 시간, 도구 비용을 악화시키지 않는지도 확인해야 한다.
블로그 게시물에 따르면 학습 데이터에는 FRAMES와 BRIGHT, Enterprise RAG, ESCI, Musique, MLQA가 포함됐고 각 데이터셋 학습 사례의 5%를 검증용으로 남겼다. 보류 테스트 세트는 FreshStack과 WixQA, BrowseComp-Plus, Wands로 구성됐다. 공개 또는 합성 데이터셋만으로 팀이 실제 서비스할 비공개 문서 모음과 질의 분포를 평가할 수는 없다.
## 작고 점검하기 쉬운 작업을 제출한다
AWS의 [10월 2일 블로그](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/)는 코드 예시에서 다른 SDK 가져오기 경로와 인자 이름을 쓴다. 현행 [SageMaker 학습 작업 참조 문서](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html)는 Bedrock AgentCore 런타임용 API 형태를 다음과 같이 보여 준다. 이 예시는 AWS가 현재 문서화한 GPT-OSS-20B 모델 식별자를 사용한다. 대상 리전에서 사용할 수 있는 모델을 고르고, 예시에 맞춰 수정하기 전에 최신 지원 모델 표를 확인해야 한다. 현행 예시에는 MLflow 앱 ARN과 역할 ARN, EULA 동의도 필요하다.
```python
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer
trainer = MultiTurnRLTrainer(
model="openai-reasoning-gpt-oss-20b",
agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
training_dataset="s3://my-bucket/prompts/prompts.parquet",
mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
s3_output_path="s3://my-bucket/output/",
role="arn:aws:iam::123456789012:role/SageMakerRole",
accept_eula=True,
)
trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
```
이는 현행 AWS 문서 예시이지 BIG CHANGE가 시험한 명령이 아니다. AWS의 10월 2일 블로그는 다른 `sagemaker.modules.train` 가져오기 경로와 `model_id`, `agent_endpoint`, `training_dataset_s3_uri` 및 `output_s3_uri` 인자를 사용한다. 현행 작업 안내와 다르므로 새 구현에는 현재 참조 문서를 따르고, 자체 환경에서 SDK 버전과 모델 요건을 확인해야 한다. 블로그 예시가 이전 SDK 버전인지 문서 간 불일치인지는 확인하지 못했다. Studio UI도 문서화된 제출 경로다. 지원되는 JumpStart 모델을 선택하고 Multi-Turn Reinforcement Learning을 지정한 다음 AgentCore 런타임이나 Lambda 포워더를 설정하고, 학습 데이터를 제공해 제출한다.
첫 실행에서는 모델과 리전, 데이터셋 버전, 보상, 제한값, 하이퍼파라미터, 출력 경로를 기록해 이후 평가를 같은 기준선과 비교할 수 있게 한다. 고객 관리형 VPC를 사용한다면 AWS의 별도 VPC 안내서는 두 가용 영역의 프라이빗 서브넷과 S3 및 CloudWatch Logs용 VPC 엔드포인트, 해당되는 경우 AgentCore 또는 Lambda 엔드포인트를 지정한다. MLflow를 사용하는 경우에도 엔드포인트가 필요하다. 실행 역할에는 ENI 관리 권한이 필요하다. 선택 사항인 고객 관리형 KMS 경로에는 호출자와 실행 역할, 런타임의 추가 권한 및 키 정책 설정이 필요하다. 기본값은 AWS 소유 KMS 키를 사용한 저장 데이터 암호화다. 두 구성을 사용하기 전에 VPC와 암호화 안내서를 확인한다. 제출 전에 계정 할당량도 검토해야 한다. AWS는 기본적으로 동시 MTRL 미세 조정 작업 한 건과 평가 작업 한 건을 허용하며 Service Quotas를 통해 둘 다 조정할 수 있다고 안내한다. 작업 관리 API의 요청 제한은 조정할 수 없다.
## 배포 전에 보류 프롬프트로 평가한다
AWS 평가 문서는 평가 프롬프트를 학습 데이터에서 제외하고, 같은 프롬프트 형식을 사용하며, 중요한 도구와 도구 조합을 다루고, 이전에 실패한 사례를 포함하며, 민감한 내용을 보호하라고 안내한다. SageMaker 평가기는 프롬프트 세트로 후보 모델을 실행하고 보상과 pass@k, 궤적 지표를 보고할 수 있다. 문서에는 미세 조정한 모델을 평가하고, 같은 비교 절차에서 기본 모델도 선택적으로 평가하는 방법이 나와 있다.
학습 전에 평가 절차를 정한다. 실제 에이전트가 마주할 질의와 권한, 문서 변경을 대표하는 고정된 보류 세트를 유지한다. 기본 모델과 미세 조정 모델을 같은 도구와 제한, 점수 산정 코드로 비교한다. 평균 검색 점수만 보지 말고 작업 실패와 턴 수, 지연 시간, 토큰 사용량, 관련 문서가 상위 순위에서 사라지는 사례도 점검한다. 문서는 AWS 평가 작업을 제출하는 방법을 설명하지만 어느 하나의 지표만으로 실제 서비스의 검색 품질을 포착할 수 있다고 입증하지는 않는다.
AWS 게시물은 다음과 같은 보류 세트 결과를 보고한다.
| 데이터셋(질문 수) | 기준 모델 nDCG@10 | 미세 조정 모델 nDCG@10 | 기준 모델 실패율 | 미세 조정 모델 실패율 |
| --- | --- | --- | --- | --- |
| WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
| Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
| FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
| BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
표를 보면 nDCG@10은 세 데이터셋에서 상승했고 FreshStack에서는 소폭 하락했다. AWS는 BrowseComp-Plus의 낮은 실패율을 턴 수 또는 토큰 한도 초과에 대한 페널티로 설명한다. 블로그는 이 수치에 신뢰 구간이나 통계적 유의성 분석을 덧붙이지 않는다. 또한 미세 조정 모델의 평균 턴 수는 WixQA에서 4.5회 대 4.3회, Wands에서 2.9회 대 2.2회였다고 보고한다. 따라서 턴 수 감소가 모든 데이터셋에서 나타난 것은 아니다. 이는 공급사가 보고한 실험이지 독립적인 검증이나 다른 문서 모음에서도 개선될 것이라는 증거가 아니다.
## 전체 시험 비용을 예산에 포함한다
AWS의 MTRL 문서에는 학습 비용의 세 가지 항목이 나온다. 입력으로 처리한 프리필 토큰과 롤아웃 중 생성된 샘플링 토큰, 학습 업데이트다. 가격 페이지에는 모델별 요금이 제시돼 있다. 이 요금과 롤아웃 양, 시퀀스 길이, 에포크, 런타임이 합쳐져 예상 비용을 결정한다. 사례 글은 총 청구액을 공개하지 않으며 문서도 보편적인 시험 가격을 제시하지 않는다. 선택한 모델과 리전의 현행 요금을 확인하고 고정 비용을 가정하는 대신 예상 작업 사용량을 바탕으로 추정해야 한다.
예산에는 연관 비용도 포함한다. 학습과 검증, 체크포인트, 출력 아티팩트를 위한 S3 저장 공간과 요청 비용, 롤아웃 중 사용하는 AgentCore 런타임이나 Lambda 및 검색 기반 시설, 로깅과 MLflow, 보류 세트 평가, 학습 후 사용하는 엔드포인트 또는 Bedrock 배포 비용이다. AWS 게시물은 계속 과금되지 않도록 실행 중인 MTRL 작업을 중단하거나 삭제하고, 필요하지 않은 S3 모델 아티팩트를 지우며, 평가 엔드포인트를 제거하라고 특별히 권한다. 엔드포인트 배포는 학습과 별개의 결정이며 별도 비용 항목이다.
## 진행할지 결정한다
검색 과제에 서로 의존하는 여러 도구 호출이 필요하고 팀이 최종 결과에 점수를 매길 수 있다면 이 작업 흐름이 특히 관련 있다. 시험 결과가 의사결정에 도움이 되려면 모델-리전 조합이 지원되고 에이전트 통합이 작동해야 한다. 대표성 있는 프롬프트 데이터와 과제를 반영하는 보상, 보류 세트 비교, 주변 서비스까지 포함한 비용 추정도 필요하다. AWS의 벤치마크 네 가지에서 좋은 결과가 나온 것은 방법을 검토할 이유이지 다른 인덱스나 질의 구성, 권한 경계에서도 같은 효과가 날 것이라고 가정할 근거는 아니다.
**출처 및 더 읽을거리**
- [AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (2026년 10월 2일)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — 공급사가 제공한 사용 안내와 설정, 데이터셋 선택, 보고된 평가 결과다.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — 현재 지원되는 모델과 리전, 과금 항목을 설명한다.
- [사전 요건](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html), [에이전트 준비](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-agent.html), [VPC 구성](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-vpc.html) 및 [저장 데이터 암호화](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-encryption-at-rest.html) — 권한과 런타임 선택, 통합, 선택적 네트워크 및 암호화 설정을 다룬다.
- [자산 생성](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html), [학습 작업 제출](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html), [평가](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-evaluation.html), [하이퍼파라미터](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-hyperparams.html) 및 [할당량](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-quotas.html) — 현행 구현 안내 문서다.
- [SageMaker AI 요금](https://aws.amazon.com/sagemaker/ai/pricing/) — 현재 모델 사용자 지정 요금 정보다. 요금은 모델과 리전에 따라 달라지며 변경될 수 있다.
*보고 관련 고지: 문서 검토만 수행했다. BIG CHANGE는 AWS 계정에 접근하거나 SageMaker 작업을 제출 또는 점검하고, AWS API를 호출하거나 보고된 지표를 독립적으로 재현하지 않았다. 구현 안내서는 AWS가 작성했고 실험 결과도 AWS가 보고했다.*
## Sources
- [AWS Machine Learning Blog: Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI (2026년 10월 2일)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — AWS가 제공한 구현 안내와 데이터셋 선택, 공급사 자체 보류 평가 결과다.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — 현재 모델 및 리전 조합과 작업 흐름, 학습 과금 항목을 설명한다.
- [Amazon SageMaker AI MTRL 사전 요건 및 에이전트 설정](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html) — 필요한 권한과 런타임 선택, 에이전트 통합, 선택적 네트워크 및 암호화 구성을 설명한다.
- [Amazon SageMaker AI MTRL 학습 및 평가 문서](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html) — 현재 데이터 입력과 작업 흐름을 다룬다. 이 기사에서는 학습 작업과 평가 참조 자료도 링크한다.
- [Amazon SageMaker AI MTRL 학습 작업 제출](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) — 현행 Python SDK 가져오기 경로와 인자 이름, AgentCore 예시, Studio 제출 절차를 설명한다. 2026년 10월 4일 확인했다.
- [Amazon SageMaker AI 요금](https://aws.amazon.com/sagemaker/ai/pricing/) — 현재 모델별 요금 정보다. 요금은 모델과 리전에 따라 달라진다.
BIG CHANGE 뉴스레터
큰 그림을 나만의 속도로.
AI와 로봇공학에 관한 최신 기사, 주목할 변화, 활용할 수 있는 실용적인 아이디어입니다. 일일 브리핑, 주간 다이제스트 또는 월간 전망을 선택하세요.
베오그라드 시간 09:00에 발송: 매일, 월요일 또는 매월 1일. 확인 후 다음 예정된 발송 시 첫 호가 도착합니다.
개인정보는 이용자가 선택합니다.
필수 저장소는 사이트 보안을 지원하고 선택 사항을 기억합니다. 선택 사항인 Google Analytics는 허용하기 전까지 꺼져 있습니다. 필수 저장 기능만 사용해 모든 기사를 읽을 수 있습니다. 개인정보 보호 세부 정보