AI-translated from English; not yet reviewed by a fluent editor.
# Claude voltou. Sua empresa ainda precisa de um plano de recuperação
> A interrupção do Claude em 22 de setembro já foi resolvida. Este guia prático explica como empresas podem manter um serviço limitado, preservar o trabalho inacabado e recuperar sua própria fila após uma falha de IA.
By BIG CHANGE Editorial
Published: 2026-09-22T08:51:37.833Z
Updated: 2026-09-22T08:51:37.833Z
Canonical: https://bigchange.ai/blog/claude-outage-ai-business-continuity
AI-generated conceptual illustration by BIG CHANGE. When an AI service pauses, a business still needs accessible records of unfinished work. The bookmarked ledger represents preserving the stopping place. Conceptual illustration, not evidence of damaged equipment or lost data.
Em 22 de setembro, o Claude apresentou aumento de erros em vários modelos. A atualização final do incidente publicada pela Anthropic informa que o período de impacto foi das 00h50 às 02h10 UTC, ou 80 minutos. A empresa marcou o incidente como resolvido às 02h35 UTC. Entre os componentes afetados estavam claude.ai, a API, Code e Cowork. O registro não diz que todas as solicitações falharam e não traz uma explicação pública da causa raiz. [Registro de incidentes da Anthropic](https://status.claude.com/incidents/7g1qpkyz5gxh)
Para uma empresa que usa IA em um processo de trabalho, a restauração do serviço resolve apenas parte do problema. Ainda pode haver solicitações de clientes aguardando. Alguém talvez tenha começado a tratar um caso manualmente enquanto uma tentativa automatizada continuava ativa. Um supervisor precisa saber quais tarefas podem ser retomadas e quais devem ser verificadas primeiro.
Quando ajuda alguém a pensar em ideias, um assistente indisponível de vez em quando é apenas inconveniente. Mas, se o mesmo serviço ajuda a classificar casos recebidos, redigir respostas e atualizar registros, a interrupção vira um problema operacional. A preparação útil é um pequeno plano de continuidade que a equipe possa seguir sem acesso ao próprio serviço de IA.
Este guia usa uma central de atendimento hipotética para mostrar como esse plano poderia funcionar. Os procedimentos são propostas a adaptar e ensaiar; não são um teste realizado pela BIG CHANGE nem uma descrição de clientes afetados por este incidente.
## Escolha o serviço que você consegue manter sem IA
Imagine um pequeno fornecedor de equipamentos cujo assistente categoriza mensagens de suporte recebidas e prepara respostas com base em informações aprovadas sobre os produtos. A equipe revisa as respostas antes de enviá-las. A empresa depende do sistema para organizar a fila, embora as pessoas continuem responsáveis pelas respostas.
Se o assistente parar de responder, a primeira decisão do gestor é o que a central ainda pode prometer. A equipe talvez continue confirmando o recebimento das solicitações e tratando casos com prazos iminentes, enquanto adia explicações rotineiras sobre produtos. Ela precisa ter acesso às mensagens originais e aos materiais de referência aprovados fora do assistente. Caso contrário, “passem a fazer manualmente” é uma instrução sem os meios para executá-la.
Defina esse serviço reduzido com antecedência. Determine quem pode ativá-lo, quais tarefas devem ser pausadas e quem cobrirá as tarefas restantes. Marque um horário para reavaliar a situação, evitando que um arranjo temporário se estenda pela tarde sem nova avaliação. Os avisos aos clientes devem explicar o atraso e o canal disponível para pedidos urgentes, com promessas que a equipe possa cumprir.
As orientações de engenharia do Google sobre sobrecarga descrevem como oferecer funcionalidades reduzidas, limitar o tráfego e priorizar solicitações importantes quando os recursos são escassos. Essas são técnicas conhecidas de confiabilidade, não um diagnóstico deste incidente do Claude. Aplicadas a uma central de atendimento, elas apoiam uma redução deliberada do escopo quando o processamento normal não pode continuar. [Google SRE: como lidar com sobrecarga](https://sre.google/sre-book/handling-overload/)
O serviço reduzido também precisa de um limite de capacidade. Duas pessoas não podem absorver silenciosamente o volume de trabalho de um sistema automatizado que normalmente atende a muito mais solicitações. Registre o que elas conseguem tratar, o que ficará aguardando e quando será necessário pedir ajuda adicional. Os clientes se beneficiam mais de um prazo de resposta realista do que de uma confirmação automática que sugira que o serviço continua normal.
## Mantenha um registro do trabalho fora da conversa
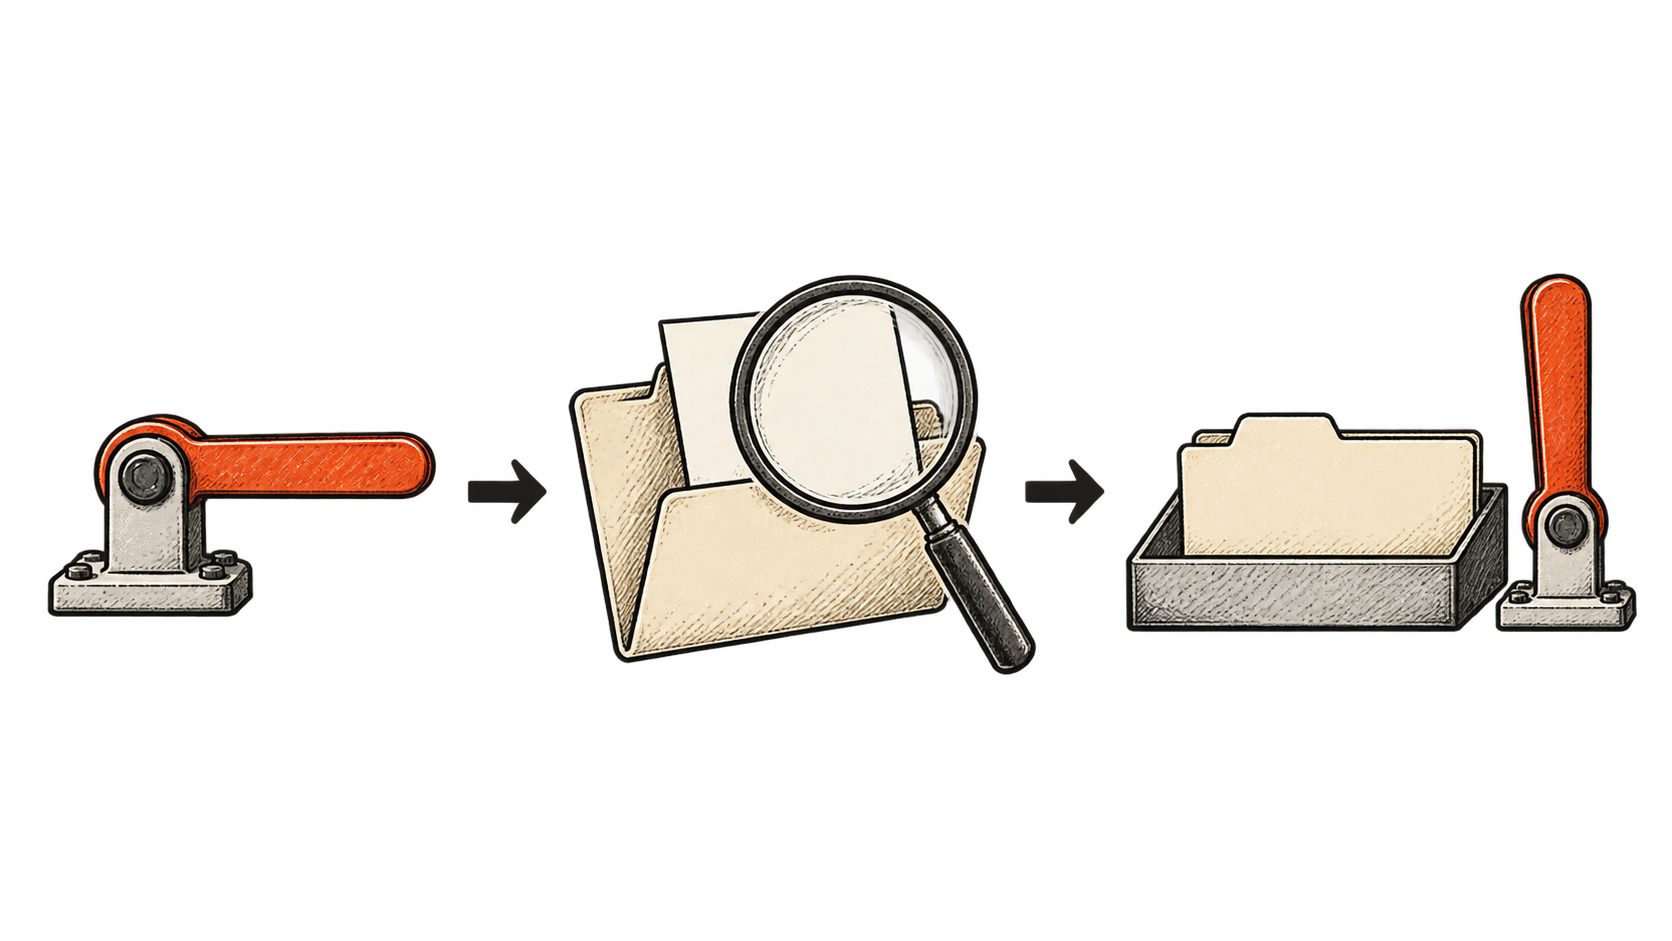
A central de atendimento precisa de um registro de casos que possa consultar enquanto o modelo estiver indisponível. Pode ser o sistema de suporte que já utiliza. O essencial é que a empresa consiga estabelecer o que aconteceu sem pedir ao assistente interrompido que reconstrua os fatos.
Para cada caso, preserve a solicitação original, a pessoa ou o processo responsável e a última ação confirmada. Um rascunho salvo é diferente de uma resposta enviada. Uma alteração proposta a um cadastro de cliente é diferente de uma alteração confirmada pelo sistema. Guarde as evidências necessárias para distinguir uma coisa da outra, aplicando as mesmas restrições de acesso exigidas pelas informações subjacentes do cliente.
Durante uma interrupção, organize o trabalho nestas categorias práticas:
- Pronto para começar: nenhum processamento ou ação externa foi iniciado.
- Parcialmente preparado: já existe uma classificação ou um rascunho, mas a próxima etapa está pendente.
- Concluído e confirmado: o sistema de destino registra a ação pretendida.
- Incerto: houve uma tentativa de ação, mas falta a confirmação.
Encaminhe casos incertos a alguém que possa inspecionar o sistema relevante antes de retomá-los. Se o assistente preparava uma resposta quando a conexão caiu, criar outro rascunho pode ser inofensivo. Mas, se uma ferramenta separada estava enviando a resposta, repetir a tarefa inteira pode enviá-la duas vezes. Essa distinção deve constar no registro do fluxo de trabalho.
A documentação da API da Anthropic informa que uma resposta em streaming pode falhar mesmo depois de uma resposta HTTP 200 inicial. Ver o primeiro texto aparecer ou receber esse status inicial não confirma que a resposta completa chegou. Exija que a integração reconheça a conclusão e mantenha o trabalho parcial identificado como parcial. [Documentação de erros da API Claude](https://platform.claude.com/docs/en/api/errors)
## Defina um limite para as novas tentativas e um responsável
Uma nova tentativa pode resolver uma falha temporária. Também pode prolongar a incerteza se cada camada repetir o mesmo trabalho de forma independente. Pergunte ao fornecedor do software se já ocorrem novas tentativas na biblioteca cliente antes de adicionar outro botão de repetição ou ciclo automatizado.
A Anthropic documenta duas novas tentativas automáticas por padrão para falhas transitórias nos SDKs oficiais, com intervalos crescentes e respeito a uma instrução retry-after, quando presente. A documentação de erros também distingue problemas temporários do servidor de falhas de autenticação, permissão e solicitações malformadas. Não se pode presumir que repetir a mesma solicitação resolva todas as categorias. [Comportamento documentado de novas tentativas no Claude](https://platform.claude.com/docs/en/api/errors)
Na central de atendimento, a regra operacional deve especificar quando as tentativas automáticas param e quem recebe o caso depois disso. Preserve o identificador da solicitação para facilitar a investigação. Deixe a equipe ver se uma tarefa está aguardando, em nova tentativa ou à espera de uma pessoa, para que ninguém inicie tentativas concorrentes sem perceber.
A AWS explica que uma ação pode ser concluída mesmo quando a resposta correspondente nunca chega. Suas APIs idempotentes usam um identificador explícito de solicitação para reconhecer repetições e impedir efeitos colaterais adicionais. O serviço que recebe a solicitação precisa garantir esse contrato; simplesmente acrescentar um número interno de caso não oferece essa proteção. [AWS sobre como tornar seguras as novas tentativas](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/)
Pergunte especificamente sobre as ações executadas pelo seu fluxo de trabalho. Uma nova tentativa pode criar outro chamado de suporte ou enviar mais um e-mail? Se não houver prevenção contra duplicatas, o plano precisa incluir a verificação do registro de destino antes de uma nova tentativa. Repetir a geração de um texto e repetir um processo empresarial inteiro são decisões diferentes.
## Um modelo alternativo precisa de uma função mais restrita
Um serviço de IA alternativo pode ajudar a manter o trabalho em andamento, mas uma segunda conta é só o começo de um plano de contingência. O substituto precisa das instruções certas, dos materiais de referência aprovados e de permissão para lidar com os dados. Também precisa ter capacidade disponível quando a empresa recorrer a ele.
Escolha uma tarefa de contingência bem delimitada antes de tentar substituir tudo. Na nossa central hipotética, outro modelo poderia classificar mensagens rotineiras enquanto a equipe trata das respostas aos clientes. A equipe poderia avaliá-lo com casos representativos, incluindo nomes de produtos ambíguos e solicitações que precisam ser encaminhadas a uma pessoa. Uma resposta fluente, por si só, não demonstraria que o modelo seguiu as regras de suporte da empresa.
Antes de qualquer incidente, decida quais informações podem ser enviadas ao serviço alternativo. A equipe não deve improvisar colando cadastros de clientes em contas pessoais. Como parte da contratação, confira as condições de tratamento de dados e as formas de acesso do substituto, além da qualidade e do preço das respostas.
Nomes diferentes de modelos também não comprovam disponibilidade independente. Um serviço de backup ainda pode depender do mesmo login, da mesma conexão de rede, do mesmo repositório de documentos ou do mesmo software de orquestração. Mapeie as dependências que a alternativa proposta realmente elimina. Esse exercício pode revelar que uma fila manual com documentos de referência acessíveis oferece uma proteção mais útil do que outro modelo conectado à mesma rede que falha.
Alternativas exigem manutenção à medida que as instruções mudam e o conhecimento sobre produtos envelhece. A equipe precisa praticar procedimentos que raramente usa. Uma pequena empresa pode optar, de forma razoável, por manter um serviço manual mais lento em vez de pagar para duplicar toda a operação. A escolha deve levar em conta o custo de atrasar o trabalho e o dano causado por uma resposta incorreta.
## Retome o trabalho com uma fila revisada
Quando o provedor informar que o serviço foi restaurado, teste uma pequena amostra do seu próprio fluxo de trabalho antes de reabrir o processamento normal. Inclua um caso que exija a consulta a documentos e a atualização de registros necessárias para a empresa. Uma resposta bem-sucedida do modelo não comprova que todos os sistemas conectados estejam prontos.
Em seguida, examine o trabalho que ficou aguardando. Remova os casos já tratados manualmente, verifique as ações incertas e identifique solicitações cujas circunstâncias mudaram. Um cliente pode ter fornecido informações novas durante a interrupção. Gerar uma resposta com base em uma versão anterior do caso pode criar um novo problema depois que a falha técnica terminar.
Libere o trabalho restante em lotes controlados. Reserve capacidade para novas solicitações urgentes e acompanhe se a fila está diminuindo. Se a demanda recebida ocupar toda a capacidade disponível de processamento, o acúmulo persistirá mesmo que cada nova tentativa seja bem-sucedida. Para colocar tudo em dia, talvez seja necessário aumentar a equipe, reduzir temporariamente o serviço ou comunicar com honestidade prazos de resposta mais longos.
Como exemplo numérico separado, suponha que cheguem 24 casos por hora e o processamento pare por 30 minutos. Isso deixa 12 casos aguardando. Se, em seguida, a central tratar 36 por hora enquanto continuam chegando 24 casos novos, levará uma hora para eliminar o acúmulo. São hipóteses ilustrativas, não medições do incidente do Claude.
As orientações do Google sobre objetivos de nível de serviço começam pelo resultado que importa aos usuários e pelas dependências necessárias para alcançá-lo. Para essa central, uma medida útil poderia ser a proporção de casos urgentes que recebem uma resposta adequada dentro do prazo prometido. A disponibilidade do provedor é relevante, mas a empresa também precisa saber se os clientes receberam o serviço. [Google SRE: implementação de objetivos de nível de serviço](https://sre.google/workbook/implementing-slos/)
Registre quando o atendimento normal aos clientes foi retomado, quantos casos continuavam sem resolução e quais correções foram necessárias depois. Essas medidas revelam o trabalho de recuperação que a página de status do provedor não consegue observar.
## Ensaie uma interrupção antes de ampliar a automação
Um breve exercício de mesa pode revelar falhas de acesso ou de responsabilidade sem prejudicar clientes reais. Use alguns casos fictícios de suporte e percorra esta sequência:
1. Suponha que o modelo fique indisponível no meio da preparação de uma resposta. Pergunte quem ativa o serviço reduzido e onde a equipe encontra a solicitação original.
2. Inclua um caso com resposta comprovadamente enviada e outro com tentativa de envio incerta. Verifique se a equipe sabe qual sistema permite estabelecer o resultado.
3. Suponha que o provedor tenha se recuperado, mas novas solicitações continuem chegando. Decida qual trabalho será retomado primeiro e como os casos concluídos manualmente sairão da fila.
4. Peça a alguém que não escreveu o plano para explicar o procedimento e identificar de quais permissões ou registros essa pessoa não dispõe.
Anote o que o exercício não conseguiu esclarecer. As correções resultantes podem ser modestas: acesso a uma fila existente, um controle claro para pausar o sistema, uma confirmação salva ou a designação de um responsável pela recuperação. Nenhuma delas garante a continuidade do serviço. Cada uma pode ajudar a conter uma interrupção sem abrir mão dos benefícios da automação.
Antes de dar outra responsabilidade operacional a um assistente, peça a um colega que mostre como ela seria tratada durante uma interrupção. Se a resposta depender de o assistente indisponível lembrar o que estava fazendo, ainda há trabalho a fazer no plano de continuidade.
## Sources
- [Status do Claude: erros elevados em vários modelos](https://status.claude.com/incidents/7g1qpkyz5gxh) — O registro de incidentes do provedor informa um período de impacto de 80 minutos e um horário posterior para a resolução. O JSON público foi consultado de forma independente. O registro relata erros elevados, não uma falha universal, e não apresenta uma análise pública da causa raiz.
- [Plataforma Claude: erros da API](https://platform.claude.com/docs/en/api/errors) — A documentação atual aborda erros, as novas tentativas padrão dos SDKs e falhas ocorridas após o início de uma transmissão. Esses mecanismos não comprovam a conclusão de uma tarefa empresarial nem impedem ações duplicadas em ferramentas conectadas.
- [Biblioteca AWS Builders’: como tornar seguras as novas tentativas com APIs idempotentes](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/) — A explicação de Malcolm Featonby sobre respostas incertas e prevenção de duplicatas. O contrato da API precisa ser implementado pelo serviço que recebe a solicitação; um identificador, por si só, não basta.
- [Google SRE: como lidar com sobrecarga](https://sre.google/sre-book/handling-overload/) — Orientações de engenharia consolidadas sobre funcionalidades reduzidas, prioridades e novas tentativas limitadas. O artigo adapta esses princípios a uma central de atendimento hipotética; eles não diagnosticam a causa do incidente da Anthropic.
- [Google SRE Workbook: implementação de SLOs](https://sre.google/workbook/implementing-slos/) — Explica objetivos de confiabilidade baseados nos resultados para usuários e em dependências essenciais. A medida de atendimento ao cliente e o exemplo de acúmulo propostos são aplicações ilustrativas, não resultados observados nem uma meta universal.
Newsletter da BIG CHANGE
A visão ampla, no seu ritmo.
Matérias recentes sobre IA e robótica, mudanças que merecem atenção e ideias práticas para usar. Escolha um briefing diário, um resumo semanal ou uma perspectiva mensal.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Sua privacidade, sua escolha.
O armazenamento necessário ajuda a proteger o site e a lembrar suas escolhas. O Google Analytics opcional permanece desativado até você autorizá-lo. Você pode ler todas as matérias usando apenas o armazenamento necessário. Detalhes de privacidade