AI-translated from English; not yet reviewed by a fluent editor.
# RL em múltiplas etapas no SageMaker: o que uma equipe de busca deve verificar antes do treinamento
> A AWS relata ganhos em três de quatro benchmarks de busca retidos para seu agente Qwen3.6-27B. Este guia apresenta a configuração do SageMaker, os custos e a avaliação necessários antes de um teste.
By BIG CHANGE Editorial
Published: 2026-10-04T17:55:25.736Z
Updated: 2026-10-04T17:55:25.736Z
Canonical: https://bigchange.ai/blog/fine-tune-search-agent-sagemaker-multi-turn-rl
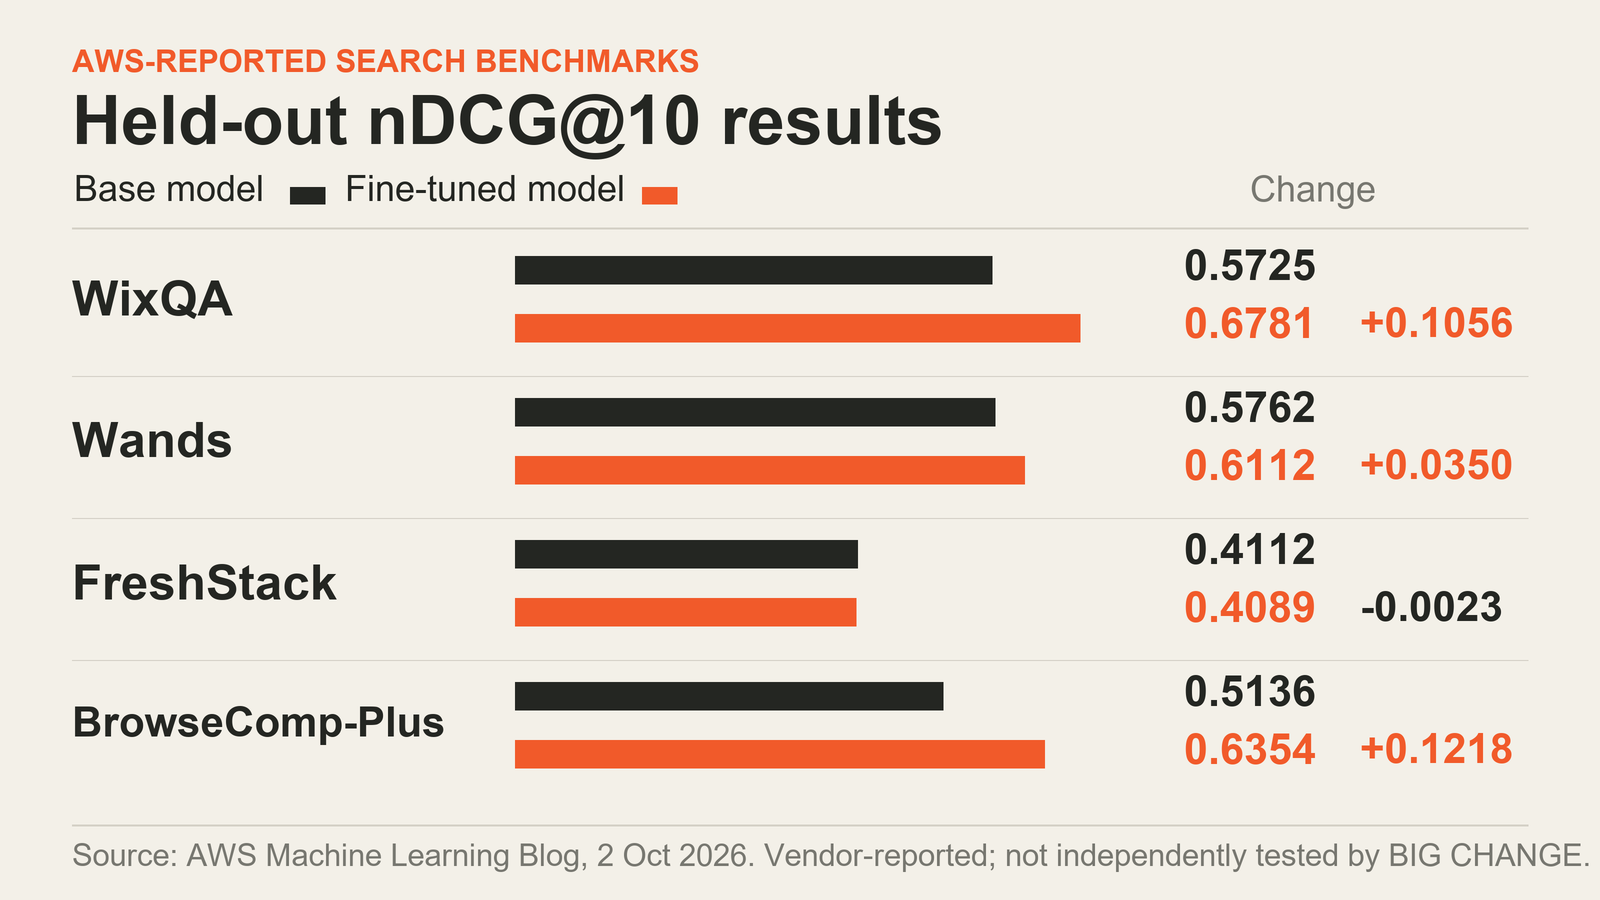
BIG CHANGE graphic; data: AWS Machine Learning Blog
## A grande mudança
Em seu [guia de 2 de outubro](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/), a AWS descreve o ajuste fino de um agente de busca Qwen3.6-27B com aprendizado por reforço em múltiplas etapas (MTRL) no SageMaker AI. O gráfico acima mostra as pontuações nDCG@10 relatadas pela AWS em conjuntos de teste retidos: elas aumentaram no WixQA, no Wands e no BrowseComp-Plus e caíram ligeiramente no FreshStack. A BIG CHANGE criou o gráfico com base nos números da AWS; não testamos o agente de forma independente nem reproduzimos os resultados. A técnica treina um modelo com base no resultado de uma sequência de decisões que usam ferramentas.
Antes de enviar um trabalho, uma pessoa de engenharia de machine learning precisa confirmar que o modelo e a região são compatíveis, que o agente pode participar do ciclo de execução do SageMaker, que os prompts e as recompensas representam a tarefa de busca pretendida e que um conjunto de avaliação separado consegue revelar regressões. Este guia se baseia na documentação da AWS; a BIG CHANGE não executou um trabalho na AWS nem chamou suas APIs.
## O que o MTRL muda no ciclo de treinamento
No ajuste fino supervisionado, a equipe precisa de trajetórias de exemplo que mostrem o comportamento desejado. Na descrição da AWS sobre o MTRL, o SageMaker, em vez disso, envia prompts a um agente; ao longo de várias etapas, o agente chama o modelo de política e suas ferramentas e, ao concluir a execução, informa uma recompensa. O modelo é atualizado com esse feedback. Em uma tarefa de busca, a recompensa pode avaliar a classificação final, de modo que as primeiras escolhas de consulta sejam otimizadas no contexto de toda a sessão de busca.
Essa diferença importa quando as chamadas às ferramentas dependem de resultados anteriores. Se o modelo faz uma consulta inicial ruim, recebe resultados fracos e precisa reformulá-la, uma recompensa ao fim da tarefa pode refletir se a sequência acabou recuperando documentos relevantes. Isso não elimina a necessidade de definir o que significa ‘relevante’ nem de criar um agente capaz de chamar as ferramentas de busca da equipe.
## Verifique primeiro o acesso, o modelo e a região
O exemplo de 2 de outubro foi executado na região US West (Oregon), `us-west-2`, e ajustou o Qwen3.6-27B. A [tabela de modelos compatíveis com o MTRL do SageMaker](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html), consultada em 4 de outubro de 2026, lista quatro modelos em seis combinações de modelo e região: Nova Lite 2.0 e GPT-OSS-20B em US East (N. Virginia), `us-east-1`, e US West (Oregon), `us-west-2`; Gemma-4-31B-it e Qwen 3.6 27B são compatíveis apenas no Oregon. Consulte a tabela atualizada na região em que pretende criar o trabalho; a presença de um modelo na lista não comprova que ele esteja disponível em outras regiões.
A equipe também precisa de uma conta AWS e de um domínio do SageMaker Studio, caso use a interface do Studio, além de acesso ao S3 para conjuntos de dados e resultados e funções do IAM configuradas para o novo trabalho MTRL e as chamadas ao ambiente de execução. O documento de pré-requisitos da AWS diz que quem faz a chamada precisa de `CreateJob` e das ações relacionadas ao trabalho, além de permissão para passar a função de execução a `job.sagemaker.amazonaws.com`. A função de execução precisa da política `AmazonSageMakerJobFullAccess` e desse principal de serviço em sua política de confiança. A função do ambiente de execução do agente precisa de `AmazonSageMakerJobRuntimeAccess`; um ambiente AgentCore também precisa de sua própria relação de confiança. O seletor de ambientes de execução do Studio requer permissão para listar o AgentCore. Segundo a AWS, o acesso amplo ao SageMaker que a equipe já possui não inclui, por si só, todas essas novas ações de trabalho.
A documentação descreve dois caminhos para o agente. Faça o deploy no Bedrock AgentCore para usar hospedagem gerenciada, opção que, segundo a AWS, funciona melhor com agentes criados usando Strands; ou hospede um agente personalizado e conecte-o por meio de um encaminhador Lambda. O agente recebe prompts de execução, chama o modelo de política pelo ambiente de execução do trabalho do SageMaker, aciona suas ferramentas de busca, conclui cada execução e informa uma recompensa. O decorator do SDK da AWS cuida de grande parte dessa integração; frameworks personalizados podem chamar diretamente as APIs do ambiente de execução. Se a função Lambda tiver um nome fora do padrão, a AWS diz que talvez seja necessário incluir seu ARN explicitamente na política de permissões. Uma VPC ou chave KMS gerenciada pelo cliente acrescenta requisitos de configuração.
## Prepare os prompts e a recompensa para a tarefa de busca real
O guia de assets do SageMaker aceita Parquet, JSON Lines, JSON ou CSV. Ele procura uma coluna chamada `prompt`; se ela não existir, usa a primeira coluna e passa seu valor ao agente sem alterações. O serviço não analisa, valida nem transforma o conteúdo do prompt. Em uma busca que usa ferramentas, o prompt pode incluir mensagens da conversa, metadados da tarefa, uma especificação de recompensa e a configuração das ferramentas no formato esperado pelo agente. A AWS alerta que os prompts são encaminhados sem inspeção; portanto, a equipe continua responsável por proteger dados sensíveis. Planeje criptografia ou outra proteção adequada para o armazenamento e para o caminho até o agente.
A recompensa é o objetivo que o modelo vai otimizar. O exemplo da AWS usa nDCG@10 nos documentos recuperados ao final e atribui uma recompensa de -1 quando o agente atinge o limite de etapas ou de tokens de amostragem. É um ponto de partida concreto para uma tarefa de recuperação ranqueada, mas torna importantes as escolhas de avaliação: a equipe precisa de rótulos confiáveis de relevância ou de outro método defensável de pontuação. Também deve verificar se a recompensa não favorece ganhos superficiais na classificação em detrimento da qualidade das respostas, da latência ou do custo das ferramentas.
A publicação diz que a mistura de treinamento incluiu FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique e MLQA, com cinco por cento das instâncias de cada conjunto reservadas para validação. O conjunto de teste retido foi composto por FreshStack, WixQA, BrowseComp-Plus e Wands. Esses conjuntos públicos ou sintéticos não substituem a avaliação no corpus privado e na distribuição de consultas que a equipe pretende atender.
## Envie um trabalho pequeno e fácil de inspecionar
O [artigo da AWS de 2 de outubro](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) usa uma importação do SDK e nomes de argumentos diferentes no trecho de código. A referência atual do [trabalho de treinamento do SageMaker](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) mostra o seguinte formato de API para um ambiente de execução Bedrock AgentCore. Este exemplo usa o identificador atual do modelo GPT-OSS-20B documentado pela AWS. Escolha um modelo disponível na região desejada e consulte a tabela atual de modelos compatíveis antes de adaptar o exemplo. O exemplo atual também exige um ARN de app do MLflow, um ARN de função e a aceitação do EULA.
```python
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer
trainer = MultiTurnRLTrainer(
model="openai-reasoning-gpt-oss-20b",
agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
training_dataset="s3://my-bucket/prompts/prompts.parquet",
mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
s3_output_path="s3://my-bucket/output/",
role="arn:aws:iam::123456789012:role/SageMakerRole",
accept_eula=True,
)
trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
```
Este é um exemplo da documentação atual da AWS, não um comando testado pela BIG CHANGE. A publicação da AWS de 2 de outubro apresenta uma `sagemaker.modules.train` importação, `model_id`, `agent_endpoint`, `training_dataset_s3_uri` e `output_s3_uri` com argumentos diferentes. Como eles divergem do guia atual do trabalho, siga a referência atual em novas implementações e confira a versão do SDK e os requisitos do modelo em seu próprio ambiente; não determinamos se o exemplo do blog reflete uma versão anterior do SDK ou uma inconsistência na documentação. A interface do Studio é outra forma de envio documentada: escolha um modelo JumpStart compatível, selecione Multi-Turn Reinforcement Learning, configure o ambiente de execução AgentCore ou o encaminhador Lambda, informe os dados de treinamento e envie o trabalho.
Na primeira execução, registre o modelo, a região, a versão do conjunto de dados, a recompensa, os limites, os hiperparâmetros e o caminho de saída para que uma avaliação posterior possa ser comparada com a mesma referência. Se usar uma VPC gerenciada pelo cliente, o guia separado da AWS exige sub-redes privadas em duas zonas de disponibilidade, endpoints de VPC para S3 e CloudWatch Logs e, quando aplicável, um endpoint do AgentCore ou do Lambda; o MLflow também precisa de um endpoint, se for usado. A função de execução precisa de permissões para gerenciar ENIs. O caminho opcional com KMS gerenciado pelo cliente exige permissões adicionais e a configuração da política da chave para quem faz a chamada, para a função de execução e para o ambiente de execução; por padrão, os dados em repouso são criptografados com uma chave KMS de propriedade da AWS. Consulte os guias de VPC e criptografia antes de usar qualquer uma dessas configurações. Antes do envio, verifique as cotas da conta: por padrão, a AWS lista um trabalho MTRL de ajuste fino simultâneo e um trabalho de avaliação simultâneo; ambos podem ser alterados pelo Service Quotas. Os limites de throttling das APIs de gerenciamento de trabalhos não podem ser alterados.
## Avalie com prompts retidos antes do deploy
A documentação de avaliação da AWS recomenda manter os prompts de avaliação fora do treinamento, usar o mesmo formato de prompt, cobrir ferramentas importantes e suas combinações, incluir casos que falharam anteriormente e proteger conteúdo sensível. O avaliador do SageMaker pode executar um modelo candidato em um conjunto de prompts e informar reward, pass@k e métricas de trajetória. A documentação mostra como avaliar um modelo ajustado e, opcionalmente, incluir o modelo base no mesmo fluxo de comparação.
Defina o protocolo de avaliação antes do treinamento. Mantenha um conjunto retido e fixo, representativo das consultas, permissões e mudanças nos documentos que o agente encontrará em produção. Compare os modelos base e ajustado com as mesmas ferramentas, limites e código de pontuação. Examine não só a pontuação média de recuperação, mas também falhas nas tarefas, número de etapas, latência, uso de tokens e casos em que documentos relevantes deixam de aparecer entre os primeiros resultados. A documentação explica como enviar um trabalho de avaliação da AWS; não demonstra que uma única métrica represente toda a qualidade da busca em produção.
A publicação da AWS informa estes resultados nos conjuntos retidos:
| Conjunto de dados (perguntas) | nDCG@10 do modelo base | nDCG@10 do modelo ajustado | Taxa de falha do modelo base | Taxa de falha do modelo ajustado |
| --- | --- | --- | --- | --- |
| WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
| Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
| FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
| BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
A tabela mostra três aumentos no nDCG@10 e uma pequena queda no FreshStack. A AWS atribui a menor taxa de falhas do BrowseComp-Plus à penalidade aplicada quando o agente atinge o limite de etapas ou tokens. O blog não apresenta intervalos de confiança nem uma análise de significância estatística junto desses números. Também informa que o modelo ajustado usou, em média, 4.5 etapas no WixQA, contra 4.3, e 2.9 no Wands, contra 2.2; portanto, reduzir o número de etapas não foi um resultado universal. Trate isso como um experimento relatado pelo fornecedor, não como validação independente nem como evidência de que outro corpus também melhorará.
## Calcule o custo total do teste
A documentação de MTRL da AWS descreve três componentes de cobrança do treinamento: tokens de prefill processados como entrada, tokens amostrados gerados durante as execuções e atualizações do treinamento. A página de preços informa valores específicos por modelo; esses valores, o volume de execuções, os comprimentos das sequências, as épocas e o ambiente de execução determinam a estimativa. O artigo de exemplo não divulga a conta total e a documentação não oferece um preço universal para testes. Consulte o valor atual do modelo e da região escolhidos e estime com base no uso previsto do trabalho, sem presumir um custo fixo.
Inclua também os custos associados: armazenamento e solicitações do S3 para treinamento, validação, checkpoints e artefatos de saída; o ambiente de execução AgentCore ou Lambda e qualquer infraestrutura de busca de apoio durante as execuções; logging e MLflow; avaliação dos dados retidos; e qualquer endpoint ou deploy no Bedrock após o treinamento. A publicação da AWS recomenda especificamente interromper ou excluir um trabalho MTRL em execução, remover artefatos de modelo desnecessários do S3 e excluir endpoints de avaliação para evitar cobranças contínuas. O deploy em endpoint é uma decisão e uma categoria de custo separadas do treinamento.
## Decida se vale a pena prosseguir
O fluxo é mais relevante quando a tarefa de busca exige várias chamadas dependentes a ferramentas e a equipe consegue pontuar o resultado final. Um teste só será útil para a tomada de decisão se contar com uma combinação compatível de modelo e região, integração funcional do agente, dados de prompt representativos, uma recompensa que reflita a tarefa, uma comparação em conjunto retido e uma estimativa que inclua os serviços associados. Um bom resultado nos quatro benchmarks da AWS é motivo para analisar o método, não para presumir o mesmo efeito em outro índice, conjunto de consultas ou limite de permissões.
**Fontes e leituras adicionais**
- [AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (2 de outubro de 2026)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — o guia do fornecedor, a configuração, as opções de conjuntos de dados e os resultados de avaliação relatados.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — modelos e regiões compatíveis atualmente, visão geral do fluxo e componentes de cobrança do treinamento.
- [Pré-requisitos](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html), [Preparação do agente](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-agent.html), [Configuração de VPC](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-vpc.html) e [criptografia em repouso](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-encryption-at-rest.html) — permissões, opções de ambiente de execução, integração e configuração opcional de rede e criptografia.
- [Criação de assets](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html), [envio do trabalho de treinamento](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html), [avaliação](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-evaluation.html), [hiperparâmetros](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-hyperparams.html) e [cotas](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-quotas.html) — referências atuais para implementação.
- [Preços do SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/) — valores atuais para personalização de modelos; os preços variam por modelo e região.
*Nota de apuração: apenas documentação foi analisada. A BIG CHANGE não acessou uma conta AWS, não enviou nem inspecionou um trabalho do SageMaker, não chamou APIs da AWS e não reproduziu de forma independente as métricas relatadas. A AWS escreveu o guia de implementação e relata seu próprio experimento.*
## Sources
- [AWS Machine Learning Blog: Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI (2 de outubro de 2026)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — Guia de implementação da AWS, opções de conjuntos de dados e avaliação em dados retidos relatada pelo fornecedor.
- [Amazon SageMaker AI: Multi-turn reinforcement learning](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — Combinações atuais de modelo e região, visão geral do fluxo e componentes de cobrança do treinamento.
- [Pré-requisitos e configuração de agentes para MTRL no Amazon SageMaker AI](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html) — Permissões necessárias, opções de ambiente de execução, integração do agente e configuração opcional de rede e criptografia.
- [Documentação de treinamento e avaliação do MTRL no Amazon SageMaker AI](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html) — Entradas de dados e fluxo atuais; o artigo também inclui links para as referências do trabalho de treinamento e da avaliação.
- [Envio de um trabalho de treinamento de MTRL no Amazon SageMaker AI](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) — Importação atual do SDK Python, nomes dos argumentos, exemplo do AgentCore e etapas de envio pelo Studio; consultado em 4 de outubro de 2026.
- [Preços do Amazon SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/) — Informações atuais de preços por modelo; os valores variam conforme o modelo e a região.
Newsletter da BIG CHANGE
A visão ampla, no seu ritmo.
Matérias recentes sobre IA e robótica, mudanças que merecem atenção e ideias práticas para usar. Escolha um briefing diário, um resumo semanal ou uma perspectiva mensal.
Próximo envio programado (UTC): . Sua primeira edição chegará no próximo envio programado após a confirmação.
Sua privacidade, sua escolha.
O armazenamento necessário ajuda a proteger o site e a lembrar suas escolhas. O Google Analytics opcional permanece desativado até você autorizá-lo. Você pode ler todas as matérias usando apenas o armazenamento necessário. Detalhes de privacidade