AI-translated from English; not yet reviewed by a fluent editor.
# Grok 4.7 chega pelo mesmo preço por token. A pergunta maior é quanto custa o trabalho concluído.
> O lançamento do Grok 4.7 promete melhorias em programação e tarefas de escritório. Analisamos a cobertura de Matthew Berman, testes independentes e o que as equipes devem medir antes de trocar de modelo.
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
O Grok 4.7 chegou em 21 de setembro de 2026. Para equipes que compram IA para escrever código ou analisar informações comerciais, o lançamento traz uma pergunta prática: um modelo melhor torna mais barato o trabalho concluído? A resposta depende de mais do que as tarifas por token anunciadas. [Notas oficiais de lançamento](https://docs.x.ai/developers/release-notes)
Esse quadro misto é o tema do vídeo de Matthew Berman, publicado em 22 de setembro, *Não sei o que pensar do Grok 4.7…*. Ele questiona a escolha das comparações e argumenta que o custo por tarefa concluída importa mais do que o preço dos tokens. Também diz que ainda não testou o modelo a fundo. Seu vídeo é uma avaliação inicial das evidências, não uma análise prática abrangente. [Introdução de Berman, 0:00](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
O lançamento merece atenção porque um modelo útil não precisa vencer todos os benchmarks para mudar o que as empresas podem automatizar. Ainda assim, precisa concluir corretamente trabalho suficiente para justificar seu custo total. Testes independentes já revelam a tensão: os resultados melhores do Grok 4.7 podem vir acompanhados de muito mais texto gerado.
Para desenvolvedores, pequenas empresas e equipes que criam agentes, a decisão é prática. Que tarefas esse modelo consegue concluir com qualidade aceitável? Quanto esforço exige? E quanto trabalho resta para uma pessoa depois que o modelo diz que terminou?
Analisamos as legendas completas do vídeo de Berman, com cerca de 17 minutos, e conferimos o lançamento, a documentação do produto e a avaliação da Artificial Analysis. A análise abaixo não contém benchmarks da BIG CHANGE nem afirmações de testes próprios do Grok.
## O que foi lançado e onde está disponível
O modelo padrão está disponível na API da xAI como `grok-4.7`, além de estar no Cursor e no Grok Build. A API aceita texto e imagens e gera texto. A janela de contexto documentada é de 500 mil tokens, com quatro configurações de raciocínio: low, medium, high e xhigh. A opção padrão é high. [Notas oficiais de lançamento](https://docs.x.ai/developers/release-notes)
A SpaceXAI atribui a melhoria a um modelo-base maior e a um treinamento de reforço mais prolongado em tarefas difíceis. Essa é a explicação do desenvolvedor. [Visão técnica do lançamento](https://x.ai/news/grok-4-7)
Há também o Grok 4.7 Fast. A documentação o descreve como o mesmo modelo em uma infraestrutura mais rápida, cobrado ao dobro das tarifas padrão por token. Ele está disponível pelo Cursor e pelo Grok Build, não faz parte do plano gratuito do Grok Build e não está disponível pela API pública da xAI. [Documentação do produto Grok 4.7](https://docs.x.ai/developers/grok-4-7)
Essas distinções importam ao comparar capturas de tela, demonstrações e faturas. Versão do modelo, esforço de raciocínio e nível de serviço são escolhas separadas. Uma demonstração usando o Fast em xhigh não é uma estimativa da experiência nem do custo de uma chamada à API padrão com velocidade normal e esforço medium.
A comparação da página de lançamento com outros modelos também deve ser separada da comparação de atualização. A SpaceXAI diz que o Grok 4.7 padrão tem o mesmo preço e velocidade do Grok 4.6. Não afirma que a atualização do 4.6 reduzirá automaticamente pela metade a conta do cliente.
## A tabela de preços tem um limite para contextos longos
As tarifas padrão publicadas para a API são:
- Até 200 mil tokens de entrada: US$ 2 para entrada, US$ 0,50 para entrada em cache e US$ 6 para saída, por milhão de tokens.
- Acima de 200 mil tokens de entrada: US$ 4 para entrada, US$ 1 para entrada em cache e US$ 12 para saída, por milhão de tokens.
Essas são tarifas por token, não preços completos para um agente concluir um trabalho. A página do modelo sinaliza preços mais altos para solicitações que excedam 200 mil tokens, e as notas de lançamento especificam as tarifas maiores. Preços e disponibilidade foram conferidos em 22 de setembro. [Preços do modelo](https://docs.x.ai/developers/models/grok-4.7) e [notas de lançamento](https://docs.x.ai/developers/release-notes)
Portanto, uma janela de contexto de 500 mil tokens não significa que toda solicitação dentro dela use a tarifa mais baixa. Uma janela grande também não comprova que o modelo encontrará com consistência todos os detalhes relevantes em uma coleção grande de arquivos.
O Cursor introduz outra distinção entre produtos: sua documentação lista uma janela padrão de 256 mil tokens e uma máxima de 500 mil. A capacidade exposta no editor pode diferir da especificação da API ou depender do modo selecionado. [Documentação do Grok 4.7 no Cursor](https://prod.cursor.com/docs/models/grok-4-7)
Para uma equipe que processa relatórios longos, a pergunta imediata é se enviar todo o material melhora o resultado o bastante para justificar o custo. Recuperar apenas as seções relevantes pode ser mais barato e fácil de inspecionar. Às vezes o documento inteiro é necessário; em outras, é apenas a maneira mais simples de montar o prompt. Não se deve orçar essas situações como se fossem iguais.
## Um desempenho melhor pode consumir mais tokens
A avaliação da Artificial Analysis, de 21 de setembro, dá ao Grok 4.7 em xhigh uma pontuação de 46 no Intelligence Index, dois pontos acima do Grok 4.6. Ela informa um consumo aproximado de 81 mil tokens de saída por tarefa, ante 36 mil do Grok 4.6 em high. O mesmo relatório apresenta 38 mil para o Grok 4.6 em xhigh; portanto, até a comparação com o mesmo nível de esforço mostra mais que o dobro de tokens de saída. [Avaliação de lançamento da Artificial Analysis](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
Esse é um motivo concreto para separar o preço dos tokens do custo da tarefa. Usar 81 mil tokens de saída à tarifa básica de US$ 6 por milhão resulta em uma cobrança ilustrativa de US$ 0,486. Com 38 mil tokens, seriam US$ 0,228. Esses cálculos excluem deliberadamente a entrada, o comportamento do cache, as tarifas de ferramentas, os preços para contextos maiores e as tentativas malsucedidas. São cálculos aritméticos com base no consumo informado, não preços totais medidos por trabalho.
Mais texto gerado não é automaticamente desperdício. Um modelo pode se esforçar mais para verificar uma resposta e evitar uma falha que exigiria a intervenção de alguém. Também pode passar mais tempo seguindo uma abordagem errada. A contagem de tokens, sozinha, não distingue persistência produtiva de repetição cara.
Berman volta a essa questão perto do fim do vídeo, observando o maior consumo de tokens informado pela Artificial Analysis. [Vídeo, 15:43](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
O resultado útil é um trabalho entregue e aceito. Uma alteração de código aprovada em testes e revisão adequados, uma planilha cujas fórmulas conciliam ou um relatório cujas afirmações estejam ligadas a evidências têm outro valor em comparação com uma resposta que apenas chega rápido.
## Os benchmarks mostram um modelo capaz, mas irregular
A tabela de lançamento dá ao Grok 4.7 em xhigh 46,3% no CursorBench 4.0, abaixo dos 51,8% do Fable 5.1 em max. O Fable também lidera a comparação do Terminal-Bench. [Tabela de benchmarks do fornecedor](https://x.ai/news/grok-4-7)
O gráfico que acompanha a tabela relaciona a pontuação do benchmark aos tokens de saída, com uma tendência decrescente da esquerda para a direita. As linhas comparam configurações de raciocínio. [Gráfico interativo original: selecione Tokens](https://x.ai/news/grok-4-7). [Abra o gráfico em tamanho integral](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png).
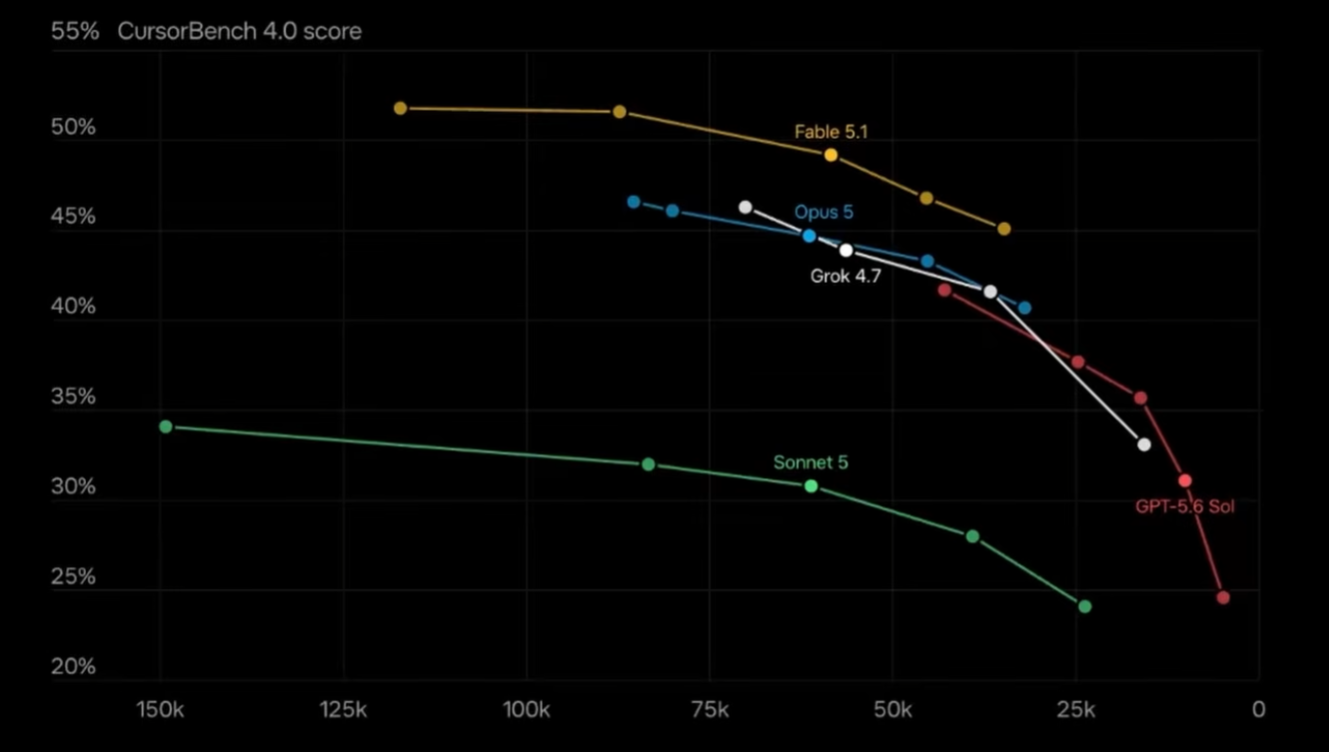
Subir no gráfico significa uma pontuação maior; mover-se à direita significa menos tokens gerados nesta avaliação. Isso não significa um preço total menor: as tarifas por token, o uso de tokens de entrada e o agente ao redor também importam. Este é outro teste, diferente dos dados de consumo da Artificial Analysis acima. Combinar as contagens apagaria as diferenças entre tarefas e metodologias que permitem interpretar cada resultado.
Isso basta para rejeitar uma afirmação geral de que o Grok 4.7 lidera em todo tipo de programação. Também justifica uma análise mais detalhada de determinadas cargas de trabalho. O tamanho de uma melhoria em uma avaliação não determina como um modelo lidará com um repositório desconhecido, um relatório de erro incompleto ou um ambiente de ferramentas incomum.
A Artificial Analysis oferece uma distinção independente útil. Seu relatório dá ao Grok 4.7 com Grok Build uma pontuação de 56 no Coding Agent Index, ante 47 para o Grok 4.6 com esse agente. O relatório separa explicitamente esses resultados do agente nativo da configuração padronizada do Intelligence Index. [Avaliação independente e notas metodológicas](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
O agente ao redor do modelo importa. Ele fornece ferramentas, gerencia o contexto e decide como executar as solicitações do modelo. Mudar esse ambiente pode alterar os resultados mesmo que o nome do modelo permaneça igual. Combinar a pontuação de terminal de uma configuração com a pontuação de engenharia de software de outra pode criar uma tabela convincente que não descreve nenhum sistema realmente testado.
Berman destaca que o GPT-6 Astra não aparece em uma das tabelas de lançamento e usa uma reconstrução gerada por IA para acrescentá-lo. Isso é um bom motivo para investigar a comparação; a reconstrução não é uma fonte independente de benchmarks. Não incorporamos os números acrescentados sem conferir a avaliação subjacente. [Vídeo, 6:03](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
Também é preciso considerar uma relação comercial. O anúncio corporativo do Cursor, de 14 de agosto, informa que a empresa foi adquirida pela SpaceX. Um benchmark publicado dentro da mesma família corporativa continua sendo evidência útil, mas não é uma avaliação desinteressada de um fornecedor concorrente. [Anúncio da aquisição do Cursor](https://cursor.com/blog/joining-spacex)
## Tarefas de escritório podem ser a oportunidade mais interessante
A avaliação independente relata uma pontuação de 1.657 Elo no AA-Briefcase para o Grok 4.7 em xhigh, 111 pontos acima do Grok 4.6 em high. Ela atribui grande parte da melhora à qualidade analítica, enquanto a qualidade da apresentação fica um pouco abaixo do resultado do modelo anterior. [Resultados da Artificial Analysis sobre trabalho intelectual](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
Essa diferença é útil para quem encomenda relatórios, planilhas ou apresentações. Uma resposta pode conter uma análise melhor e ainda exigir edição ou reformulação visual. Por outro lado, uma apresentação refinada pode esconder um raciocínio superficial. Avaliar apenas o acabamento visível pode recompensar a melhoria errada.
Uma equipe de operações poderia testar o modelo em um relatório de desempenho recorrente. Um teste útil verificaria se ele usa o período correto, confere os números com os dados de origem e distingue uma mudança observada de uma explicação proposta. Quem o revisar deveria registrar quanto precisou corrigir, não apenas se o relatório parecia profissional à primeira vista.
Uma empresa menor talvez se importe menos em vencer o benchmark mais difícil e mais em tornar rotineira uma análise que, de outra forma, seria inacessível. Esse é um caminho plausível para uma adoção mais ampla. Ele se torna real quando o resultado é suficientemente preciso, chega no prazo e deixa menos trabalho para o proprietário do que a execução manual da tarefa.
Rótulos de benchmarks profissionais não devem ser confundidos com qualificações profissionais. Um resultado de trabalho jurídico ou raciocínio clínico descreve o desempenho naquela avaliação. Não comprova que o modelo possa lidar sozinho com a questão jurídica de um cliente ou tomar uma decisão de atendimento a um paciente. Este artigo não recomenda usar o Grok para essas decisões.
## As salvaguardas também precisam ser avaliadas no contexto
A SpaceXAI diz que o Grok 4.7 tem uma nova camada de salvaguardas e maior resistência a tentativas de jailbreak. Essa é uma afirmação de lançamento, não uma garantia de que toda aplicação que usa o modelo será segura. [Relato de segurança do desenvolvedor](https://x.ai/news/grok-4-7)
Para um agente empresarial, ainda restam pelo menos duas perguntas. O modelo responde adequadamente às solicitações que recebe? E a aplicação limita o que ele realmente pode fazer?
Um modelo pode compreender corretamente uma instrução para alterar o cadastro de um cliente e ainda não ter permissão para fazê-lo. Também pode encontrar instruções maliciosas embutidas em um documento que deveria resumir. Controles de acesso e regras de aprovação precisam permanecer no sistema ao redor; uma recusa mais eficaz não os substitui.
A implicação prática é testar o fluxo de trabalho inteiro. Inclua solicitações legítimas que devem ser atendidas, ações proibidas que devem ser bloqueadas e casos ambíguos que devem aguardar esclarecimento. Um produto que recusa trabalho inofensivo com frequência demais pode ser inutilizável; um que executa ações não autorizadas pode ser muito pior. Nenhum dos problemas aparece em uma única pontuação de manchete.
## O que o vídeo deixa sem resposta
A cobertura de Berman levanta várias perguntas que devem continuar em aberto. Sua explicação que relaciona os preços à capacidade computacional disponível é uma interpretação de mercado, não uma divulgação da contabilidade dos custos por unidade. As previsões para redes sociais que ele discute são expectativas, não evidências de desempenho alcançado. Sua comparação de demonstrações no final reconhece que ele não sabe quais configurações foram usadas. [Discussão sobre preços, 8:44](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s), [expectativas, 11:51](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s) e [discussão sobre demonstrações, 15:20](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
O vídeo também discute modelos de pesos abertos. Essa tendência competitiva mais ampla não deve ser confundida com a licença do Grok 4.7: a Artificial Analysis identifica este lançamento como proprietário e informa que seus pesos não estão disponíveis. [Perfil de lançamento do Grok 4.7](https://artificialanalysis.ai/models/releases/grok-4-7)
Essas distinções mantêm a avaliação focada. Um produto pode ter um preço atraente sem que o público saiba por que o fornecedor o escolheu. Uma demonstração de falha impressionante pode indicar um teste que vale repetir sem comprovar que o modelo seja ruim em geral. Um modelo disponível pode ser útil sem corresponder à previsão anterior de um fundador.
Também há um limite relacionado ao patrocínio. O vídeo de Berman inclui um anúncio da Zapier. Ele não é evidência independente do desempenho do Grok, e as afirmações promocionais não são recomendações da BIG CHANGE.
## Uma métrica de compra melhor: custo por tarefa aceita
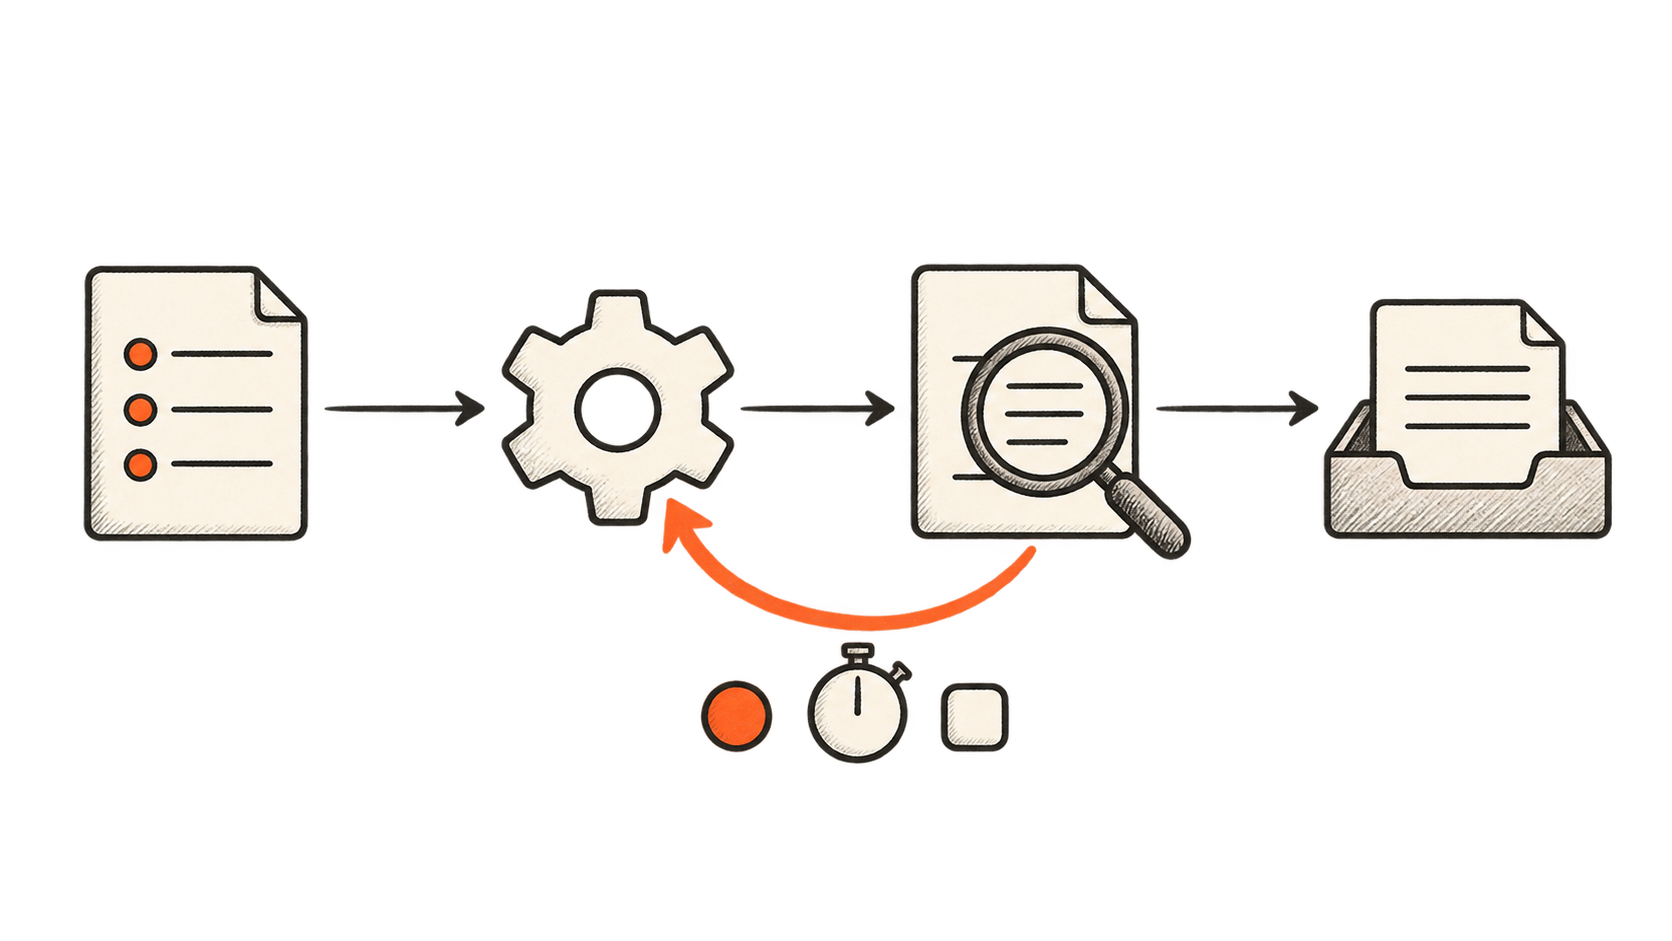
Uma equipe que esteja considerando o Grok 4.7 deve compará-lo ao processo atual em um conjunto pequeno e representativo de tarefas. Defina os critérios de aceitação antes de ver os resultados. Para programação, podem incluir testes pertinentes, um patch legível e ausência de alterações sem relação com a tarefa. Para análise, podem incluir cálculos corretos e evidências para afirmações importantes.
Em seguida, registre a conta completa: uso de tokens de entrada e saída, ferramentas, novas tentativas e tempo gasto na revisão ou correção do resultado. Conte também as tentativas malsucedidas. Divida esse custo pelo número de entregas que atendem aos critérios de aceitação.
Um exemplo ilustrativo mostra por que essa distinção importa. Suponha que uma configuração custe US$ 20 em um lote e produza 80 resultados aceitos. Seu custo medido é de US$ 0,25 por resultado aceito, antes do trabalho humano. Outra custa US$ 12, mas produz apenas 30 resultados aceitos, o que dá US$ 0,40 por resultado aceito. O lote mais barato é a fonte mais cara de trabalho utilizável. São números hipotéticos, não medições do Grok.
O esforço de raciocínio deve fazer parte desse teste. Uma configuração de alto esforço pode justificar o custo em uma tarefa difícil e acrescentar pouco em uma rotineira. Direcionar apenas os casos que precisam dela pode ser mais econômico do que executar toda solicitação em xhigh, desde que a própria decisão de direcionamento também seja avaliada.
Mantenha os mesmos padrões de revisão para todos os modelos. Reduzir a exigência para um modelo mais barato cria uma economia aparente ao aceitar um trabalho pior. Aumentar a exigência somente para o modelo atual provoca a distorção oposta. O objetivo é comprar um resultado confiável, sabendo claramente o que ainda cabe às pessoas fazer.
## A mudança que vale acompanhar
O Grok 4.7 oferece às equipes outra opção para testar. Para escolhê-lo, é preciso considerar a tarefa inteira: o que o modelo produz, o que consome e o que alguém ainda precisa consertar.
A consequência mais ampla pode ser um uso mais seletivo de IA nas tarefas cotidianas. Uma equipe pode escolher uma configuração para análises rotineiras, outra para programação difícil e uma pessoa para os casos em que não se pode delegar o julgamento ou a responsabilidade. Mais concorrência oferece outra opção para testar; não determina qual delas deve vencer.
Para a BIG CHANGE, a próxima etapa é realizar trabalho mensurável com menos esforço total. Se o Grok 4.7 reduzir o custo de entregas aceitas, poderá tornar a automação útil acessível a mais organizações. Se o raciocínio adicional apenas transferir a despesa do preço dos tokens para o volume consumido, o preço da manchete dirá muito pouco aos compradores. A resposta virá de tarefas concluídas, inclusive as que falharam antes de dar certo.
## Sources
- [Matthew Berman: não sei o que pensar do Grok 4.7…](https://www.youtube.com/watch?v=MJllZbpvrAc) — 22 de setembro de 2026. O vídeo que motivou esta análise. Os links com marcação de tempo identificam os trechos examinados; Berman descreve sua avaliação como preliminar. O segmento patrocinado é separado das evidências sobre o modelo.
- [Apresentação do Grok 4.7](https://x.ai/news/grok-4-7) — 21 de setembro de 2026. Anúncio da SpaceXAI e gráficos interativos de benchmarks. É preciso considerar as configurações de esforço nos resultados do fornecedor; eles não representam uma classificação universal.
- [Notas de lançamento para desenvolvedores da xAI](https://docs.x.ai/developers/release-notes) — A entrada de 21 de setembro estabelece a disponibilidade, a janela de contexto, as configurações de esforço e as tarifas padrão e para contextos longos da API. Conferida em 22 de setembro; preços e acesso a produtos podem mudar.
- [Documentação do produto Grok 4.7](https://docs.x.ai/developers/grok-4-7) — Explica o modelo padrão e a opção de execução Fast. A disponibilidade do Fast é mais restrita do que a do modelo na API padrão; demonstrações e orçamentos devem especificar o nível utilizado.
- [Preços do modelo Grok 4.7](https://docs.x.ai/developers/models/grok-4.7) — Tabela de tarifas do modelo e limite de preço mais alto para prompts acima de 200 mil tokens. Os preços por token, sozinhos, não incluem novas tentativas, ferramentas nem revisão humana.
- [Documentação do Grok 4.7 no Cursor](https://prod.cursor.com/docs/models/grok-4-7) — Distingue a janela de contexto padrão do Cursor da capacidade máxima. As configurações do produto podem diferir da capacidade da API subjacente.
- [Artificial Analysis: avaliação do Grok 4.7](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — 21 de setembro de 2026. Testes independentes que embasam a análise do consumo de tokens e do trabalho intelectual. O relatório distingue a avaliação padronizada dos resultados do agente nativo; essas configurações não devem ser misturadas.
- [Artificial Analysis: perfil de lançamento do Grok 4.7](https://artificialanalysis.ai/models/releases/grok-4-7) — Identifica a licença proprietária do lançamento e informa que os pesos não estão disponíveis. A discussão sobre concorrência de pesos abertos no vídeo não comprova que este modelo tenha pesos abertos.
- [Cursor agora faz parte da SpaceX](https://cursor.com/blog/joining-spacex) — 14 de agosto de 2026. O anúncio de aquisição do Cursor contextualiza a avaliação de um benchmark promovido dentro da mesma família corporativa.
Newsletter da BIG CHANGE
A visão ampla, no seu ritmo.
Matérias recentes sobre IA e robótica, mudanças que merecem atenção e ideias práticas para usar. Escolha um briefing diário, um resumo semanal ou uma perspectiva mensal.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Sua privacidade, sua escolha.
O armazenamento necessário ajuda a proteger o site e a lembrar suas escolhas. O Google Analytics opcional permanece desativado até você autorizá-lo. Você pode ler todas as matérias usando apenas o armazenamento necessário. Detalhes de privacidade