AI-translated from English; not yet reviewed by a fluent editor.
# A NVIDIA lança o Nemotron 3 Diarization para áudio com até oito locutores
> Lançado a 23 de setembro, o modelo de diarização com pesos abertos da NVIDIA identifica até oito locutores em áudio gravado ou em transmissão. A configuração recomendada com menor latência usa um buffer de 0,32 segundos; os valores de precisão são dos próprios testes da NVIDIA.
By BIG CHANGE Editorial
Published: 2026-09-27T15:28:31.966Z
Updated: 2026-09-27T15:28:31.966Z
Canonical: https://bigchange.ai/blog/nvidia-nemotron-3-speaker-diarization-model
AI-generated conceptual illustration by BIG CHANGE.
A NVIDIA lançou o [Nemotron 3 Diarization](https://huggingface.co/nvidia/Nemotron-3-Diarization) a 23 de setembro. O modelo de pesos abertos, com cerca de 100 milhões de parâmetros, assinala os momentos em que até oito locutores falam num áudio gravado ou em transmissão. Fornece atividade dos locutores e marcações temporais; para obter também a transcrição das palavras, é necessário um sistema de reconhecimento de fala.
## A grande mudança
- **O que mudou:** O checkpoint Sortformer anterior da NVIDIA para transmissão suporta quatro locutores. Este lançamento oferece oito canais de locutor, ordenados pela ordem de chegada, num único checkpoint compatível tanto com áudio gravado como com blocos de áudio recebidos em tempo real.
- **Porque é importante:** Um programador que esteja a criar um sistema de transcrição de reuniões ou chamadas pode usar o modelo para atribuir rótulos genéricos de locutor a intervalos de tempo, inclusive quando há fala sobreposta, e depois combinar esses intervalos com as palavras reconhecidas por outro sistema. O lançamento alarga o limite documentado de locutores para esta tarefa.
- **O que acompanhar:**A escolha prática consiste em decidir quanto áudio manter no buffer antes de cada resultado transmitido. A configuração recomendada mais curta da NVIDIA aguarda 0,32 segundos de áudio antes de iniciar o cálculo, e as tabelas de precisão da própria empresa mostram o custo de usar essa configuração. As equipas ainda precisam de medir o fluxo completo com as suas próprias gravações.
## O que o modelo devolve
O [cartão do modelo](https://huggingface.co/nvidia/Nemotron-3-Diarization) especifica áudio mono a 16 kHz. Lista ficheiros WAV, FLAC, Opus e MP3; a interface NeMo aceita caminhos para ficheiros, matrizes de áudio ou um manifesto JSON delimitado por linhas. Para matrizes de áudio, é necessário indicar a taxa de amostragem correta à função `diarize()`. Segundo a ficha, a inferência em blocos não tem uma duração máxima fixa de gravação.
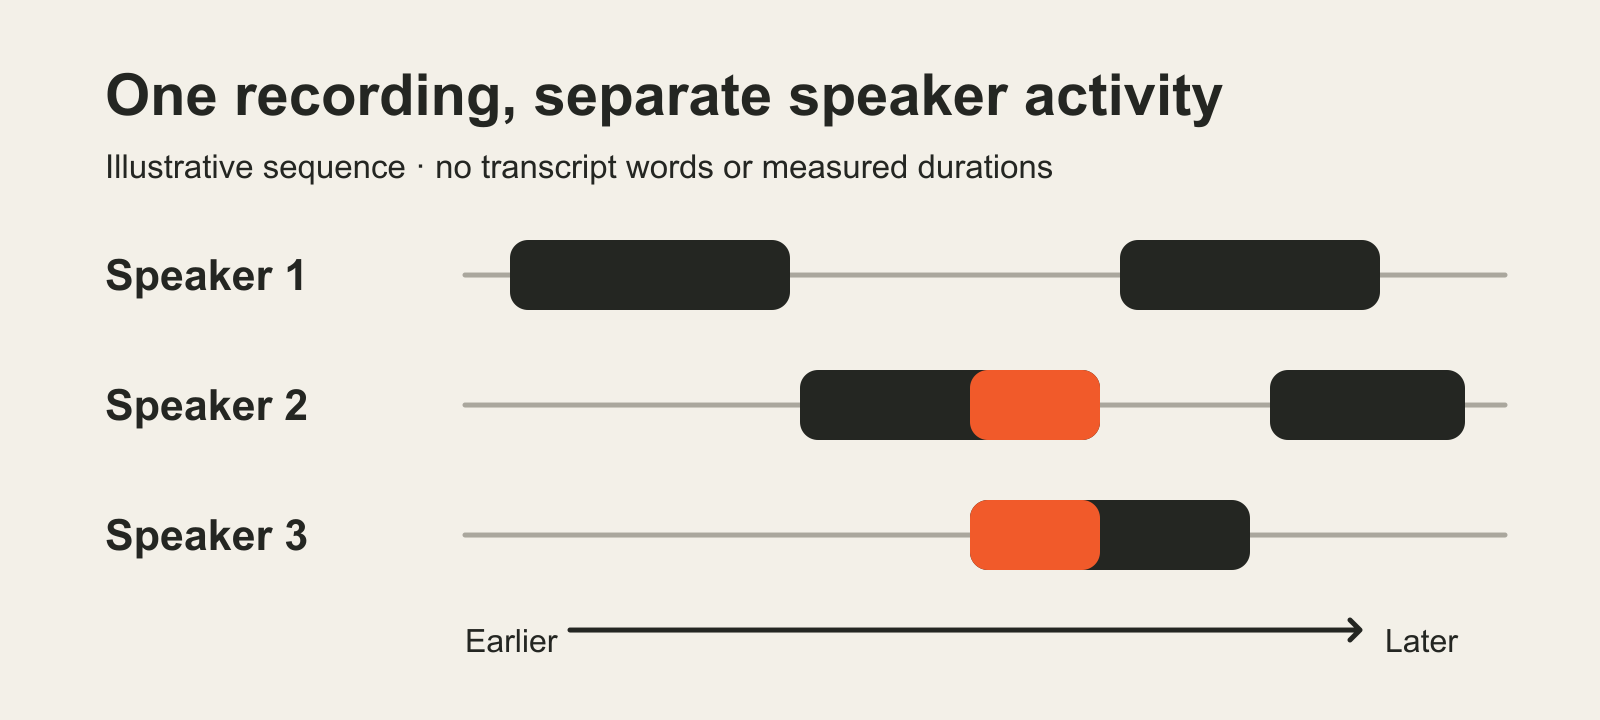
O modelo converte o áudio num tensor de formato `[T, 8]`, com probabilidades de atividade dos locutores e um intervalo de saída predefinido de 10 milissegundos. Vários canais podem estar ativos em simultâneo quando há sobreposição de vozes. O pós-processamento converte essas probabilidades em intervalos com horas de início e fim e rótulos genéricos de locutor. Os rótulos seguem a ordem em que as vozes surgem pela primeira vez; não identificam as pessoas pelo nome. O modo de transmissão da NVIDIA usa uma cache de locutores para blocos anteriores e uma fila «primeiro a entrar, primeiro a sair» para fotogramas recentes, permitindo que o modelo retenha o contexto.
Para quem desenvolve um sistema de transcrição com identificação de locutores, esta distinção é importante. O [guia de integração da NVIDIA](https://huggingface.co/blog/nvidia/nemotron-diarization) combina as marcações temporais da diarização com o resultado de um sistema separado de reconhecimento automático de fala. A regra do ponto médio no exemplo deixa uma palavra sem locutor atribuído quando nenhum está ativo e assinala atividades simultâneas como ambíguas. O modelo de diarização, por si só, não determina qual das vozes sobrepostas produziu uma palavra reconhecida.
## O tempo no buffer não é o tempo de resposta
A NVIDIA recomenda buffers de entrada de 30,4, 1,04, 0,64 e 0,32 segundos. A configuração de 0,32 segundos contém três fotogramas de processamento de 80 milissegundos e um fotograma de contexto à direita, também de 80 milissegundos. A [cartão define explicitamente a latência](https://huggingface.co/nvidia/Nemotron-3-Diarization) como o áudio mantido antes da inferência; não inclui o cálculo. Um sistema de transcrição também acrescentaria o tempo do reconhecimento, do transporte e do processamento pela aplicação.
O percurso documentado no NeMo requer Python 3.12 ou posterior, Cython, uma versão recente do PyTorch e NeMo Speech. A NVIDIA fornece como exemplo o método `SortformerEncLabelModel.from_pretrained()`, uma chamada `diarize()` que devolve segmentos de locutores e uma opção para incluir tensores de probabilidade. A ficha diz que é necessário um token do Hugging Face para carregar o checkpoint alojado através dessa chamada do NeMo. Apresenta também uma interface offline e de transmissão no Transformers, que requer a instalação a partir do repositório de código-fonte do Transformers, além de uma opção de linha de comandos [do NeMo-Speech.cpp](https://github.com/NVIDIA/NeMo-Speech.cpp/blob/main/docs/cli.md). São interfaces documentadas; a BIG CHANGE não as executou. Para a integração com NeMo, a ficha do modelo lista Linux e GPUs das famílias NVIDIA Ampere, Hopper e Blackwell. As necessidades de hardware e o custo de processamento de uma carga de trabalho específica dependem da opção e da máquina escolhidas; a ficha não indica um preço de funcionamento por hora.
Os pesos são disponibilizados ao abrigo da licença [OpenMDW 1.1](https://openmdw.ai/license/1-1/). A licença permite utilizar, modificar e distribuir o modelo sem uma taxa de licenciamento, sujeito aos respetivos termos. A distribuição tem de manter a licença e os avisos de origem aplicáveis. A licença não restringe a utilização nem a partilha dos resultados gerados e atribui aos utilizadores a responsabilidade de obter os direitos e consentimentos necessários para os seus áudios. A NVIDIA descreve o modelo como disponível para utilização comercial e não comercial.
## O que mediu a NVIDIA
A avaliação no [cartão do modelo da NVIDIA](https://huggingface.co/nvidia/Nemotron-3-Diarization) compara o Nemotron 3 com o Sortformer v2.1 anterior da própria NVIDIA, que suporta quatro locutores em transmissão. No conjunto completo de avaliação DIHARD III, a NVIDIA indica uma taxa de erro de diarização de 13,18% para o Nemotron 3 com o buffer de entrada de 1,04 segundos, contra 19,60% para o modelo anterior com a mesma configuração declarada. Com 0,32 segundos, o resultado do Nemotron 3 é 13,55%. A taxa de erro de diarização combina fala não detetada, falsos alarmes e confusão entre locutores, divididos pelo tempo de fala de referência. Quanto menor, melhor.
Estes números dizem respeito a um protocolo definido. A NVIDIA afirma que todas as avaliações pontuam a fala sobreposta. O DIHARD III usa uma tolerância de fronteira de zero segundos; o CALLHOME-Part2 usa 0,25 segundos. Para AMI, AliMeeting e NOTSOFAR1, a NVIDIA usa anotações de referência ligadas e alinhadas à força, em vez dos rótulos originais dos segmentos; a alteração desses rótulos altera as pontuações. As [instruções de avaliação](https://huggingface.co/nvidia/Nemotron-3-Diarization/blob/main/diarization_evaluation.md) identificam o script do NeMo e exigem um ficheiro RTTM de referência, a configuração de sobreposição, a tolerância, as definições de transmissão e os pormenores do pós-processamento para uma execução comparável. Os testes de velocidade de inferência da NVIDIA usaram BF16 numa RTX PRO 5000, com e sem `torch.compile()`. São testes relatados pelo fornecedor, não reproduzidos pela BIG CHANGE.
O limite de oito locutores continua a ser relevante. Algumas gravações do DIHARD III são anotadas com até nove locutores, e a ficha diz que a fala para além dos oito canais do modelo pode não ser detetada ou ser atribuída a outro canal. Nas gravações de teste AMI, a NVIDIA indica uma taxa de erro de diarização menor para o Nemotron 3 do que para o modelo de referência anterior, mas uma precisão inferior na contagem exata de locutores. Portanto, a precisão depende da tarefa, da métrica e do áudio. Uma equipa que avalie integrar o modelo pode começar pelas interfaces publicadas pela NVIDIA e testar o fluxo completo de identificação de locutores e palavras em gravações semelhantes às da utilização prevista.
## Sources
- [NVIDIA: ficha do modelo Nemotron 3 Diarization](https://huggingface.co/nvidia/Nemotron-3-Diarization) — Especificação primária da data de lançamento, dimensão da classe de 100 milhões de parâmetros, entradas, saídas, configurações de transmissão e tabelas de avaliação da NVIDIA. As medições de precisão e velocidade são relatadas pelo fornecedor; a configuração declarada de 0,32 segundos corresponde ao tempo no buffer de entrada e não inclui o cálculo.
- [NVIDIA: artigo de lançamento «Know Who Spoke When»](https://huggingface.co/blog/nvidia/nemotron-diarization) — O relato datado do lançamento explica os canais de locutor ordenados pela ordem de chegada e mostra como intervalos genéricos de locutor podem ser combinados com o resultado de um sistema separado de reconhecimento automático de fala. O exemplo de correspondência pelo ponto médio assinala sobreposições como ambíguas e é uma heurística simples, não um resultado de transcrição validado.
- [NVIDIA: ficha complementar da avaliação da diarização](https://huggingface.co/nvidia/Nemotron-3-Diarization/blob/main/diarization_evaluation.md) — Identifica o script de avaliação do NeMo, o requisito de ficheiro RTTM de referência, as definições de sobreposição e tolerância e os campos necessários para comunicar uma taxa de erro de diarização comparável. É um documento de protocolo, não uma reprodução independente.
- [Acordo de licença OpenMDW, versão 1.1](https://openmdw.ai/license/1-1/) — Permissões e obrigações aplicáveis: utilização gratuita e redistribuição dos materiais do modelo nos termos da licença, manutenção da licença e dos avisos de origem na distribuição, ausência de restrições aos resultados gerados e responsabilidade do utilizador pelos direitos e consentimentos necessários.
- [Guia de linha de comandos NVIDIA NeMo-Speech.cpp](https://github.com/NVIDIA/NeMo-Speech.cpp/blob/main/docs/cli.md) — Documenta a diarização local através da linha de comandos e o limite anterior de quatro locutores no V2, em comparação com oito no V3. O suporte da linha de comandos não demonstra que a BIG CHANGE tenha executado o modelo nem confirma a velocidade do teste de desempenho NeMo indicada na ficha.
Newsletter BIG CHANGE
A perspetiva geral, ao seu ritmo.
Histórias recentes sobre IA e robótica, mudanças que vale a pena acompanhar e ideias práticas para utilizar. Escolha um briefing diário, um resumo semanal ou uma perspetiva mensal.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
A sua privacidade, a sua escolha.
O armazenamento necessário ajuda a proteger o site e a memorizar as suas escolhas. O Google Analytics opcional permanece desativado até que o autorize. Pode ler todos os artigos utilizando apenas o armazenamento necessário. Detalhes de privacidade