AI-translated from English; not yet reviewed by a fluent editor.
# Claude снова работает. Для бизнеса всё ещё нужен план восстановления
> Сбой Claude от 22 сентября устранён. Практическое руководство объясняет, как бизнесу поддерживать ограниченный сервис, сохранять незавершённую работу и восстанавливать собственную очередь после сбоя ИИ.
By BIG CHANGE Editorial
Published: 2026-09-22T08:51:37.833Z
Updated: 2026-09-22T08:51:37.833Z
Canonical: https://bigchange.ai/blog/claude-outage-ai-business-continuity
AI-generated conceptual illustration by BIG CHANGE. When an AI service pauses, a business still needs accessible records of unfinished work. The bookmarked ledger represents preserving the stopping place. Conceptual illustration, not evidence of damaged equipment or lost data.
22 сентября в нескольких моделях Claude участились ошибки. В итоговом обновлении Anthropic указано, что сбой длился с 00:50 до 02:10 UTC, то есть 80 минут. В 02:35 UTC компания пометила инцидент как устранённый. Среди затронутых компонентов перечислены claude.ai, API, Code и Cowork. В отчёте не сказано, что каждый запрос завершался сбоем, и не опубликовано объяснение первопричины. [Запись об инциденте Anthropic](https://status.claude.com/incidents/7g1qpkyz5gxh)
Для компании, встроившей ИИ в рабочий процесс, восстановление сервиса решает лишь часть проблемы. Запросы клиентов всё ещё могут ждать ответа. Сотрудник мог начать разбирать обращение вручную, пока автоматическая попытка оставалась активной. Руководителю нужно знать, какую работу можно продолжить, а какую сначала следует проверить.
Редко доступный ассистент неудобен, если он лишь помогает придумывать идеи. Если тот же сервис классифицирует входящие обращения, составляет ответы и обновляет записи, перерыв становится операционной проблемой. Полезная подготовка — это краткий план непрерывности, которому сотрудники смогут следовать без доступа к самому ИИ-сервису.
В этом руководстве на гипотетическом примере службы поддержки показано, как может работать такой план. Предлагаемые процедуры нужно адаптировать и отрепетировать; BIG CHANGE их не тестировало, и они не описывают клиентов, затронутых этим инцидентом.
## Определите, какую услугу вы сможете поддерживать без ИИ
Представим небольшого поставщика оборудования, чей ассистент сортирует обращения в поддержку и готовит ответы по утверждённым сведениям о продукции. Перед отправкой сотрудники проверяют ответы. Для организации очереди бизнес полагается на систему, хотя ответственность за ответы остаётся у людей.
Если ассистент перестал отвечать, руководителю сначала нужно решить, что служба поддержки всё ещё может обещать. Сотрудники могут продолжить подтверждать получение обращений и обрабатывать дела со срочными сроками, отложив обычные вопросы о продукции. Им нужны исходные сообщения и утверждённые справочные материалы, доступные без ассистента. Иначе инструкция «перейти на ручной режим» не оставит средств её выполнить.
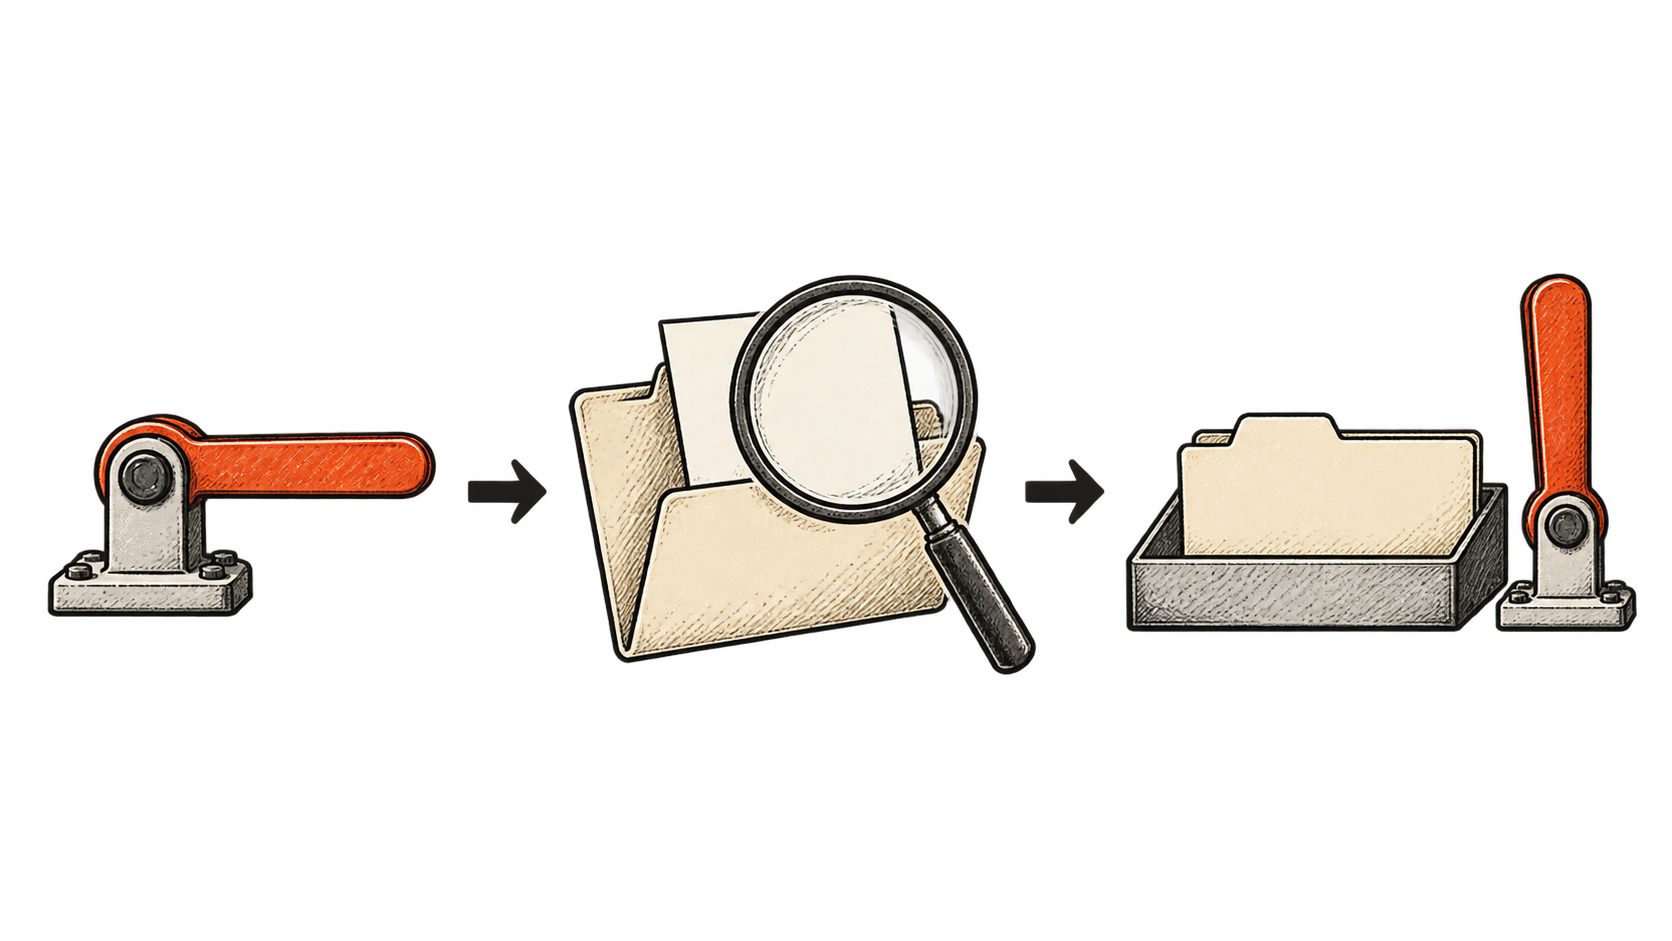
Заранее определите такой сокращённый режим обслуживания. Назначьте сотрудника, который может его включить, укажите, какую работу приостановить, и определите, кто займётся оставшимися задачами. Назначьте время пересмотра, чтобы временный режим не продолжался до конца дня без повторной оценки. В сообщениях клиентам следует объяснить задержку и доступный способ получить срочную помощь, не обещая того, чего команда выполнить не сможет.
В инженерных рекомендациях Google по работе при перегрузке описаны обслуживание с урезанными функциями, ограничение трафика и приоритет важных запросов при нехватке ресурсов. Это проверенные методы обеспечения надёжности, а не диагноз инцидента Claude. Для службы поддержки они означают, что при невозможности нормальной работы объём сервиса можно осознанно сократить. [Google SRE: работа при перегрузке](https://sre.google/sre-book/handling-overload/)
Для сокращённого сервиса также нужен предел нагрузки. Нельзя молча поручить двум людям объём работы автоматизированной системе, обычно обслуживающей гораздо больше запросов. Зафиксируйте, сколько сотрудники успеют обработать, что будет ждать и когда понадобится дополнительная помощь. Клиентам полезнее реалистичный срок ответа, чем автоматическое подтверждение, создающее впечатление, будто сервис работает нормально.
## Храните записи о работе за пределами разговора с ИИ
Службе поддержки нужна запись обращений, доступная во время недоступности модели. Это может быть уже используемая система поддержки. Главное, чтобы бизнес мог установить, что произошло, не прося прервавшегося ассистента восстановить ход работы.
Для каждого дела сохраняйте исходный запрос, ответственного сотрудника или процесс и последнее подтверждённое действие. Сохранённый черновик — не то же самое, что отправленный ответ. Предложенное изменение записи клиента отличается от изменения, подтверждённого самой системой. Храните достаточно свидетельств, чтобы различить эти случаи, с теми же ограничениями доступа, что действуют для исходных данных клиента.
Во время сбоя разделите работу на такие практические категории:
- Готово к началу: обработка и внешние действия ещё не запускались.
- Частично подготовлено: классификация или черновик есть, но следующий шаг не завершён.
- Подтверждено как завершённое: целевая система зафиксировала нужное действие.
- Неопределённо: действие было предпринято, но подтверждения нет.
Назначайте неопределённые дела сотруднику, который может проверить соответствующую систему до продолжения работы. Если при обрыве соединения ассистент составлял ответ, новый черновик может быть безвреден. Но если отдельный инструмент отправлял ответ, повтор всей задачи может привести к повторной отправке. Это различие должно отражаться в рабочей записи.
В документации Anthropic по API сказано, что потоковая передача ответа может прерваться после первоначального успешного статуса HTTP 200. Появление первых строк или получение этого статуса не доказывает, что ответ поступил целиком. Интеграция должна проверять завершённость и сохранять частичный результат именно как частичный. [Документация по ошибкам API Claude](https://platform.claude.com/docs/en/api/errors)
## Ограничьте число повторных попыток и назначьте ответственного
Повторный запрос может устранить временный сбой. Но он может и продлить неопределённость, если каждый уровень независимо запускает ту же задачу снова. Прежде чем добавлять ещё одну кнопку повтора или автоматический цикл, выясните у поставщика программного обеспечения, не повторяются ли запросы уже во встроенной клиентской библиотеке.
Anthropic сообщает, что официальные SDK по умолчанию дважды автоматически повторяют запросы при временных сбоях, увеличивая задержку и соблюдая инструкцию retry-after, если она присутствует. В документации об ошибках также различаются временные проблемы сервера, сбои аутентификации и разрешений, а также ошибки формата запроса. Нельзя рассчитывать, что повтор исправит любую из этих проблем. [Описанное поведение повторов в Claude](https://platform.claude.com/docs/en/api/errors)
Для службы поддержки в рабочем правиле следует указать, когда автоматические попытки прекращаются и кому после этого передаётся обращение. Сохраняйте идентификатор запроса для поиска причины. Сотрудники должны видеть, ожидает ли задача выполнения, повторяется ли запрос или ожидает человека, чтобы не запускать параллельные попытки вслепую.
Amazon Web Services объясняет, как действие может выполниться, даже если ответ не поступил. В идемпотентных API явный идентификатор запроса распознаёт повторы и предотвращает дополнительные побочные эффекты. Это соглашение должно поддерживаться принимающим сервисом; одного внутреннего номера дела для защиты недостаточно. [AWS о безопасных повторах запросов](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/)
Уточните, какие именно действия выполняет рабочий процесс. Может ли повтор создать второе обращение в поддержку или отправить ещё одно письмо? Если защититься от дублирования нельзя, перед новой попыткой проверьте запись целевой системы. Повтор генерации текста и повтор целого бизнес-процесса требуют разных решений.
## Для резервной модели нужна более узкая задача
Альтернативный ИИ-сервис может поддержать рабочий процесс, но резервный аккаунт — лишь начало плана перехода. Замена должна получить нужные инструкции, утверждённые справочные материалы и разрешение на работу с данными. Во время сбоя у неё также должны быть свободные мощности.
Прежде чем пытаться полностью заменить систему, выберите ограниченную резервную задачу. В нашем гипотетическом примере другая модель могла бы классифицировать обычные сообщения, а сотрудники — отвечать клиентам. Команда могла бы оценить её на типичных случаях, в том числе при неоднозначных названиях товаров и запросах, требующих участия человека. Беглый ответ сам по себе не докажет, что система соблюдала правила поддержки компании.
Заранее решите, какие сведения можно отправлять альтернативному сервису в случае сбоя. Сотрудникам не следует импровизировать и вставлять данные клиентов в личные аккаунты. При закупке наряду с качеством ответов и ценой проверьте условия обработки данных и порядок предоставления доступа.
Разные названия моделей сами по себе не означают независимость доступности. Резервный сервис может по-прежнему зависеть от того же входа в систему, сети, хранилища документов или программной оркестрации. Определите, от каких именно зависимостей избавляет предложенная альтернатива. Возможно, ручная очередь с доступными справочниками окажется надёжнее, чем ещё одна модель за тем же оборвавшимся соединением.
Альтернативы требуют обслуживания по мере изменения инструкций и устаревания знаний о продукции. Сотрудникам нужно тренироваться пользоваться процедурами, которые редко применяются. Небольшой бизнес может разумно сохранить более медленное ручное обслуживание вместо затрат на дублирование всей операции. Решение должно учитывать цену задержки и вред неправильного ответа.
## Возобновляйте работу с проверенной очередью
Когда поставщик объявит о восстановлении, проверьте на небольшой выборке собственный рабочий процесс и только затем возвращайтесь к обычному обслуживанию. Добавьте случай, проверяющий поиск по документам и обновление записей, необходимые бизнесу. Успешный ответ модели не доказывает, что все подключённые системы готовы.
Затем изучите накопившуюся работу. Удалите дела, уже обработанные вручную, проверьте неопределённые действия и отметьте запросы, обстоятельства которых изменились. Во время сбоя клиент мог прислать новые сведения. Составление ответа по прежней версии обращения может создать новую проблему уже после устранения технического сбоя.
Возобновляйте обработку оставшейся очереди небольшими партиями. Оставьте мощности для новых срочных запросов и следите, сокращается ли очередь. Если весь доступный ресурс уходит на входящий поток, очередь продолжит расти, даже когда каждый новый запрос обрабатывается успешно. Для наверстывания может потребоваться дополнительный персонал, временно сокращённый сервис или честное продление сроков ответа.
Рассмотрим отдельный числовой пример. Если поступает 24 обращения в час, а обработка останавливается на 30 минут, в очереди остаётся 12. Если после этого служба обрабатывает 36 обращений в час, пока продолжают поступать 24 новых, на ликвидацию очереди уйдёт час. Это иллюстративные предположения, а не измерения инцидента Claude.
Руководство Google SRE по целям уровня сервиса рекомендует начинать с важного для пользователей результата и зависимостей, необходимых для его достижения. Для этой службы показателем может быть доля срочных обращений, получивших надлежащий ответ в обещанный срок. Доступность поставщика имеет значение, но бизнесу также нужно знать, получили ли услугу его клиенты. [Google SRE: внедрение целей уровня сервиса](https://sre.google/workbook/implementing-slos/)
Записывайте время возобновления обычного обслуживания, число неразрешённых обращений и необходимость последующих исправлений. Такие показатели показывают объём восстановительной работы, невидимый для страницы статуса поставщика.
## Отрепетируйте один сбой до расширения автоматизации
Короткое командное упражнение может выявить проблемы с доступом или ответственностью, не затрагивая реальных клиентов. Возьмите несколько вымышленных обращений и пройдите такие шаги:
1. Представьте, что модель становится недоступна, пока готовит ответ. Спросите, кто включает сокращённый сервис и где сотрудники найдут исходное обращение.
2. Для одного дела укажите, что ответ точно отправлен, а для другого — что попытка отправки не подтверждена. Проверьте, знает ли команда, в какой системе можно установить результат.
3. Предположите, что поставщик восстановил работу, но обращения продолжают поступать. Решите, какая работа возобновится первой и как убрать из очереди дела, уже обработанные вручную.
4. Попросите человека, не составлявшего план, объяснить процедуру и назвать недостающие разрешения или записи.
Запишите вопросы, на которые упражнение не дало ответа. Исправления могут оказаться простыми: доступ к существующей очереди, понятная кнопка приостановки, сохранённое подтверждение или назначенный ответственный за восстановление. Ничто из этого не гарантирует непрерывную работу, но каждая мера помогает ограничить последствия сбоя, не отказываясь от преимуществ автоматизации.
Прежде чем поручить ассистенту ещё одну операционную задачу, попросите коллегу показать, как с ней будут справляться во время сбоя. Если план зависит от того, что недоступный ассистент помнит, чем он занимался, план непрерывности ещё не готов.
## Sources
- [Статус Claude: повышенное число ошибок в нескольких моделях](https://status.claude.com/incidents/7g1qpkyz5gxh) — В записи поставщика указан 80-минутный период воздействия и более позднее время устранения. Общедоступные данные JSON прочитаны независимо. В сообщении говорится о повышенном числе ошибок, а не о повсеместном сбое; объяснение первопричины не опубликовано.
- [Claude Platform: ошибки API](https://platform.claude.com/docs/en/api/errors) — Актуальная документация рассматривает ошибки, стандартные повторы SDK и сбои после начала передачи ответа. Эти механизмы не подтверждают завершение бизнес-задачи и не предотвращают дублирование действий в подключённых инструментах.
- [AWS Builders’ Library: безопасные повторы с идемпотентными API](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/) — Объяснение Малкольма Фитонби о неопределённых ответах и предотвращении дублирования. Соглашение API должно реализовываться принимающим сервисом; одного идентификатора недостаточно.
- [Google SRE: работа при перегрузке](https://sre.google/sre-book/handling-overload/) — Устоявшиеся инженерные рекомендации по сокращённой функциональности, приоритетам и ограничению повторов. В статье они адаптированы к гипотетической службе поддержки; они не устанавливают причину инцидента Anthropic.
- [Google SRE Workbook: внедрение целей уровня сервиса](https://sre.google/workbook/implementing-slos/) — Объясняет цели надёжности через результаты для пользователей и критические зависимости. Предлагаемый показатель службы поддержки и пример с очередью — иллюстративные решения, а не наблюдаемые результаты или универсальная норма.
Рассылка BIG CHANGE
Общая картина. В вашем темпе.
Свежие материалы об ИИ и робототехнике, важные перемены и практические идеи. Выберите ежедневную сводку, еженедельный дайджест или ежемесячный обзор.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ваша конфиденциальность — ваш выбор.
Необходимое хранилище помогает защитить сайт и запомнить ваши настройки. Необязательная Google Analytics отключена, пока вы её не разрешите. Все статьи доступны для чтения только с необходимым хранилищем. Подробнее о конфиденциальности