AI-translated from English; not yet reviewed by a fluent editor.
# Већа опклада компаније Jev: одлуке AI-ја у софтверу који већ користимо
> Извршни директор TypeSafe-а Диого Алмеида заговара AI заснован на малим одлукама унутар софтвера. Разматрамо лансирање Jev-а, његова ограничења и шта би потврдило значајну промену.
By BIG CHANGE Editorial
Published: 2026-09-22T00:45:03.943Z
Updated: 2026-09-22T00:45:03.943Z
Canonical: https://bigchange.ai/blog/jev-typesafe-ai-decisions-software-diogo-almeida
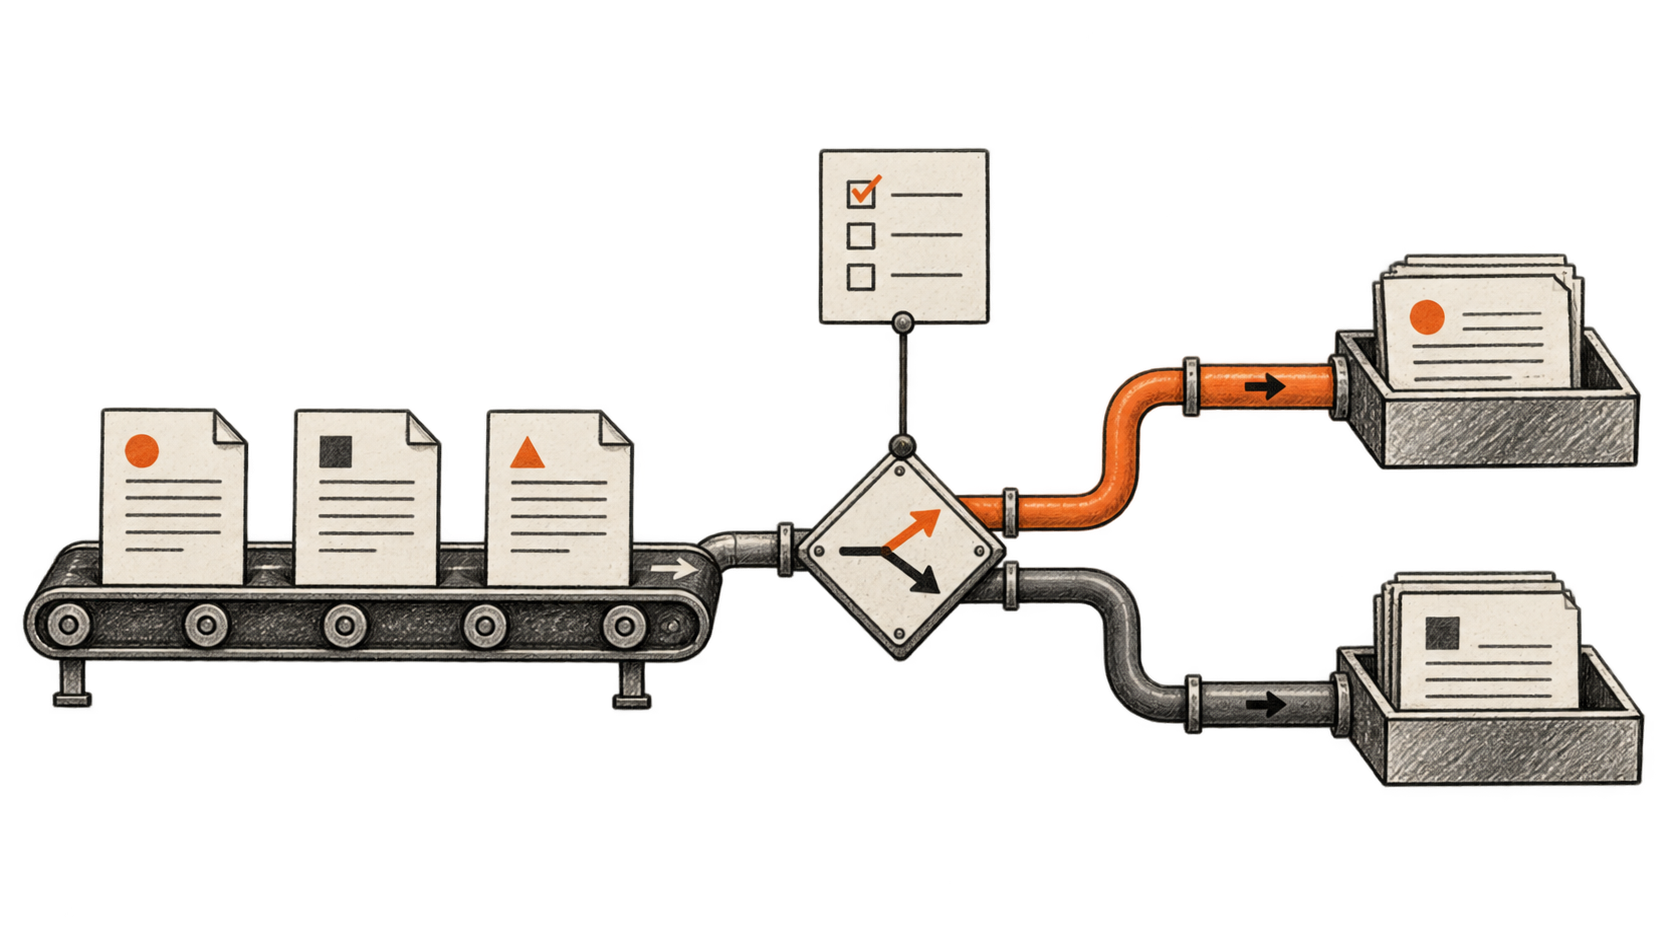
AI-generated conceptual illustration by BIG CHANGE. A decision switch inside a larger workflow; not a depiction of Jev’s internal architecture.
Купац мења адресу у поруџбини. У поруци такође тражи повраћај новца, помиње оштећен пакет и наговештава да је ово трећи пут да је нешто пошло наопако. Претварање те поруке у користан одговор један је задатак. Одлука о томе које записе ажурирати, који тим треба да интервенише и које радње захтевају дозволу други је задатак.
Jev, модел који је TypeSafe AI представио у раном приступу 15. септембра 2026, намењен је таквим одлукама. Производи ограничене, структурисане одговоре за софтвер. Лансирање позива на преиспитивање тога колико апликација треба да зависи од дугог разговора са моделом опште намене. [Најава лансирања компаније TypeSafe](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
Аргумент је најпотпуније изложен у интервјуу који је Swyx водио 21. септембра за подкаст Latent Space са суоснивачем и извршним директором TypeSafe-а Диогом Алмеидом. Прегледали смо целокупне титлове на енглеском за разговор од два сата и 22 минута и проверили документацију производа. Ово је анализа тог интервјуа и јавно доступних доказа; нисмо независно спровели бенчмарк за Jev. [Погледајте оригинални интервју](https://www.youtube.com/watch?v=cFx9Z3ZXca0)
По нашем тумачењу, најзначајнији предлог Jev-а односи се на јединицу аутоматизације. Предузеће би могло да аутоматизује ограничену процену у оквиру постојећег процеса пре него што одговорно препусти цео процес систему. Ако процена постане довољно јефтина за понављање и јасна за мерење, познати пословни софтвер могао би добити корисне могућности без претварања сваке интеракције у разговор.
То би утицало на људе који осмишљавају токове рада једнако колико и на њихове кориснике. Неко и даље мора да одлучи које су радње дозвољене, шта се сматра грешком и ко решава изузетке. Квалитет тих одлука одредиће да ли овај приступ ствара поуздане услуге или само убрзава грешке.
## Шта је TypeSafe заиста лансирао
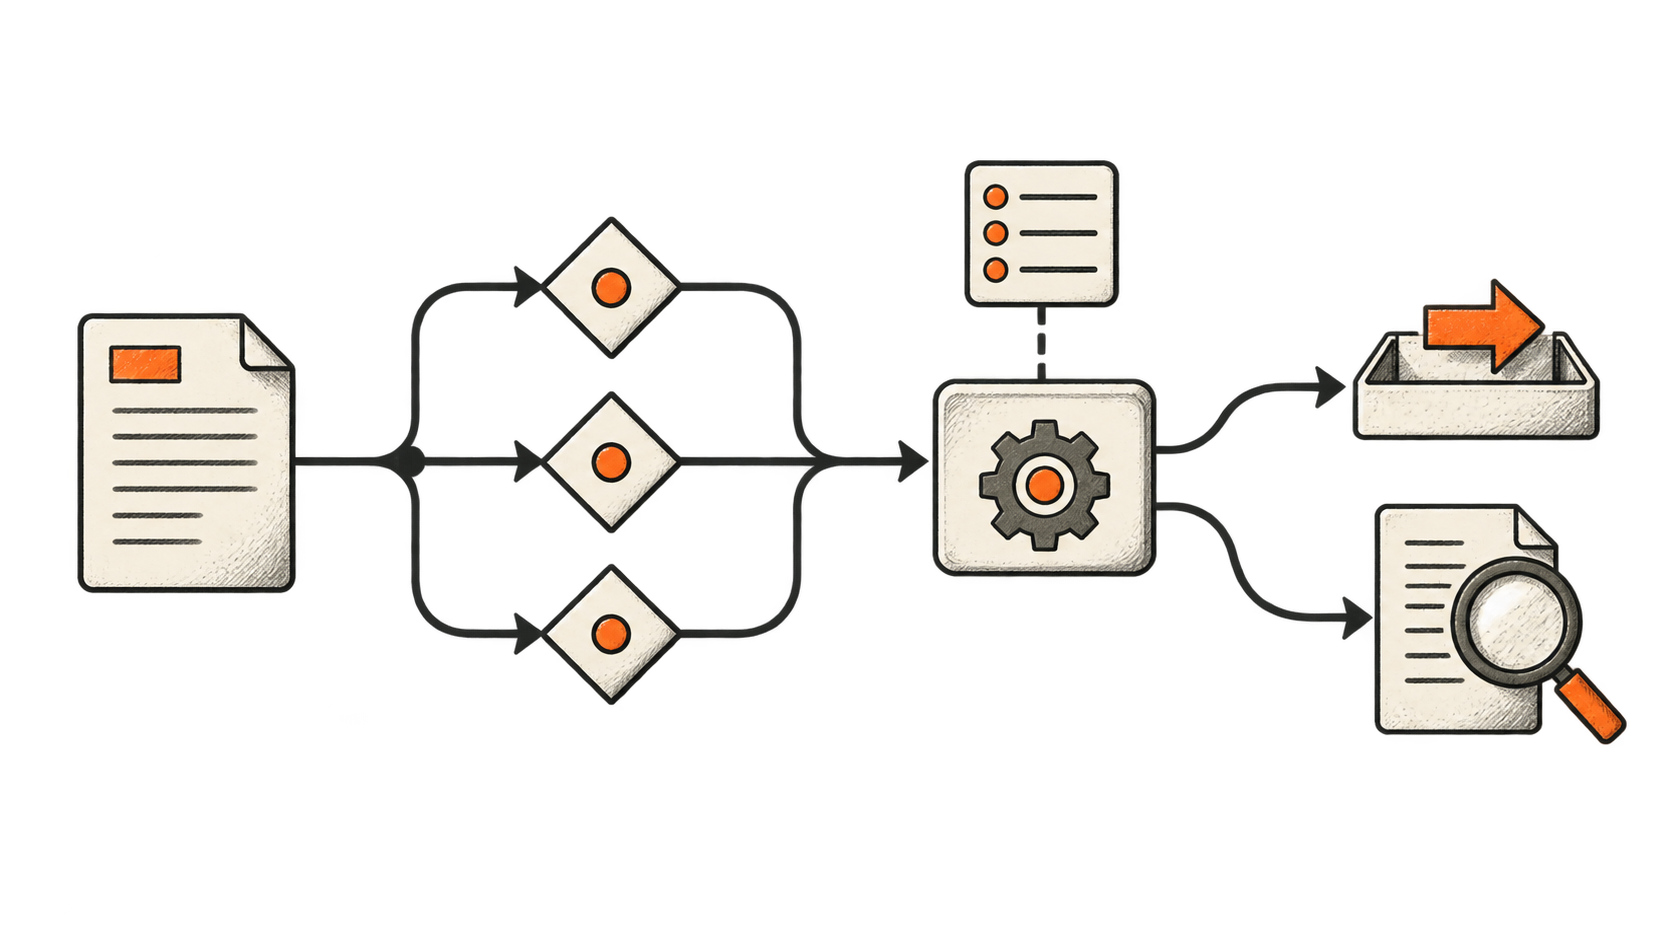
Документовани интерфејс Jev-а прима стање и скуп типизованих питања. Има три основна елемента: Choice, који бира између задатих опција; Score, који процењује према рубрици; и Noul, који изражава вероватноћу тврдње на скали од нула до један. Choice и Score враћају расподеле и поље за поузданост. Noul нема засебно поље за поузданост. Питања могу користити исто задато стање, али се процењују независно. [Документација интерфејса TypeSafe-а](https://docs.typesafe.ai/introduction)
У апликацији за корисничку подршку, програмер би могао да употреби те елементе за разликовање захтева за промену адресе од отказивања, процену хитности и проверу да ли порука садржи доказе о оштећењу. То су хипотетички примери, а не резултати примене Jev-а. Апликација би потом одлучила шта да уради са одговорима.
Корисно је што се тиме раздвајају тумачење и овлашћење. AI може закључити да купац жели повраћај новца. Самим доношењем тог закључка не треба да стекне дозволу да га одобри. Апликација може проверити поруџбину, спровести ограничење за повраћај и затражити одобрење кад је то примерено.
TypeSafe назива ову категорију модела System One, позајмљујући израз за брзо, интуитивно размишљање. Назив треба схватити као опис намераваног оптерећења. Он не потврђује сазнајне способности налик људским нити поставља јасну границу између лаких и тешких задатака. Кратко питање може прикривати сложену процену, нарочито када недостају неопходне информације.
## Инжењерска промена су мање одлуке које се могу проверити
Алмеида заговара разлагање: поставити уско дефинисана питања, а затим одговоре спојити у коду. [Интервју, 1:03:02](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=3782s)
Вратимо се примеру оштећене поруџбине. Једно упутство да се реши притужба скрива више процена унутар једног одговора. Прегледнији дизајн засебно би утврдио тражену радњу, може ли се пронаћи поруџбина и подржавају ли доступни докази тврдњу о оштећењу. Правила пословања остала би изван тих процена.
Тако је грешку лакше истражити. Ако систем упути захтев за промену адресе тиму за повраћаје, оператер може да прегледа ту одлуку о усмеравању. Ако је процена оштећења погрешна, та компонента може да се тестира на основу ранијих случајева. Промена правила може изменити изричито дефинисано правило, без преписивања широког упутства и надања да ће га модел доследно тумачити.
То има и цену. Више компоненти значи више интерфејса за одржавање. У питањима се може случајно изоставити контекст који разјашњава одговор. Две наизглед независне процене могу зависити од истог обмањујућег доказа. Ток рада састављен од појединачних прихватљивих делова и даље може произвести неприхватљив исход.
Документовани обрасци TypeSafe-а обухватају истовремено постављање више питања, спајање оцена и усмеравање неизвесних случајева на додатну обраду. Они описују архитектонске могућности, а не доказују да је одређени кориснички процес спреман за рад без надзора. [Обрасци TypeSafe-а](https://docs.typesafe.ai/patterns)
Корисно је тестирати да ли разлагање унапређује и дијагностику и исходе. Могућност да се објасни који корак је заказао има вредност. Пословни разлог за примену јесте смањење учесталости и последица таквих грешака.
## Валидан одговор и даље може бити погрешан
Тврдњу из најаве да Jev „не може да халуцинира“ треба уско тумачити. TypeSafe гаранцију везује за подударање са дозвољеном излазном шемом. То не доказује истинитост изабраног одговора. У сопственој најави компанија разликује гаранцију шеме од емпиријске процене. [Објашњење типске безбедности TypeSafe-а](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
Претпоставимо да апликација допушта вредности `damaged`, `late` и `other`. Враћање вредности `damaged` потпуно је валидно чак и ако је пакет само каснио. Модел који не може да измисли четврту категорију и даље може изабрати погрешну. Ако списак изоставља категорију која је заиста потребна, сама шема постаје део проблема.
Структурисани излаз је и постојећи инжењерски приступ. OpenAI је у августу 2024. представио излазе ограничене шемом и изричито напоменуо да модел и даље може погрешити унутар враћених вредности. Зато Jev треба процењивати према конкретној комбинацији квалитета одлука, извештавања о неизвесности, кашњења и трошка, а не приписивати му изум свих структурисаних AI излаза. [Првобитна најава и ограничења компаније OpenAI](https://openai.com/index/introducing-structured-outputs-in-the-api/)
За купце ова разлика мења план процене. Тест шеме проверава може ли софтвер да обради одговор. Тест чињеничне тачности проверава слаже ли се одговор са доказима. Тест правила проверава да ли је последична радња дозвољена. Успех на једном тесту не замењује успех на осталима.
## Најважнији изазов у интервјуу тиче се калибрације
У 1:09, Алмеида одбацује идеју савршене калибрације и признаје да модели греше. [Интервју, 1:08:50](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4130s)
Калибрација се односи на поређење предвиђених вероватноћа са уоченим исходима у групама предвиђања. Модел може бити користан за означавање неизвесности иако није у праву у сваком случају са високом предвиђеном вероватноћом. У уводном тексту TypeSafe-а та разлика је изричито сачувана. [Објашњење калибрације TypeSafe-а](https://docs.typesafe.ai/introduction/machine-learning-primer)
Поље за поузданост у API-ју захтева још једно разликовање. TypeSafe га описује као статистику изведену из расподеле одговора. Оно се не може изједначити са независно измереном вероватноћом да је изабрани одговор тачан. Документација препоручује да се прагови одаберу према задатку и његовим последицама. [Документација о поузданости TypeSafe-а](https://docs.typesafe.ai/confidence)
То су практичне недоумице. Замислимо да модел за усмеравање добро ради на кратким порукама на енглеском, али се мучи са дугим притужбама које спајају више захтева. Једна збирна оцена може прикрити ту слабост. Одлука високе поузданости из слабије групе можда заслужује већу проверу од истог приказаног броја за добро познату групу.
Зато тим треба да процени случајеве које очекује, укључујући недостајуће информације, непознате формулације и намерно збуњујуће уносе. Треба да прегледа грешке по категоријама и упореди цену слања случаја на проверу са ценом погрешне радње. Прагови постају оперативне одлуке поткрепљене доказима, а не бројеви преписани из демонстрације.
Истраживање калибрације постоји знатно дуже од Jev-а. Често цитиран рад Чуана Гуа и колега из 2017. испитао је лошу калибрацију савремених неуронских мрежа и методе за њено побољшање. Тај рад даје контекст проблему, али не потврђује модел TypeSafe-а. [О калибрацији савремених неуронских мрежа](https://arxiv.org/abs/1706.04599)
## Поузданост обухвата и оно што се дешава када се услуга промени
Разговор разликује робусност од детерминистичности и разматра стабилност верзија без општег обећања дугорочне подршке. [Интервју, 41:24](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2484s) и [49:40](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=2980s)
То су засебна питања за куповину. Детерминистичност пита да ли идентични улази производе идентичне излазе. Робусност пита да ли неважна промена, као што је другачији идентификатор записа, изазива неразумну промену у понашању. Модел може бесконачно понављати исти погрешан одговор и бити детерминистичан. Може и незнатно осцилирати док околни ток рада остаје поуздан.
Ниједно својство не решава ризик током животног циклуса. Предузеће мора знати која ревизија модела је донела одлуку, да ли ће та ревизија остати доступна и како ће се проценити замена. Побољшање на тестовима добављача и даље може променити понашање пажљиво подешеног радног тока купца.
Разуман одговор је сачувати репрезентативне случајеве, бележити верзије и упоредити замену пре преласка важних послова. Потребна је и резервна опција: услуга одлучивања која је иначе тачна може постати недоступна. Ако апликација нема безбедан начин да паузира рад или га усмери другде, у пракси и време непрекидног рада постаје део квалитета одлучивања.
Ту се привлачан API претвара у оперативну зависност. Набавка, надзор и планирање преласка не нестају када модел постане бржи. Лакше их је занемарити јер појединачни позив изгледа тако једноставно.
## Зашто бројке о брзини и цени треба ставити у контекст
Истакнути резултати токова рада TypeSafe-а укључују побољшање брзине од 193,6 пута и трошка од 444,6 пута. У најави се наводи да су то највећа побољшања у токовима рада које је осмислила компанија. Референтни одговори потичу од процена вероватноће других модела, а не од независно проверених класификација са утврђеним основним вредностима. Компанија такође упозорава да кратка демонстрација иде у прилог Jev-у и да дугорочно одрживе цене тек треба утврдити. [Ограничења евалуације које наводи TypeSafe](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
Те ограде треба наводити заједно са бројкама. Слагање са референтним моделом може бити информативно, али мери нешто друго од тачности у поређењу са разрешеним случајем купца. Ток рада који је осмислио добављач може бити релевантан купцу, али не представљати расподелу његових захтева.
Право поређење треба да обухвати цео посао: прикупљање контекста, доношење одлука, примену правила, обраду изузетака и опоравак после неуспеха. Јефтинији позив моделу може ићи уз већи укупни трошак ако превише посла пребаци рецензентима. Спорији позив може бити исплатив ако избегава скупо преправљање.
Кашњење треба мерити и из стварног региона апликације. Демонстрација у близини инфраструктуре услуге није обећање о искуству корисника на другој локацији. Интерактивни системи треба да испитују и споре захтеве, а не само просек; код обраде у позадини важнији могу бити пропусност и укупан трошак.
Назив Jev упућује на идеју да ефикасност може проширити потрошњу. За појединачно предузеће то отвара буџетско питање: које нове одлуке вреди процењивати, а које је само постало довољно јефтино да се непотребно процењују? Више позива моделу само по себи није резултат.
## Другачији истраживачки циљ уз недовршене доказе
Алмеидин истраживачки аргумент повезује податке, избор задатка и RLCD са његовом критиком оптимизације преференција. [Интервју, 7:23](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=443s) и [22:12](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=1332s)
RLCD је скраћеница за Reinforcement Learning for Calibrated Decisions, односно учење поткрепљивањем за калибрисане одлуке. TypeSafe га представља као обуку усмерену на употребљиве одлуке и вероватноће, насупрот приступима заснованим на људским преференцијама и проверљивим наградама. То је опис циља компаније. Не треба га мешати са независном провером целокупног метода обуке. [Уводни текст TypeSafe-а о AI-ју](https://docs.typesafe.ai/introduction/machine-learning-primer)
Шире питање вреди истражити док се метод процењује: какво понашање награђује циљ обуке? Модел оптимизован за уверљиво објашњење може бити пријатан за коришћење, а да не изрази неизвесност у облику на основу ког софтвер може да делује. Интерфејс оријентисан на одлучивање може олакшати рад са неизвесношћу, али његове излазе и даље треба споља проверити у односу на стварност.
TypeSafe повезује ову забринутост са сужавањем распона излаза: оптимизација преференција може сузити вероватне одговоре ка онима које људи награђују. То је објашњење могућег пропуста које даје компанија, а не налаз да је сваки модел обучен преференцијама неупотребљив за доношење одлука. [Разматрање оптимизације преференција компаније TypeSafe](https://docs.typesafe.ai/introduction/machine-learning-primer)
Алмеидино искуство чини овај аргумент посебно занимљивим. Један је од коаутора рада InstructGPT, који је проучавао обучавање језичких модела за праћење упутстава помоћу људских повратних информација. То ауторство може да се провери; свеобухватне тврдње о томе у чему греше све лабораторије сасвим су друга ствар. [Рад InstructGPT](https://arxiv.org/abs/2203.02155)
Његови приговори на трошкове претходног обучавања и нове лабораторије без јасног циља део су истог аргумента о избору корисних задатака. [Интервју, 1:49:32](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6572s) и [2:03:10](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7390s)
За купца је важна поука да пита шта производ може да уради у оквиру дефинисаног процеса. Истраживачко искуство, рачунарски трошкови и препознатљива архитектура модела могу објаснити како је компанија дошла до понуде. Не могу доказати економску исплативост примене у туђем предузећу.
Интервју обухвата и Алмеидин одлазак из OpenAI-ја, тешкоће раног усвајања и раст подстакнут програмерима. [Интервју, 1:31:27](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5487s) и [1:56:48](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7008s)
Та сећања објашњавају приоритете компаније. Она нису ревидирани докази о усвајању производа. Развојну платформу на крају треба процењивати према трајним, корисним оптерећењима и подршци коју пружа када та оптерећења закажу. Одушевљење после лансирања разлог је за испитивање, а не замена за такве податке.
## Постојећи софтвер може добити више од новог прозора за разговор
Алмеида предвиђа боље SaaS производе и AI који се повлачи у позадину. [Интервју, 1:19:57](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4797s)
Ово је уверљив смер за истраживање јер софтвер већ садржи места на којима корисна процена може променити следећи корак. Апликација за заказивање могла би да открије нејасан захтев пре резервисања. Архива медија могла би да разврста материјал за истраживача. Служба подршке могла би да разликује рутинско ажурирање од притужбе која захтева пажњу. То су могући дизајни, а не објављене примене Jev-а.
Кориснички интерфејс можда се готово неће променити. Корисници би приметили мање грешака, мање понављајућег разврставања или краће чекање на праву особу. Комерцијалну предност могле би стећи компаније које већ разумеју ток рада и умеју да уграде боље одлуке у њега.
И постојећа софтверска предузећа и даље би се суочавала са конкуренцијом. Ако исти суд постане доступан многим програмерима, сам позив моделу мало разликује производ. Пратећи производ мора да обезбеди корисне податке, промишљено осмишљену интеракцију и поуздан начин довршавања посла.
Тврдње о запослености захтевају већу уздржаност. Смањење труда за један задатак могло би да промени број запослених, повећа обим услуге или пребаци посао на изузетке. Исходи зависе од организације и потражње за њеном услугом. Ни интервју ни лансирање у раном приступу не доказују да ће одређен број радних места бити сачуван, укинут или отворен.
За индустријски преглед BIG CHANGE-а мерљиви догађај је доступност још једног приступа аутоматизацији одлука. Шире усвајање, повећање продуктивности и ефекти на тржиште рада каснија су питања која захтевају другачије доказе.
## Мрачни подаци, софтвер у реалном времену и ограничења демонстрације
У интервјуу се разматрају сачувани подаци, интерактивне апликације, провера и демонстрације управљања рачунаром. [Интервју, 1:34:50](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5690s)
Свака категорија захтева другачију процену. Посао обраде архиве може да поднесе извесно кашњење, али захтева план узорковања резултата и праћења до изворних записа. Интерфејсу у реалном времену потребна је предвидљива брзина реаговања. Проверавач који оцењује други модел мора се тестирати на стварним грешкама тог модела, укључујући случајеве у којима оба система праве исту грешку.
Код управљања рачунаром, избор радње само је део система. Потребни су му и тачан приказ интерфејса, начин извршења радње и провера да ли је дошло до очекиване промене. Углађена демонстрација може доказати да је низ радњи једном спроведен; поуздана аутоматизација захтева поновљена испитивања и опоравак од прекида.
Исто упозорење важи за игре. Лик чије поступке усмерава модел могао би да реагује на богатије стање, док игра и даље одређује које су радње могуће. Да ли то побољшава игру зависи од брзине реаговања, доследности и дизајна искуства. Додавање закључивања сваком кадру не би аутоматски учинило игру занимљивијом.
Ове разлике спречавају категоријалну грешку: корисну компоненту треба ценити за улогу коју обавља, а да јој се не приписују све могућности веће апликације која је окружује.
Фино подешавање, вид и додатни облици модела појављују се као могућности у интервјуу. [Интервју, 1:10:27](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=4227s) и [1:26:23](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=5183s)
Разговор о плановима за будућност не сме постати зависност у плану лансирања. Градите на основу доступног интерфејса, утврдите шта мора да обезбеди засебна компонента и процените сваку нову могућност када заиста стигне. Тако остаје простор за корист од будућих побољшања, без представљања претпоставки као функција производа.
## Агенти за кодирање могли би другачије да деле посао
Алмеида предлаже јефтинију обраду стања и заједнички контекст за агенте за кодирање, уместо петље са једним моделом. [Интервју, 1:40:17](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6017s) и [2:09:29](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=7769s)
Једна могућа архитектура користила би способан модел за кодирање да осмисли измену, мање позиве за одлучивање да разврстају релевантне датотеке, а уобичајени софтвер да управља насталим задацима. Засебни рецензент могао би да прегледа завршну закрпу. То је предлог дизајна, а не бенчмарком проверена препорука нити доказ да Jev већ замењује постојећег агента за кодирање.
Привлачна страна је селективан контекст. Ако је подзадатку потребан само један интерфејс и неколико ограничења, слање целог разговора може бити расипно. Изричито забележени задаци олакшали би утврђивање важних чињеница, већ донетих одлука и преосталих измена.
Опасност је у мешању предлога за координацију са гаранцијом паралелног рада. Два агента могу истовремено закључити да треба да измене исту датотеку. Вероватносни модел не треба да замени софтверске механизме за спречавање сукоба при упису. Дозволе, провере верзија и закључавање и даље морају да спроведу жељени исход.
Исто тако, јефтиније проналажење ранијег рада може побољшати управљање меморијом, а да не реши сваки проблем који се назива континуираним учењем. Памћење претходног покушаја, разумевање разлога његовог неуспеха и поуздано прилагођавање новој ситуацији засебне су способности. Уверљива процена испитала би завршене задатке, регресије, сукобе и људске интервенције, а не само број агената или позива.
## Безбедност се преноси кроз систем; не ишчезава
Алмеида даје предност безбедносним контролама на нивоу апликације у односу на одбијања модела, а Swyx преиспитује последице. [Интервју, 13:11](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=791s) и [1:42:29](https://www.youtube.com/watch?v=cFx9Z3ZXca0&t=6149s)
Овде постоји стварни проблем дизајна: апликација без надзора мора да поднесе ситуације у којима зависна компонента одбије захтев, откаже или врати неизвесан резултат. Потребан јој је изричит поступак реаговања. Та примедба сама по себи не одређује где треба поставити сваку заштитну меру.
Апликација треба да спроведе дозволе приступа чак и када модел исправно утврди намеравану радњу. Захтев за брисање записа може бити потпуно јасан, а ипак неовлашћен. Захтев такође може бити технички ваљан, али кршити правила оператера. Служба за одлучивање не може одговорно решити та питања без одговарајућег контекста, а апликација мора задржати контролу над радњом.
Зато већи број одлука у софтверу повећава важност дефинисања граница пре увођења. Тимови морају одлучити који докази су неопходни, које операције остају реверзибилне и како особа може оспорити или исправити исход. Уклањање незгодне интеракције са моделом није довољан доказ безбедности целог система.
## Шта би потврдило велику промену
Лансирање омогућава јасан експеримент. Изаберите један ограничен процес са видљивим исходом. Забележите како се данас обавља, укључујући грешке и време које људи троше на њихово поправљање. Испробајте верзију засновану на одлучивању на репрезентативним случајевима пре него што јој дате овлашћење за деловање.
Измерите удео случајева исправно завршених без интервенције, грешке које прођу преглед, количину посла пребачену људима и укупан трошак по завршеном случају. Сачувајте изворне доказе да би рецензент могао да провери зашто је резултат прихваћен. Поновите поређење кад се промене модел, правила или група улазних података.
Евалуација може показати да је спреман само део процеса. И то је користан резултат. Аутоматизација рутинског разврставања уз препуштање нејасних случајева искусном оператеру може бити исплатива, а да не оправдава ширу аутономију.
Лансирање Jev-а и Алмеидин интервју износе амбициозну хипотезу о начину на који AI улази у економију: понављајуће одлуке са јасним ограничењима могу унапредити софтвер од ког људи већ зависе. Следећи докази треба да дођу из система који тај посао обављају током времена, уз урачунате грешке и изузетке. Тада занимљива архитектура модела постаје промена коју читаоци заиста могу да виде.
## Sources
- [Оригинални интервју за Latent Space](https://www.youtube.com/watch?v=cFx9Z3ZXca0) — Интервју Latent Space-а са Диогом Алмеидом, објављен 21. септембра 2026. Временске ознаке су наведене у анализи.
- [Представљамо System One моделе и Jev](https://typesafe.ai/blog/introducing-system-one-models-and-jev) — 15. септембар 2026. Најава раног приступа моделу Jev компаније TypeSafe, са тврдњама о учинку и ограничењима евалуације.
- [Увод](https://docs.typesafe.ai/introduction) — Документација TypeSafe-а која објашњава улазно стање модела и питања Choice, Score и Noul.
- [Поузданост](https://docs.typesafe.ai/confidence) — Документација TypeSafe-а која разликује поузданост од вероватноће и објашњава како апликације могу да користе прагове.
- [Уводни текст о AI-ју](https://docs.typesafe.ai/introduction/machine-learning-primer) — Објашњење циља обуке и значења калибрације у групама предвиђања које даје TypeSafe.
- [Обрасци](https://docs.typesafe.ai/patterns) — Примери TypeSafe-а који показују спајање одлука модела са логиком апликације.
- [Представљамо структурисане излазе у API-ју](https://openai.com/index/introducing-structured-outputs-in-the-api/) — 6. август 2024. OpenAI-јево представљање излаза ограничених шемом и њихових ограничења.
- [О калибрацији савремених неуронских мрежа](https://arxiv.org/abs/1706.04599) — Истраживачки рад Чуана Гуа и колега из 2017. о калибрацији неуронских мрежа. Овај рад не процењује Jev.
- [Обучавање језичких модела да прате упутства уз људске повратне информације](https://arxiv.org/abs/2203.02155) — Истраживачки рад о InstructGPT-у из 2022, чији је коаутор Диого Алмеида, о праћењу упутстава уз људске повратне информације.
Билтен BIG CHANGE
Шира слика. Вашим темпом.
Недавне приче о вештачкој интелигенцији и роботици, промене вредне праћења и практичне идеје за примену. Изаберите дневни преглед, недељни сажетак или месечну перспективу.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
Ваша приватност, ваш избор.
Неопходно складиште доприноси безбедности сајта и памти ваше изборе. Опционални Google Analytics остаје искључен док га не дозволите. Све чланке можете читати само уз неопходно складиштење података. Детаљи о приватности