AI-translated from English; not yet reviewed by a fluent editor.
# Vals AI-இன் coding சோதனையில் ஒரு agent குழு 7.3 புள்ளிகள் உயர்ந்தது; ஆனால் செலவு 2.5 மடங்கு
> 50 app உருவாக்கங்களில், நடுத்தர reasoning effort கொண்ட GPT 6 Sol குழுவில் மட்டுமே Vals AI புள்ளியியல் முக்கியத்துவமுள்ள குழு முன்னேற்றத்தைக் கண்டது; அந்த அமைப்பின் app ஒன்றுக்கான செலவு $1.22-க்கு பதிலாக $3.07.
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
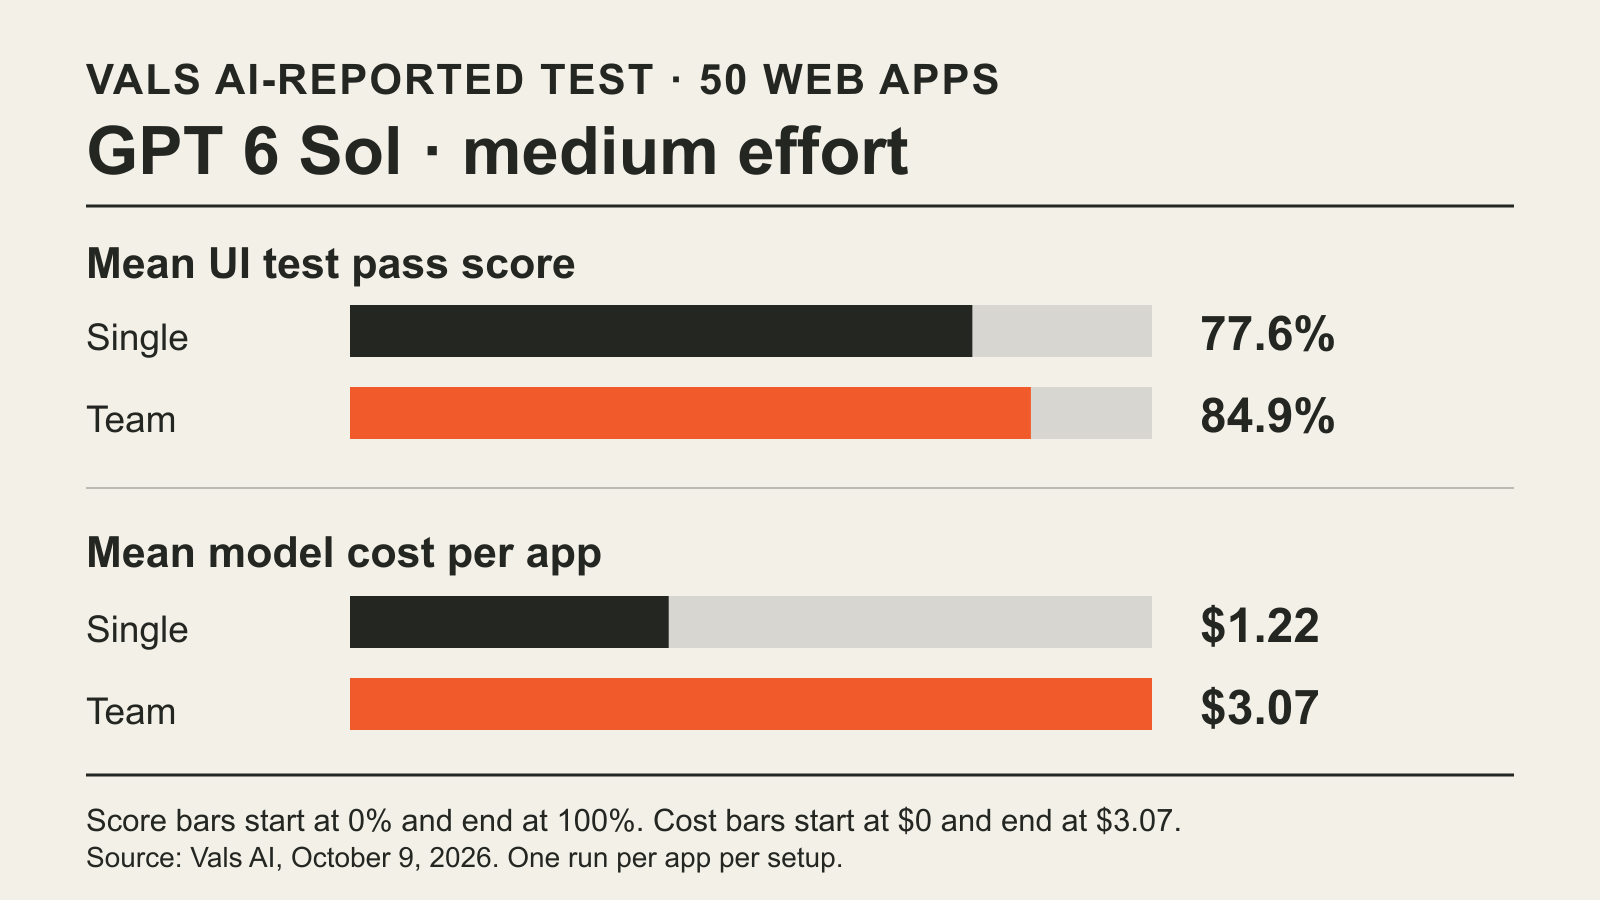
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
Vals AI-யின் அக்டோபர் 9 ஆய்வில் நான்கு paired ஒப்பீடுகளில் ஒன்றில் agent குழுவால் coding agent மேம்பட்டது [Vals AI Vibe Code Bench ஆய்வு, அக்டோபர் 9](https://www.vals.ai/blogs/multi-agent-vibe-code-bench). நடுத்தர reasoning effort கொண்ட GPT 6 Sol குழு benchmark app சோதனைகளில் 84.9% தேர்ச்சி பெற்றது; தனி Sol agent 77.6% பெற்றது. 7.3 percentage-point உயர்வுக்கான சராசரி செலவு app ஒன்றுக்கு $1.22-க்கு பதிலாக $3.07. அந்த உயர்வுக்கான 95% இடைவெளி 2.3 முதல் 12.4 புள்ளிகள் என்றும் paired test p-value 0.005 என்றும் Vals தெரிவித்தது. மற்ற மூன்று team-versus-single ஒப்பீடுகளிலும் score வேறுபாடு புள்ளியியல் ரீதியாக குறிப்பிடத்தக்கதாக இல்லை.
குழுக்கள் “சிறந்தவையா” என்பதைக் காட்டிலும், இந்த முடிவு developers-க்கு இன்னும் துல்லியமான budget கேள்வியை எழுப்புகிறது. இந்த web-app உருவாக்கத் தொகுப்பில், நடுத்தர effort கொண்ட Sol கிட்டத்தட்ட அதே median நேரத்தில், app ஒன்றுக்கு சுமார் $1.85 கூடுதல் செலவில் அளவிடக்கூடிய தர உயர்வை வழங்கியது. அதிக effort-இலும் Claude Opus 5.5-ன் இரு effort நிலைகளிலும், குழுவுக்கான கூடுதல் செலவு இந்தச் சோதனையில் score மேம்பாட்டை நிரூபிக்கவில்லை.
## பெரிய மாற்றம்
- **என்ன மாறியது:** அதே 50 web-app பணிகளில், இரண்டு reasoning நிலைகளில், தனி coding agents-ஐ Vals குழுக்களுடன் ஒப்பிட்டது. நடுத்தர effort கொண்ட Sol மட்டுமே புள்ளியியல் முக்கியத்துவமுள்ள குழு score உயர்வைக் காட்டியது.
- **ஏன் முக்கியம்:** வென்ற குழு அமைப்பு app ஒன்றுக்கு 2.5 மடங்கு செலவானது; மற்ற குழுக்கள் குறிப்பிடத்தக்க score உயர்வின்றி 1.8 முதல் 5.1 மடங்கு செலவானது. குழு வடிவமைப்பும் model அமைப்புகளும் ஒரே வாங்குதல் முடிவின் பகுதிகள்.
- **எதை கவனிக்க வேண்டும்:** மீண்டும் இயக்குதல் மற்றும் வேறு software பணிகளில் சோதனை செய்வது, இந்த குறிப்பிட்ட apps-ஐத் தாண்டியும் உயர்வு நிலைக்கிறதா என்பதைக் காட்டலாம். இந்த ஆய்வில் ஒவ்வொரு அமைப்பும் ஒருமுறை மட்டுமே இயக்கப்பட்டது.
## எட்டு இயக்கங்கள் எதை அளந்தன
GPT 6 Sol மற்றும் Claude Opus 5.5-ஐ கொண்டு product specifications-இலிருந்து 50 முழுமையான web apps உருவாக்குமாறு Vals கேட்டது. Docker Compose மூலம் apps செயல்படுத்தப்பட்டன; UI tests இயக்கிய browser agents அவற்றை மதிப்பிட்டன. தெரிவிக்கப்பட்ட score என்பது ஒவ்வொரு app-இன் tests-இல் தேர்ச்சி பெற்றவற்றின் சராசரி விகிதம். [benchmark முறை ](https://www.vals.ai/benchmarks/vibe-code) ஒவ்வொரு app specification-லும் 20 முதல் 60 automated tests உள்ளன என்றும், ஒரு test-இன் steps-ல் குறைந்தது 90% வெற்றியடைந்தால் அது தேர்ச்சி எனக் கருதப்படும் என்றும் கூறுகிறது.
ஒவ்வொரு model-க்கும், நடுத்தர மற்றும் அதிக reasoning effort நிலைகளில், ஒரே agent-ஐ ஒரே நேரத்தில் அதிகபட்சம் ஐந்து subagents-க்கு பணிகளை ஒப்படைக்கக்கூடிய lead agent-உடன் Vals ஒப்பிட்டது. பணியைப் பிரித்து, ஒப்படைத்து, ஒருங்கிணைத்து, சரிபார்க்கும் கூடுதல் அறிவுறுத்தலும் leads-க்கு வழங்கப்பட்டது. ஒவ்வொரு model ஒப்பீட்டிலும் task prompt, sandbox, grader ஆகியவை மற்றபடி ஒரேபோல வைக்கப்பட்டன. எட்டு அமைப்புகள் ஒவ்வொன்றும் 50 apps-ஐ தலா ஒருமுறை உருவாக்கின.
| Model மற்றும் effort | தனி agent score | குழு score | app ஒன்றுக்கான சராசரி செலவு: தனி → குழு | median நேரம்: தனி → குழு |
| --- | --- | --- | --- | --- |
| GPT 6 Sol, நடுத்தரம் | 77.6% | 84.9% | $1.22 → $3.07 | 12.4 → 11.9 நிமிடம் |
| GPT 6 Sol, அதிகம் | 89.0% | 90.4% | $4.82 → $8.54 | 38.4 → 27.6 நிமிடம் |
| Claude Opus 5.5, நடுத்தரம் | 91.5% | 91.2% | $4.08 → $9.10 | 20.3 → 26.6 நிமிடம் |
| Claude Opus 5.5, அதிகம் | 89.8% | 93.2% | $23.77 → $122 | 74.7 → 174.1 நிமிடம் |
இவை ஒரு app உருவாக்கத்துக்கான Vals model-களின் சராசரி செலவுகள்; subscription விலையோ UI test ஒன்றை வெற்றிகரமாக்கும் செலவோ அல்ல. இயக்க நேரங்கள் wall-clock median-கள் என்பதால், ஒவ்வொரு வரியிலும் செலவும் நேரமும் 50 இயக்கங்களை வெவ்வேறு விதமாகச் சுருக்குகின்றன. அதிக-effort Opus குழுவின் சராசரியில் timeout ஆன ஒரு இயக்கமும் அடங்கும்; token எண்ணிக்கையிலிருந்து அதன் சுமார் $189 செலவை Vals மதிப்பிட்டது.
## அமைப்பைப் பொறுத்து முடிவு ஏன் மாறுகிறது
ஒவ்வொரு குழுவையும் அதற்குரிய தனி agent-உடன் அதே apps-இல் paired t-test மூலம் Vals ஒப்பிட்டது. அதிக-effort Sol குழு 1.4 புள்ளிகள் உயர்ந்தது; 95% இடைவெளி −1.7 முதல் 4.5 புள்ளிகள். நடுத்தர-effort Opus குழு 0.3 புள்ளிகள் குறைவாகப் பெற்று, இடைவெளி −3.2 முதல் 2.5; அதிக-effort நிலையில் 3.4 புள்ளிகள் உயர்ந்து, இடைவெளி −1.4 முதல் 8.3. இந்த இடைவெளிகளில் உயர்வே இல்லாத நிலையும் அடங்குகிறது. இந்த அமைப்புகளில் குழுக்கள் ஒருபோதும் உதவாது என்று அவை நிரூபிக்கவில்லை; ஆனால் இந்தச் சோதனை உயர்வை நிறுவவில்லை.
Sol-க்கு reasoning effort-ஐச் செலவிடுவதும் தனியாகச் சோதிக்கப்பட்ட தேர்வாகும். தனி Sol agent-ஐ நடுத்தரத்திலிருந்து அதிக effort-க்கு உயர்த்தியபோது score 77.6%-இலிருந்து 89.0%-ஆக உயர்ந்தது; இது புள்ளியியல் முக்கியத்துவமுடையது என Vals தெரிவிக்கிறது. அந்த அதிக-effort தனி agent app ஒன்றுக்கு $4.82 செலவாகி, median-ஆக 38.4 நிமிடங்கள் எடுத்தது; நடுத்தர-effort குழுவுக்கு $3.07 மற்றும் 11.9 நிமிடங்கள். அந்த இரண்டு அமைப்புகளுக்கிடையிலான 4.1-point score வேறுபாடு புள்ளியியல் முக்கியத்துவமுடையதல்ல (p = 0.08). புதிய project-இல் எந்த அமைப்பு வெல்லும் என்று ஊகிக்காமல், அளவிடப்பட்ட விலை-நேர பரிமாற்றத்தை இந்த எண்கள் developer-க்கு காட்டுகின்றன.
குழுக்கள் நேரத்தையும் வெவ்வேறு விதமாகப் பகிர்ந்தன. Vals-ன் படி Sol lead விரைவாகவே பணியை ஒப்படைத்து, ஒருங்கிணைத்த app-ஐத் தானே சோதித்தது. அதிக-effort குழு median 27.6 நிமிடங்களில் முடித்தது; தனி agent-க்கு 38.4 நிமிடங்கள். Opus leads பகிரப்பட்ட ஒப்பந்தத்தை எழுதிவிட்டு கட்டங்களாக ஒப்படைத்தன. அதிக effort-இல் குழு median 174.1 நிமிடங்கள் எடுத்தது; தனி agent 74.7 நிமிடங்கள், மேலும் app ஒன்றுக்கு சுமார் ஐந்து மடங்கு செலவானது. subagents-ன் தனித்தனி context-களில் உள்ள cached input tokens கூடுதல் கட்டணத்தின் பெரும்பகுதி என Vals கூறுகிறது.
## இந்தக் கண்டுபிடிப்பை எவ்வளவு தூரம் எடுத்துச் செல்லலாம்
முக்கியத்துவ இடைவெளிகள் 50 apps இடையிலான வேறுபாடுகளை பிரதிபலிக்கின்றன; அதே app-ஐ மீண்டும் முயற்சிப்பதில் ஏற்படும் மாறுபாட்டை அல்ல. வேறு ஓட்டம் ஒப்பீட்டை மாற்றலாம். குழு ஓட்டங்களுக்கு கூடுதல் delegation அறிவுறுத்தலும் இருந்ததால், குழு மற்றும் அறிவுறுத்தல் இணைந்த அமைப்பையே சோதனை அளந்தது. Sol, OpenAI Agents API-ஐயும் Opus, Claude Code-ஐயும் பயன்படுத்தின; models இடையிலான score ஒப்பீடுகளும் வேறுபட்ட harness-களை கலக்கின்றன. Sol செலவு மதிப்பீடுகள் subagents-ஐ அறிக்கையிடப்பட்ட token பயன்பாடு உள்ளடக்குகிறது எனக் கருதுகின்றன; request-level பயன்பாட்டு தரவு இல்லாததால் long-context வரம்பைத் தாண்டும் கோரிக்கைகளின் அதிக விலையை கணக்கில் கொள்ளவில்லை.
இந்த ஆய்வு வரையறுக்கப்பட்ட முடிவையே ஆதரிக்கிறது: இந்த அமைப்புகளில் இதேபோன்ற full-stack apps உருவாக்கும்போது, நடுத்தர-effort Sol குழு அதிக செலவில் அளவிடக்கூடிய உயர்வைக் காட்டியது; மற்ற குழுக்கள் நம்பகமான score உயர்வைக் காட்டவில்லை. வேறு codebase, model, அல்லது பணியை வேறு விதமாகப் பிரித்து சரிபார்க்கும் workflow-இல் குழுக்கள் பயனளிக்குமா என்பதை இது தீர்மானிக்காது. BIG CHANGE, வெளியிடப்பட்ட Vals கட்டுரையையும் முறையையும் ஆய்வு செய்தது; benchmark-ஐ இயக்கவோ மீண்டும் உருவாக்கவோ இல்லை.
## Sources
- [Vals AI, Agent குழுக்கள் பயன் தருமா? Vibe Code Bench குறித்த வழக்காய்வு](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — அசல் பரிசோதனை அறிக்கை. அதன் score, செலவு, நேரம், paired-test இடைவெளிகள் மற்றும் p-value-கள், குழு நடத்தை, செயலாக்க விவரங்கள் மற்றும் வரம்புகள் கட்டுரைக்கு ஆதாரம். எட்டு அமைப்புகளும் 50 apps ஒவ்வொன்றிலும் ஒருமுறை இயக்கப்பட்டன; தெரிவிக்கப்பட்ட uncertainty apps-க்கிடையிலான வேறுபாடுகள், மீண்டும் முயற்சிகள் அல்ல.
- [Vals AI, Vibe Code Bench v1.1 முறை](https://www.vals.ai/benchmarks/vibe-code) — இணைக்கப்பட்ட benchmark-ன் விளக்கமும் முறையும்: app specifications, app ஒன்றுக்கு 20–60 UI tests, scoring விதிகள். அதன் பொதுத் தரவரிசை வேறு harness அமைப்புகளைப் பயன்படுத்துகிறது; agent-team case study முடிவுகளுக்குப் பதிலாக அது பயன்படுத்தப்படவில்லை.
- [The Decoder, AI agent குழுக்கள் மிகப்பெரிய token செலவில் மிகச் சிறிய தர உயர்வையே தருகின்றன என ஆய்வு கூறுகிறது](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — கண்டுபிடிப்பு மற்றும் சூழலுக்குப் பயன்படுத்திய சமகால சுயாதீன செய்தி. கட்டுரையின் எண் மற்றும் முறைக் கூற்றுகள் Vals-ன் அசல் அறிக்கையுடன் சரிபார்க்கப்பட்டன; BIG CHANGE தலைப்பின் பரந்த முடிவை ஏற்கவில்லை.
BIG CHANGE செய்திமடல்
பெரிய பார்வை. உங்கள் வேகத்தில்.
AI மற்றும் ரோபாட்டிக்ஸ் பற்றிய சமீபத்திய செய்திகள், கவனிக்க வேண்டிய மாற்றங்கள், பயன்படுத்தக்கூடிய நடைமுறைக் கருத்துகள். தினசரி விளக்கக் குறிப்பு, வாராந்திரத் தொகுப்பு அல்லது மாதாந்திரப் பார்வையைத் தேர்ந்தெடுக்கவும்.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
உங்கள் தனியுரிமை, உங்கள் தேர்வு.
அத்தியாவசிய சேமிப்பு தளத்தின் பாதுகாப்புக்கு உதவுவதுடன் உங்கள் தேர்வுகளையும் நினைவில் வைக்கிறது. நீங்கள் அனுமதிக்கும் வரை விருப்ப Google Analytics முடக்கப்பட்டிருக்கும். அத்தியாவசியச் சேமிப்பை மட்டும் பயன்படுத்தி ஒவ்வொரு கதையையும் படிக்கலாம். தனியுரிமை விவரங்கள்