AI-translated from English; not yet reviewed by a fluent editor.
# Vals AI కోడింగ్ పరీక్షలో ఒక ఏజెంట్ బృందం 7.3 పాయింట్లు మెరుగుపడినా ఖర్చు 2.5 రెట్లు అయ్యింది
> 50 యాప్ నిర్మాణాల్లో, మధ్యస్థ ప్రయత్న స్థాయిలో GPT 6 Sol మాత్రమే గణాంకపరంగా ముఖ్యమైన బృంద ప్రయోజనం చూపిందని Vals AI కనుగొంది; ఆ అమరికకు యాప్కు $3.07 ఖర్చయింది, ఒంటరి ఏజెంట్కు $1.22 ఖర్చయింది.
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
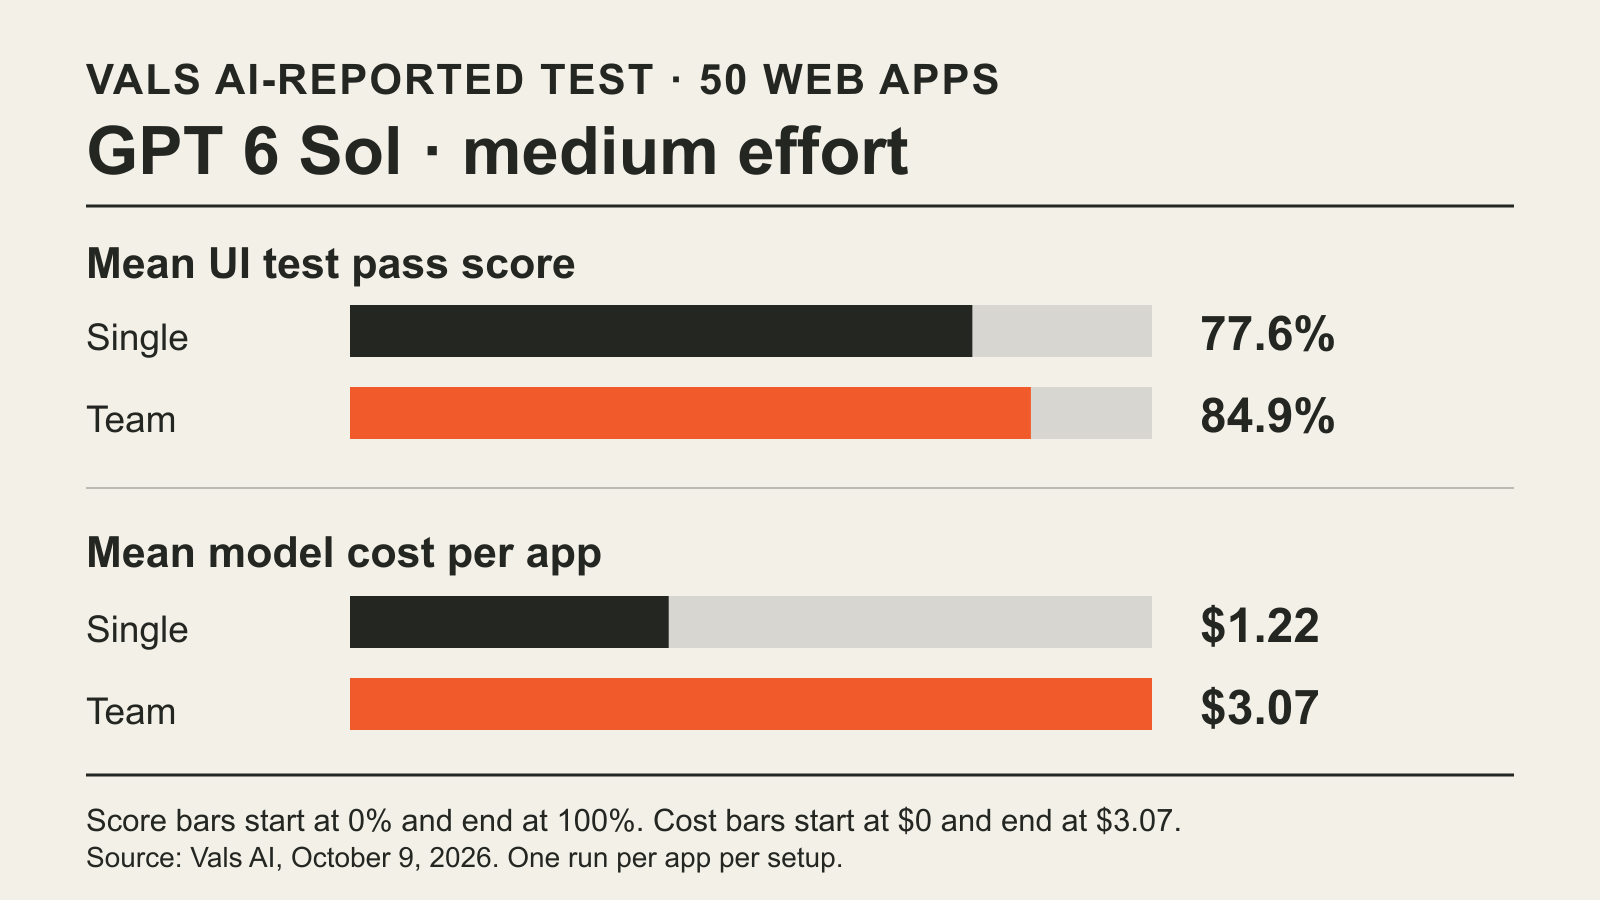
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
అక్టోబర్ 9న Vals AI చేసిన అధ్యయనంలోని నాలుగు జతపరచిన పోలికల్లో ఒకదానిలో కోడింగ్ ఏజెంట్కు సహచరులను ఇవ్వడం సహాయపడింది [అక్టోబర్ 9న వెలువడిన Vals AI Vibe Code Bench అధ్యయనం](https://www.vals.ai/blogs/multi-agent-vibe-code-bench). మధ్యస్థ తర్క ప్రయత్నం ఉన్న GPT 6 Sol బృందం బెంచ్మార్క్ యాప్ పరీక్షల్లో 84.9% ఉత్తీర్ణమైంది; ఒంటరి Sol ఏజెంట్ 77.6% ఉత్తీర్ణమైంది. 7.3 శాతం-పాయింట్ల పెరుగుదలకు యాప్కు సగటున $1.22 బదులు $3.07 ఖర్చయింది. ఈ పెరుగుదలకు 95% విరామం 2.3 నుంచి 12.4 పాయింట్లు, జతపరచిన పరీక్ష p-value 0.005 అని Vals నివేదించింది. మిగిలిన మూడు బృందం-ఒంటరి ఏజెంట్ పోలికల్లో స్కోరు తేడా గణాంకపరంగా ముఖ్యమైనది కాదు.
బృందాలు “మెరుగైనవా” అని అడగడం కంటే ఈ ఫలితం డెవలపర్లకు మరింత స్పష్టమైన బడ్జెట్ ప్రశ్నను అందిస్తుంది. ఈ వెబ్-యాప్ నిర్మాణాల్లో, మధ్యస్థ ప్రయత్నం ఉన్న Sol యాప్కు సుమారు $1.85 అదనపు ఖర్చుతో కొలవగల నాణ్యత పెరుగుదల ఇచ్చింది; మధ్యకాలం దాదాపు ఒకేలా ఉంది. ఎక్కువ ప్రయత్నంలోనూ, Claude Opus 5.5 యొక్క రెండు ప్రయత్న స్థాయిల్లోనూ, బృందానికి అదనపు ఖర్చు ఈ పరీక్షలో స్కోరు పెరుగుదలను నిరూపించలేదు.
## ప్రధాన మార్పు
- **ఏమి మారింది:** ఒకే 50 వెబ్-యాప్ పనులను రెండు తర్క స్థాయిల్లో ఒంటరి కోడింగ్ ఏజెంట్లతోనూ బృందాలతోనూ Vals కొలిచింది. మధ్యస్థ ప్రయత్నం ఉన్న Sol మాత్రమే బృంద స్కోరులో గణాంకపరంగా ముఖ్యమైన పెరుగుదల సాధించింది.
- **ఇది ఎందుకు ముఖ్యం:** గెలిచిన బృంద అమరికకు యాప్కు 2.5 రెట్లు ఖర్చయింది; ఇతర బృందాలకు 1.8 నుంచి 5.1 రెట్లు ఖర్చయినా స్కోరులో ముఖ్యమైన లాభం లేదు. బృంద రూపకల్పన, మోడల్ సెట్టింగులు ఒకే కొనుగోలు నిర్ణయంలో భాగం.
- **ఏమి గమనించాలి:** పునరావృత రన్లు, ఇతర సాఫ్ట్వేర్ పనులపై పరీక్షలు ఈ నిర్దిష్ట యాప్లకు మించి లాభం ఆధారపడుతుందా చూపవచ్చు. ఈ అధ్యయనంలో ప్రతి అమరికను ఒక్కసారే నడిపారు.
## ఎనిమిది రన్లు ఏమి కొలిచాయి
ఉత్పత్తి స్పెసిఫికేషన్ల ఆధారంగా 50 పూర్తి వెబ్ యాప్లు నిర్మించమని Vals GPT 6 Sol, Claude Opus 5.5లను కోరింది. Docker Composeతో యాప్లను అమలు చేసి, బ్రౌజర్ ఏజెంట్లతో యూజర్-ఇంటర్ఫేస్ పరీక్షలు చేయించి స్కోరు ఇచ్చారు. నివేదించిన స్కోరు ప్రతి యాప్ పరీక్షల్లో ఉత్తీర్ణమైన వాటి సగటు వాటా. [బెంచ్మార్క్ విధానం ](https://www.vals.ai/benchmarks/vibe-code)ప్రతి యాప్ స్పెసిఫికేషన్లో 20 నుంచి 60 ఆటోమేటెడ్ పరీక్షలు ఉంటాయని, ఒక్క పరీక్షలో కనీసం 90% దశలు విజయవంతమైతేనే ఉత్తీర్ణతగా పరిగణిస్తారని చెబుతుంది.
ప్రతి మోడల్కు, మధ్యస్థ మరియు గరిష్ఠ తర్క ప్రయత్నాల వద్ద ఒకేసారి ఐదుగురు సబ్ఏజెంట్ల వరకు పనిని అప్పగించగల లీడ్ను ఒంటరి ఏజెంట్తో Vals పోల్చింది. పనిని విభజించడం, అప్పగించడం, సమీకరించడం, ధృవీకరించడం అనే అదనపు సూచన కూడా లీడ్లకు ఇచ్చారు. ప్రతి మోడల్ పోలికలో టాస్క్ ప్రాంప్ట్, శాండ్బాక్స్, మూల్యాంకనకర్త ఒకేలా ఉన్నాయి. ఎనిమిది కాన్ఫిగరేషన్లలో ప్రతి ఒక్కటి 50 యాప్లన్నింటినీ ఒక్కసారి నిర్మించింది.
| మోడల్ మరియు ప్రయత్నం | ఒంటరి స్కోరు | బృంద స్కోరు | యాప్కు సగటు ఖర్చు: ఒంటరి → బృందం | మధ్యస్థ రన్టైమ్: ఒంటరి → బృందం |
| --- | --- | --- | --- | --- |
| GPT 6 Sol, మధ్యస్థ | 77.6% | 84.9% | $1.22 → $3.07 | 12.4 → 11.9 నిమిషాలు |
| GPT 6 Sol, గరిష్ఠ | 89.0% | 90.4% | $4.82 → $8.54 | 38.4 → 27.6 నిమిషాలు |
| Claude Opus 5.5, మధ్యస్థ | 91.5% | 91.2% | $4.08 → $9.10 | 20.3 → 26.6 నిమిషాలు |
| Claude Opus 5.5, గరిష్ఠ | 89.8% | 93.2% | $23.77 → $122 | 74.7 → 174.1 నిమిషాలు |
ఇవి ఒక యాప్ నిర్మాణానికి Vals తెలిపిన మోడల్ల సగటు ఖర్చులు; సబ్స్క్రిప్షన్ ధరలు లేదా ఒక్క UI పరీక్షను విజయవంతం చేయడానికి అయ్యే ఖర్చులు కావు. రన్టైమ్లు గడిచిన వాస్తవ సమయపు మధ్యకాలు; అందువల్ల ప్రతి వరుసలో ఖర్చు, సమయం 50 రన్ల వేర్వేరు సంగ్రహాలు. గరిష్ఠ ప్రయత్నం ఉన్న Opus బృంద సగటులో సమయం ముగిసిన ఒక రన్ ఉంది; టోకెన్ లెక్క ఆధారంగా దాని ఖర్చును Vals సుమారు $189గా అంచనా వేసింది.
## ఫలితం అమరికపై ఎందుకు ఆధారపడుతుంది
జతపరచిన t-పరీక్షతో ప్రతి బృందాన్ని అదే యాప్లపై దాని సరిపోలే ఒంటరి ఏజెంట్తో Vals పోల్చింది. గరిష్ఠ ప్రయత్నం ఉన్న Sol బృందం 1.4 పాయింట్లు పెరిగింది; 95% విరామం −1.7 నుంచి 4.5 పాయింట్లు. మధ్యస్థ ప్రయత్నం ఉన్న Opus బృందం 0.3 పాయింట్లు తక్కువ సాధించింది; విరామం −3.2 నుంచి 2.5. గరిష్ఠ ప్రయత్నం ఉన్న బృందం 3.4 పాయింట్లు పెరిగింది; విరామం −1.4 నుంచి 8.3. ఈ విరామాల్లో లాభం లేకపోవడమూ ఉంది. అవి ఆ అమరికల్లో బృందాలు ఎప్పుడూ సహాయపడవని నిరూపించవు; కానీ ఈ ప్రయోగం లాభాన్ని స్థాపించలేదు.
Sol కోసం తర్క ప్రయత్నం మరో పరీక్షించిన ఎంపిక. ఒంటరి Sol ఏజెంట్ ప్రయత్నాన్ని మధ్యస్థ స్థాయి నుంచి గరిష్ఠానికి పెంచితే స్కోరు 77.6% నుంచి 89.0%కి పెరిగింది; Vals దీన్ని గణాంకపరంగా ముఖ్యమైనదిగా తెలిపింది. ఆ గరిష్ఠ-ప్రయత్న ఒంటరి ఏజెంట్కు యాప్కు $4.82, మధ్యస్థ రన్టైమ్ 38.4 నిమిషాలు; మధ్యస్థ-ప్రయత్న బృందానికి $3.07, 11.9 నిమిషాలు. ఈ రెండు అమరికల మధ్య 4.1 పాయింట్ల స్కోరు తేడా గణాంకపరంగా ముఖ్యమైనది కాదు (p = 0.08). కొత్త ప్రాజెక్టులో ఏది గెలుస్తుందో ఊహించకుండా, కొలిచిన ధర-సమయ మార్పిడిని ఈ సంఖ్యలు డెవలపర్కు చూపుతాయి.
బృందాలు తమ సమయాన్ని కూడా వేర్వేరుగా వినియోగించాయి. Vals ప్రకారం Sol లీడ్ ముందుగానే పనిని అప్పగించి, సమీకరించిన యాప్ను తానే పరీక్షించింది. గరిష్ఠ-ప్రయత్న బృందం మధ్యస్థ 27.6 నిమిషాల్లో పూర్తిచేసింది; ఒంటరి ఏజెంట్కు 38.4 నిమిషాలు పట్టాయి. Opus లీడ్లు ఉమ్మడి ఒప్పందం రాసి దశలవారీగా అప్పగించేవి. గరిష్ఠ ప్రయత్నంలో బృందానికి మధ్యస్థ 174.1 నిమిషాలు పట్టగా, ఒంటరి ఏజెంట్కు 74.7 నిమిషాలు పట్టాయి; యాప్కు ఖర్చు సుమారు ఐదు రెట్లు. సబ్ఏజెంట్ల వేర్వేరు సందర్భాల్లో కాష్ అయిన ఇన్పుట్ టోకెన్లే అదనపు బిల్లులో ఎక్కువ భాగమని Vals చెబుతుంది.
## ఈ ఫలితాన్ని ఎంతవరకు వర్తింపజేయాలి
గణాంక ప్రాముఖ్యత విరామాలు 50 యాప్ల మధ్య తేడాలను చూపుతాయి; అదే యాప్పై పునరావృత ప్రయత్నాల మధ్య మార్పును కాదు. మరో రన్ పోలికను మార్చవచ్చు. బృంద రన్లకు అప్పగింపు గురించి అదనపు సూచన కూడా ఇచ్చారు; అందువల్ల ప్రయోగం బృందం-సూచన కలిపిన అమరికను కొలిచింది. Sol OpenAI Agents API, Opus Claude Code ఉపయోగించాయి; మోడల్ స్కోర్ల పోలికలో వేర్వేరు హార్నెస్లు కూడా కలిశాయి. Sol ఖర్చుపై Vals అంచనాలు నివేదించిన టోకెన్ వినియోగంలో సబ్ఏజెంట్లు ఉన్నారని భావిస్తాయి; అభ్యర్థన-స్థాయి వినియోగ సమాచారం లేనందున దీర్ఘ-సందర్భ పరిమితి దాటిన అభ్యర్థనల అధిక ధరను లెక్కించలేదు.
ఈ అధ్యయనం పరిమిత నిర్ణయానికే మద్దతిస్తుంది: ఈ అమరికలతో ఇలాంటి ఫుల్-స్టాక్ యాప్లు నిర్మించినప్పుడు, మధ్యస్థ-ప్రయత్న Sol బృందం అధిక ఖర్చుతో కొలవగల లాభం చూపింది; మిగతా బృందాలు నమ్మదగిన స్కోరు లాభం చూపలేదు. మరో కోడ్బేస్, వేరే మోడల్ లేదా పనిని వేరేలా విభజించి తనిఖీ చేసే ప్రక్రియలో బృందాలు లాభదాయకమా అనేది ఇది తేల్చదు. BIG CHANGE ప్రచురిత Vals కథనం, దాని పద్ధతిని సమీక్షించింది; బెంచ్మార్క్ను నడపలేదు లేదా పునరావృతం చేయలేదు.
## Sources
- [Vals AI, ఏజెంట్ బృందాలు ఖర్చుకు తగినవా? Vibe Code Bench కేస్ స్టడీ](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — అసలు ప్రయోగ నివేదిక. దాని స్కోర్లు, ఖర్చులు, రన్టైమ్లు, జతపరచిన పరీక్షల విరామాలు మరియు p-values, బృందాల ప్రవర్తన, అమలు వివరాలు, హెచ్చరికలు ఈ కథనానికి ఆధారం. ఎనిమిది అమరికల్లో ప్రతి ఒక్కదాన్ని 50 యాప్లలో ప్రతి దానిపై ఒక్కసారి నడిపారు; నివేదించిన అనిశ్చితి యాప్ల మధ్య మారుతుంది, పునరావృత ప్రయత్నాల మధ్య కాదు.
- [Vals AI, Vibe Code Bench v1.1 పద్ధతి](https://www.vals.ai/benchmarks/vibe-code) — లింక్ చేసిన బెంచ్మార్క్ వివరణ మరియు విధానం: యాప్ స్పెసిఫికేషన్లు, యాప్కు 20–60 UI పరీక్షలు, స్కోరింగ్ నియమాలు. దాని సాధారణ లీడర్బోర్డ్ వేరే హార్నెస్ అమరికలను ఉపయోగిస్తుంది; అది ఏజెంట్-బృంద కేస్ స్టడీ ఫలితాలకు ప్రత్యామ్నాయం కాదు.
- [The Decoder, అధ్యయనం: AI ఏజెంట్ బృందాలు కొలవడం కష్టమైన నాణ్యత లాభాల కోసం విపరీతమైన టోకెన్లు ఖర్చు చేస్తున్నాయి](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — ఆవిష్కరణ, సందర్భం కోసం ఉపయోగించిన స్వతంత్ర సమకాలీన కథనం. ఈ వ్యాసంలోని సంఖ్యలు, పద్ధతి సంబంధిత వాదనలు Vals అసలు నివేదికతో తనిఖీ చేయబడ్డాయి; BIG CHANGE శీర్షికలోని విస్తృత నిర్ణయాన్ని అంగీకరించదు.
BIG CHANGE వార్తాపత్రిక
పెద్ద దృశ్యం. మీ వేగంతో.
AI, రోబోటిక్స్ తాజా కథనాలు, గమనించదగిన మార్పులు, ఆచరణలో పెట్టగల ఆలోచనలు. రోజువారీ బ్రీఫింగ్, వారపు సంకలనం లేదా నెలవారీ దృక్కోణం ఎంచుకోండి.
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.
మీ గోప్యత, మీ ఎంపిక.
అవసరమైన నిల్వ సైట్ భద్రతకు తోడ్పడి, మీ ఎంపికలను గుర్తుంచుకుంటుంది. మీరు అనుమతించే వరకు ఐచ్ఛిక Google Analytics ఆఫ్లోనే ఉంటుంది. అవసరమైన స్టోరేజ్తోనే ప్రతి కథనాన్ని చదవవచ్చు. గోప్యత వివరాలు