Markdown 版本
AI-translated from English; not yet reviewed by a fluent editor.
# SageMaker 多轮强化学习:训练前,搜索团队必须核实什么
> AWS 报告称,其 Qwen3.6-27B 代理在四项留出搜索基准中的三项上有所提升。本指南梳理了试用前需了解的 SageMaker 配置、成本与评估方法。
By BIG CHANGE Editorial
Published: 2026-10-04T17:55:25.736Z
Updated: 2026-10-04T17:55:25.736Z
Canonical: https://bigchange.ai/blog/fine-tune-search-agent-sagemaker-multi-turn-rl
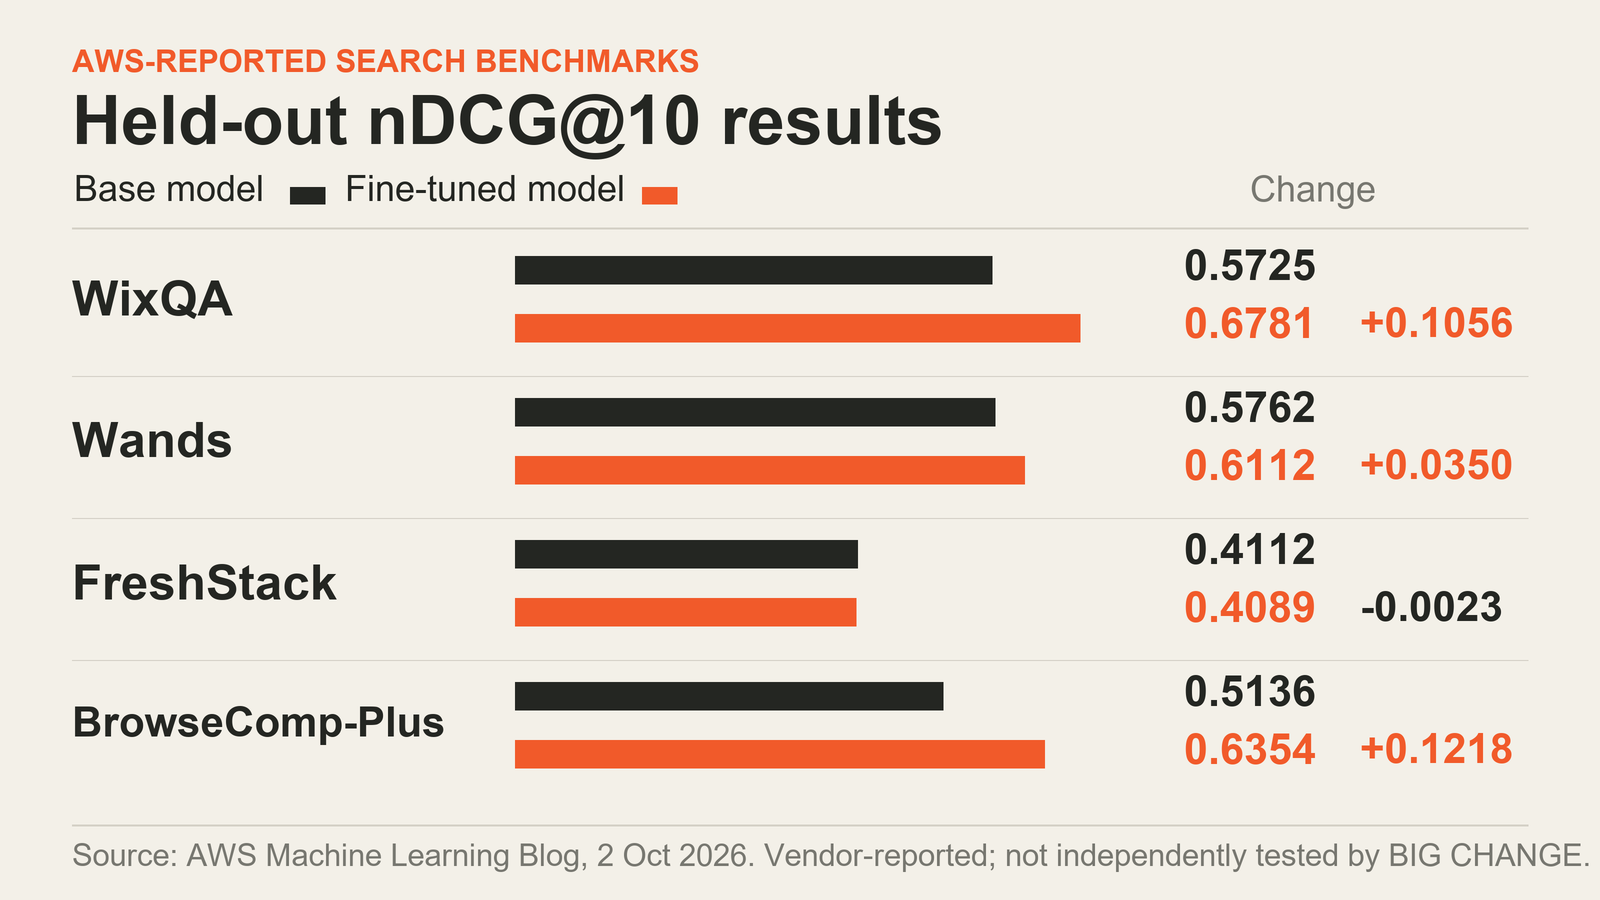
BIG CHANGE graphic; data: AWS Machine Learning Blog
## 重大变革
在 AWS 于[10 月 2 日发布的操作指南](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/)中,AWS 介绍了如何在 SageMaker AI 中通过多轮强化学习(MTRL)微调 Qwen3.6-27B 搜索代理。上方图表绘制了 AWS 报告的留出集 nDCG@10 分数:WixQA、Wands 和 BrowseComp-Plus 得分上升,FreshStack 略有下降。BIG CHANGE 根据 AWS 的数据制作了该图;我们没有独立测试该代理,也没有复现这些结果。这项技术通过一连串使用工具的决策所产生的结果来训练模型。
提交作业前,机器学习工程师需要确认模型和区域受支持、代理能够参与 SageMaker 的 rollout 循环、提示词与奖励能代表预期的搜索任务,并且另设的评估集足以揭示性能退化。本指南依据 AWS 文档编写;BIG CHANGE 未运行 AWS 作业或调用其 API。
## MTRL 如何改变训练循环
监督式微调需要团队准备展示目标行为的示例轨迹。AWS 对 MTRL 的描述则是:SageMaker 向代理发送提示词,代理在多个回合中调用策略模型及其工具,完成 rollout 后回报奖励,再依据这些反馈更新模型。对于搜索任务,奖励可以衡量最终排序,因此早期的查询选择会根据整个搜索过程进行优化。
当工具调用依赖先前结果时,这一区别就很重要。如果模型第一次查询效果不佳、看到的结果也不理想,那么它应该改写查询;任务结束时给出的奖励可以反映整段流程最终是否检索到了相关文档。但这并不能免除团队界定“相关”含义的责任,也不能代替构建一个能调用团队搜索工具的代理。
## 先确认访问权限、模型和区域
10 月 2 日的示例在美国西部(俄勒冈州)运行,`us-west-2`,并微调了 Qwen3.6-27B。[SageMaker MTRL 支持的模型列表](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html)(于 2026 年 10 月 4 日查阅)列出六种模型与区域组合中的四种模型:Nova Lite 2.0 和 GPT-OSS-20B 支持美国东部(弗吉尼亚州北部)`us-east-1`以及美国西部(俄勒冈州)`us-west-2`;Gemma-4-31B-it 和 Qwen 3.6 27B 仅支持俄勒冈州。请在准备创建作业的区域查看实时列表;模型出现在列表中,并不代表它在其他地区也可用。
团队还需要 AWS 账户;如果使用 Studio 界面,则还需 SageMaker Studio 域;需拥有对 S3 中数据集及输出的访问权限,并配置可供新版 MTRL 作业和运行时调用使用的 IAM 角色。AWS 的前置条件文档指出,调用者需要`CreateJob`及相关作业操作权限,还需要获准将执行角色传递给`job.sagemaker.amazonaws.com`。执行角色需要`AmazonSageMakerJobFullAccess`策略,并且其信任策略必须包含该服务主体。代理运行时角色需要`AmazonSageMakerJobRuntimeAccess`;AgentCore 运行时还需要单独设置自己的信任关系。Studio 的运行时选择器需要 AgentCore 列表权限。AWS 指出,现有的广泛 SageMaker 访问权限本身并不涵盖这些新增作业操作。
文档提供了两种代理接入方式。第一种是通过 Bedrock AgentCore 部署并使用托管主机;AWS 表示,这种方式最适合使用 Strands 构建的代理。第二种是托管自定义代理,再通过 Lambda 转发函数接入。代理接收 rollout 提示词,通过作业运行时调用策略模型,再调用搜索工具;每次 rollout 完成后回报奖励。AWS 的 SDK 装饰器可以处理大部分集成工作;自定义框架也可直接调用运行时 API。如果 Lambda 函数使用非标准名称,AWS 表示可能需要把其 ARN 明确加入权限策略。使用客户自主管理的 VPC 或 KMS 密钥还需要额外配置。
## 为真实搜索任务准备提示词和奖励
SageMaker 的资源指南接受 Parquet、JSON Lines、JSON 或 CSV 格式。它会查找名为`prompt`的列;若找不到,则回退到第一列,并将其原样传递给代理。服务不会解析、验证或转换提示词内容。对于使用工具的搜索任务,提示词可以按照代理预期的格式,携带对话消息、任务元数据、奖励说明和工具配置。AWS 警告,提示词会未经检查直接传递,因此保护敏感数据的责任仍在团队;应在存储和代理调用链路中设计加密或其他适当的保护措施。
奖励是模型要优化的目标。AWS 的示例使用最终检索文档的 nDCG@10 评分;如果代理达到回合数或采样 token 上限,则给予 -1 奖励。这为排序检索任务提供了具体的起点,但评估设计会直接影响结果:团队需要可靠的相关性标注或其他站得住脚的评分方法,并检查奖励是否会偏向表面上的排序提升,却损害答案质量、延迟或工具成本。
博客文章称,其训练组合包含 FRAMES、BRIGHT、Enterprise RAG、ESCI、Musique 和 MLQA,每个数据集都保留 5% 的训练实例作验证集。留出测试集则包含 FreshStack、WixQA、BrowseComp-Plus 和 Wands。这些公开或合成数据集不能替代针对团队实际要服务的私有语料库和查询分布所进行的评估。
## 提交一个规模小、便于检查的作业
AWS 于[10 月 2 日发布的博客](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/)代码片段使用了不同的 SDK 导入语句和参数名称。当前的[SageMaker 训练作业参考文档](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html)则展示了 Bedrock AgentCore 运行时所采用的 API 格式。以下示例使用 AWS 当前文档所列的 GPT-OSS-20B 模型标识符;请根据目标区域选择可用模型,并在改写示例前查看实时支持列表。当前示例还要求提供 MLflow 应用 ARN、角色 ARN,并接受最终用户许可协议(EULA)。
```python
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer
trainer = MultiTurnRLTrainer(
model="openai-reasoning-gpt-oss-20b",
agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
training_dataset="s3://my-bucket/prompts/prompts.parquet",
mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
s3_output_path="s3://my-bucket/output/",
role="arn:aws:iam::123456789012:role/SageMakerRole",
accept_eula=True,
)
trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
```
这是 AWS 当前文档中的示例,并非 BIG CHANGE 测试过的命令。AWS 于 10 月 2 日发布的博客使用了不同的`sagemaker.modules.train`导入语句、`model_id`、`agent_endpoint`、`training_dataset_s3_uri`和`output_s3_uri`等参数。由于这些内容与当前作业指南不同,新实现应遵循现行参考文档,并在自己的环境中核实 SDK 版本及模型要求;我们无法确认博客示例反映的是较早的 SDK 版本,还是文档之间存在不一致。Studio 用户界面也是文档列出的提交途径:选择受支持的 JumpStart 模型,选择“多轮强化学习”,设置 AgentCore 运行时或 Lambda 转发函数,提供训练数据,然后提交作业。
首次运行时,请记录模型、区域、数据集版本、奖励、限制条件、超参数和输出路径,以便后续评估与同一基准进行比较。如果使用客户自主管理的 VPC,AWS 的独立 VPC 指南要求在两个可用区中配置私有子网、S3 和 CloudWatch Logs 的 VPC 端点,并视情况设置 AgentCore 或 Lambda 端点;使用 MLflow 时还需要相应端点。执行角色需要管理弹性网络接口(ENI)的权限。选择客户自主管理的 KMS 时,还要为调用者、执行角色和运行时配置额外权限及密钥策略;默认情况下,静态数据使用 AWS 所有的 KMS 密钥加密。采用任何一种配置前,请先查阅 VPC 和加密指南。提交前还要检查账户配额:AWS 默认允许同时运行一个 MTRL 微调作业和一个评估作业,两者都可通过 Service Quotas 调整。作业管理 API 的限流上限则无法调整。
## 部署前先用留出提示词评估
AWS 的评估文档建议:评估提示词不得用于训练;提示词格式应保持一致;涵盖重要工具及工具组合;加入过去失败的案例;并保护敏感内容。SageMaker 评估器可以针对一组提示词运行候选模型,并报告奖励、pass@k 和轨迹指标。文档展示了如何评估微调后的模型,也提供了在同一比较流程中评估基础模型的可选做法。
请在训练前确定评估方案。保留固定且未参与训练的数据集,使其能代表线上代理将遇到的查询、权限条件和文档变更。使用相同工具、限制条件和评分代码比较基础模型与微调模型。除了平均检索分数,还要检查任务失败、回合数、延迟、token 用量,以及相关文档从高排名中消失的案例。文档说明了如何提交 AWS 评估作业,但并未证明任何单一指标足以反映生产环境中的搜索质量。
AWS 的文章报告了以下留出测试结果:
| 数据集(问题数) | 基础模型 nDCG@10 | 微调模型 nDCG@10 | 基础模型失败率 | 微调模型失败率 |
| --- | --- | --- | --- | --- |
| WixQA(400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
| Wands(147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
| FreshStack(672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
| BrowseComp-Plus(830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
表格显示,nDCG@10 有三项上升,FreshStack 则小幅下降。AWS 将 BrowseComp-Plus 失败率降低归因于:代理达到回合数或 token 上限时会受到惩罚。博客没有同时提供这些数据的置信区间或统计显著性分析。文章还报告称,微调模型在 WixQA 上的平均回合数为 4.5,对比基线模型的 4.3;在 Wands 上为 2.9,对比 2.2。因此,并非所有数据集上的回合数都有所减少。应将这些结果视为供应商报告的实验,而非独立验证,也不能据此认定其他语料库同样会有提升。
## 为整个试用过程编列预算
AWS 的 MTRL 文档列出三种训练计费项目:作为输入处理的预填充 token、rollout 过程中生成的采样 token,以及训练更新。定价页面提供针对不同模型的费率;最终估算取决于这些费率,以及团队的 rollout 数量、序列长度、训练周期和运行时间。示例文章没有公布总费用,文档也未提供通用的试用价格。请查询所选模型和区域的当前费率,再依据预期作业用量估算,而不是假定有固定成本。
估算时还要计入相关服务的成本:训练、验证、检查点及输出资源在 S3 中的存储和请求费用;rollout 期间 AgentCore 运行时或 Lambda,以及任何配套搜索基础设施的费用;日志和 MLflow;留出集评估;以及训练后使用的任何端点或 Bedrock 部署费用。AWS 在文章中特别建议,停止或删除仍在运行的 MTRL 作业、删除不再需要的 S3 模型资源,并移除评估端点,以避免持续计费。部署端点与模型训练是两项独立的决策和成本类别。
## 决定是否继续
如果搜索任务需要多个彼此依赖的工具调用,而且团队能够为最终结果打分,这套工作流程就最值得考虑。只有在模型与区域配对受支持、代理集成可运行、提示词数据具有代表性、奖励能反映任务、具备留出集对比,并且成本估算涵盖周边服务时,试用结果才有决策价值。AWS 在四项基准上的强劲结果值得进一步检视方法,但不足以让人假定换成不同索引、查询组合或权限边界也会得到相同效果。
**来源与延伸阅读**
- [AWS Machine Learning Blog:《在 Amazon SageMaker AI 上用多轮强化学习微调搜索代理》(2026 年 10 月 2 日)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/)——供应商的操作指南、配置说明、数据集选择与报告的评估结果。
- [Amazon SageMaker AI:多轮强化学习](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html)——当前支持的模型、区域与计费项目。
- [前置条件](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html)、[准备代理](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-agent.html)、[VPC 配置](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-vpc.html)和[静态加密](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-encryption-at-rest.html)——权限、运行时选项、集成方法,以及可选的网络与加密配置。
- [创建资源](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html)、[提交训练作业](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html)、[评估](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-evaluation.html)、[超参数](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-hyperparams.html)和[配额](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-quotas.html)——当前实现参考资料。
- [SageMaker AI 定价](https://aws.amazon.com/sagemaker/ai/pricing/)——当前的模型定制价格详情;费率会变动,并因模型和区域而异。
*报告说明:本文仅审阅文档。BIG CHANGE 未访问 AWS 账户、提交或检查 SageMaker 作业、调用 AWS API,也未独立复现报告的指标。实施指南由 AWS 编写,实验结果亦由 AWS 自行报告。*
## Sources
- [AWS Machine Learning Blog:《在 Amazon SageMaker AI 上用多轮强化学习微调搜索代理》(2026 年 10 月 2 日)](https://aws.amazon.com/blogs/machine-learning/fine-tune-a-search-agent-with-multi-turn-rl-on-amazon-sagemaker-ai/) — AWS 的实施指南、数据集选择与供应商报告的留出评估。
- [Amazon SageMaker AI:多轮强化学习](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl.html) — 当前的模型与区域组合、工作流程概述和训练计费项目。
- [Amazon SageMaker AI MTRL 前置条件与代理配置](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-prereqs.html) — 所需权限、运行时选项、代理集成,以及可选的网络与加密配置。
- [Amazon SageMaker AI MTRL 训练与评估文档](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-assets.html) — 当前数据输入与工作流程;文章还链接了训练作业和评估参考资料。
- [Amazon SageMaker AI MTRL 训练作业提交指南](https://docs.aws.amazon.com/sagemaker/latest/dg/model-customize-mtrl-job.html) — 当前 Python SDK 导入语句、参数名称、AgentCore 示例和 Studio 提交步骤;查阅日期:2026 年 10 月 4 日。
- [Amazon SageMaker AI 定价](https://aws.amazon.com/sagemaker/ai/pricing/) — 当前的模型专属定价信息;费率因模型和区域而异。
BIG CHANGE 新闻通讯
纵览全局,按自己的节奏。
关于人工智能和机器人技术的近期报道、值得关注的变化以及可采用的实用想法。选择每日简报、每周摘要或每月视角。
下次计划发送时间(UTC): . 确认订阅后,您将在下一个计划发送时间收到第一期通讯。