Markdown 版本
AI-translated from English; not yet reviewed by a fluent editor.
# Grok 4.7 上线,token 单价不变。完成工作的成本才是更重要的问题。
> Grok 4.7 上线时宣称在编程和办公任务上表现更强。本文回顾 Matthew Berman 的分析、独立测试,以及团队在切换前应衡量哪些指标。
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
Grok 4.7 于 2026 年 9 月 21 日发布。对于使用 AI 编写代码或分析业务信息的团队而言,新版本带来了一个实际问题:更好的模型能否降低完成工作的成本?答案取决于的不只是公布的 token 单价。[官方发布说明](https://docs.x.ai/developers/release-notes)
Matthew Berman 于 9 月 22 日发布的视频,*我不知道该如何看待 Grok 4.7……*围绕这一复杂情况展开。他质疑了对比对象的选择,并认为每项已完成任务的成本比 token 价格更重要。他也表示自己尚未充分测试该模型。他的视频是对现有证据的初步评估,并非全面的实机评测。[Berman 的开场介绍,0:00](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
这次发布值得关注,因为实用的模型不必赢下每一项基准测试,也可能改变企业能够负担哪些自动化工作。但它必须正确完成足够多的工作,才能证明其总成本合理。独立测试已经揭示了这种张力:Grok 4.7 的结果更好,但可能会生成多得多的内容。
对开发者、小企业和构建智能体的团队而言,这个决定很实际:该模型能够以可接受的质量完成哪些任务?它需要多少投入?模型宣称完成工作后,还剩下多少需要人来处理?
我们审阅了 Berman 时长约 17 分钟视频的完整字幕,并核对了发布公告、产品文档和 Artificial Analysis 的评估。以下分析不包含 BIG CHANGE 自行开展的基准测试,也不声称我们亲自测试了 Grok。
## 发布了什么,以及在哪里可以使用
标准模型可通过 xAI API 使用`grok-4.7`,也可在 Cursor 和 Grok Build 中使用。API 接受文本和图像,并生成文本。文档所列上下文窗口为 500,000 个 token,共有四档推理强度:低、中、高和 xhigh,默认值为高。[官方发布说明](https://docs.x.ai/developers/release-notes)
SpaceXAI 将性能提升归因于更大的基础模型,以及在更困难任务上进行更长时间的强化学习。这是开发者给出的解释。[发布技术概览](https://x.ai/news/grok-4-7)
此外还有 Grok 4.7 Fast。文档称它是在更快基础设施上运行的同一模型,按标准 token 价格的两倍收费。该版本可通过 Cursor 和 Grok Build 使用,不包含在 Grok Build 免费层中,也不能通过 xAI 公共 API 使用。[Grok 4.7 产品文档](https://docs.x.ai/developers/grok-4-7)
这些区别在比较截图、演示和账单时很重要。模型版本、推理强度和服务档位是彼此独立的选择。使用 Fast 和 xhigh 运行的演示,并不能代表标准速度、中等推理强度的 API 调用效果或成本。
发布页面与其他模型的比较,也应与升级前后的比较区分开。SpaceXAI 称标准版 Grok 4.7 与 Grok 4.6 的价格和速度相同,但并未表示从 4.6 升级后,客户账单会自动减半。
## 价格卡设有长上下文门槛
公布的标准 API 价格如下:
- 提示词不超过 200,000 个 token:每百万个 token 的输入价格为 2 美元,缓存输入为 0.50 美元,输出为 6 美元。
- 提示词超过 200,000 个 token:每百万个 token 的输入价格为 4 美元,缓存输入为 1 美元,输出为 12 美元。
这些是 token 单价,并非智能体完成一项任务的全包价格。模型页面提示,超过 200,000 个 token 的请求适用更高价格,发布说明也列出了较高档费率。价格和可用情况核查于 9 月 22 日。[模型定价](https://docs.x.ai/developers/models/grok-4.7)和[发布说明](https://docs.x.ai/developers/release-notes)
因此,500,000 个 token 的上下文窗口并不意味着窗口内的每个请求都按最低费率计价。大上下文窗口也不能证明模型会持续从大量文件中找到所有相关细节。
Cursor 带来了另一项产品层面的区别:其文档列出的标准上下文窗口为 256,000 个 token,最大值为 500,000 个 token。编辑器提供的容量可能不同于 API 规格,也可能取决于所选模式。[Cursor 的 Grok 4.7 文档](https://prod.cursor.com/docs/models/grok-4-7)
对于处理长篇报告的团队,眼下要问的是:提交全部材料,是否能显著改善结果,足以抵消成本?检索相关章节可能更便宜,也更容易检查。有时确实需要完整文档,有时这只是构造提示最省事的办法。这两种情况不应按相同预算处理。
## 性能提升可能消耗更多 token
Artificial Analysis 于 9 月 21 日发布的评估中,Grok 4.7 在 xhigh 档的智能指数得分为 46,比 Grok 4.6 高 2 分。报告估计每项任务约生成 81,000 个输出 token,而 Grok 4.6 在高档推理强度下约为 36,000 个。相同报告还给出 Grok 4.6 在 xhigh 下生成 38,000 个 token 的数据;即使只比较相同推理强度,输出 token 也增加了一倍以上。[Artificial Analysis 的发布评估](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
这就是为什么 token 单价和任务成本必须分开看。按基础输出价格每百万 token 6 美元计算,生成 81,000 个输出 token 的示例费用为 0.486 美元;生成 38,000 个则为 0.228 美元。计算有意排除了输入、缓存情况、工具收费、更高上下文费率和失败重试。这是根据所报告 token 数进行的算术计算,不是实测的任务全包价格。
更多输出不一定是浪费。模型可能通过投入额外精力检查答案,避免原本需要人工介入的失败;它也可能花更长时间追逐错误路径。仅凭 token 数无法区分有效坚持和昂贵的重复尝试。
在视频接近结尾时,Berman 再次谈到这个问题,并提及 Artificial Analysis 报告的较高 token 用量。[视频,15:43](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
真正有用的是通过验收的交付成果。通过适当测试和审查的代码改动、公式能够核对一致的电子表格,或主张有证据来源的报告,其价值都不同于一个只是很快生成的答案。
## 基准测试显示,这是一款能力强但表现不均衡的模型
发布对比表显示,Grok 4.7 在 xhigh 下的 CursorBench 4.0 得分为 46.3%,低于 Fable 5.1 在 max 档下的 51.8%。Fable 在 Terminal-Bench 对比中也领先。[供应商基准测试表](https://x.ai/news/grok-4-7)
配套图表以输出 token 数为横轴、基准得分为纵轴,曲线由左向右下降,并比较了不同推理强度。[原始交互式图表:选择“Tokens”](https://x.ai/news/grok-4-7)。[打开完整尺寸图表](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png)。
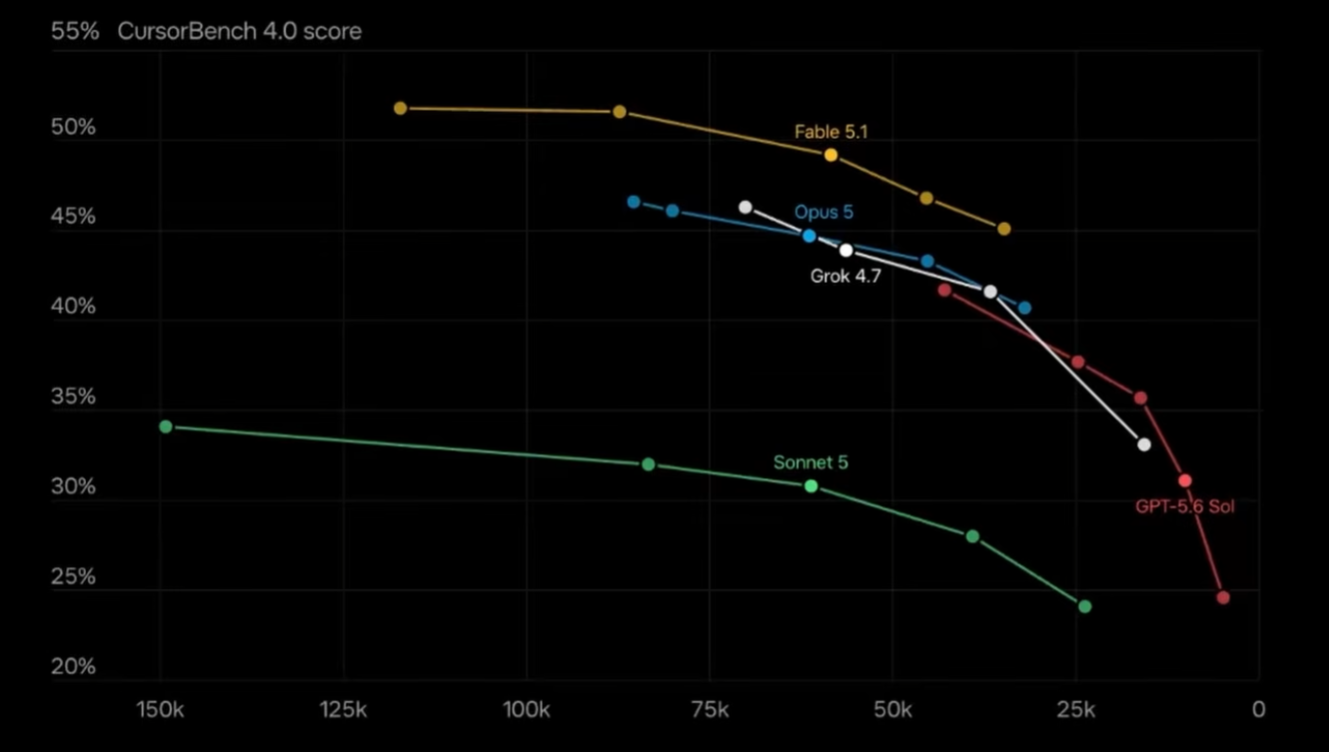
向上表示得分更高;向右表示在这项评估中生成的 token 更少。但这并不等于全包价格更低,因为 token 费率、输入用量和周边智能体也会影响成本。这与上文 Artificial Analysis 的 token 用量数据还是不同的测试。把两者的数据合在一起,会抹去使各自结果具有解释意义的任务和方法差异。
这些信息足以否定“Grok 4.7 在各种编程工作中都领先”的笼统说法,也足以支持团队进一步评估某些特定工作负载。一项评估中的提升幅度,不能决定模型面对陌生代码库、不完整错误报告或不同工具环境时会如何表现。
Artificial Analysis 提供了一个有价值的独立区分。其报告称,Grok 4.7 与 Grok Build 组合时,编程智能体指数得分为 56,高于 Grok 4.6 与该智能体组合的 47。报告明确将这些原生智能体结果与标准化智能指数测试设置分开。[独立评估与方法说明](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
周边智能体同样重要。它提供工具、管理上下文,并决定如何执行模型发出的请求。即使模型名称相同,改变运行环境也可能改变结果。把一种设置下的终端测试得分,与另一种设置下的软件工程得分放在一起,可能会做出一张很有说服力的表格,却描述了一个从未有人实际测试过的系统。
Berman 指出,发布表中缺少 GPT-6 Astra,并用 AI 生成的重建数据把它补了进去。这可以促使人们进一步调查对比方式,但重建结果并不是独立基准测试来源。未经核查底层评估,我们不会采用其中新增的数字。[视频,6:03](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
还有一项商业关系需要考虑。Cursor 于 8 月 14 日发布的公司公告称,SpaceX 已收购 Cursor。在同一企业集团内推广的产品所发布的基准测试,仍然是有用证据,但并非对竞争对手漠不关心的评估。[Cursor 的收购公告](https://cursor.com/blog/joining-spacex)
## 办公任务或许才是更值得关注的机会
这项独立评估报告称,Grok 4.7 在 xhigh 下的 AA-Briefcase 得分为 1,657 Elo,比 Grok 4.6 在高档下高 111 分。报告将大部分提升归因于分析质量,同时指出其呈现质量略低于早期模型。[Artificial Analysis 的知识工作结果](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
这项差异对委托撰写报告、制作电子表格或演示文稿的人很有参考价值。答案的分析能力可以更强,却仍需要编辑或重新设计;反过来,精美的演示文稿也可能掩盖浅层推理。只看最终呈现效果,可能会奖励错误的改进。
运营团队可以用定期绩效报告来测试模型。有效的试用应检查模型是否使用了正确期间的数据、是否与源数据对账,以及是否区分了观察到的变化和提出的解释。审核者应记录需要多少修正,而不能只看报告初稿是否专业。
小企业可能不太在意是否赢下最困难的基准测试,而更关心能否把原本负担不起的分析工作变成日常流程。这是一条合理的普及路径。只有当输出足够准确、按时交付,而且比业主手动完成任务省事时,这种可能性才会成为现实。
专业基准测试的名称不等于专业资质。法律工作或临床推理的评测成绩,只说明模型在该项评估中的表现,并不能证明它可以独立处理客户的法律事务或作出患者护理决策。本文不建议将 Grok 用于此类决策。
## 安全防护也需要结合实际情境评估
SpaceXAI 称 Grok 4.7 配备了新的安全防护体系,并提高了抵御越狱攻击的能力。这是发布时的主张,并不保证所有使用该模型的应用都安全。[开发者对安全性的说明](https://x.ai/news/grok-4-7)
对商业智能体而言,至少还有两个问题:模型能否恰当地回应收到的请求?应用本身是否限制了模型实际能够执行的操作?
模型可能正确理解了修改客户记录的指令,却无权执行修改。它也可能遇到嵌入待总结文档中的恶意指令。访问控制和审批规则必须继续保留在外围系统中;拒答行为改善并不能取代这些措施。
实际做法是测试完整工作流程。测试内容应包括:应当成功的正当请求、应当拦截的未授权操作,以及应暂停并请求澄清的模糊情况。如果产品过于频繁地拒绝无害工作,就可能无法使用;如果它执行了未授权操作,后果可能更严重。单一的醒目分数无法反映这两类问题。
## 视频中仍未解决的问题
Berman 的分析提出了几个仍应保留为问题的问题。他把定价与可用算力联系起来的解释,是一种市场判断,并非公开披露的单位成本核算。他讨论的社交媒体预测代表预期,而不是已交付性能的证据。他在结尾比较演示时,也承认自己不知道所用设置。[定价讨论,8:44](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s);[性能预期,11:51](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s);[演示讨论,15:20](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
视频还谈到了开放权重模型这一趋势。但这种更广泛的竞争趋势,不应与 Grok 4.7 的许可证情况混为一谈:Artificial Analysis 将该版本列为专有模型,并称权重不可获取。[Grok 4.7 发布资料](https://artificialanalysis.ai/models/releases/grok-4-7)
区分这些问题有助于让评估聚焦。产品定价可能很有吸引力,但公众未必知道供应商为什么选择这个价格。一场令人震惊的失败演示,可以提示某项测试值得重做,却不能证明模型整体表现不佳。模型已经可用,也不代表它达到了创始人早先的预测。
还需要注意赞助内容与证据的边界。Berman 的视频包含 Zapier 广告。它不是 Grok 性能的独立证据,广告中的宣传内容也不是 BIG CHANGE 的推荐。
## 更好的采购指标:每项验收任务的成本
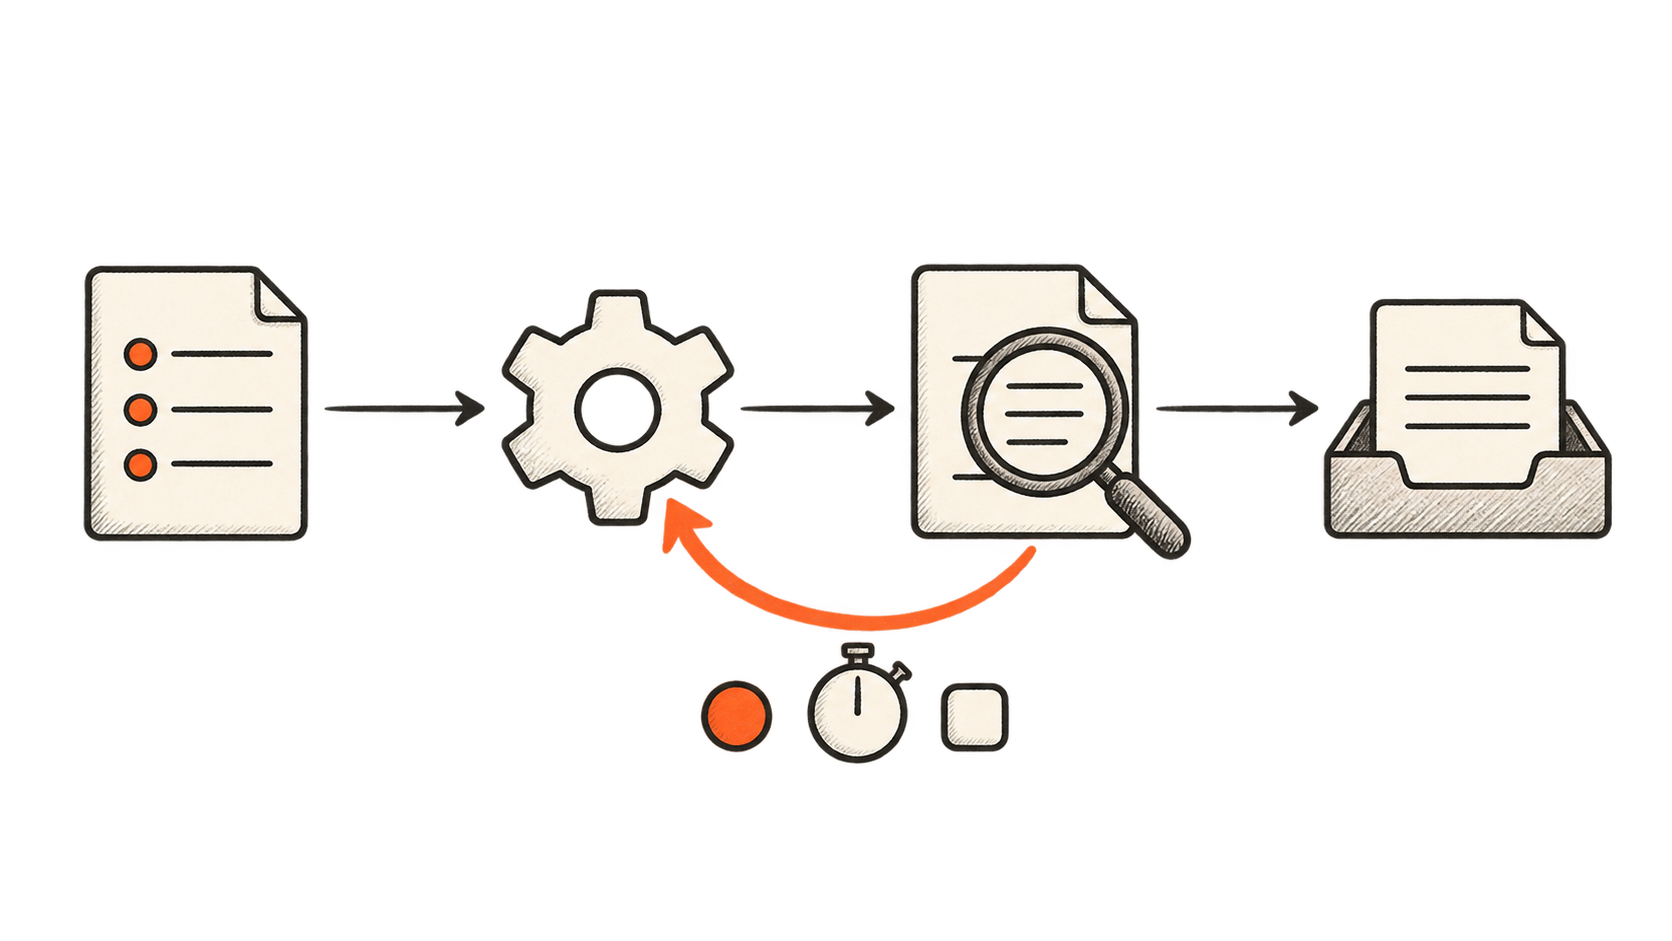
考虑 Grok 4.7 的团队,可以从一小组具有代表性的工作入手,与当前流程进行比较。应在查看输出之前定义验收标准。编程任务可以要求相关测试通过、补丁易于阅读且没有无关改动;分析任务则可以要求计算正确,并为重要主张提供证据。
接着记录完整费用:输入和输出用量、工具、重试,以及审核或修正结果所花的时间。失败尝试也要计入。再用总成本除以符合验收标准的交付数量。
一个示意性例子能说明这种区别为何重要。假设一种配置批量运行的总成本为 20 美元,得到 80 项验收合格的结果,那么不计人工时,每项合格结果的实测成本为 0.25 美元。另一种配置花费 12 美元,却只得到 30 项合格结果,每项合格结果的成本为 0.40 美元。较便宜的一批任务,反而是更昂贵的可用工作来源。这些是用于说明的假设数字,并非 Grok 的实测数据。
推理强度也应纳入试用。高强度设置或许值得用于困难任务,但对常规工作帮助不大。只对有需要的案例升级,可能比所有请求一律使用 xhigh 更经济,前提是路由决策本身也经过评估。
对所有模型保持相同的审核标准。降低廉价模型的门槛,会通过接受更差的工作制造出虚假的节省;只提高现有模型的门槛,则会造成相反的失真。关键是买到可靠的结果,并清楚说明人们还需要做什么。
## 值得关注的变化
Grok 4.7 为团队提供了另一个待测选项。要不要采用,取决于对完整工作的评估:模型产出了什么、消耗了什么,以及还需要有人修补什么。
更广泛的影响可能是 AI 在日常工作中的使用变得更加有选择性。团队可以用一种配置处理常规分析,另一种处理困难的编程工作,而在无法委托判断或问责的情况下交由人处理。竞争加剧为团队提供了又一个测试选项,却不会决定哪种选项应该胜出。
对 BIG CHANGE 而言,下一个里程碑是以更少的总投入完成可衡量的工作。如果 Grok 4.7 降低了通过验收的交付成果成本,就能让更多机构负担得起实用的自动化。如果额外推理只是把费用从 token 单价转移到更高用量上,醒目的价格数字对买家就没有多少参考价值。要回答这个问题,需要观察实际完成的任务,包括那些一开始就失败的任务。
## Sources
- [Matthew Berman:《我不知道该如何看待 Grok 4.7……》](https://www.youtube.com/watch?v=MJllZbpvrAc) — 视频于 2026 年 9 月 22 日上传,是本文分析的起因。与 Max Levchin 和 Alex Rampell 的 59 分钟对谈字幕已完整审阅。Berman 将自己的判断称为初步评估;赞助环节另行区分。录制日期尚未确认。
- [Grok 4.7 正式发布](https://x.ai/news/grok-4-7) — 2026 年 9 月 21 日。SpaceXAI 的公告及交互式基准测试图表。供应商测试结果需要结合推理强度设置解读;它们并非普遍适用的排名。
- [xAI 开发者发布说明](https://docs.x.ai/developers/release-notes) — 9 月 21 日条目确认了可用情况、上下文窗口、推理强度,以及标准和长上下文 API 费率。我们于 9 月 22 日核查;价格和产品访问条件可能变化。
- [Grok 4.7 产品文档](https://docs.x.ai/developers/grok-4-7) — 解释标准模型和 Fast 服务选项。Fast 的可用范围比标准 API 模型窄,因此演示和预算都必须注明服务档位。
- [Grok 4.7 模型定价](https://docs.x.ai/developers/models/grok-4.7) — 该模型的费率表,以及超过 200,000 个 token 提示词时适用的较高价格门槛。单看 token 价格不包含重试、工具和人工审核。
- [Cursor 的 Grok 4.7 文档](https://prod.cursor.com/docs/models/grok-4-7) — 区分了 Cursor 的标准上下文窗口和最大窗口。产品设置可能与底层 API 的容量不同。
- [Artificial Analysis:《Grok 4.7 基准测试》](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — 2026 年 9 月 21 日。支撑本文 token 用量和知识工作讨论的独立测试。报告区分了标准化评估和原生智能体结果,不应混合这些测试设置。
- [Artificial Analysis:Grok 4.7 发布资料](https://artificialanalysis.ai/models/releases/grok-4-7) — 说明该版本采用专有许可证且权重不可获取。视频中讨论的开放权重竞争趋势,并不能证明本模型采用开放权重。
- [Cursor 现已成为 SpaceX 的一部分](https://cursor.com/blog/joining-spacex) — 2026 年 8 月 14 日。Cursor 的收购公告为评估同一企业集团内推广的基准测试提供了背景。
BIG CHANGE 新闻通讯
纵览全局,按自己的节奏。
关于人工智能和机器人技术的近期报道、值得关注的变化以及可采用的实用想法。选择每日简报、每周摘要或每月视角。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.