Markdown 版本
AI-translated from English; not yet reviewed by a fluent editor.
# 在 Vals AI 的编程测试中,一个智能体团队提升了 7.3 个百分点,成本却是 2.5 倍
> 在 50 次应用构建中,Vals AI 仅发现 GPT 6 Sol 中等推理力度的团队取得了统计显著的提升;该配置每个应用花费 3.07 美元,而单体配置为 1.22 美元。
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
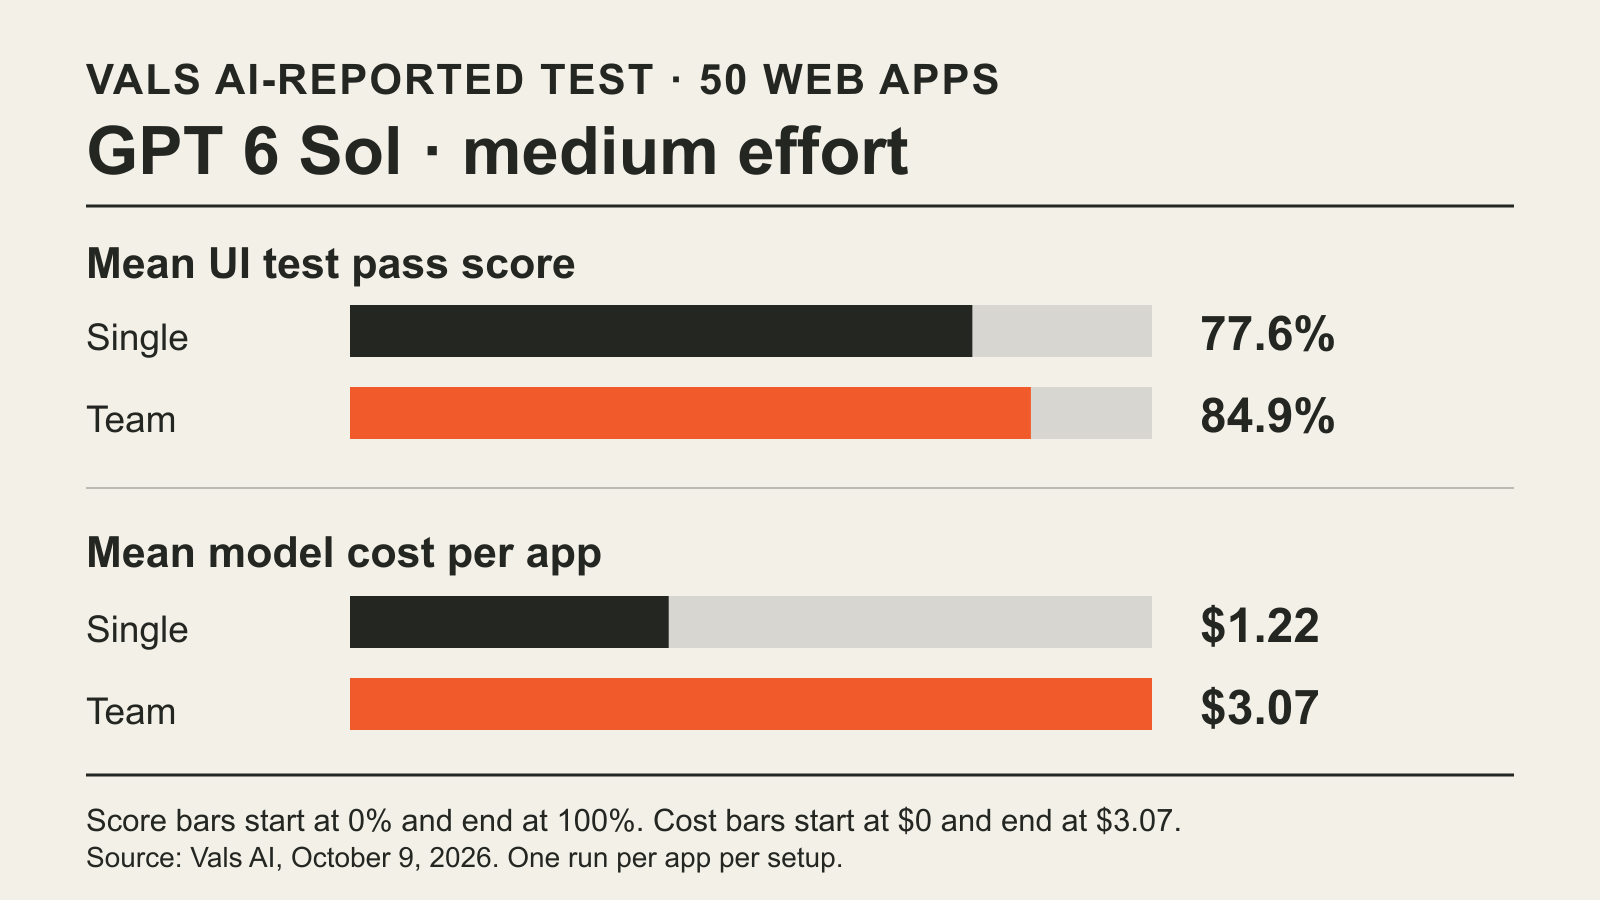
在 Vals AI 10 月 9 日发布的 [Vibe Code Bench 研究](https://www.vals.ai/blogs/multi-agent-vibe-code-bench)。GPT 6 Sol 中等推理力度团队通过了基准测试中 84.9% 的应用测试,而单个 Sol 智能体为 77.6%。这 7.3 个百分点的提升平均每个应用花费 3.07 美元,而非 1.22 美元。Vals 报告称,该提升的 95% 区间为 2.3 至 12.4 个百分点,配对检验的 p 值为 0.005。其余三组团队与单体智能体的比较均未显示统计显著的得分差异。
与其笼统地问团队是否“更好”,这个结果为开发者提供了更具体的预算问题。在这组 Web 应用构建任务中,中等力度的 Sol 以每个应用约多花 1.85 美元为代价,换来了可测量的质量提升,中位耗时几乎相同。在更高力度下,以及 Claude Opus 5.5 的两种力度下,本次测试均未证明团队额外支出带来了得分改善。
## 重大变化
- **变化内容:** Vals 在相同的 50 项 Web 应用任务和两种推理力度下,对比了单个编程智能体与团队。只有中等力度的 Sol 团队取得了统计显著的得分提升。
- **重要原因:** 获胜团队配置的每应用成本是单体配置的 2.5 倍;其他团队花费高出 1.8 至 5.1 倍,却没有显著得分提升。团队设计和模型设置应纳入同一项采购决策。
- **后续观察:**重复运行并在其他软件任务上测试,或能显示这项提升能否超出这些特定应用而保持稳定。本研究中的每种配置只运行了一次。
## 八次运行测量了什么
Vals 要求 GPT 6 Sol 和 Claude Opus 5.5 根据产品规格构建 50 个完整的 Web 应用。应用通过 Docker Compose 部署,并由浏览器智能体执行用户界面测试进行评分。报告的分数是每个应用测试通过比例的平均值。 [基准测试方法](https://www.vals.ai/benchmarks/vibe-code)说明每份应用规格包含 20 至 60 个自动化测试;单项测试至少有 90% 的步骤成功才算通过。
对于每个模型,Vals 将单个智能体与一名负责人进行比较;该负责人在中等和最高推理力度下均可同时委派给最多五个子智能体。负责人还被要求拆分、委派、整合并核验工作。每组模型比较中,任务提示、沙箱和评分器都保持一致。八种配置分别各构建了 50 个应用一次。
| 模型与力度 | 单体得分 | 团队得分 | 每个应用平均成本:单体 → 团队 | 中位运行时间:单体 → 团队 |
| --- | --- | --- | --- | --- |
| GPT 6 Sol,中等 | 77.6% | 84.9% | 1.22 美元 → 3.07 美元 | 12.4 → 11.9 分钟 |
| GPT 6 Sol,最高 | 89.0% | 90.4% | 4.82 美元 → 8.54 美元 | 38.4 → 27.6 分钟 |
| Claude Opus 5.5,中等 | 91.5% | 91.2% | 4.08 美元 → 9.10 美元 | 20.3 → 26.6 分钟 |
| Claude Opus 5.5,最高 | 89.8% | 93.2% | 23.77 美元 → 122 美元 | 74.7 → 174.1 分钟 |
这些是 Vals 估算的单个应用构建的模型平均成本,不是订阅价格,也不是每项成功 UI 测试的成本。运行时间是实际经过时间的中位数,因此每行的成本与耗时概括了 50 次运行的不同方面。最高力度 Opus 团队的平均值包含一次超时运行;Vals 根据令牌用量估算其成本约为 189 美元。
## 为何结果取决于具体配置
Vals 使用配对 t 检验,将每个团队与对应的单体智能体在相同应用上的表现进行比较。最高力度 Sol 团队提升 1.4 个百分点,95% 区间为 −1.7 至 4.5 个百分点。中等力度 Opus 团队低 0.3 个百分点,区间为 −3.2 至 2.5;最高力度团队提升 3.4 个百分点,区间为 −1.4 至 8.3。这些区间包含零提升。它们并不能证明这些配置中的团队永远无助于提升,但本次实验没有证实提升。
对于 Sol,推理力度也是一项测试变量。将单个 Sol 智能体从中等力度提高到最高力度后,得分从 77.6% 升至 89.0%;Vals 报告称这在统计上显著。该最高力度单体配置每个应用花费 4.82 美元,中位运行时间为 38.4 分钟;中等力度团队则为 3.07 美元和 11.9 分钟。这两种配置相差 4.1 个百分点,但统计上并不显著(p = 0.08)。这些数据让开发者看到实测的价格与时间权衡,无须假定某种配置在新项目上必然胜出。
各团队分配时间的方式也不同。Vals 表示,Sol 负责人较早委派任务,并亲自测试组装后的应用。其最高力度团队的中位完成时间为 27.6 分钟,单体智能体为 38.4 分钟。Opus 负责人则倾向于先编写共享约定,再分批委派。最高力度下,团队中位耗时 174.1 分钟,单体为 74.7 分钟;每个应用的成本约为单体的五倍。Vals 将大部分额外费用归因于子智能体各自上下文中缓存的输入令牌。
## 这一发现能说明到什么程度
显著性区间反映的是 50 个应用之间的差异,而不是同一应用重复尝试之间的波动。另一次运行可能改变比较结果。团队运行还额外收到委派指令,因此实验测量的是团队与指令共同作用的配置。Sol 使用 OpenAI Agents API,Opus 使用 Claude Code;跨模型得分比较也混合了不同的运行框架。Vals 对 Sol 成本的估算假设报告的令牌用量包含子智能体;由于缺少请求级用量数据,估算未计入超过长上下文阈值后可能产生的更高价格。
这项研究支持一个范围有限的决策:用这些配置构建类似的全栈应用时,中等力度 Sol 团队以更高成本带来了可测量的提升,而其他团队没有显示可靠的得分提升。研究无法确定团队在其他代码库、不同模型,或采用不同任务拆分和核验流程时是否值得投入。BIG CHANGE 审阅了 Vals 已发表的文章和方法;它没有运行或复现该基准测试。
## Sources
- [Vals AI,《智能体团队值得投入吗?Vibe Code Bench 案例研究》](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — 原始实验报告。报告中的得分、成本、运行时间、配对检验区间和 p 值、团队行为、实现细节及局限构成本文依据。八种配置分别在 50 个应用上各运行一次;报告的不确定性来自应用之间的差异,而非重复尝试。
- [Vals AI,Vibe Code Bench v1.1 方法说明](https://www.vals.ai/benchmarks/vibe-code) — 链接所指基准测试的描述与方法:应用规格、每个应用 20 至 60 项 UI 测试及评分规则。其综合排行榜采用其他运行框架配置,不能替代智能体团队案例研究的结果。
- [The Decoder,《研究发现:AI 智能体团队浪费大量令牌,质量提升却几乎不可测》](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — 作为发现线索和背景参考的独立同期报道。本文的数字和方法论说法均根据 Vals 原始报告核对;BIG CHANGE 不采纳其标题中更宽泛的结论。
BIG CHANGE 新闻通讯
纵览全局,按自己的节奏。
关于人工智能和机器人技术的近期报道、值得关注的变化以及可采用的实用想法。选择每日简报、每周摘要或每月视角。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.