AI-translated from English; not yet reviewed by a fluent editor.
# Claude 恢復了,企業仍需要服務復原計畫
> 9 月 22 日 Claude 服務事件已解除。本實用指南說明企業如何在服務受限時維持運作、保存未完成工作,並在 AI 中斷後處理待辦積壓。
By BIG CHANGE Editorial
Published: 2026-09-22T08:51:37.833Z
Updated: 2026-09-22T08:51:37.833Z
Canonical: https://bigchange.ai/blog/claude-outage-ai-business-continuity
AI-generated conceptual illustration by BIG CHANGE. When an AI service pauses, a business still needs accessible records of unfinished work. The bookmarked ledger represents preserving the stopping place. Conceptual illustration, not evidence of damaged equipment or lost data.
Claude 於 9 月 22 日在多個模型上出現錯誤率升高。Anthropic 最終事件更新列出的影響時段為 UTC 00:50 至 02:10,共 80 分鐘;並於 UTC 02:35 將事件標記為解除。受影響元件包括 claude.ai、API、Code 與 Cowork。紀錄未表示所有請求都失敗,也未公布根本原因。 [Anthropic 事件紀錄](https://status.claude.com/incidents/7g1qpkyz5gxh)
對將 AI 納入工作流程的企業而言,服務恢復只解決了部分問題。客戶請求可能仍在等待;有人或許已開始手動處理案件,而自動化程序仍在執行。主管需要知道哪些工作可以恢復,哪些工作必須先檢查。
助理偶爾無法使用,若只用於腦力激盪,最多是不方便;但若同一服務用於分類來件、撰寫回覆及更新紀錄,中斷就會成為營運問題。實用的準備方式,是制定一份簡短的持續營運計畫,讓員工在無法使用 AI 時也能遵循。
本指南以假設的客服團隊示範計畫如何運作。相關程序是可供調整與演練的建議,不是 BIG CHANGE 執行的測試,也不是對此次事件受影響客戶的描述。
## 選擇無 AI 也能維持的服務水準
想像一家小型設備供應商使用助理分類客戶支援訊息,並根據核准的產品資料準備回覆。員工寄出前會先審查內容。即使最後答案仍由人員負責,企業的案件佇列已仰賴這套系統進行整理。
若助理停止回應,主管首先要決定客服團隊仍能承諾提供什麼服務。員工或許能繼續確認已收到請求,並處理期限迫近的案件,同時延後例行產品說明。他們必須能在助理之外存取原始訊息及核准的參考資料,否則「改用人工處理」只是沒有配套的指示。
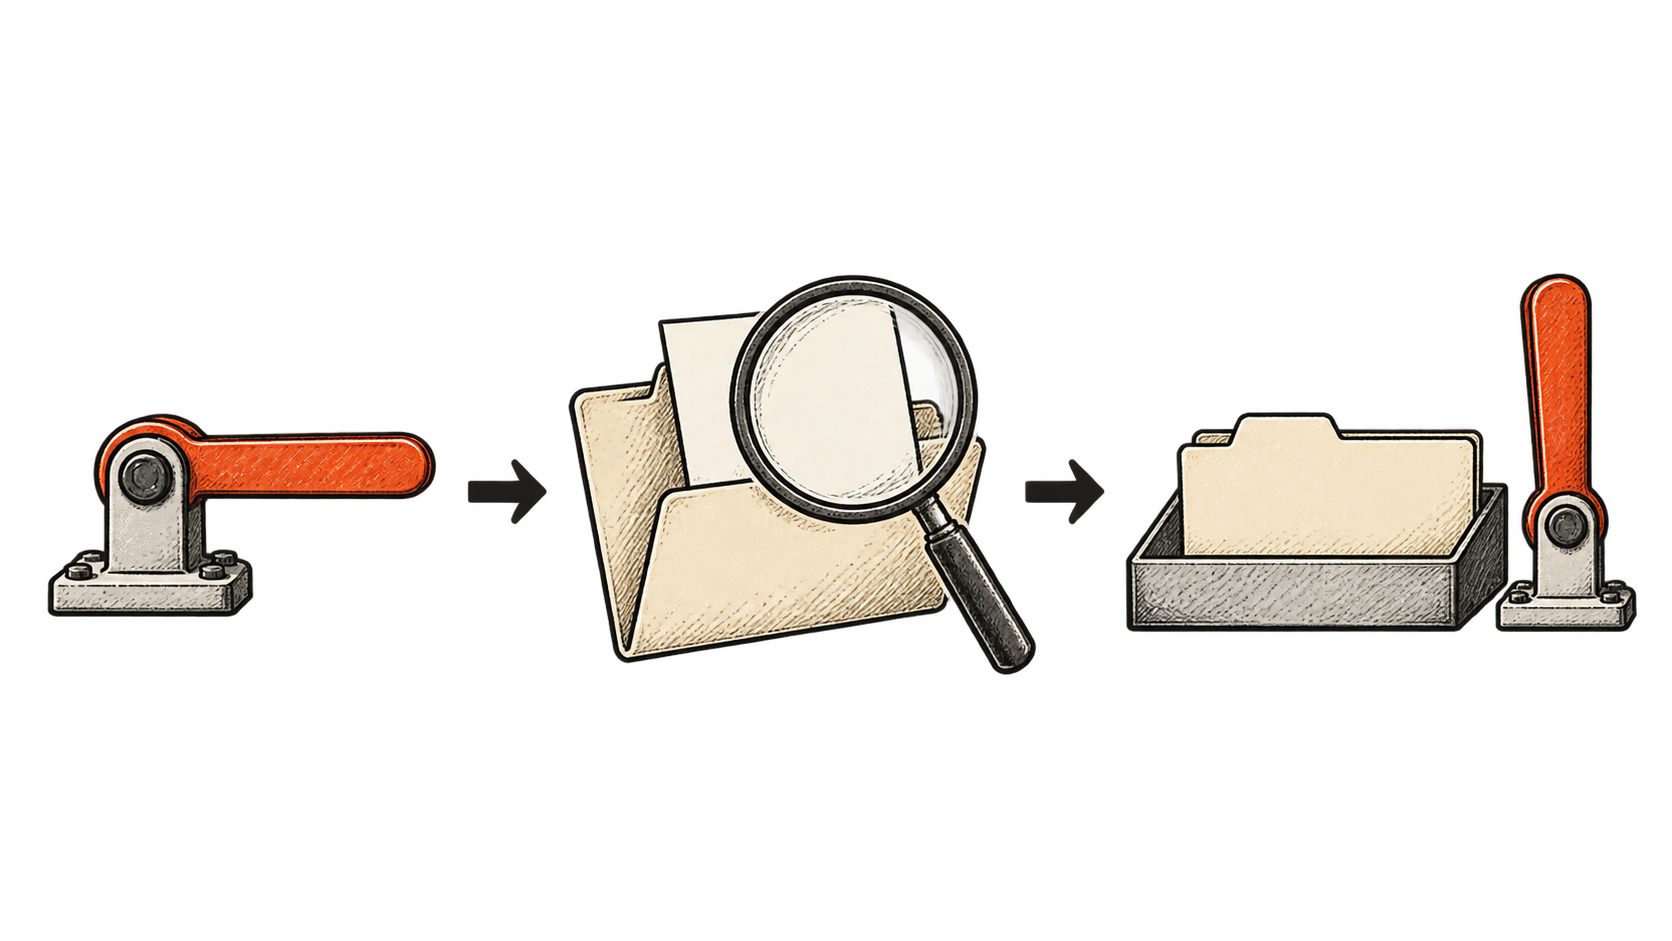
事先決定這種降級服務模式。指定能啟用模式的人員、暫停的工作,以及負責剩餘任務的員工。設定檢查時間,避免臨時安排整個下午都沒有人重新評估。面向客戶的通知應說明延誤及緊急協助管道,並只承諾團隊能做到的事。
Google 的工程指引指出,資源受限時可提供縮減功能、限制流量並優先處理重要請求。這些是既有可靠性工程方法,不是對此次 Claude 事件的診斷。若用於客服,就能在正常處理方式中斷時,有計畫地縮小服務範圍。 [Google SRE:處理過載](https://sre.google/sre-book/handling-overload/)
降級服務也需要容量上限。不能默默要求兩名員工接手原本由自動化系統服務大量請求的全部工作。應記錄他們能處理多少、哪些工作須等待,以及何時需要額外協助。比起讓自動確認訊息暗示服務照常運作,提供可信的回覆時程對客戶更有幫助。
## 在對話之外保留工作紀錄
服務團隊需要一份助理無法使用時仍可讀取的案件紀錄,可以使用既有支援系統。重要的是,企業不必要求中斷服務的助理還原情況,也能確認發生了什麼。
每個案件都應保存原始請求、負責的人員或流程,以及最後一項已確認的行動。儲存草稿不等於已寄出回覆;提議變更客戶紀錄,也不等於該系統已確認變更。應保留能區分兩者的證據,並遵循客戶資訊原本適用的存取限制。
中斷期間,可將工作分為以下實用類別:
- 尚未開始:處理或外部操作都還沒開始。
- 部分完成:已產生分類或草稿,但下一步尚未完成。
- 已確認完成:目的端系統已記錄預期操作。
- 狀態不明:已嘗試操作,但缺少確認。
將狀態不明的案件交給能檢查相關系統的人員,再決定是否恢復處理。若連線中斷時助理正在準備回覆,重新產生草稿或許無妨;但如果另一項工具正在寄送回覆,重做整個任務可能寄出兩次。工作流程紀錄應清楚區分兩種情況。
Anthropic 的 API 文件指出,串流回應即使一開始收到 HTTP 200 成功回應,之後仍可能失敗。看到部分文字或收到初始狀態碼,不代表整份答案都已送達。整合程式應確認請求確實完成,並將部分成果標示為未完成。 [Claude API 錯誤文件](https://platform.claude.com/docs/en/api/errors)
## 為重試設定上限與負責人
重試可能排除暫時性錯誤,但也可能讓多個層級各自重複工作,使狀態更不明確。新增重試按鈕或自動迴圈前,先詢問軟體供應商,其用戶端程式庫是否已內建重試。
Anthropic 文件指出,其官方 SDK 遇到暫時性錯誤時預設會自動重試兩次,逐次延長等待時間,並遵循有提供的 retry-after 指示。錯誤文件也區分暫時性伺服器問題,與驗證、權限及格式錯誤的請求。不能假設重送相同請求能解決所有類別的錯誤。 [Claude 有文件記載的重試行為](https://platform.claude.com/docs/en/api/errors)
對客服團隊而言,作業規則應明定何時停止自動嘗試,以及之後由誰接手案件。保留請求識別碼以利除錯,並讓員工知道工作是等待中、重試中,還是等待人員處理,避免他們不知情地啟動互相衝突的作業。
AWS 說明,即使回應沒有送達,動作本身仍可能已成功。其具冪等性的 API 會使用明確的請求識別碼辨識重送,並防止副作用再次發生;但接收服務必須實際實作這項機制,只附上內部案件編號並不會自動取得同樣保障。 [AWS:讓重試安全的具冪等性 API](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/)
請針對工作流程實際執行的動作具體詢問。重複嘗試是否可能新增第二張支援單或寄出另一封郵件?若無法防止重複,就應在重試前檢查目的端紀錄。重試文字生成與重做整個商業流程,需要不同決策。
## 備用模型需要更明確的工作範圍
另一項 AI 服務或許能協助工作繼續,但多開一個帳戶只是備援的開始。替代服務需要適當指示、核准的參考資料及處理資料的權限;企業需要時,也必須有足夠容量。
先為備援設定明確範圍,再考慮全面替換。在假設的客服團隊中,另一款模型或許可以分類例行訊息,而由員工處理對客回覆。團隊可用具代表性的案件評估,包括模糊的產品名稱,以及必須轉交人員的請求。答案寫得流暢,不能證明它遵循公司的支援規則。
應在事件發生前決定哪些資訊可以傳送至替代服務。員工不應臨時把客戶紀錄貼進個人帳戶。採購時應一併檢查替代服務的資料處理條款與存取安排,以及輸出品質和價格。
模型名稱不同,不代表服務可用性彼此獨立。備援服務仍可能依賴同一個登入帳戶、網路連線、文件儲存庫或協調軟體。應整理替代方案實際能避開哪些相依項目。這項檢查可能顯示,相較於使用同一條故障連線上的另一款模型,保留可存取參考文件的人工佇列更能提供保障。
指示會變更、產品知識會過時,替代方案也需要維護。員工必須練習不常使用的程序。小型企業合理的選擇,可能是保留速度較慢的人工服務,而非付費複製整套營運。應依延誤工作的成本及錯誤回覆造成的損害做決策。
## 透過審查後的佇列恢復服務
供應商宣布服務恢復後,在恢復正常處理前,先抽樣檢查自家工作流程。樣本應包含一項能測試企業所需文件查詢與紀錄更新的案件。模型成功回覆,不能證明所有連接系統也都已準備就緒。
接著檢查等待中的工作。移除已由人員處理的案件、檢查狀態不明的操作,並找出情況已改變的請求。中斷期間,客戶可能提供新資訊。若依舊版本的案件內容產生回覆,技術故障結束後仍可能引發新問題。
分批釋出其餘工作。保留容量處理新的緊急請求,並觀察佇列是否縮短。若新需求占滿所有可用處理能力,即使每項新請求都成功,積壓工作仍會持續。追趕進度可能需要增加人力、暫時降低服務量,或如實延長回覆時程。
以下是另一個獨立的數字範例:假設每小時收到 24 件案件,處理停止 30 分鐘,就會累積 12 件待辦。之後若客服每小時處理 36 件,同時每小時仍有 24 件新案進來,清空積壓需一小時。這些是說明用假設數字,並非 Claude 事件的實測資料。
Google 的服務水準目標指引,從使用者重視的結果與交付所需的相依服務著手。對這個客服團隊而言,可衡量緊急案件中,有多少能在承諾時限內得到適當回應。供應商服務可用率固然相關,企業也需要知道客戶是否實際收到服務。 [Google SRE:制定服務水準目標](https://sre.google/workbook/implementing-slos/)
記錄客服何時恢復正常、未解決案件數,以及事後需要進行的修正。這些指標能呈現供應商狀態頁無法觀察到的復原工作。
## 全面擴大自動化前,先演練一次服務中斷
簡短的桌上演練可以找出存取權或責任歸屬缺漏,而不必影響真實客戶。使用幾個虛構支援案件,按以下順序演練:
1. 假設模型在準備回覆途中無法使用。詢問由誰啟用降級服務,以及員工到哪裡查閱原始請求。
2. 設定一件已確認寄出回覆的案件,以及另一件寄送狀態不明的案件。檢查團隊是否知道該查哪個系統才能確認結果。
3. 假設供應商服務已恢復,但新案件仍持續進來。決定先恢復哪些工作,以及如何將人工完成的案件移出積壓佇列。
4. 請一位並非計畫撰寫者的人員說明程序,並指出他缺少哪些權限或紀錄。
記下演練無法回答的問題。後續修正可能很小,例如取得既有佇列的存取權、設定清楚的暫停控制、保存確認紀錄,或指定復原負責人。這些做法都無法保證服務永不中斷,但能在保留自動化效益的同時,更容易控制中斷影響。
再交付新的營運責任給助理前,請同事示範停機時如何接手。如果答案仰賴無法使用的助理記得自己正在處理什麼,持續營運計畫就還有待補強。
## Sources
- [Claude 狀態頁:多個模型錯誤率升高](https://status.claude.com/incidents/7g1qpkyz5gxh) — 供應商事件紀錄列出 80 分鐘的影響時段及較晚的解除時間。該公開 JSON 紀錄已另行讀取。紀錄稱錯誤率升高,未稱所有請求都失敗,也沒有公布根本原因。
- [Claude Platform:API 錯誤](https://platform.claude.com/docs/en/api/errors) — 現行文件涵蓋錯誤、SDK 預設重試,以及串流開始後發生的失敗。這些機制無法證明商業任務已完成,也不能防止連接工具重複執行動作。
- [AWS Builders’ Library:透過具冪等性 API 安全重試](https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/) — Malcolm Featonby 說明回應狀態不明及防止重複操作的方式。接收服務必須實作相應 API 契約;單靠識別碼並不足夠。
- [Google SRE:處理過載](https://sre.google/sre-book/handling-overload/) — 關於縮減功能、工作優先順序及限制重試的既有工程指引。本文將原則套用至假設的客服團隊,並非用以診斷 Anthropic 事件原因。
- [Google SRE Workbook:制定服務水準目標](https://sre.google/workbook/implementing-slos/) — 說明以使用者結果及關鍵相依項目為基礎的可靠性目標。建議的客服指標與積壓範例是說明性應用,不是實測結果或通用目標。