Markdown 版本
AI-translated from English; not yet reviewed by a fluent editor.
# Grok 4.7 上市,token 單價不變;更重要的是完成工作的總成本
> Grok 4.7 主打更強的程式開發與辦公工作能力。我們檢視 Matthew Berman 的評論、獨立測試,以及團隊轉換模型前應衡量的項目。
By BIG CHANGE Editorial
Published: 2026-09-22T02:10:45.042Z
Updated: 2026-09-22T02:10:45.042Z
Canonical: https://bigchange.ai/blog/grok-4-7-launch-pricing-benchmarks-cost-of-work
AI-generated conceptual illustration by BIG CHANGE. Evaluating the time, usage and review needed to finish useful work.
Grok 4.7 於 2026 年 9 月 21 日推出。對使用 AI 撰寫程式碼或分析商業資訊的團隊而言,這次發布帶來一項實際問題:更好的模型能否降低完成工作的成本?答案不只取決於公告中的 token 單價。[官方版本說明](https://docs.x.ai/developers/release-notes)
這種多面向的情況,正是 Matthew Berman 於 9 月 22 日發布的影片*我不知道該如何看待 Grok 4.7……*所探討的內容。他質疑比較方法是否恰當,並主張每項任務的完成成本,比 token 價格更重要。他也表示自己尚未充分測試該模型。這部影片是對現有證據的初步評估,並非完整的實測評鑑。[Berman 對談開場,0:00](https://www.youtube.com/watch?v=MJllZbpvrAc&t=0s)
這次發布值得關注,因為有用的模型不必在每項基準測試中都勝出,仍可能改變企業能以什麼成本自動化工作。但它必須能正確完成足夠多的任務,才值得負擔整體成本。獨立測試已凸顯其中張力:Grok 4.7 的成績提升,可能伴隨大幅增加的生成內容。
對開發者、小型企業與建置代理的團隊而言,決策很實際:這個模型能以可接受的品質完成哪些任務?需要投入多少成本與心力?模型表示完成後,還剩多少工作要由人接手?
我們完整檢視了 Berman 約 17 分鐘影片的字幕,並查閱產品發布資訊、技術文件及 Artificial Analysis 的評估。以下分析不包含 BIG CHANGE 的基準測試,也不宣稱曾親自測試 Grok。
## 產品發布內容與供應範圍
標準模型可透過 xAI API、`grok-4.7`以及 Cursor 和 Grok Build 使用。API 可接收文字與影像,並產生文字。文件列出的上下文視窗為 500,000 個 token,推理強度有低、中、高與 xhigh 四種設定,預設為高。[官方版本說明](https://docs.x.ai/developers/release-notes)
SpaceXAI 將效能改善歸因於更大型的基礎模型,以及讓模型在較困難任務上接受更長時間的強化學習。這是開發者對原因的說明。[技術發布概覽](https://x.ai/news/grok-4-7)
此外還有 Grok 4.7 Fast。文件將它描述為在更快基礎設施上執行的相同模型,token 費率是標準版的兩倍。Fast 可透過 Cursor 與 Grok Build 使用,但不在 Grok Build 免費方案內,也無法透過 xAI 公開 API 使用。[Grok 4.7 產品文件](https://docs.x.ai/developers/grok-4-7)
比較截圖、示範與帳單時,這些差異很重要。模型版本、推理強度與服務等級是不同選項。若示範使用 Fast 和 xhigh,就不能用來推估標準速度、中等推理強度的 API 呼叫體驗或成本。
發布頁面與其他模型的比較,也應與升級前後的比較分開看待。SpaceXAI 表示,標準 Grok 4.7 與 Grok 4.6 的價格及速度相同;但該公司沒有說,從 4.6 升級後顧客帳單會自動減半。
## 價格表設有長上下文門檻
公開的標準 API 費率如下:
- 提示詞不超過 200,000 個 token:每百萬 token 的輸入費 2 美元、快取輸入費 0.50 美元、輸出費 6 美元。
- 提示詞超過 200,000 個 token:每百萬 token 的輸入費 4 美元、快取輸入費 1 美元、輸出費 12 美元。
這些是 token 費率,並非代理完成工作的全包價格。模型頁面提醒,請求超過 200,000 個 token 時費率會提高,版本說明也列出較高費率。價格與供應情況查核日期為 9 月 22 日。[模型價格](https://docs.x.ai/developers/models/grok-4.7)與[版本說明](https://docs.x.ai/developers/release-notes)
因此,500,000 個 token 的上下文視窗不代表範圍內每項請求都能使用最低費率。上下文視窗很大,也不代表模型每次都能從大量檔案中穩定找出所有相關細節。
Cursor 又多一項產品層級差異:其文件列出的標準上下文視窗為 256,000 個 token,最高可達 500,000 個。編輯器提供的容量可能與 API 規格不同,或取決於所選模式。[Cursor 的 Grok 4.7 文件](https://prod.cursor.com/docs/models/grok-4-7)
對處理長篇報告的團隊來說,眼前的問題是:完整輸入所有資料,是否能顯著改善結果,值得額外付費?擷取相關段落可能更便宜,也更容易檢查。有時確實需要整份文件;有時只是因為這是最容易組成提示詞的方法。預算規劃不應把兩種情況視為相同。
## 效能提升可能消耗更多 token
Artificial Analysis 於 9 月 21 日發布的評估中,Grok 4.7 在 xhigh 下的 Intelligence Index 得分為 46,比 Grok 4.6 高 2 分。該報告估計每項任務約產生 81,000 個輸出 token;相較之下,Grok 4.6 使用高推理強度時為 36,000 個。報告也列出 Grok 4.6 在 xhigh 下產生 38,000 個 token,因此即使比較相同推理強度,Grok 4.7 的輸出 token 數也超過兩倍。[Artificial Analysis 的上市評估](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
這是將 token 單價與任務成本分開檢視的具體理由。若以每百萬輸出 token 6 美元的基本費率計算,輸出 81,000 個 token 的示意費用為 0.486 美元;38,000 個 token 則為 0.228 美元。這些計算刻意不納入輸入、快取效果、工具費、長上下文費率與失敗重試成本。這只是依據報告中的 token 數量進行算術計算,並非實測工作的全包價格。
輸出更多內容不一定代表浪費。模型或許多花些力氣檢查答案,因此避免原本需要人工介入的錯誤;也可能花更長時間追逐錯誤解法。單靠 token 數量,無法分辨有成效的持續推理與昂貴的重複嘗試。
Berman 在影片接近結尾時再次談到這個問題,並指出 Artificial Analysis 報告的 token 使用量較高。[影片,15:43](https://www.youtube.com/watch?v=MJllZbpvrAc&t=943s)
真正有價值的是獲採納的交付成果。通過適當測試與審查的程式碼變更、公式能對得起資料的試算表,或主張可追溯至證據的報告,都比單純快速得到答案更有價值。
## 基準測試顯示模型能力強,但表現不平均
發布比較表列出 Grok 4.7 xhigh 在 CursorBench 4.0 的得分為 46.3%,低於 Fable 5.1 max 的 51.8%;Fable 在 Terminal-Bench 的比較中也領先。[供應商基準測試表](https://x.ai/news/grok-4-7)
隨附圖表以生成 token 數為橫軸、基準測試分數為縱軸,線條則比較不同推理設定;圖上越往右,token 數越少。[互動式原始圖表:選擇 Tokens](https://x.ai/news/grok-4-7)。[開啟完整尺寸圖表](https://bigchange.ai/api/media/file/grok-cursorbench-user-chart.png)。
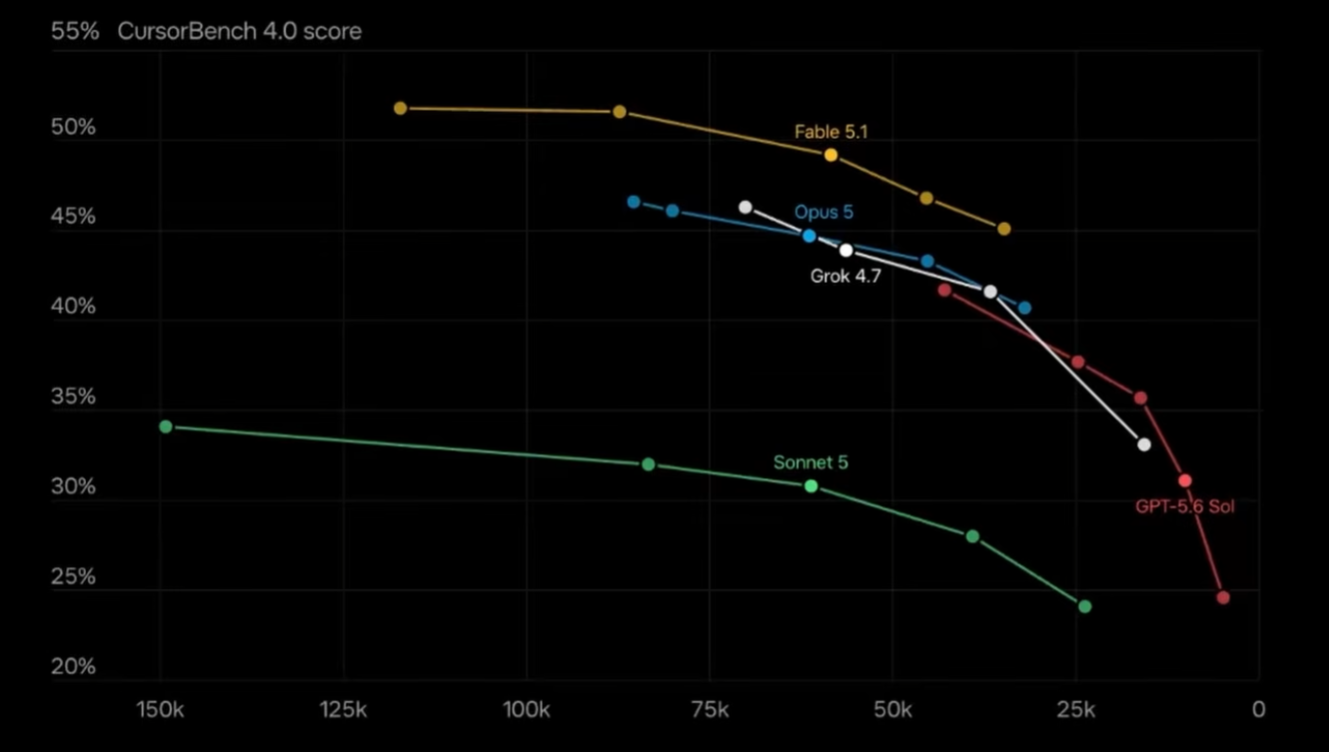
往上代表分數較高,往右代表在這項評估中生成的 token 較少;但這不代表全包價格較低,因為 token 費率、輸入使用量與代理周邊系統都會影響成本。這也與前述 Artificial Analysis 的 token 數據是不同測試。若將兩者的數字混為一談,就會抹去解讀各自結果所需的任務與方法差異。
這些資訊足以否定「Grok 4.7 在所有程式開發工作中都領先」這種一概而論的說法,也足以支持團隊針對特定工作負載進一步測試。單項評估的分數提升多少,無法預測模型處理陌生程式碼庫、不完整錯誤回報或特殊工具環境時的表現。
Artificial Analysis 提供了另一項有用區別。報告指出,Grok 4.7 搭配 Grok Build 的 Coding Agent Index 得分為 56,高於 Grok 4.6 搭配該代理的 47 分。報告特別將原生代理的結果,與標準化的 Intelligence Index 測試架構分開處理。[獨立評估與方法說明](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
周邊代理系統同樣重要。它提供工具、管理上下文,並決定如何執行模型的請求。即使模型名稱不變,更換系統環境也會改變結果。若將一種設定的終端機分數與另一種設定的軟體工程分數放在一起,可能拼出一張令人信服的表格,卻沒有人實際測過表中的系統。
Berman 指出,發布比較表中缺少 GPT-6 Astra,並以 AI 生成的重建結果補上數據。這可以作為深入調查比較方式的起點,但重建結果並非獨立基準測試來源。我們不會在未查核原始評估前採用新增數值。[影片,6:03](https://www.youtube.com/watch?v=MJllZbpvrAc&t=363s)
也須留意商業關係。Cursor 於 8 月 14 日的公司公告指出,SpaceX 已收購 Cursor。該產品系列內部發布的基準測試仍有參考價值,但它並非對競爭供應商的中立評估。[Cursor 收購公告](https://cursor.com/blog/joining-spacex)
## 辦公室工作可能更值得關注
這項獨立評估指出,Grok 4.7 在 xhigh 下的 AA-Briefcase 得分為 1,657 Elo,比 Grok 4.6 在 high 下高 111 分。報告將大部分改善歸因於分析品質,但呈現品質略低於舊模型的結果。[Artificial Analysis 知識工作評估](https://artificialanalysis.ai/articles/benchmarking-grok-4-7)
對委託撰寫報告、試算表或簡報的人而言,這項分數落差很有參考價值。答案的分析可能更強,仍需要編輯或重新設計;反過來說,精美簡報也可能掩蓋薄弱推理。只評估表面完成度,可能獎勵錯誤的改善。
營運團隊可以用定期績效報告測試模型。有效的試用應檢查報告是否採用正確期間、能否用來源資料核對數字,以及是否區分觀察到的變化與推測原因。審查者應記錄需要多少修正,而不只是第一次查看時報告看起來是否專業。
小型企業可能不在意能否贏過最困難的基準測試,更在意能否把原本負擔不起的分析工作變成例行作業。這是 AI 擴大採用的一種可能途徑;當輸出夠準確、能準時交付,且比負責人手動完成更省力時,這項可能性才成為現實。
專業基準測試的標籤不等於專業資格。法律工作或臨床推理的測試結果,描述模型在該項評估中的表現,不能證明模型能獨立處理客戶法律案件或替病患作出醫療決策。本文不建議將 Grok 用於這些決策。
## 安全防護的主張也應放在實際脈絡中評估
SpaceXAI 表示 Grok 4.7 加入新一代安全防護機制,並提升抵禦越獄攻擊的能力。這是產品發布時的主張,不保證所有採用該模型的應用程式都安全。[開發者對安全防護的說明](https://x.ai/news/grok-4-7)
企業代理至少仍有兩個問題:模型能否妥善回應收到的請求?應用程式又是否限制了模型實際能做的事?
模型可能正確理解更改客戶紀錄的指示,卻沒有獲准執行該操作;也可能遇到文件內嵌的惡意指示,而原本只被要求摘要文件。存取控制與核准規則必須留在周邊系統中;改善拒答表現無法取代這些機制。
實際做法是測試整個工作流程,包含應成功的合法請求、應遭封鎖的禁止操作,以及應暫停等待釐清的模糊情況。過常拒絕無害工作,會讓產品難以使用;執行未獲授權的操作,則可能造成更大傷害。單一醒目分數無法反映這兩種問題。
## 影片仍未解決的問題
Berman 的評論提出了一些仍須保留為問題的議題。他將價格與可用運算資源連結的說法,是對市場的解讀,不是公開的單位成本會計資料;他談到的社群媒體預測,是對未來的期望,而非已交付效能的證據;結尾的示範比較,也附帶他本人不清楚所用設定的說明。[價格討論,8:44](https://www.youtube.com/watch?v=MJllZbpvrAc&t=524s)、[預期,11:51](https://www.youtube.com/watch?v=MJllZbpvrAc&t=711s)以及[示範討論,15:20](https://www.youtube.com/watch?v=MJllZbpvrAc&t=920s)
影片也談到開放權重模型,但這股更廣泛的競爭趨勢,不應與 Grok 4.7 的授權狀態混為一談。Artificial Analysis 將此版本列為專有模型,並指出權重無法取得。[Grok 4.7 發布資料](https://artificialanalysis.ai/models/releases/grok-4-7)
這些區別能讓評估保持聚焦。產品價格看似吸引人,不代表大眾知道供應商為何採用該價格;醒目的失敗示範可以指出值得重測的項目,卻不能證明模型整體表現差;模型已經推出,也不代表它一定符合創辦人早先的預測。
影片中也有贊助內容。Berman 的影片包含 Zapier 廣告,這不是 Grok 效能的獨立證據,廣告中的促銷主張也不是 BIG CHANGE 的推薦。
## 更好的採購指標:每項獲採納任務的成本
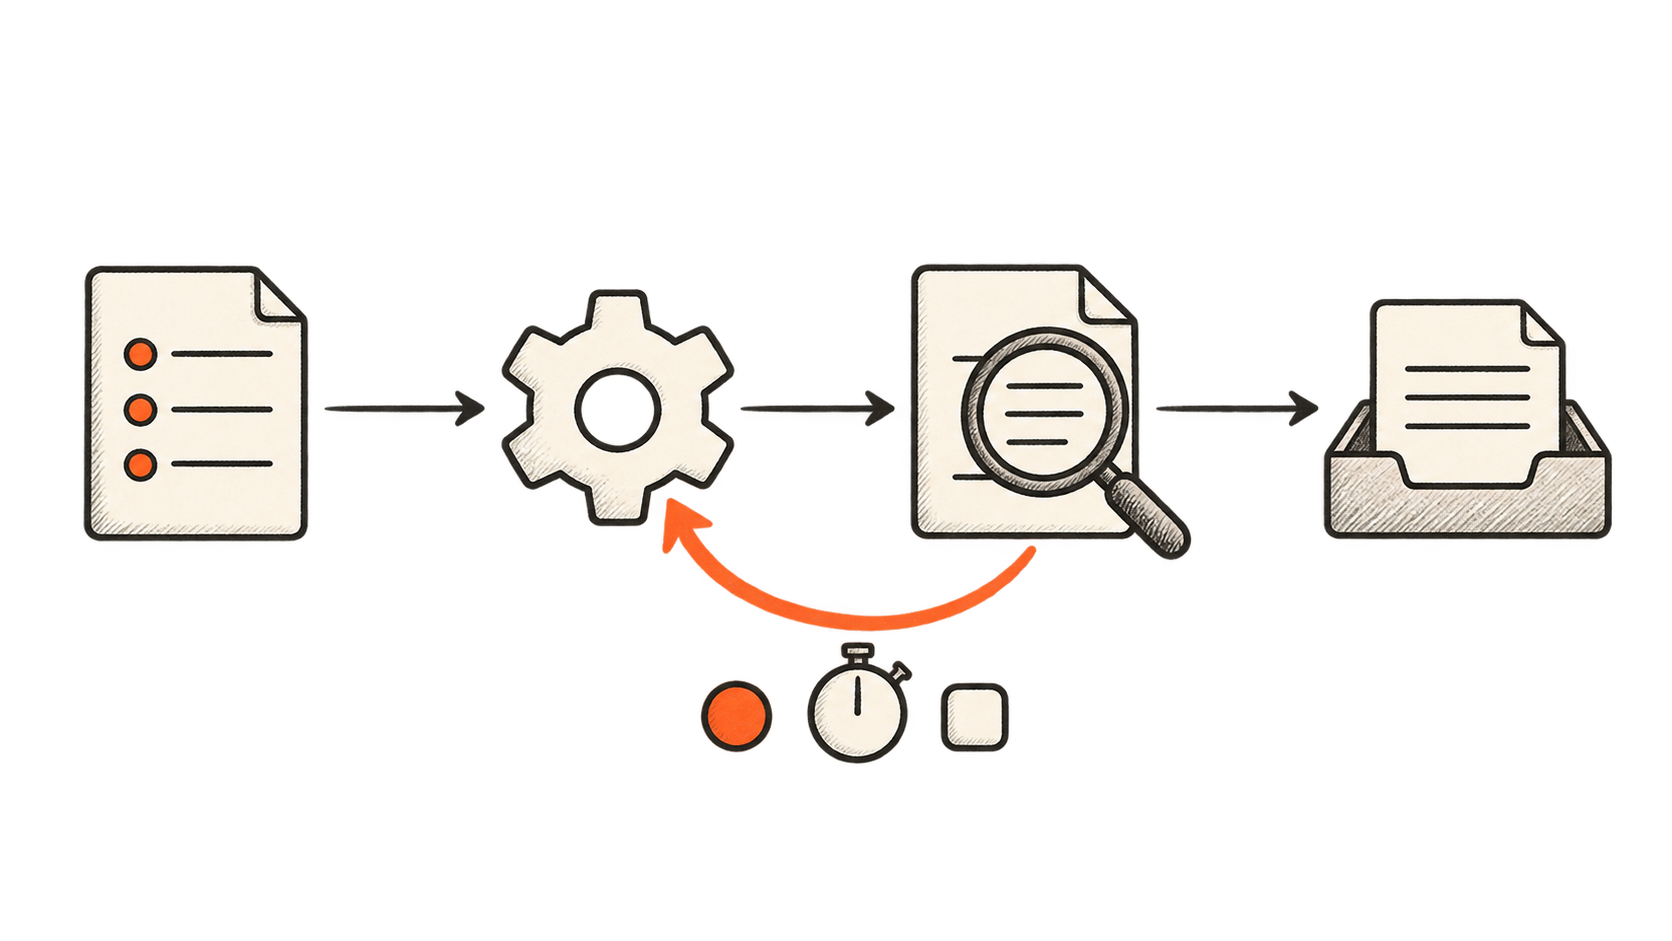
考慮採用 Grok 4.7 的團隊,應選取一小組具代表性的工作,與目前流程進行比較,並在看到輸出前先定義驗收標準。程式開發任務可要求相關測試通過、修補程式易讀且不包含無關變更;分析工作則可要求計算正確,重要主張有證據支持。
接著記錄完整費用:輸入與輸出使用量、工具、重試,以及審查或修補結果所花的時間。失敗嘗試也要計入。再以符合驗收條件的交付成果數量,除以這些總成本。
一個示意例子可說明這項差異的重要性。假設某種設定處理一批工作花費 20 美元,產出 80 項獲採納成果,則在計入人力前,每項成果成本為 0.25 美元。另一種設定花費 12 美元,只產出 30 項獲採納成果,每項成果成本為 0.40 美元。後者的整批費用較低,取得可用成果的成本卻較高。這些是假設數字,不是 Grok 實測結果。
推理強度也應納入試用。高推理強度或許值得用在困難任務上,例行任務卻可能不需要。只將必要個案升級處理,或許比每項請求都使用 xhigh 更省成本;前提是也要評估如何決定升級對象。
不同模型應採用一致的審查標準。若降低較便宜模型的驗收門檻,接受品質更差的成果,就會製造表面上的節省;若只對現有模型提高門檻,也會造成相反偏差。真正的目標是取得可靠成果,並清楚交代人員還需完成哪些工作。
## 值得關注的變化
Grok 4.7 為團隊提供另一項可測試的選擇。是否採用,必須從整體工作來看:模型產出了什麼、消耗了多少資源,以及還需要人員修補哪些部分。
更廣泛的影響,可能是企業在日常工作中更有選擇地使用 AI。團隊可以用一種設定處理例行分析、另一種處理困難程式開發,而在需要判斷力或問責能力時交由真人處理。競爭增加,讓團隊多了一個可測試選項,卻不會替團隊決定哪個選項最好。
對 BIG CHANGE 而言,下一個里程碑是以更少總投入完成可量測的工作。若 Grok 4.7 能降低獲採納交付成果的成本,就能讓更多組織負擔得起實用自動化;若額外推理只把成本從 token 單價轉移到更高用量,醒目的單價對買家就幾乎沒有參考價值。最終能回答這個問題的證據,來自已完成的工作,也包括曾經失敗的嘗試。
## Sources
- [Matthew Berman:我不知道該如何看待 Grok 4.7……](https://www.youtube.com/watch?v=MJllZbpvrAc) — 2026 年 9 月 22 日。引發本文分析的影片。附上時間戳記的連結標示文中探討的內容;Berman 將自己的評估稱為初步分析。影片贊助片段與模型效能證據分開處理。
- [Grok 4.7 登場](https://x.ai/news/grok-4-7) — 2026 年 9 月 21 日。SpaceXAI 公告及互動式基準測試圖表。供應商的測試結果須考量推理強度設定,不能視為普遍適用的排名。
- [xAI 開發者版本說明](https://docs.x.ai/developers/release-notes) — 9 月 21 日的版本條目確認供應情況、上下文視窗、推理強度,以及標準與長上下文 API 費率。於 9 月 22 日查核;價格與產品存取情況可能變動。
- [Grok 4.7 產品文件](https://docs.x.ai/developers/grok-4-7) — 說明標準模型與 Fast 服務選項。Fast 的供應範圍小於標準 API 模型,因此示範與預算都應註明服務等級。
- [Grok 4.7 模型價格](https://docs.x.ai/developers/models/grok-4.7) — 模型費率表,以及提示詞超過 200,000 個 token 後的較高價格門檻。單看 token 價格,不包含重試、工具與人工審查。
- [Cursor 的 Grok 4.7 文件](https://prod.cursor.com/docs/models/grok-4-7) — 區分 Cursor 的標準上下文視窗與最高容量。產品設定可能與底層 API 的容量不同。
- [Artificial Analysis:Grok 4.7 基準測試](https://artificialanalysis.ai/articles/benchmarking-grok-4-7) — 2026 年 9 月 21 日。提供 token 用量與知識工作分析的獨立測試。報告區分標準化評估與原生代理結果,不應混用兩種設定。
- [Artificial Analysis:Grok 4.7 發布資料](https://artificialanalysis.ai/models/releases/grok-4-7) — 指出此版本採專有授權,且模型權重無法取得。影片討論開放權重競爭,不代表 Grok 4.7 採開放權重。
- [Cursor 現已成為 SpaceX 的一部分](https://cursor.com/blog/joining-spacex) — 2026 年 8 月 14 日。Cursor 收購公告提供了評估同一企業集團內宣傳之基準測試的背景。
BIG CHANGE 電子報
掌握全貌,按照自己的步調。
關於人工智慧和機器人技術的近期報導、值得關注的轉變,以及可運用的實用想法。選擇每日快訊、每週摘要或每月觀點。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.