Markdown 版本
AI-translated from English; not yet reviewed by a fluent editor.
# 在 Vals AI 的程式設計測試中,一個智慧代理團隊提升了 7.3 個百分點,成本卻是 2.5 倍
> 在 50 次應用程式建置中,Vals AI 僅發現 GPT 6 Sol 中等推理力度的團隊取得了統計顯著的提升;該配置每個應用程式花費 3.07 美元,而單體配置為 1.22 美元。
By BIG CHANGE Editorial
Published: 2026-10-11T20:00:10.163Z
Updated: 2026-10-11T20:00:10.163Z
Canonical: https://bigchange.ai/blog/vals-ai-agent-team-coding-benchmark-cost-score
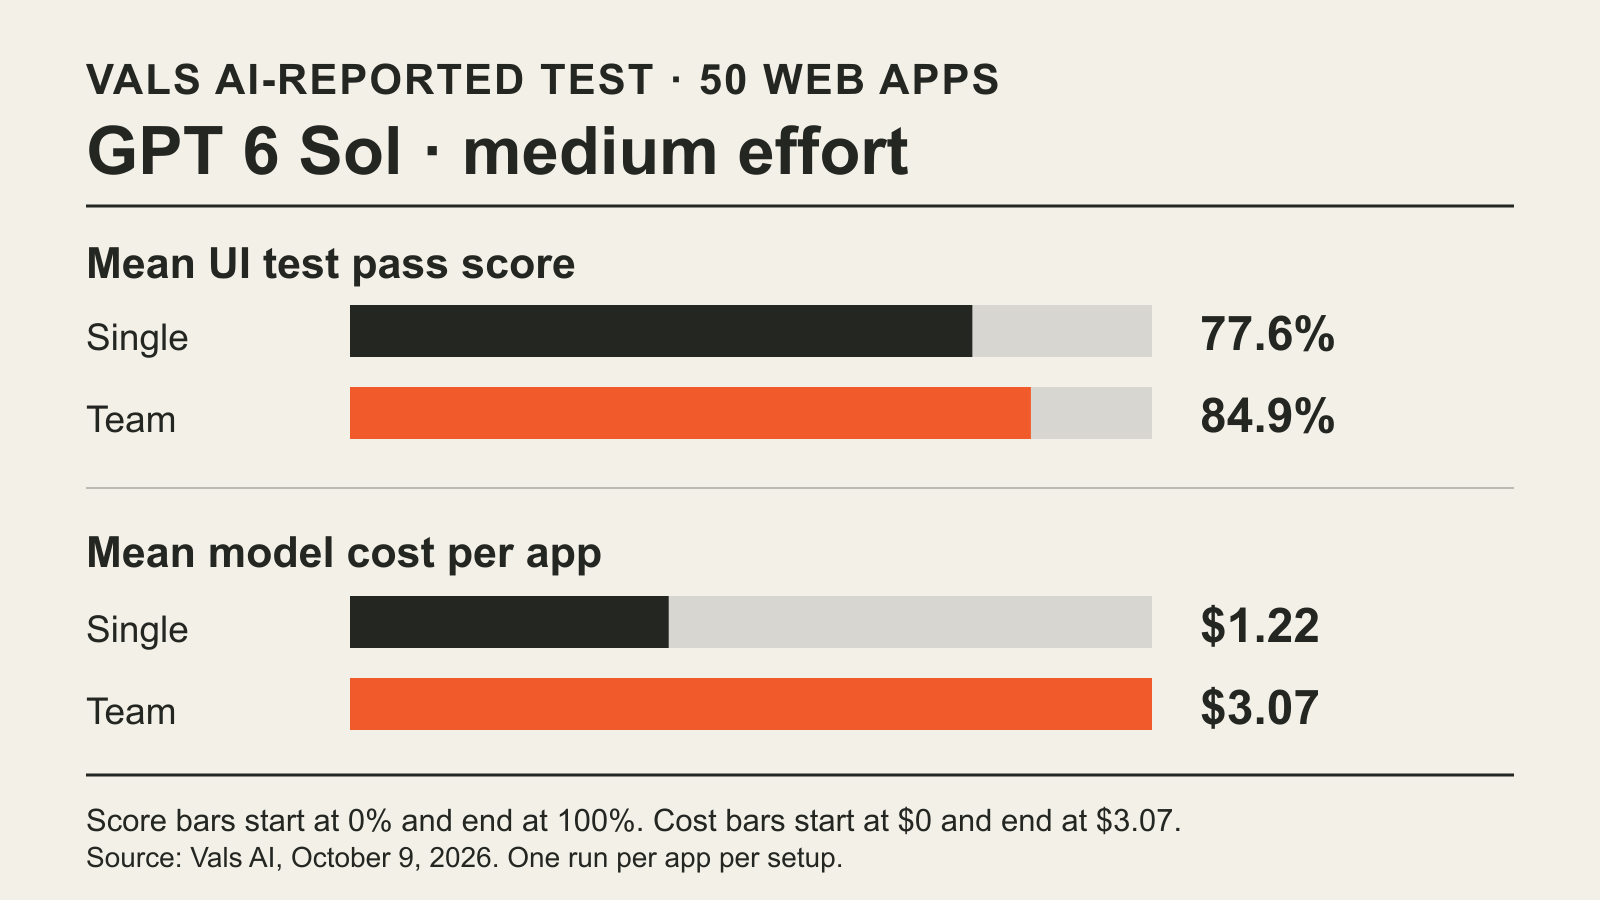
BIG CHANGE graphic; data: Vals AI, October 9, 2026.
在 Vals AI 於 10 月 9 日發布的 [Vibe Code Bench 研究](https://www.vals.ai/blogs/multi-agent-vibe-code-bench)。GPT 6 Sol 中等推理力度團隊通過了基準測試中 84.9% 的應用程式測試,而單個 Sol 智慧代理為 77.6%。這 7.3 個百分點的提升平均每個應用程式花費 3.07 美元,而非 1.22 美元。Vals 報告稱,該提升的 95% 區間為 2.3 至 12.4 個百分點,配對檢驗的 p 值為 0.005。其餘三組團隊與單體智慧代理的比較均未顯示統計顯著的得分差異。
與其籠統地問團隊是否“更好”,這個結果為開發者提供了更具體的預算問題。在這組 Web 應用程式建置任務中,中等力度的 Sol 以每個應用程式約多花 1.85 美元為代價,換來了可測量的品質提升,中位耗時幾乎相同。在更高力度下,以及 Claude Opus 5.5 的兩種力度下,本次測試均未證明團隊額外支出帶來了得分改善。
## 重大變化
- **變化內容:** Vals 在相同的 50 項 Web 應用程式任務和兩種推理力度下,對比了單個程式設計智慧代理與團隊。只有中等力度的 Sol 團隊取得了統計顯著的得分提升。
- **重要原因:** 获勝團隊配置的每應用程式成本是單體配置的 2.5 倍;其他團隊花費高出 1.8 至 5.1 倍,卻沒有顯著得分提升。團隊設計和模型設置應纳入同一項采購決策。
- **後續觀察:**重復運行並在其他軟件任務上測試,或能顯示這項提升能否超出這些特定應用程式而保持穩定。本研究中的每種配置只運行了一次。
## 八次運行測量了什么
Vals 要求 GPT 6 Sol 和 Claude Opus 5.5 根據產品規格構建 50 個完整的 Web 應用程式。應用程式通過 Docker Compose 部署,並由浏覽器智慧代理执行用戶界面測試進行評分。報告的分數是每個應用程式測試通過比例的平均值。 [基準測試方法](https://www.vals.ai/benchmarks/vibe-code)說明每份應用程式規格包含 20 至 60 個自動化測試;單項測試至少有 90% 的步骤成功才算通過。
對於每個模型,Vals 將單個智慧代理與一名負責人進行比較;該負責人在中等和最高推理力度下均可同時委派給最多五個子智慧代理。負責人還被要求拆分、委派、整合並核驗工作。每組模型比較中,任務提示、沙箱和評分器都保持一致。八種配置分別各構建了 50 個應用程式一次。
| 模型與力度 | 單體得分 | 團隊得分 | 每個應用程式平均成本:單體 → 團隊 | 中位運行時間:單體 → 團隊 |
| --- | --- | --- | --- | --- |
| GPT 6 Sol,中等 | 77.6% | 84.9% | 1.22 美元 → 3.07 美元 | 12.4 → 11.9 分钟 |
| GPT 6 Sol,最高 | 89.0% | 90.4% | 4.82 美元 → 8.54 美元 | 38.4 → 27.6 分钟 |
| Claude Opus 5.5,中等 | 91.5% | 91.2% | 4.08 美元 → 9.10 美元 | 20.3 → 26.6 分钟 |
| Claude Opus 5.5,最高 | 89.8% | 93.2% | 23.77 美元 → 122 美元 | 74.7 → 174.1 分钟 |
這些是 Vals 估算的單個應用程式建置的模型平均成本,不是訂阅價格,也不是每項成功 UI 測試的成本。運行時間是實際經過時間的中位數,因此每行的成本與耗時概括了 50 次運行的不同方面。最高力度 Opus 團隊的平均值包含一次超時運行;Vals 根據令牌用量估算其成本約為 189 美元。
## 為何結果取決於具體配置
Vals 使用配對 t 檢驗,將每個團隊與對應的單體智慧代理在相同應用程式上的表現進行比較。最高力度 Sol 團隊提升 1.4 個百分點,95% 區間為 −1.7 至 4.5 個百分點。中等力度 Opus 團隊低 0.3 個百分點,區間為 −3.2 至 2.5;最高力度團隊提升 3.4 個百分點,區間為 −1.4 至 8.3。這些區間包含零提升。它們並不能證明這些配置中的團隊永遠無助於提升,但本次實驗沒有證實提升。
對於 Sol,推理力度也是一項測試變量。將單個 Sol 智慧代理從中等力度提高到最高力度後,得分從 77.6% 升至 89.0%;Vals 報告稱這在統計上顯著。該最高力度單體配置每個應用程式花費 4.82 美元,中位運行時間為 38.4 分钟;中等力度團隊則為 3.07 美元和 11.9 分钟。這兩種配置相差 4.1 個百分點,但統計上並不顯著(p = 0.08)。這些資料讓開發者看到實測的價格與時間權衡,無須假定某種配置在新項目上必然勝出。
各團隊分配時間的方式也不同。Vals 表示,Sol 負責人較早委派任務,並親自測試組裝後的應用程式。其最高力度團隊的中位完成時間為 27.6 分钟,單體智慧代理為 38.4 分钟。Opus 負責人則傾向於先編寫共享約定,再分批委派。最高力度下,團隊中位耗時 174.1 分钟,單體為 74.7 分钟;每個應用程式的成本約為單體的五倍。Vals 將大部分額外費用歸因於子智慧代理各自上下文中緩存的輸入令牌。
## 這一發現能說明到什么程度
顯著性區間反映的是 50 個應用程式之間的差異,而不是同一應用程式重復嘗試之間的波動。另一次運行可能改變比較結果。團隊運行還額外收到委派指令,因此實驗測量的是團隊與指令共同作用的配置。Sol 使用 OpenAI Agents API,Opus 使用 Claude Code;跨模型得分比較也混合了不同的運行框架。Vals 對 Sol 成本的估算假設報告的令牌用量包含子智慧代理;由於缺少請求級用量資料,估算未計入超過長上下文阈值後可能產生的更高價格。
這項研究支持一個範圍有限的決策:用這些配置構建類似的全棧應用程式時,中等力度 Sol 團隊以更高成本帶來了可測量的提升,而其他團隊沒有顯示可靠的得分提升。研究無法確定團隊在其他代碼庫、不同模型,或采用不同任務拆分和核驗流程時是否值得投入。BIG CHANGE 審阅了 Vals 已發表的文章和方法;它沒有運行或復現該基準測試。
## Sources
- [Vals AI,《智慧代理團隊值得投入嗎?Vibe Code Bench 案例研究》](https://www.vals.ai/blogs/multi-agent-vibe-code-bench) — 原始實驗報告。報告中的得分、成本、運行時間、配對檢驗區間和 p 值、團隊行為、實現細節及局限構成本文依據。八種配置分別在 50 個應用程式上各運行一次;報告的不確定性來自應用程式之間的差異,而非重復嘗試。
- [Vals AI,Vibe Code Bench v1.1 方法說明](https://www.vals.ai/benchmarks/vibe-code) — 链接所指基準測試的描述與方法:應用程式規格、每個應用程式 20 至 60 項 UI 測試及評分規則。其综合排行榜采用其他運行框架配置,不能替代智慧代理團隊案例研究的結果。
- [The Decoder,《研究發現:AI 智慧代理團隊浪費大量令牌,品質提升卻幾乎不可測》](https://the-decoder.com/ai-agent-teams-waste-massive-tokens-for-barely-measurable-quality-gains-research-finds/) — 作為發現線索和背景參考的獨立同期報道。本文的數字和方法論說法均根據 Vals 原始報告核對;BIG CHANGE 不采纳其標題中更寬泛的結論。
BIG CHANGE 電子報
掌握全貌,按照自己的步調。
關於人工智慧和機器人技術的近期報導、值得關注的轉變,以及可運用的實用想法。選擇每日快訊、每週摘要或每月觀點。
Next scheduled send (UTC): . Your first edition arrives at the next scheduled send after you confirm.