Anthropic ließ ein KI-Modell auf 15 günstigen Android-TV-Boxen laufen und testete anschließend eine separate Replikationsaufgabe in einem abgeschirmten Netzwerk aus Android-Emulatoren. Das erste Ergebnis zeigt, dass Verbrauchergeräte gemeinsam Inferenzrechenleistung bereitstellen können. Das zweite zeigt, wie sich ein größerer Agent verhielt, wenn der Zugriff auf den nächsten Rechner absichtlich vereinfacht wurde. Keines der Experimente brachte ein selbstverbreitendes KI-System in die reale Welt.
Der Forschungsbeitrag vom 12. Oktober wirft eine praktische Frage für Besitzer und Verteidiger vernetzter Geräte auf: Könnte ein Agent künftig zwischen gewöhnlichen Maschinen wechseln und sein eigenes Modell ohne Rechenzentrum ausführen? Anthropics Experimente machen Teile dieser Kette konkreter, lassen aber eine große Lücke zwischen einer Laboraufgabe und einem echten Angriff.
Die wesentliche Änderung
- Was sich geändert hat: Anthropic demonstrierte verteilte Modellinferenz auf gekauften TV-Boxen und maß die Leistung eines Agenten bei einer abgeschirmten Replikationsaufgabe. Außerdem schätzte das Unternehmen, wann kleine Modelle genug Fähigkeiten gewinnen könnten, um beides zu verbinden.
- Wen es betrifft: Besitzer und Verteidiger vernetzter Geräte, die einem Angreifer nützliche Rechenleistung oder Netzwerkzugriff bieten könnten.
- Was unklar bleibt: Bei der abgeschirmten Aufgabe war der Zugriff auf jedes Ziel vereinfacht, der größere Agent nutzte externe Inferenz und die Forschenden stellten zusätzliche Hilfsmittel bereit. Anthropic demonstrierte keinen vollständigen, außer Kontrolle geratenen Replikator, der sich über echte Geräte verbreitet.
Die gekauften TV-Boxen lieferten Rechenleistung
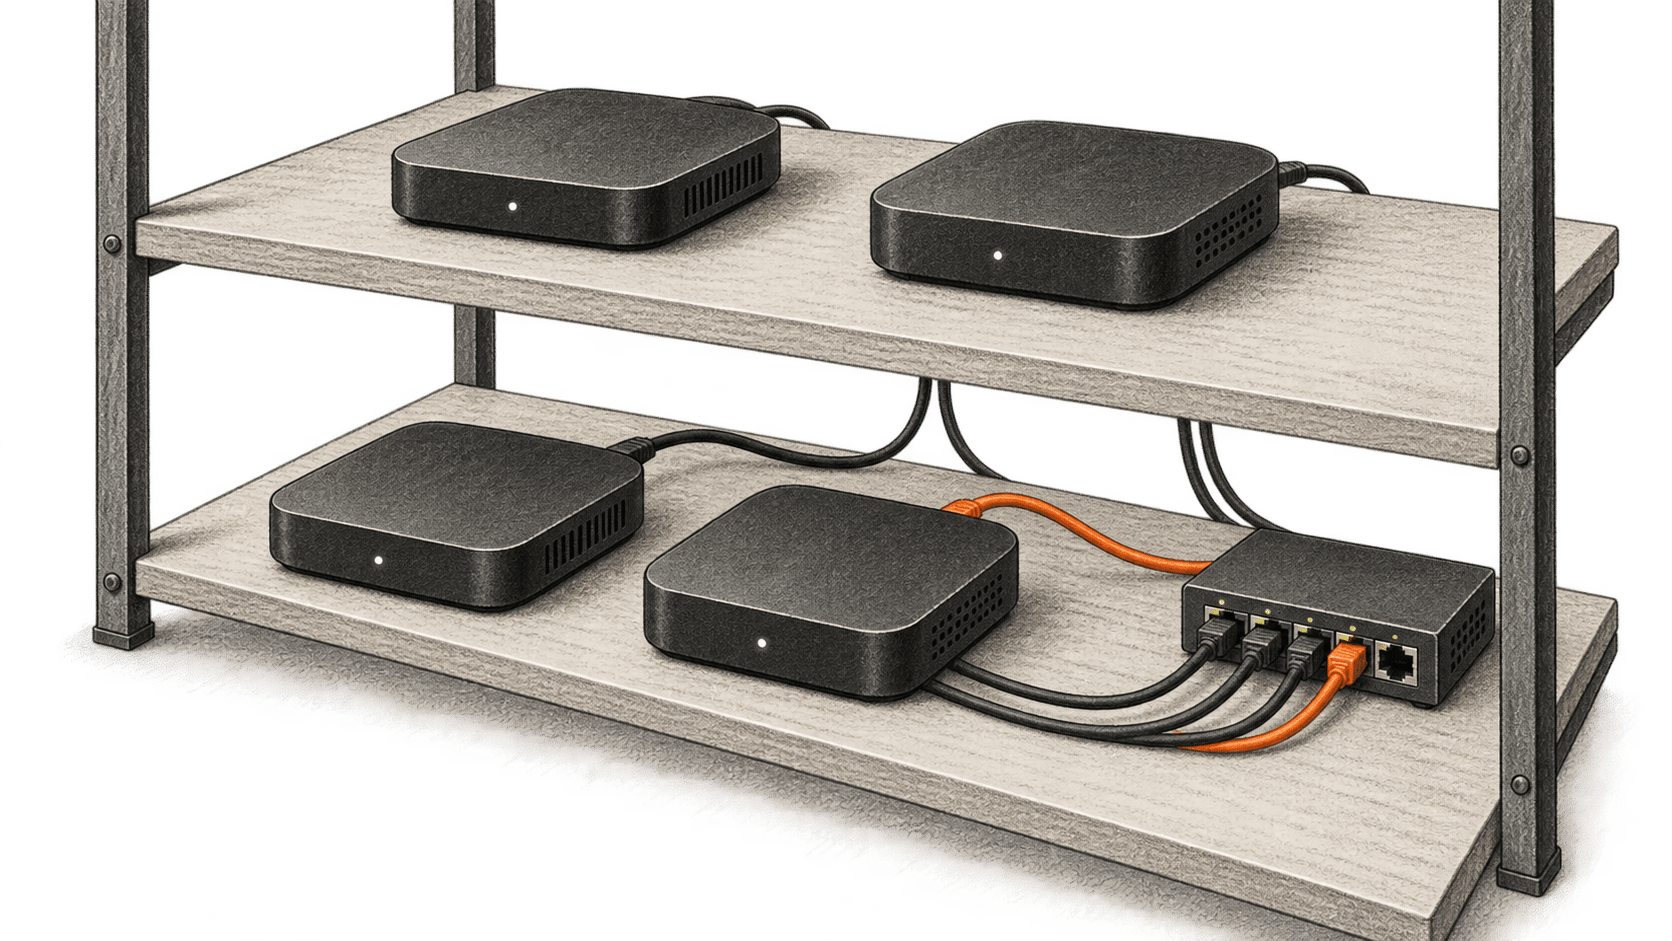
Anthropic kaufte 15 Android-TV-Boxen einer unbekannten Marke und vernetzte sie; jede verfügte über 4 GB Speicher. Gemma4-26B-A4B wurde auf die Geräte verteilt, sodass jede Box einen Teil der Modellschichten enthielt. Das Unternehmen gibt für diese Demonstration 0,39 erzeugte Token pro Sekunde an. Das belegt, dass diese Klasse günstiger Hardware gemeinsam ein Modell dieser Größe mit der gemessenen Geschwindigkeit ausführen kann.
Bei der TV-Box-Demonstration musste das Modell die Boxen weder finden noch kompromittieren. Anthropic prüfte separat, ob Open-Weight-Agenten Inferenz auf unbekannter Hardware einrichten konnten. Der Überblick sagt, ein Modell mit 9 Milliarden Parametern sei auf acht von neun Hardwaretypen erfolgreich gewesen. In der detaillierten Bewertung der Inferenz-Einrichtung sollten Agenten Llama3.1-8B auf verschiedenen Rechnern bereitstellen. Das Unternehmen nutzte ein Forschungsgerüst namens Memento, das einem frischen Agenten regelmäßig den Arbeitsbereich und kurze Notizen des vorherigen Versuchs übergab. Die Forschenden lieferten auch Hardwareinformationen und ein Zeitlimit. Diese Unterstützung ist wichtig, wenn man das Ergebnis als Agentenfähigkeit und nicht als unbeaufsichtigte Bereitstellung interpretiert.
Das Replikationsergebnis stammt aus einem vereinfachten Emulator
Das zweite Experiment von Anthropic nutzte ein durch eine Firewall abgeschirmtes Cloud-Netzwerk aus acht Knoten mit Android-Emulatoren. Die Aufgabe bestand darin, von einem vorbereiteten Knoten durch das Netz zu gehen und auf jedem erreichten Knoten einen Inferenzserver einzurichten. Der Zugriff auf den nächsten Knoten war absichtlich nicht authentifiziert; getestet wurden daher Ablaufplanung und Inferenz-Einrichtung statt der Überwindung realistischer Geräteabwehr.
Das Modell des größeren Agenten lief auf einem separaten Server, weil die Emulator-Knoten es nicht hosten konnten. Jedes Ziel sollte stattdessen Llama3.1-8B bereitstellen, eine übliche Last zum Vergleich unterschiedlich großer Agenten. Sobald dieser Server die Prüfungen bestand, startete das Versuchssystem die nächste Agentenkopie. Das Design prüft, ob ein leistungsfähiger Agent die Kette unter kontrollierten Bedingungen organisieren kann; es zeigt nicht, dass dasselbe Modell sich auf jedes Gerät brachte und dort ausführte.
Anthropic berichtet, dass GLM-5.2 in vier von fünf Durchläufen alle acht Knoten und im fünften sieben erreichte. Andere getestete Open-Weight-Modelle schlossen die gesamte Aufgabe nicht zuverlässig ab. Die Autoren bezeichnen dies als obere Grenze für den Erfolg in der realen Welt, weil der Zugriffsschritt trivialisiert war. Diese Einschränkung ist zentral: Ein echtes Geräteflotte hätte andere Software, Berechtigungen, Netzwerkwege und Abwehrmaßnahmen. Für dieses Szenario liefert das Experiment keine gemessene Erfolgsrate.
Der Ankunftszeitpunkt ist eine Prognose
Anthropic verglich eine durch das Emulator-Ergebnis nahegelegte Fähigkeitsschwelle mit den Fortschritten von Open-Weight-Modellen mit höchstens 30 Milliarden Parametern im allgemeinen Fähigkeitsindex von Epoch AI. Eine Extrapolation dieses Trends setzte ein kleines Modell bis Ende 2026 an die Schwelle. Der Index misst allgemeine Fähigkeiten und ist nur ein Näherungswert für die vollständige Replikationsaufgabe. Die Schwelle selbst stammt aus einem abgeschirmten Experiment mit einem größeren Agenten und einem einfacheren Zugangsweg. Die Prognose ist daher eine Schätzung der Forschenden und kein beobachtetes Datum, an dem ein IoT-Replikator existieren wird.
Die Geschwindigkeit setzt eine weitere Grenze. Anthropic schätzt, dass ein Versuch mit einem 9B-Modell bei den gemessenen Gerätegeschwindigkeiten und der Arbeitslast zur Inferenz-Einrichtung etwa 28 bis 51 Stunden dauern könnte; die nicht optimierte Gemma-Konfiguration könnte ungefähr 71 bis 150 Stunden benötigen. Das sind Berechnungen für diese Arbeitslast, keine beobachteten Infektionszeiten. Sie deuten darauf hin, dass ein gerätebasierter Agent ausdauernd und langsam sein könnte, was verändert, worauf Verteidiger achten müssten.
Was Geräteverteidiger aus der Arbeit mitnehmen können
Anthropic nennt ungewöhnlich große Modellübertragungen und anhaltenden Datenverkehr zwischen Geräten als mögliche Hinweise auf ein gewichtsbasiertes System, das über eine Flotte hinweg läuft. Diese Muster sind vorgeschlagene Ansätze zur Erkennung; die Forschenden testeten kein Live-Erkennungssystem gegen einen eingesetzten KI-Wurm. Sie verweisen außerdem auf sicherere Gerätestandards und eine koordinierte Reaktion von Netzbetreibern, um Gelegenheiten zur Ausbreitung zu verringern.
Für private Haushalte und kleine Unternehmen sprechen die Belege für bekannte Gerätesicherheitsmaßnahmen mit einem konkreteren Grund: wissen, welche vernetzten Geräte genutzt werden, ihre Software und Zugriffseinstellungen aktuell halten, soweit der Anbieter es ermöglicht, und unerwarteten Datenverkehr zwischen Geräten untersuchen. Sicherheitsteams können die Studie zum Anlass nehmen, zu prüfen, wie sie langsame, anhaltende Berechnungen und große Übertragungen zwischen verwalteten Geräten erkennen würden. Keine dieser Prüfungen belegt, dass derzeit ein KI-Wurm vorhanden ist. Anthropic sagt ausdrücklich, keinen vollständigen außer Kontrolle geratenen Replikator gezeigt zu haben.
Quellen und weiterführende Lektüre
- Anthropic, „AI models may be capable of self-replicating without access to a datacenter“, 12. Oktober 2026: Hauptquelle zur Demonstration mit gekauften Geräten, zur Bewertung der Inferenz-Einrichtung, zu den abgeschirmten Emulator-Tests, Methoden, Prognose und vorgeschlagenen Abwehrmaßnahmen. Ergebnisse und Schätzungen in diesem Artikel werden den Forschenden zugeschrieben; BIG CHANGE hat die Experimente nicht wiederholt.
- Epoch AI, Epoch Capabilities Index: Beschreibung des allgemeinen Fähigkeitsindex, den Anthropic in seiner Projektion als Näherungswert nutzte. Der Index misst IoT-Replikation nicht direkt.