샤오미 연구진은 두 채널 소리를 입력받아 소리에 무엇이 들어 있는지와 어디서 오는지를 묻는 질문에 답하는 오디오·언어 모델 MiDashengLM-Spatial을 공개했습니다. 10월 8일 논문은 두 공간 오디오 벤치마크 하위집합에서 시험한 모노 오디오 모델보다 훨씬 높은 점수를 보고합니다. 공개 코드와 체크포인트로 방법을 살펴볼 수 있지만, BIG CHANGE는 모델을 실행하거나 평가를 재현하지 않았습니다.
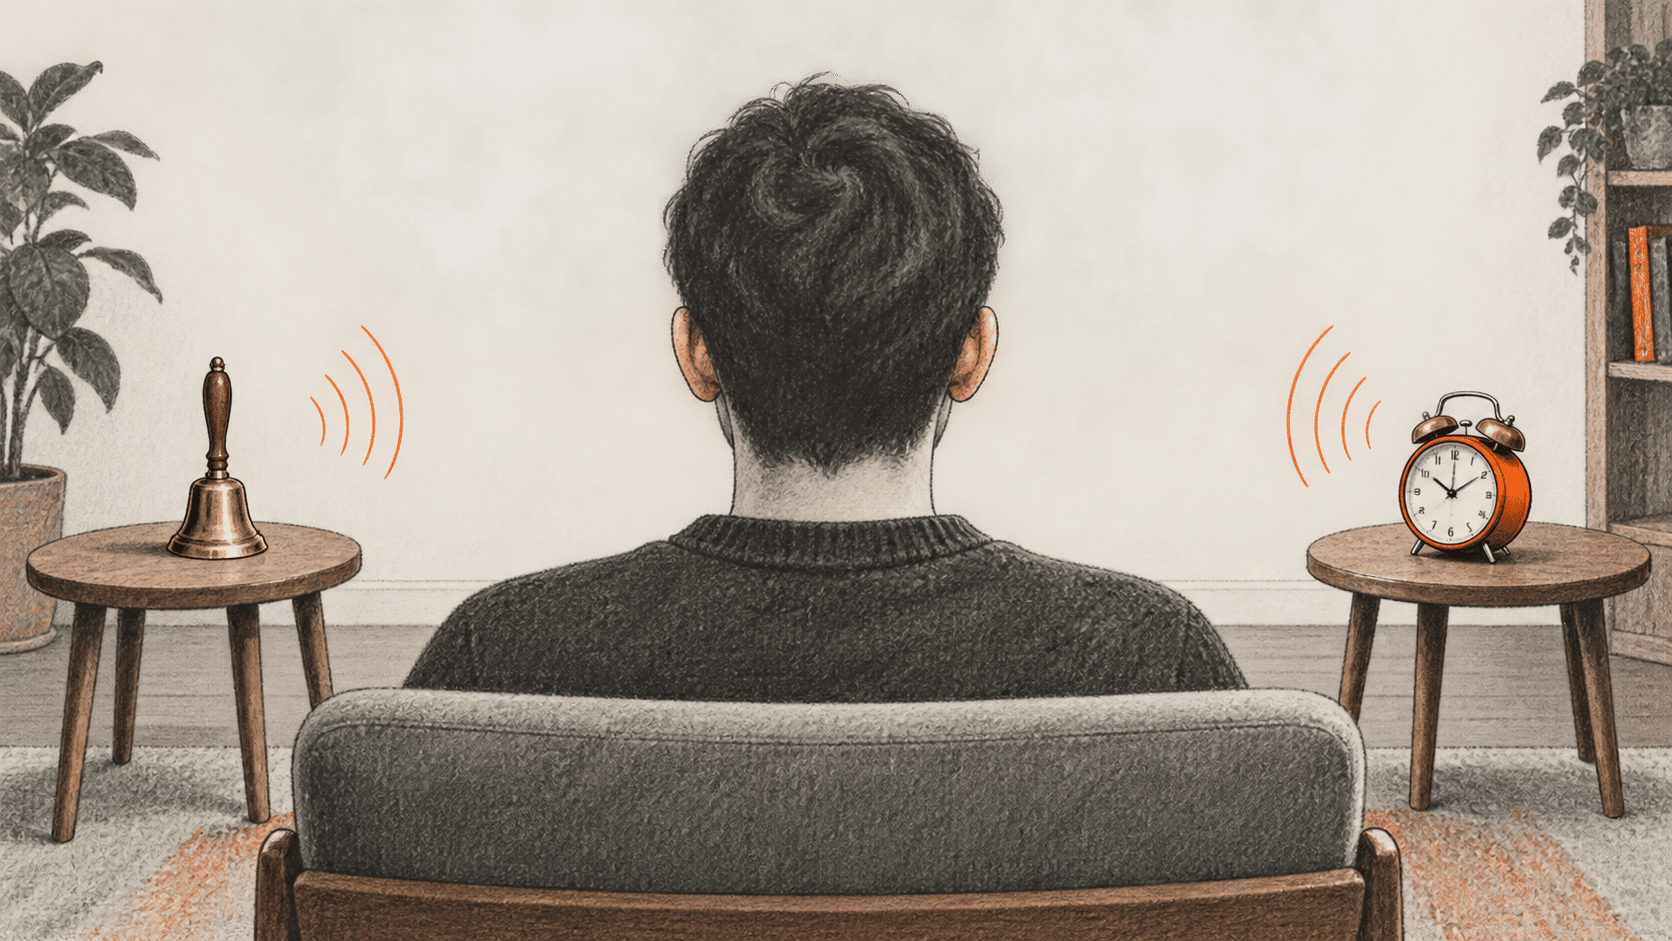
녹음에 소리 발생원이 둘 이상 있을 때 이 구분이 중요합니다. 일반적인 오디오 질문은 무엇이 들리는지 물을 수 있습니다. 공간 질문은 발생원이 청취자의 왼쪽인지 오른쪽인지, 움직이는지, 답이 어느 소리를 가리키는지도 묻습니다. 두 채널을 하나로 섞으면 방향 정보를 담을 수 있는 채널 간 차이가 사라집니다.
큰 변화
- 달라진 점: 연구진은 MiDashengLM에 공간 오디오 분기를 추가하고 논문, 코드, 모델 체크포인트를 공개했습니다. 모델은 공간 질문에 양이 오디오를 사용하고 일반 오디오 이해 경로도 유지합니다.
- 중요한 이유: 소리 위치에 관한 텍스트 답변에는 사건 인식과 위치 단서가 모두 필요합니다. 두 분기 설계는 의미 분기의 순방향 경로 구조를 그대로 둔 채 공간 분기가 중간 의미 특징을 활용할 수 있게 합니다.
- 지켜볼 점: 저자들의 채널 교환 벤치마크는 왼쪽·오른쪽 답이 오디오 채널을 따라 바뀌는지 시험합니다. 보고된 결과를 응용에서 신뢰할 만한 것으로 보기 전에 다양한 녹음 설정과 여러 소리가 밀집한 장면을 포함한 추가 독립 시험이 필요합니다.
두 분기가 작업을 나누는 방법
이 arXiv v1 논문은 MiDashengLM에서 물려받은 32층 의미 인코더와 다채널 오디오용 12층 Spatial-Dasheng 인코더를 설명합니다. 의미 경로는 녹음에 무엇이 있는지 추출합니다. Spatial-Dasheng은 발생원이 겹치는 경우까지 포함해, 활성 소리 사건을 프레임별로 감지하고 방향과 거리를 추정하도록 훈련됩니다. 중간 의미 표현은 어댑터를 통해 네 깊이에서 공간 분기로 들어갑니다. 최종 출력은 오디오 토큰으로 융합되어 언어 모델이 텍스트를 생성하는 데 사용됩니다.
이 구성은 특정한 연관 문제를 다룹니다. 두 발생원이 겹치면 위치 추정만으로 어느 소리가 그곳에 있는지 알 수 없습니다. 공간 특징을 의미 특징에 조건화하는 방식으로 저자들은 새 공간 표현을 원래 의미 경로에 다시 넣지 않고 단서를 결합합니다. 논문은 훈련에 약 100만 개의 합성 양이 장면, 약 1만3천 시간의 오디오, 600만 개의 질문·답변 쌍을 사용한 뒤 모노 및 양이 데이터를 혼합한다고 보고합니다. 이는 저자들이 제시한 데이터셋 규모이며 독립적으로 감사한 수치는 아닙니다.
이 고정 커밋 저장소의 README는 텍스트 지시 전에 오디오를 배치하는 Transformers 예제를 설명하며, 실제 양이 오디오를 (2, T) 배열로 받습니다. 모노 입력도 실행되지만 방향은 담고 있지 않다고 설명합니다. 이 진술은 특정 마이크, 기기, 음향 환경과의 호환성을 입증하지 않습니다. 코드 경로는 from_pretrained를 trust_remote_code=True 설정으로 호출하므로 사용자는 실행 전에 저장소와 체크포인트 코드를 확인해야 합니다. 체크포인트 파일 트리는 약 33.5 GB의 파일과 Apache-2.0 라이선스를 표시합니다. 파일 크기만으로 작업 메모리나 추론 비용을 알 수는 없습니다.
저자들이 측정한 내용
STAR-Bench의 Spatial Reasoning 하위집합에서 논문은 MiDashengLM-Spatial의 공간 정확도를 70.3%, 모노 MiDashengLM 기준 모델은 44.3%로 보고합니다. MMAU-Pro 공간 하위집합에서는 55.4% 대 18.2%를 보고합니다. 이 수치는 저자들이 벤치마크 녹음을 평가한 결과이며 BIG CHANGE의 시험이나 실제 배포 측정이 아닙니다.
논문은 답변이 두 채널에 의존하는지도 확인합니다. 오디오 채널을 바꾸면 올바른 왼쪽·오른쪽 답이 뒤집히는 질문에서, 완전 정답률은 원래 답과 채널 교환 후 답이 모두 맞아야 합니다. 저자들은 STAR-Bench에서 자신들의 모델은 72.6%, 모노 MiDashengLM 기준 모델은 0%라고 보고합니다. 이 짝지은 검사는 단일 정확도 점수보다 방향 판단이 오디오에 근거하는지를 더 잘 보여 주지만, 여전히 논문 조건 아래의 벤치마크 결과입니다.
논문은 주의할 이유도 제시합니다. 자체 합성 장면 시험에서 이동 궤적의 완전 일치율은 여전히 20% 미만이며, 여러 발생원이 겹치는 복잡한 장면에서는 성능이 더 낮습니다. 스테레오 STARSS23 위치 추정 평가에서는 스테레오 녹음이 위·아래와 앞·뒤 모호성을 풀 단서를 제한적으로만 제공하므로 과제를 왼쪽·오른쪽 방위각으로 제한합니다. 일반 오디오 결과는 일률적으로 좋아지지 않고 과제마다 다릅니다. 연구용 체크포인트를 고려하는 사람에게 이 한계는 중요합니다. 공간 벤치마크 향상은 여러 녹음 환경에서 견고한 위치 추정을 하거나 안전한 내비게이션 기반이 된다는 증거가 아닙니다.
출처 및 추가 읽을거리
- Hu와 동료들, 「MiDashengLM-Spatial: 일반 오디오 이해와 공간 인식의 통합」, arXiv v1(2026년 10월 8일). 모델 구성, 훈련 데이터, 저자 보고 평가와 한계에 관한 원 사전논문입니다. 여기서는 독립 재현을 주장하지 않습니다.
- Xiaomi Research, MiDashengLM-Spatial 저장소, 고정 커밋
f314b3455e7fd94c60ad078655a39d69bcd05232(2026년 10월 16일 확인). README, 예제, 평가 코드는 입력, 설정, 보고 표를 설명합니다. BIG CHANGE는 이를 실행하지 않았습니다. - Xiaomi Speech Team, MiDashengLM-Spatial 체크포인트 트리, 고정 리비전
160ae51b51becade390ace4294feaa5b078d5665(2026년 10월 16일 확인). 공개 파일, 크기, 라이선스 목록입니다. 실행 시 측정값을 추론하지 않습니다.