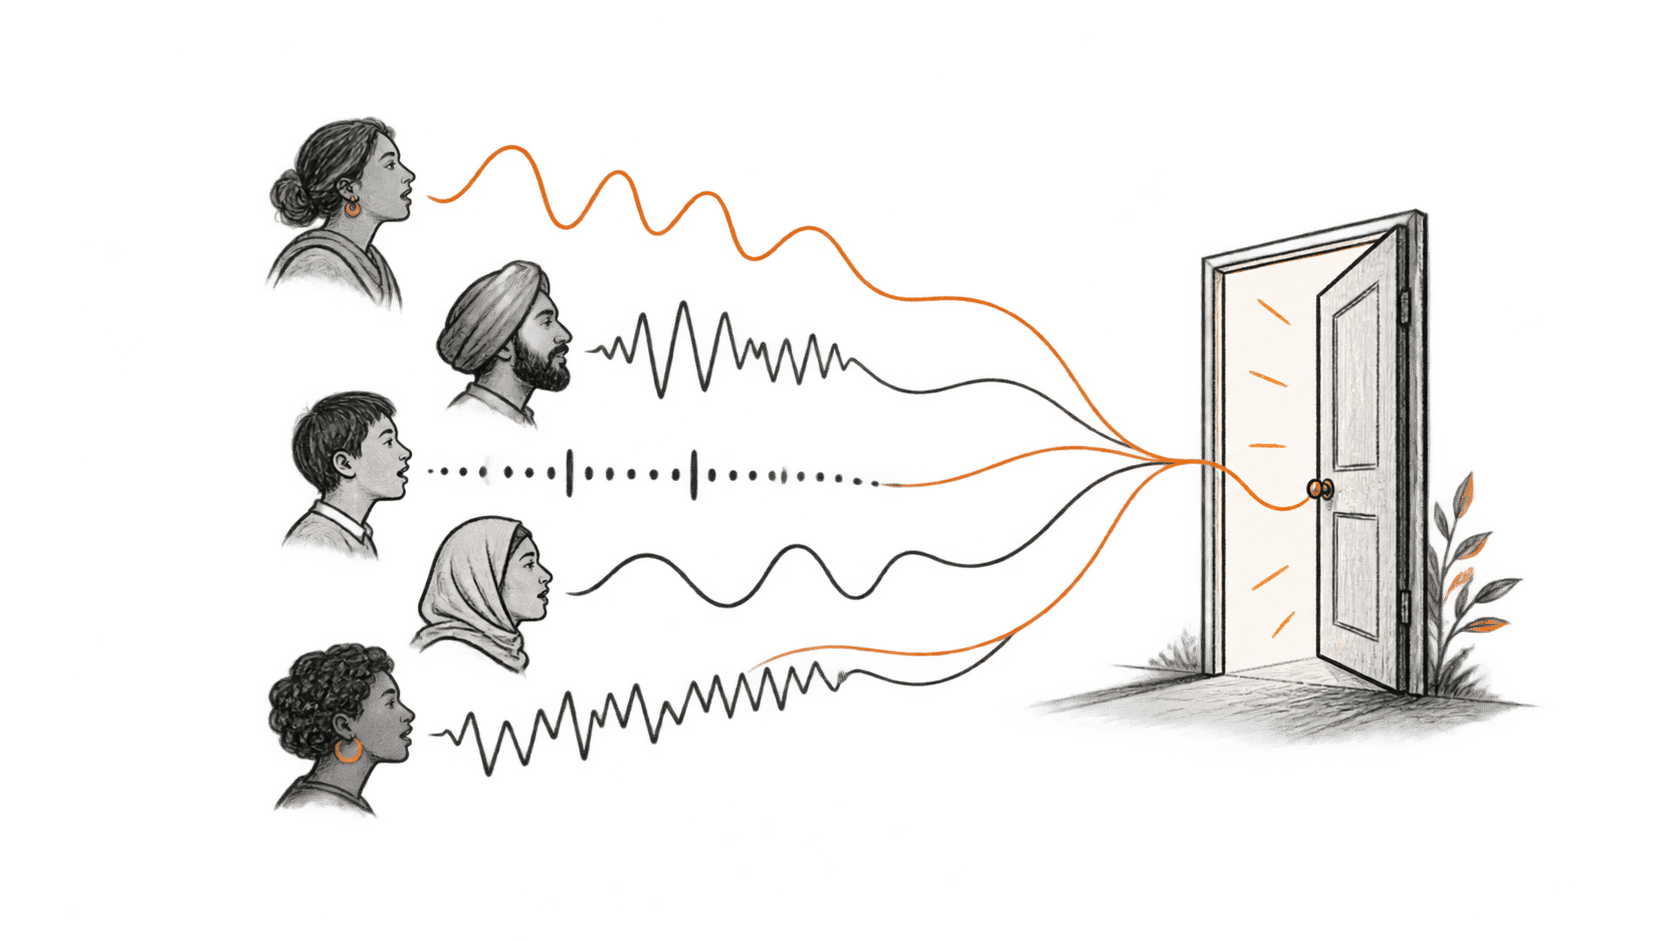
Una coalición de 60 organizaciones anunció el 21 de septiembre que quiere que las personas que hablan lenguas poco atendidas por los sistemas de IA actuales puedan utilizar esas herramientas en su propia lengua y con su propia voz. La Fundación Gates estima esa población en 3400 millones de personas y establece un horizonte de cinco años para la iniciativa. Google, Anthropic y la Fundación OpenAI figuran entre los firmantes, junto con organizaciones locales de investigación y organizaciones comunitarias. Anuncio de la coalición.
El cambio inmediato es un acuerdo para coordinar el trabajo de acceso lingüístico. La cifra describe la ambición, no el número de personas ya atendidas. Esa distinción será importante cuando lleguen los primeros informes de progreso: una interfaz traducida y un servicio que entiende la pregunta real de una persona son logros distintos.
Lo que tendrá que construir la coalición
Los firmantes proponen datos lingüísticos compartidos, evaluaciones del progreso y modelos y aplicaciones que otros desarrolladores puedan utilizar. La privacidad, el consentimiento y el control comunitario sobre los datos forman parte del enfoque declarado. El anuncio deja para el próximo año el desarrollo detallado de la gobernanza y las líneas de trabajo de la coalición. Los compromisos declarados.
La cobertura periodística independiente aporta un reconocimiento inusualmente directo sobre el punto de partida. Elizabeth Kelly, de Anthropic, declaró a Associated Press que los productos de la empresa funcionan mal en muchas lenguas africanas. AP también informa de que una secretaría hará un seguimiento de los compromisos de los participantes. Son aspectos que conviene observar a medida que la coalición pasa de las firmas a los resultados. La cobertura de AP.
Consideramos que la prueba práctica debería ser una tarea completada. ¿Puede alguien hacer una pregunta con su forma habitual de hablar, entender la respuesta y corregir un malentendido? Una puntuación impresionante en traducción escrita dejaría parte de esa prueba sin resolver. Un informe público útil distinguiría el reconocimiento del habla de la precisión y la utilidad de la respuesta final.
El trabajo que ya se realiza fuera de los laboratorios de modelos
Project Vaani muestra lo que implica recopilar datos pertinentes. Dirigido por el Instituto Indio de Ciencias y ARTPARK, con financiación de Google, busca recopilar más de 150 000 horas de habla en los distritos de la India. Su panel público muestra actualmente unas 31 278 horas y 105 lenguas. No deben confundirse el total previsto y el total registrado. Project Vaani.
El proyecto afirma que su recopilación pretende reflejar diferencias como la edad, el género, la educación y la ubicación urbana o rural. Eso plantea a los desarrolladores una pregunta más exigente que si su producto incluye una lengua en un menú: ¿el habla de quiénes dentro de esa lengua ha aprendido a reconocer?
La propiedad de las grabaciones es otra parte del problema. En una actualización de mayo, Mozilla describió una función de solicitud de acceso para Mozilla Data Collective que permite a quienes suben datos aprobar quién recibe sus conjuntos de datos. Su plataforma también permite a los proveedores especificar cómo puede utilizarse su material. Mozilla Data Collective figura entre los firmantes de la coalición. Actualización de la plataforma de Mozilla, condiciones de acceso a los conjuntos de datos.
Para una comunidad que aporta grabaciones, el acceso es una decisión concreta. Un proyecto puede preguntar quién las recibirá, si se permite el uso comercial y cómo se gestionará una reclamación. Esas cuestiones deberían resolverse antes de comenzar la recopilación. Llamar abierto a un conjunto de datos no sustituye la explicación de su licencia a las personas cuyas voces contiene.
Qué cambia para los servicios públicos y las empresas
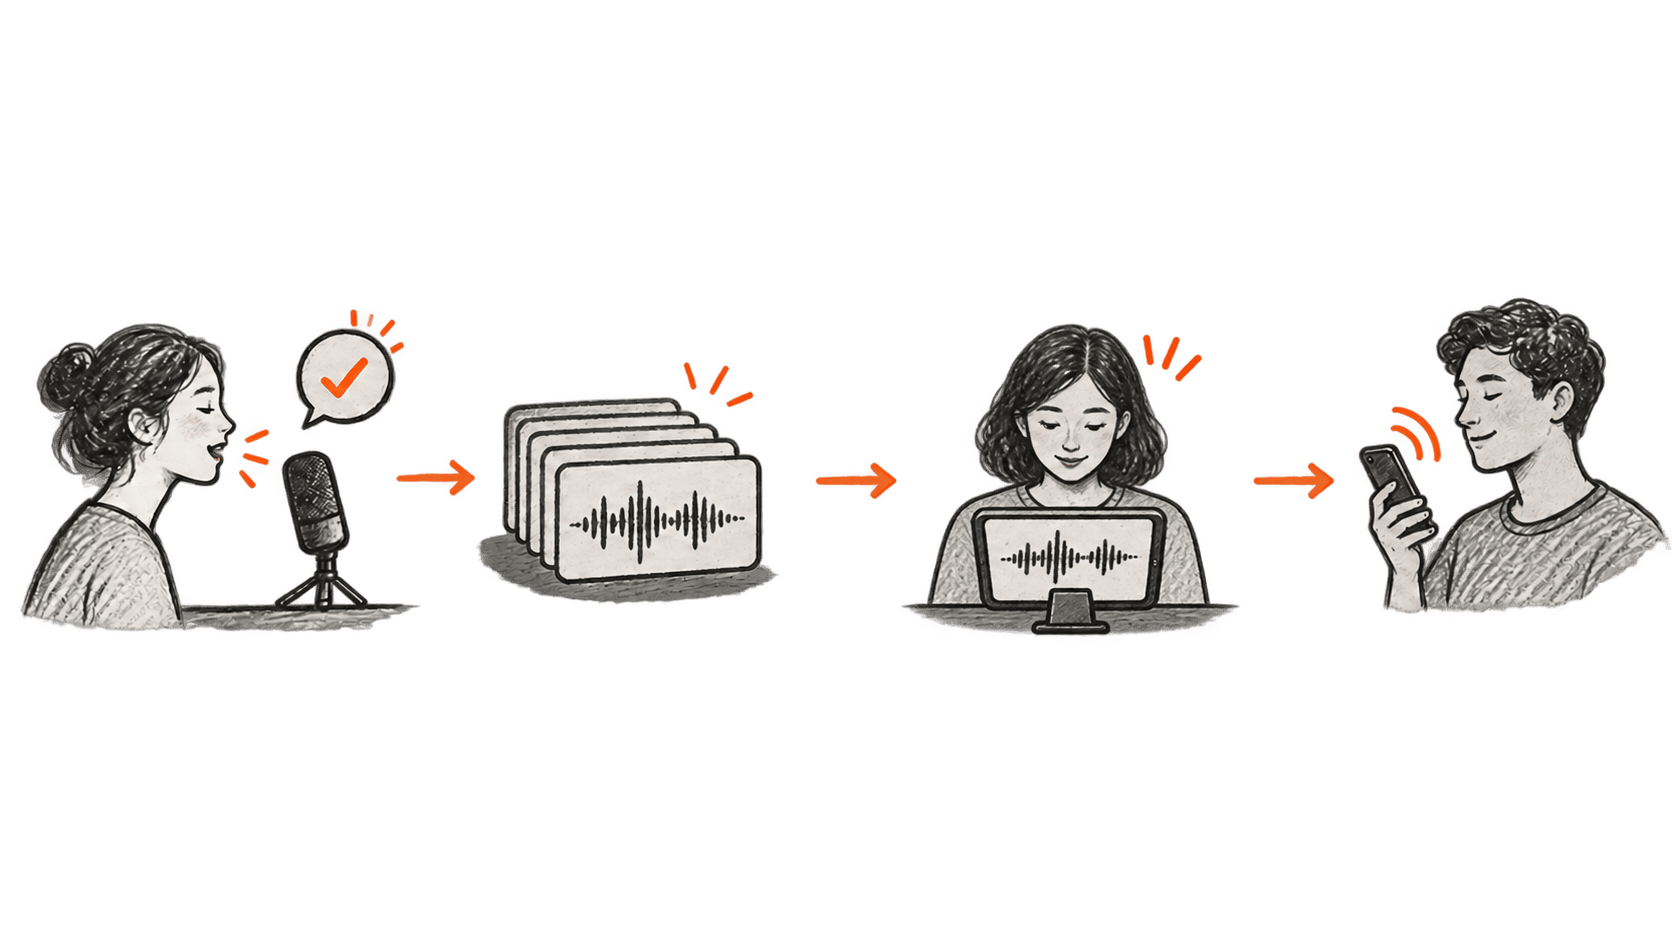
Para las organizaciones que evalúan servicios de IA, esto ofrece un motivo para realizar pruebas locales antes de ampliar su alcance. Nuestra recomendación es empezar con una tarea rutinaria y acotada, y reclutar a personas del público destinatario que hablen la lengua con fluidez para evaluar las respuestas. Registren los fallos con el mismo cuidado que los aciertos. Incluyan términos locales y formas habituales de alternar entre lenguas, en lugar de probar únicamente frases pulidas escritas para una demostración.
Un servicio también necesita una vía clara para salir de una conversación automatizada que no da resultado. Una persona que no pueda obtener una respuesta precisa debería poder contactar con un ser humano o utilizar otro canal. Los avances que logre la coalición deberían evaluarse junto con esas alternativas, especialmente cuando un malentendido afecte al acceso a un servicio esencial.
Esta iniciativa llega después de que la Fundación Gates anunciara el 14 de septiembre sus planes de destinar al menos 1000 millones de dólares durante dos años al acceso equitativo a la IA. Se trata de un compromiso de financiación más amplio; el anuncio sobre las lenguas no dice que la totalidad de ese importe corresponda a esta coalición. El anuncio independiente de financiación.
Las próximas pruebas que habrá que buscar son concretas: lenguas identificadas, evaluaciones publicadas con participantes locales, conjuntos de datos utilizables y servicios en funcionamiento. Eso mostraría si el acuerdo está haciendo que la IA sea útil para personas que hasta ahora han tenido pocos motivos para recurrir a ella.


