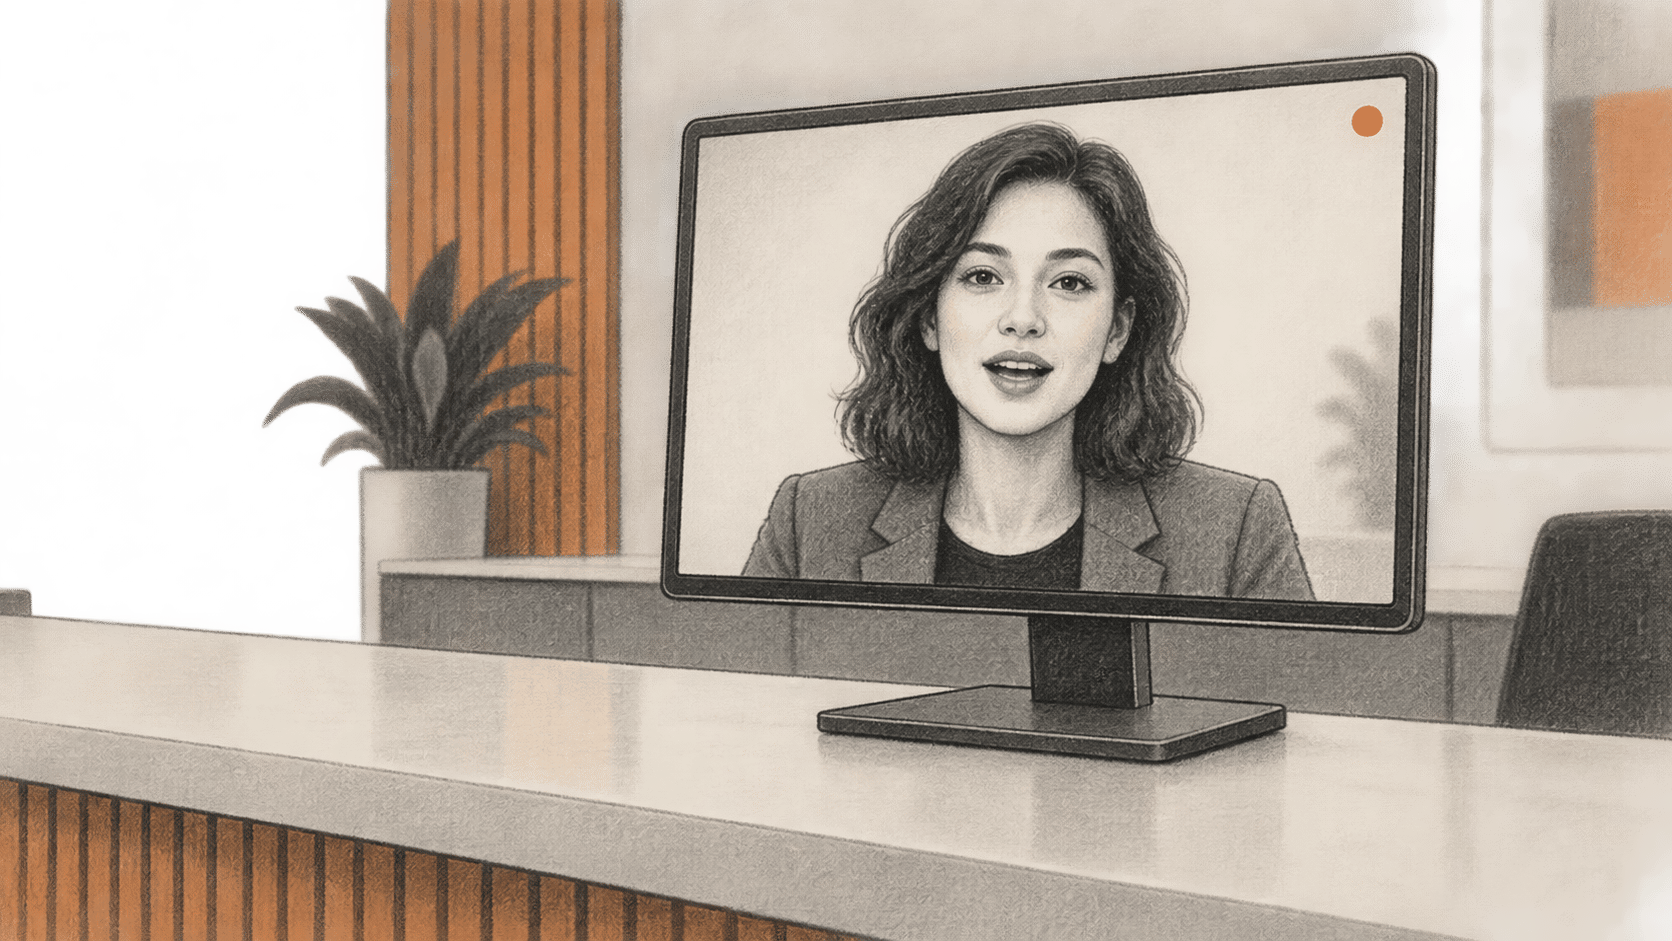
Google 于 9 月 24 日随 Gemini 3.8 Live 向企业用户普遍开放 Live Avatar 功能。它为 Google 的实时语音模型加入了会说话的动画人脸;该模型还可以接收摄像头或屏幕画面,并在对话中调用外部工具。对开发面向客户的代理的团队来说,实际变化是视频输出已集成其中,并提供了有文档说明的 API 接入方式。公告并未证明虚拟形象能改善服务结果,也未证明它在所有场景中都能可靠工作。
重大变化
- 发生了什么变化:Google 的开发者指南为其早期 Live 模型已有的语音输出增加了同步虚拟形象视频。开发者现在可以通过一个流式 API 同时生成会说话的人脸和语音。
- 为何重要:构建客户服务代理的团队无需另行搭建虚拟形象渲染流程,即可加入这种视觉呈现。但应用仍须执行工具调用并处理故障;动画本身不能证明交易已成功。
- 接下来关注什么:眼下的设计选择是在预设形象和自定义肖像之间取舍。Google 的配置指南将自定义虚拟形象限制为部分获选客户,并要求取得处理人脸或语音样本所需的权利和同意。因此,采用品牌形象仍需另行申请访问权限并处理同意事宜。
虚拟形象已经开放,自定义肖像仍须单独获准
Google 在发布文章中展示了虚拟形象如何回应实时音频和画面输入、切换语言,以及在调用工具的同时继续进行酒店入住对话。这些是公司的演示,展示了预期交互方式,但没有提供经过测量的错误率、无障碍效果,也不能证明客户服务有所改善。
Google 的云服务公告称该功能已在 Gemini Enterprise 和 API 中普遍开放,并提供美国和欧盟端点。开发者可以选择预设虚拟形象。根据个人参考图创建虚拟形象仍只对获选企业客户开放,这些客户须通过 Google Cloud 申请访问权限。配置指南还说明,客户有责任取得处理人脸或语音样本所需的权利和同意。
模型页面列出模型 IDgemini-3.8-live,并列出可用范围:us和eu多区域,以及us-central1。该页面还列出标准按量付费和预配吞吐量两种受支持的计费方式。团队在将普遍开放理解为所有人都能访问之前,应核实自身部署所用的端点和商业条款。
对话效果仍取决于应用本身
Google 将 Gemini 3.8 Live 描述为语音到语音系统,可以接收实时摄像头画面或屏幕共享,并返回语音和视频。其开发者指南区分了代理继续说话时并行运行的工具调用,以及等待响应的阻塞式调用。应用仍须连接并授权自己的工具、处理工具结果,并决定代理可以采取哪些行动。在查询期间一直显示在屏幕上的人脸,并不能证明查询已经成功。
指南称,工具响应应报告状态,并说明是否适合重试;响应必须与原始调用 ID 匹配;开发者还应限制重复工具调用的次数。这些要求会影响代理如何处理空账户查询或中断。Google 还表示,Gemini 3.8 Live 可以切换使用 97 种语言。公告声称虚拟形象的口型能在这些语言间保持同步,但本文未对此进行独立测量。
Google 表示,生成的音频和视频带有 SynthID 水印,并限制创建自定义肖像。这些是公司所述的防护措施,并不能证明每位观看者都会意识到虚拟形象是合成的,也不能证明滥用会被杜绝。评估部署时,还需核查是否取得同意、是否进行充分说明、实时摄像头和语音数据如何处理、工具调用失败及中断时的表现,以及面向实际用户的观测结果。Google 已发布的公告和文档没有提供这些结果。
来源与延伸阅读
- Google 关于 Live Avatar 的公告(2026 年 9 月 24 日)介绍并展示了公司预期的交互方式、多语言虚拟形象及 SynthID 相关说法。公告中的演示不是独立性能测试。
- Google Cloud 关于 Gemini 3.8 Live with Live Avatar 普遍开放的公告(2026 年 9 月 24 日)说明企业版可用情况、美国和欧盟端点、预设与受限自定义虚拟形象,以及应用示例。公告中的客户评价属于推广性陈述,本文未将其作为结果测量依据。
- Gemini 3.8 Live 开发者指南(2026 年 9 月 24 日更新)记录了模型比较、流式格式和工具调用行为。它描述的是 API 设计行为,并非特定部署中的实测性能。
- Gemini 3.8 Live 模型页面(2026 年 9 月 24 日更新)列出模型 ID、正式开放日期、区域和计费方式。具体项目和端点的可用性应另行核实。
- 配置实时虚拟形象(2026 年 9 月 25 日查阅)介绍预设虚拟形象的 API 设置,以及自定义肖像的访问权限和同意要求。