英伟达发布了Nemotron 3 Diarization模型,时间为 9 月 23 日。这款开放权重模型约有 1 亿个参数,可标记录制或流式音频中最多八名说话者各自发言的时间。它会为对话中的说话者活动和时间戳提供标记;若要生成带文字内容的转录,还需要语音识别。
主要变化
- 发生了什么变化:英伟达此前的流式 Sortformer 检查点支持四名说话者。此次发布的单一检查点提供八个按说话者首次出现顺序排列的说话人通道,同时适用于录制音频和传入的音频块。
- 为何重要:开发会议或通话转录工具的人,可以用该模型为时间段分配通用说话人标签,包括多人重叠发言的时间段,再将这些时间段与另一个识别器输出的文字结合。此次发布扩大了该任务公开标注的说话人数上限。
- 接下来关注什么:实际使用时,需要决定在每次流式处理结果生成前缓冲多少音频。英伟达建议的最短设置要先等待 0.32 秒音频才开始计算,而其准确率表显示,采用这一设置会带来代价。团队仍需在自己的录音上测量完整处理流程。
模型会返回什么
该模型卡规定输入为 16 kHz 单声道音频。它列出了 WAV、FLAC、Opus 和 MP3 文件格式;NeMo 接口接受文件路径、音频数组或逐行 JSON 清单。传入音频数组时,必须向diarize()调用时传入正确的采样率。模型卡没有为分块推理设定固定的最长录音时长。
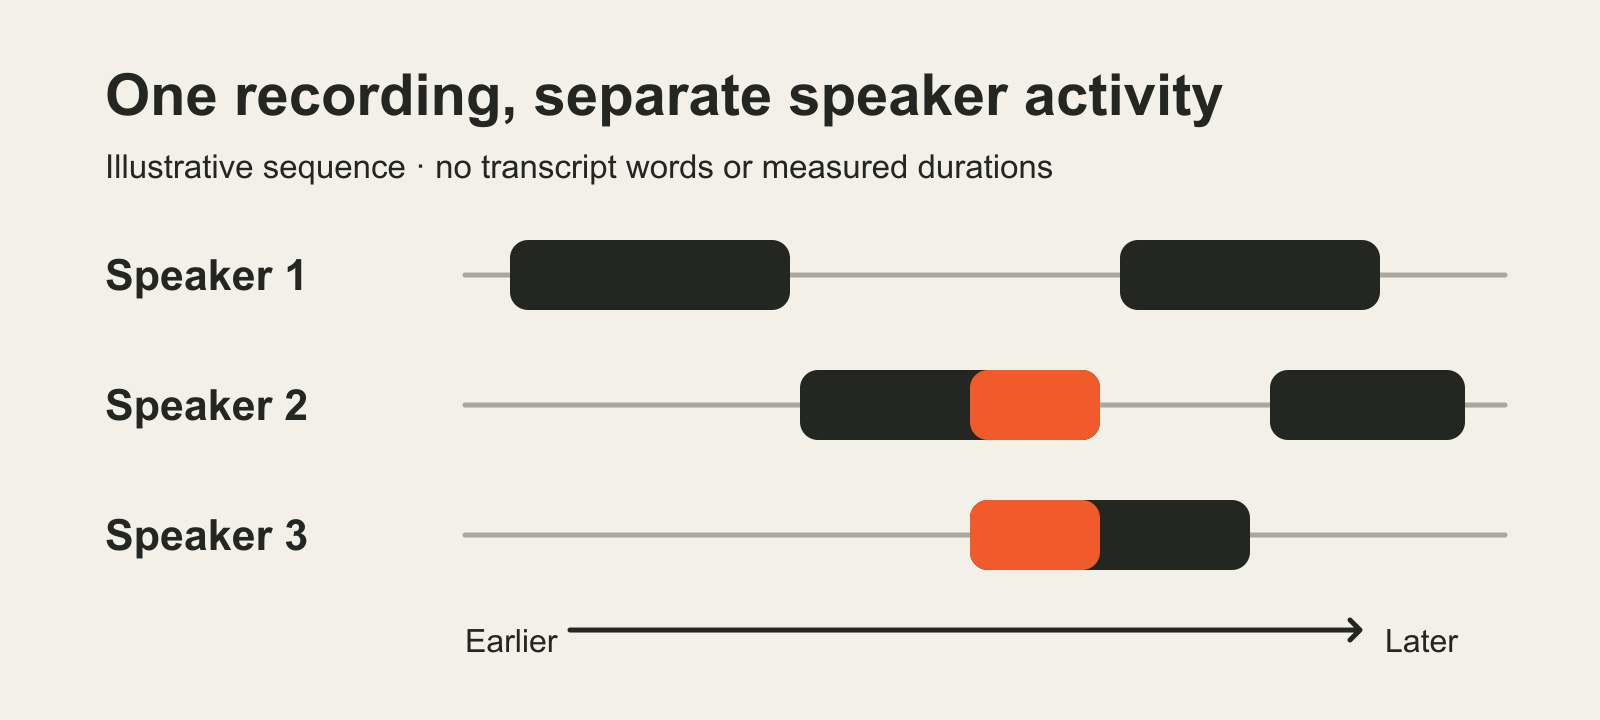
模型会将音频转换为一个[T, 8]说话人活动概率张量,默认输出步长为 10 毫秒。多人重叠发言时,多个通道可以同时处于活动状态。后处理会将这些概率转换为带有起止时间和通用说话人标签的区间。标签按声音首次出现的顺序排列,并不用于识别说话者的姓名。英伟达使用说话人缓存保存较早音频块的信息,并通过先进先出队列处理近期帧,使流式模型能够保留上下文。
对于需要生成带说话人标记转录的开发者来说,这一区别很重要。英伟达的集成指南会将说话人分离时间戳与单独的自动语音识别输出配对。示例中的中点规则规定:没有说话人处于活动状态时,不给词语分配说话人;多人同时发言时,则标记为含糊不清。单靠说话人分离模型,无法判定识别出的词语究竟由哪位重叠发言者说出。
缓冲时长不等于响应时间
英伟达列出的建议输入缓冲设置为 30.4、1.04、0.64 和 0.32 秒。0.32 秒设置由三个 80 毫秒处理帧和一个 80 毫秒右侧上下文帧组成。模型卡明确将延迟定义为推理前保留的音频时长,不包括计算时间。转录系统还会增加识别、传输和应用处理时间。
文档说明,NeMo 路径需要 Python 3.12 或更高版本、Cython、较新的 PyTorch 版本和 NeMo Speech。英伟达提供了一个SortformerEncLabelModel.from_pretrained()示例,以及一个diarize()返回说话人片段的调用,并提供用于包含概率张量的开关。模型卡称,通过该 NeMo 调用加载托管检查点需要 Hugging Face 令牌。它还展示了离线和流式 Transformers 接口,安装方式是从 Transformers 源代码仓库安装;此外还提供了NeMo-Speech.cpp 命令行方案。这些都是文档列出的接口;BIG CHANGE 并未实际运行。模型卡为 NeMo 集成列出了 Linux 系统,以及 NVIDIA Ampere、Hopper 和 Blackwell GPU 系列。特定工作负载所需的硬件和处理成本取决于所选方案和机器;英伟达没有在模型卡中列出每小时运行价格。
这些权重依据OpenMDW 1.1 许可提供。根据许可条款,使用、修改和分发均无需支付许可费。分发时必须保留许可文本和适用的来源声明。许可不限制使用或分享输出内容,并要求用户自行确保其音频所需的权利和同意。英伟达称,该模型可用于商业和非商业用途。
英伟达测量了什么
英伟达的模型卡评估将 Nemotron 3 与较早的四人流式 Sortformer v2.1 进行比较。在完整 DIHARD III 评测集上,英伟达报告称,Nemotron 3 在 1.04 秒输入缓冲设置下的说话人分离错误率为 13.18%;较早模型在相同标注缓冲设置下为 19.60%。缓冲为 0.32 秒时,Nemotron 3 的结果为 13.55%。说话人分离错误率将漏检语音、误报和说话人混淆合并后,除以参考说话人时长。数值越低越好。
这些数字对应一套明确的测试规程。英伟达称,所有评估都会对重叠语音计分。DIHARD III 使用零秒边界容差,而 CALLHOME-Part2 使用 0.25 秒容差。对于 AMI、AliMeeting 和 NOTSOFAR1,英伟达使用经过关联并强制对齐的参考标注,而非原始分段标签;更改这些标签会改变分数。评估说明列明了 NeMo 脚本,并要求提供参考 RTTM 文件、重叠语音设置、边界容差、流式设置和后处理细节,才能进行可比测试。英伟达的推理速度结果是在 RTX PRO 5000 上以 BF16 测得,分别测试了启用和未启用torch.compile()。这些是厂商报告的测试,并非 BIG CHANGE 的复现实验。
八名说话者的上限仍然重要。DIHARD III 包含一些标注了多达九名说话者的录音;模型卡称,超出模型八个通道范围的语音可能被漏掉,或分配给其他通道。在 AMI 测试录音上,英伟达报告称,与此前基线相比,Nemotron 3 的说话人分离错误率更低,但准确判断说话人数的能力也更低。因此,准确性取决于任务和衡量指标,也取决于音频本身。考虑是否集成该模型的团队,可以先参考英伟达公开的接口,再用符合预期用途的录音测试完整的说话人和文字处理流程。