El 22 de septiembre, Claude experimentó un aumento de errores en varios modelos. La actualización final de Anthropic sitúa el periodo de impacto entre las 00:50 y las 02:10 UTC: 80 minutos. La empresa marcó el incidente como resuelto a las 02:35 UTC. Entre los componentes afectados figuraban claude.ai, la API, Code y Cowork. El registro no dice que fallaran todas las solicitudes y no contiene una explicación publicada de la causa raíz. Registro del incidente de Anthropic
Para una empresa que integra la IA en un proceso de trabajo, restablecer el servicio solo resuelve una parte del problema. Puede que todavía haya solicitudes de clientes pendientes. Alguien podría haber empezado a gestionar un caso manualmente mientras seguía activa una operación automatizada. Una persona responsable debe saber qué trabajo puede reanudarse y qué hay que revisar primero.
Que un asistente no esté disponible de vez en cuando resulta molesto si alguien solo lo utiliza para generar ideas. Si el mismo servicio ayuda a clasificar casos entrantes, redactar respuestas y actualizar registros, la interrupción se convierte en un problema operativo. La preparación útil consiste en un pequeño plan de continuidad que el personal pueda seguir sin acceder al propio servicio de IA.
Esta guía utiliza como ejemplo un equipo hipotético de atención al cliente para mostrar cómo podría funcionar ese plan. Son procedimientos propuestos para adaptar y ensayar, no una prueba realizada por BIG CHANGE ni una descripción de clientes afectados por este incidente.
Elige qué servicio puedes mantener sin IA
Imaginemos un pequeño proveedor de equipos cuyo asistente clasifica mensajes de soporte entrantes y prepara respuestas a partir de información aprobada sobre sus productos. El personal revisa las respuestas antes de enviarlas. La empresa depende del sistema para organizar la cola, aunque las personas siguen siendo responsables de lo que se contesta.
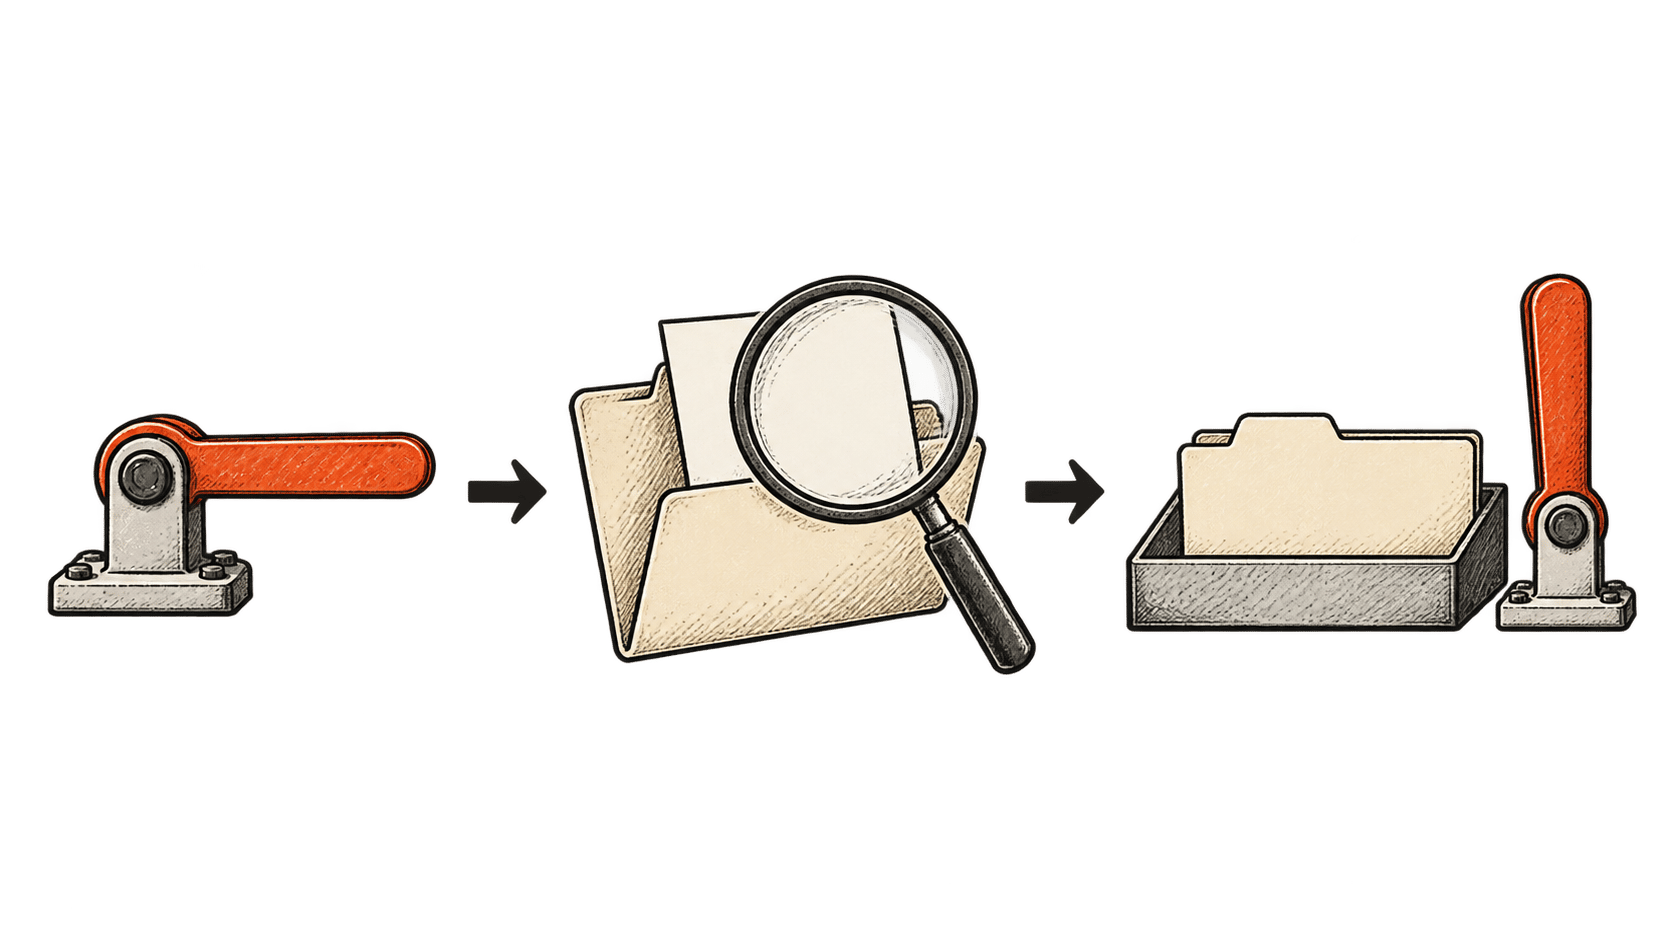
Si el asistente deja de responder, la primera decisión de quien dirige el equipo es qué puede seguir prometiendo el servicio de atención. El personal quizá pueda confirmar la recepción de las solicitudes y ocuparse de los casos con plazos inminentes, y aplazar las explicaciones rutinarias sobre productos. Necesita acceso a los mensajes originales y al material de referencia aprobado fuera del asistente. De lo contrario, «pasar a la gestión manual» es una instrucción sin medios para cumplirla.
Elige de antemano ese servicio reducido. Designa quién puede activarlo, qué trabajo debe detenerse y quién atenderá las tareas restantes. Fija una hora para revisar la situación, de modo que un arreglo temporal no se prolongue toda la tarde sin que nadie lo reevalúe. Los avisos a los clientes deben explicar la demora y el canal disponible para solicitar ayuda urgente, con promesas que el equipo pueda cumplir.
La guía de ingeniería de Google sobre la sobrecarga describe cómo ofrecer funciones reducidas, limitar el tráfico y dar prioridad a las solicitudes importantes cuando escasean los recursos. Son técnicas de fiabilidad establecidas, no un diagnóstico de este incidente de Claude. Aplicadas a un equipo de atención, respaldan una reducción deliberada del alcance cuando no es posible continuar con el procesamiento normal. Google SRE: gestión de la sobrecarga
El servicio reducido también necesita un límite de capacidad. No es posible que dos personas absorban en silencio el trabajo de un sistema automatizado que normalmente atiende muchas más solicitudes. Registra cuántos casos pueden atender, cuáles esperarán y cuándo hará falta más ayuda. A los clientes les sirve más un plazo de respuesta creíble que un acuse automatizado que dé a entender que el servicio funciona con normalidad.
Registra el trabajo fuera de la conversación
El equipo necesita un registro de casos que pueda consultar mientras el modelo no está disponible. Podría ser su sistema de soporte habitual. Lo importante es que la empresa pueda establecer qué ocurrió sin pedirle al asistente interrumpido que lo reconstruya.
Para cada caso, conserva la solicitud original, quién —persona o proceso— es responsable y cuál fue la última acción confirmada. Un borrador guardado no equivale a una respuesta enviada. Proponer un cambio en el registro de un cliente no equivale a que el sistema haya confirmado el cambio. Guarda las pruebas necesarias para distinguir ambos estados y aplica las mismas restricciones de acceso que requieren los datos subyacentes del cliente.
Durante una interrupción, clasifica el trabajo en estas categorías prácticas:
- Listo para empezar: aún no se ha iniciado ningún procesamiento ni ninguna acción externa.
- Preparado en parte: existe una clasificación o un borrador, pero falta completar el siguiente paso.
- Completado y confirmado: el sistema de destino registra la acción prevista.
- Incierto: se intentó una acción, pero falta la confirmación.
Asigna los casos inciertos a alguien que pueda consultar el sistema pertinente antes de reanudarlos. Si el asistente estaba preparando una respuesta cuando se cortó la conexión, generar otro borrador quizá no cause ningún problema. Pero si una herramienta aparte estaba enviándola, repetir toda la tarea podría mandar el mismo mensaje dos veces. El registro del flujo de trabajo debe reflejar esa diferencia.
La documentación de la API de Anthropic dice que una respuesta transmitida en flujo puede fallar después de una respuesta HTTP 200 inicial. Que aparezca el primer texto o se reciba ese estado inicial no demuestra que haya llegado la respuesta completa. La integración debe reconocer cuándo termina la respuesta y conservar como parcial el trabajo incompleto. Documentación de errores de la API de Claude
Limita los reintentos y asigna a alguien su seguimiento
Un reintento puede resolver un fallo temporal. También puede prolongar la incertidumbre si cada capa vuelve a ejecutar el mismo trabajo de forma independiente. Antes de añadir otro botón o un ciclo automatizado, pregunta al proveedor del software si su biblioteca cliente ya hace reintentos.
Anthropic documenta dos reintentos automáticos de forma predeterminada ante fallos transitorios en sus SDK oficiales, con esperas progresivamente más largas y respetando las instrucciones «retry-after» cuando estén presentes. La documentación sobre errores también distingue los problemas temporales del servidor de los errores de autenticación, permisos y solicitudes mal formadas. No se puede dar por sentado que repetir la misma solicitud resolverá todas las categorías. Comportamiento documentado de reintentos de Claude
Para el equipo de atención, la regla operativa debe especificar cuándo se detienen los intentos automáticos y quién se hace cargo del caso a continuación. Conserva el identificador de la solicitud para facilitar el diagnóstico. El personal debe poder ver si una tarea está pendiente, se está reintentando o espera la intervención de una persona, para no iniciar sin saberlo intentos que compitan entre sí.
AWS explica que una acción puede completarse aunque su respuesta nunca llegue. Las API idempotentes utilizan un identificador de solicitud explícito para reconocer los reintentos y evitar efectos secundarios adicionales. El servicio receptor debe cumplir ese contrato; un número de caso interno por sí solo no ofrece esa protección. AWS: cómo hacer seguros los reintentos
Pregunta específicamente por las acciones de tu flujo de trabajo. ¿Un reintento puede crear otro caso de soporte o enviar otro correo? Si no es posible impedir duplicados, el plan debe incluir una comprobación del registro de destino antes de intentarlo de nuevo. Reintentar la generación de texto y repetir todo un proceso empresarial son decisiones distintas.
Asigna una tarea más acotada al modelo de respaldo
Un servicio de IA alternativo puede ayudar a mantener el trabajo en marcha, pero tener una segunda cuenta es solo el primer paso para contar con una alternativa. El sustituto necesita las instrucciones adecuadas, material de referencia aprobado y permiso para manejar los datos. También debe tener capacidad cuando la empresa recurra a él.
Elige una tarea de respaldo acotada antes de intentar sustituir el sistema entero. En nuestro equipo hipotético, otro modelo podría clasificar los mensajes rutinarios mientras el personal gestiona las respuestas a los clientes. El equipo podría evaluarlo con casos representativos, incluidos nombres de productos ambiguos y solicitudes que deben remitirse a una persona. Que la respuesta sea fluida no demuestra que haya respetado las reglas de atención de la empresa.
Decide antes de una interrupción qué información se puede enviar al servicio alternativo. El personal no debería improvisar pegando registros de clientes en cuentas personales. Como parte de la contratación, revisa las condiciones de gestión de datos y los acuerdos de acceso del sustituto, además de su calidad y su precio.
Que los modelos tengan nombres distintos tampoco demuestra que su disponibilidad sea independiente. El respaldo quizá siga dependiendo del mismo inicio de sesión, conexión de red, repositorio de documentos o software de orquestación. Identifica qué dependencias evita de verdad la alternativa propuesta. Ese ejercicio puede revelar que una cola manual con documentos de referencia accesibles ofrece más protección que otro modelo conectado mediante la misma conexión defectuosa.
Las alternativas requieren mantenimiento a medida que cambian las instrucciones y queda obsoleto el conocimiento sobre los productos. El personal necesita practicar procedimientos que rara vez utiliza. Una pequeña empresa podría optar razonablemente por mantener un servicio manual más lento en vez de pagar por duplicar toda la operación. La decisión debe tener en cuenta el coste de las demoras y el daño que podría causar una respuesta incorrecta.
Reanuda el servicio con una cola revisada
Cuando el proveedor comunique que se ha restablecido el servicio, prueba primero una pequeña muestra de tu propio flujo de trabajo. Incluye un caso que requiera la búsqueda de documentos y la actualización de registros que necesita tu empresa. Una respuesta correcta del modelo no demuestra que todos los sistemas conectados estén listos.
Después, examina el trabajo pendiente. Retira los casos atendidos manualmente, revisa las acciones inciertas e identifica solicitudes cuyas circunstancias hayan cambiado. Puede que un cliente haya aportado información nueva durante la interrupción. Redactar una respuesta a partir de una versión anterior del caso podría crear un problema nuevo una vez resuelto el fallo técnico.
Libera el trabajo restante en tandas controladas. Reserva capacidad para nuevas solicitudes urgentes y observa si la cola disminuye. Si la demanda entrante consume toda la capacidad de procesamiento disponible, el trabajo atrasado seguirá pendiente aunque todos los nuevos intentos tengan éxito. Ponerse al día quizá requiera personal adicional, reducir temporalmente el servicio o ampliar con franqueza los plazos de respuesta.
Veamos otro ejemplo numérico. Supongamos que llegan 24 casos por hora y que el procesamiento se detiene durante 30 minutos. Quedan 12 casos pendientes. Si después el equipo atiende 36 por hora mientras siguen llegando 24 nuevos, tardará una hora en ponerse al día. Son supuestos ilustrativos, no mediciones del incidente de Claude.
La guía de Google sobre objetivos de nivel de servicio parte del resultado que importa a los usuarios y de las dependencias necesarias para conseguirlo. Para este equipo, una medida útil podría ser el porcentaje de casos urgentes que reciben una respuesta adecuada dentro del plazo prometido. La disponibilidad del proveedor es pertinente, pero la empresa también necesita saber si sus clientes recibieron el servicio. Google SRE: implementación de objetivos de nivel de servicio
Registra cuándo se restableció el servicio normal al cliente, cuántos casos seguían sin resolverse y qué correcciones hicieron falta después. Estas medidas revelan el trabajo de recuperación que la página de estado del proveedor no puede observar.
Ensaya una interrupción antes de ampliar la automatización
Un breve ejercicio de simulación puede revelar carencias de acceso o responsabilidades sin interrumpir el servicio a los clientes. Usa unos pocos casos ficticios de soporte y repasa esta secuencia:
- Supón que el modelo deja de estar disponible mientras prepara una respuesta. Pregunta quién activa el servicio reducido y dónde encuentra el personal la solicitud original.
- Asigna una respuesta enviada y confirmada a un caso, y un intento de envío incierto a otro. Comprueba si el equipo sabe qué sistema puede determinar el resultado.
- Supón que el proveedor ha restablecido el servicio mientras siguen llegando casos nuevos. Decide qué trabajo se reanuda primero y cómo se retiran de la cola los casos resueltos manualmente.
- Pide a alguien que no haya redactado el plan que explique el procedimiento y señale los permisos o registros a los que no tiene acceso.
Anota qué preguntas no pudo responder el ejercicio. Las correcciones necesarias quizá sean modestas: acceso a una cola existente, un control claro para pausar el servicio, una confirmación guardada o una persona responsable de la recuperación. Ninguna garantiza un servicio ininterrumpido. Cada una puede facilitar que la interrupción quede contenida sin renunciar a las ventajas de la automatización.
Antes de asignar otra responsabilidad operativa a un asistente, pide a un colega que explique cómo se gestionaría durante una interrupción. Si la respuesta depende de que el asistente no disponible recuerde lo que estaba haciendo, aún queda trabajo por hacer en el plan de continuidad.