22 सितंबर को Claude के कई मॉडलों में त्रुटियाँ बढ़ गई थीं। Anthropic के अंतिम घटना-अपडेट के अनुसार असर की अवधि 00:50 से 02:10 UTC—यानी 80 मिनट—थी। घटना को 02:35 UTC पर सुलझा चिह्नित किया गया। प्रभावित घटकों में claude.ai, API, Code और Cowork शामिल थे। रिकॉर्ड यह नहीं कहता कि हर अनुरोध विफल हुआ था और न ही मूल वजह की कोई प्रकाशित व्याख्या देता है। Anthropic का घटना-रिकॉर्ड
कामकाजी प्रक्रिया में AI इस्तेमाल करने वाले कारोबार के लिए सेवा बहाल होना समस्या का सिर्फ़ एक हिस्सा हल करता है। ग्राहकों के अनुरोध अब भी इंतज़ार कर रहे हो सकते हैं। कोई व्यक्ति हाथ से मामला सँभालना शुरू कर चुका हो और स्वचालित कोशिश अब भी सक्रिय हो सकती है। पर्यवेक्षक को जानना होगा कि कौन-सा काम फिर शुरू किया जा सकता है और किसकी पहले जाँच चाहिए।
विचार-मंथन में कभी-कभार सहायक उपलब्ध न होना असुविधाजनक है। लेकिन वही सेवा आने वाले मामलों की श्रेणी तय करने, जवाब के मसौदे बनाने और रिकॉर्ड अपडेट करने में मदद करे, तो रुकावट संचालन की समस्या बन जाती है। काम की तैयारी के लिए एक छोटी निरंतरता योजना उपयोगी है जिसे कर्मचारी AI सेवा तक पहुँच न होने पर भी अपना सकें।
यह मार्गदर्शिका एक काल्पनिक ग्राहक-सेवा डेस्क से दिखाती है कि ऐसी योजना कैसे काम कर सकती है। प्रक्रियाएँ अपनाने और अभ्यास करने के लिए प्रस्ताव हैं; ये BIG CHANGE का किया परीक्षण या इस घटना से प्रभावित ग्राहकों का विवरण नहीं।
वह सेवा चुनें जो AI के बिना भी जारी रख सकें
मान लें कि उपकरणों का एक छोटा आपूर्तिकर्ता आने वाले सहायता-संदेशों की श्रेणी तय करने और स्वीकृत उत्पाद जानकारी से जवाब तैयार करने के लिए सहायक इस्तेमाल करता है। भेजने से पहले कर्मचारी जवाबों की समीक्षा करते हैं। जवाबों की ज़िम्मेदारी लोगों पर रहते हुए भी कारोबार कतार व्यवस्थित करने के लिए सिस्टम पर निर्भर है।
अगर सहायक जवाब देना बंद कर दे, तो प्रबंधक का पहला फ़ैसला यह है कि डेस्क अब भी किस सेवा का वादा कर सकती है। कर्मचारी अनुरोध मिलने की पुष्टि जारी रख सकते हैं और आसन्न समय-सीमा वाले मामले सँभाल सकते हैं, जबकि नियमित उत्पाद-व्याख्या को टाल सकते हैं। सहायक से बाहर मूल संदेशों और स्वीकृत संदर्भ-सामग्री तक पहुँच चाहिए। वरना “हाथ से काम करें” ऐसा निर्देश होगा जिसे पूरा करने के साधन नहीं हैं।
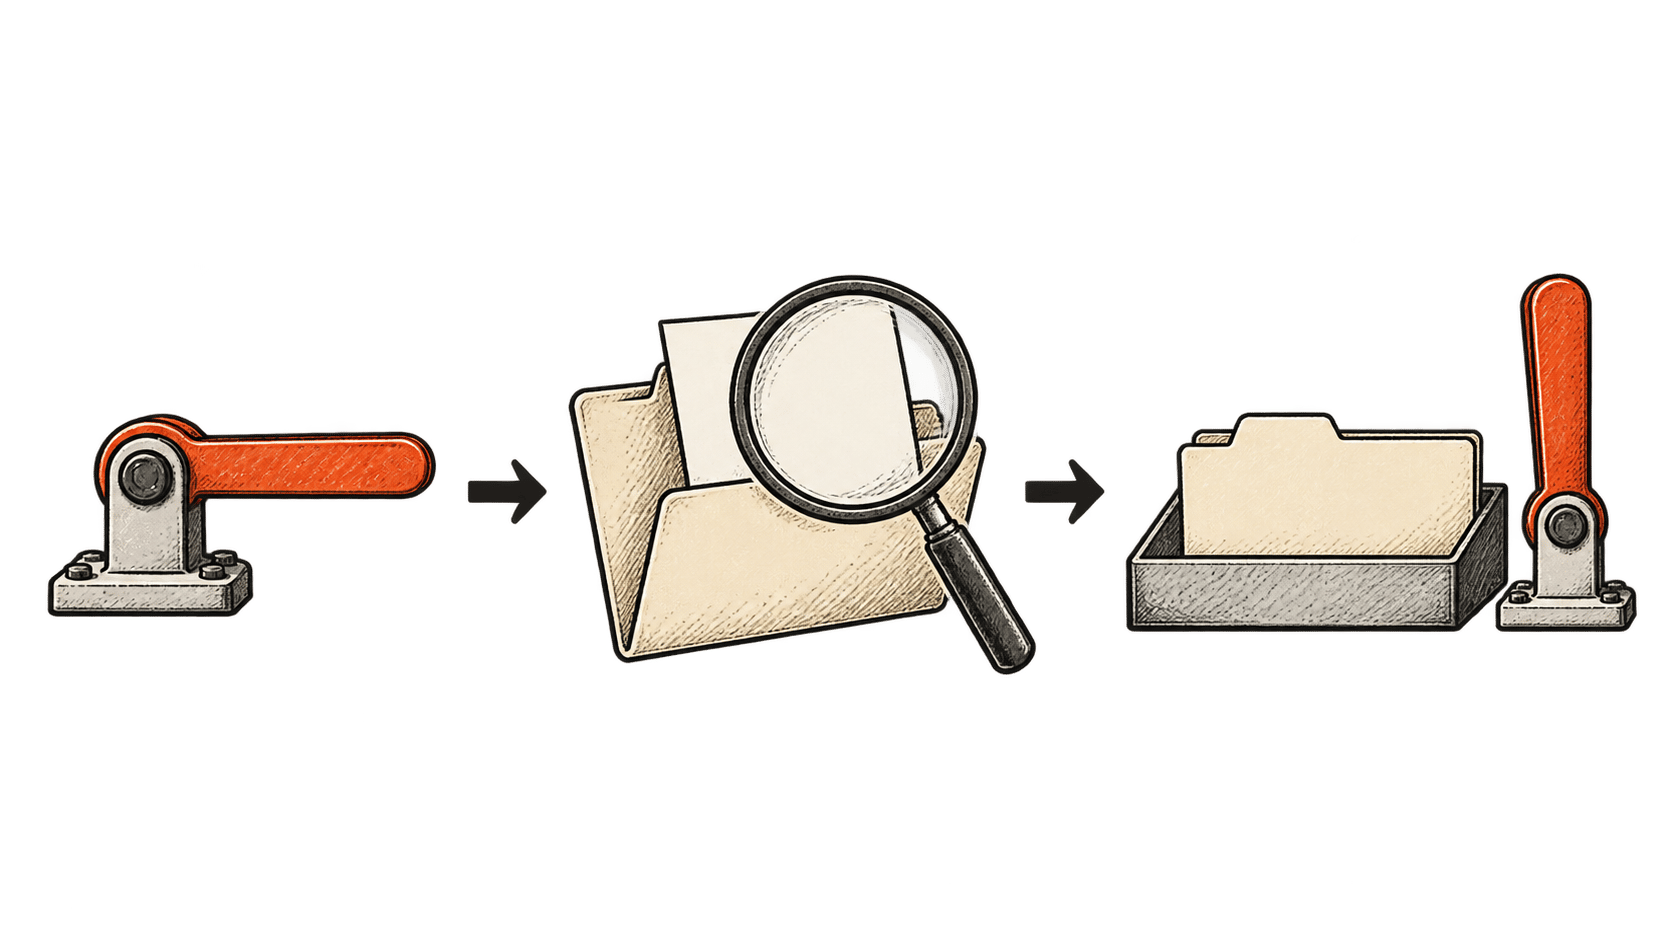
सेवा घटाने का विकल्प पहले से तय करें। इसे सक्रिय करने वाले व्यक्ति, रोका जाने वाला काम और बाकी कार्यों को सँभालने वाले कर्मचारियों के नाम तय करें। समीक्षा का समय रखें ताकि अस्थायी व्यवस्था बिना पुनर्मूल्यांकन के पूरी दोपहर न खिंच जाए। ग्राहकों को देरी और ज़रूरी मदद के उपलब्ध तरीके बताए जाएँ—ऐसे वादों के साथ जिन्हें टीम पूरा कर सके।
ओवरलोड सँभालने पर Google की इंजीनियरिंग मार्गदर्शिका कम कार्यक्षमता पर सेवा देने, ट्रैफ़िक सीमित करने और संसाधन कम होने पर ज़रूरी अनुरोधों को प्राथमिकता देने का वर्णन करती है। ये स्थापित विश्वसनीयता तकनीकें हैं, Claude घटना का कारण-विश्लेषण नहीं। सेवा-डेस्क में अपनाने पर ये सामान्य काम आगे न चल पाए, तो जान-बूझकर दायरा कम करने का आधार देती हैं। Google SRE: ओवरलोड सँभालना
सीमित सेवा की भी क्षमता-सीमा चाहिए। दो लोग चुपचाप उस स्वचालित सिस्टम का काम नहीं सँभाल सकते जो आम तौर पर कहीं अधिक अनुरोध निपटाता है। दर्ज करें कि वे कितना काम सँभाल सकते हैं, क्या इंतज़ार करेगा और अतिरिक्त मदद कब ज़रूरी होगी। सामान्य सेवा जारी होने का संकेत देने वाली स्वचालित पुष्टि से बेहतर है ग्राहकों को जवाब मिलने का विश्वसनीय समय बताना।
बातचीत से बाहर काम का रिकॉर्ड रखें
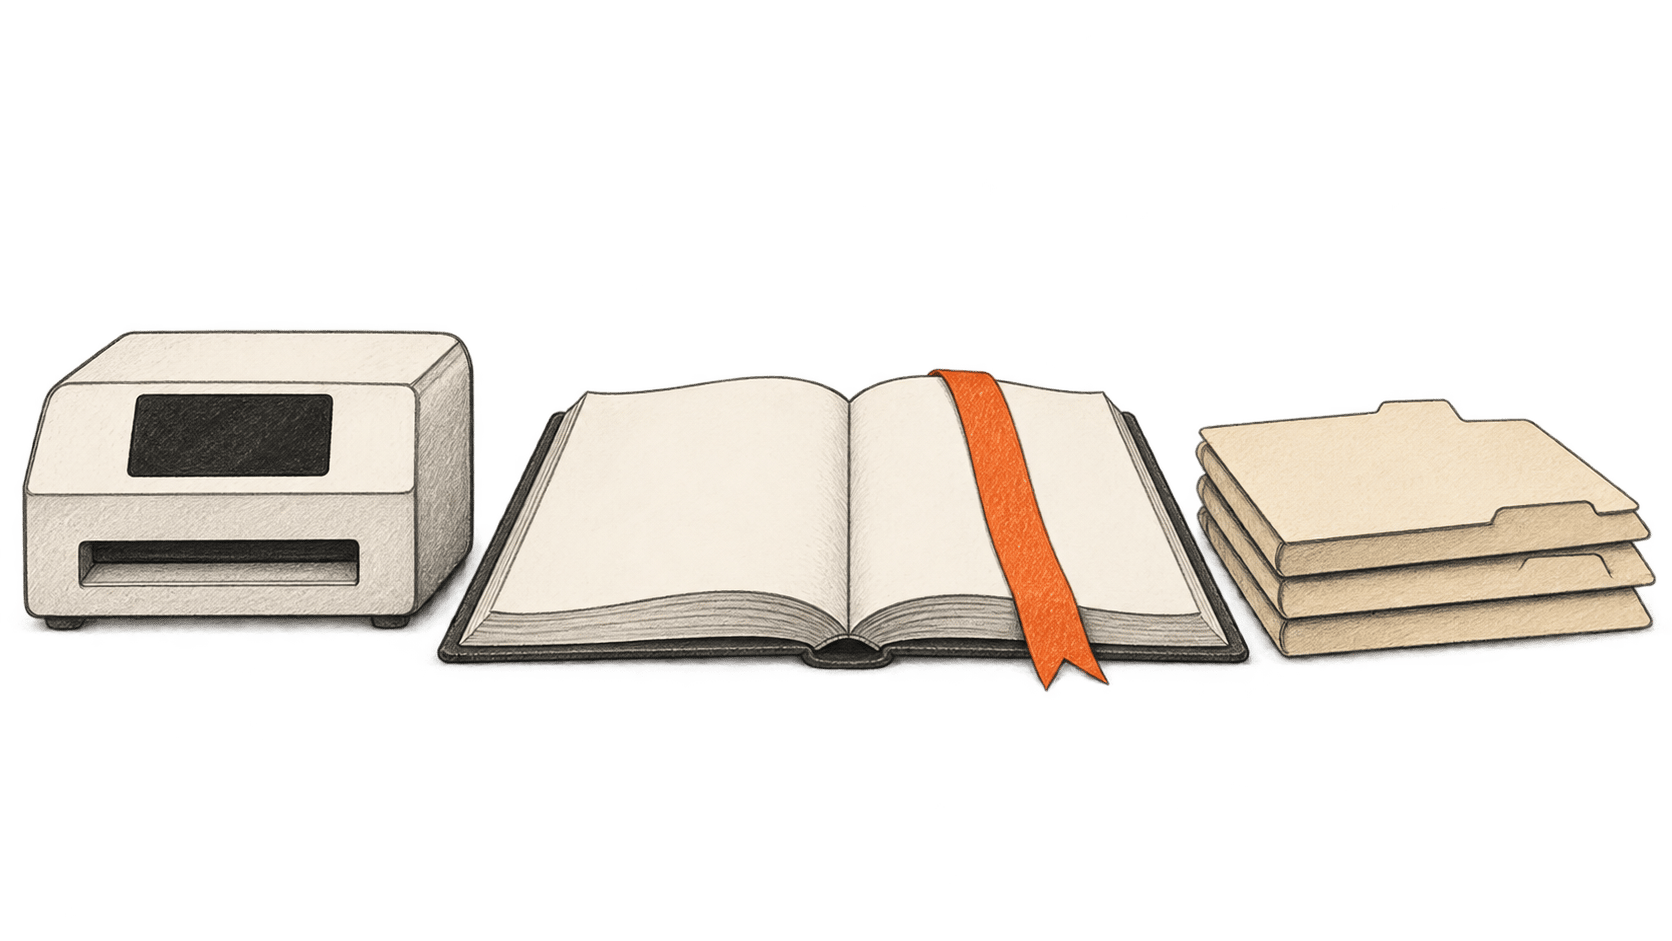
सेवा-डेस्क को ऐसा केस रिकॉर्ड चाहिए जिसे मॉडल अनुपलब्ध होने पर पढ़ा जा सके। वह उसका मौजूदा सहायता-सिस्टम हो सकता है। अहम बात यह है कि रुकावट वाले सहायक से दोबारा घटनाक्रम बनवाए बिना कारोबार पता लगा सके कि क्या हुआ।
हर मामले के लिए मूल अनुरोध, ज़िम्मेदार व्यक्ति या प्रक्रिया और आखिरी पुष्ट कार्रवाई सुरक्षित रखें। सहेजा गया मसौदा भेजे गए जवाब से अलग है। ग्राहक रिकॉर्ड में प्रस्तावित बदलाव, उस सिस्टम में पुष्ट बदलाव के बराबर नहीं। उन्हें अलग पहचानने के लिए ज़रूरी प्रमाण उसी पहुँच-सीमा के साथ रखें जो मूल ग्राहक जानकारी पर लागू होती है।
रुकावट के दौरान काम को इन व्यावहारिक श्रेणियों में बाँटें:
- शुरू करने के लिए तैयार: कोई प्रोसेसिंग या बाहरी कार्रवाई शुरू नहीं हुई।
- आंशिक तैयारी: श्रेणी या मसौदा तैयार है, पर अगला कदम पूरा नहीं हुआ।
- पूरा होने की पुष्टि: गंतव्य सिस्टम में इच्छित कार्रवाई दर्ज है।
- अनिश्चित: कार्रवाई की कोशिश हुई, लेकिन पुष्टि नहीं मिली।
अनिश्चित मामलों को ऐसे व्यक्ति को दें जो फिर शुरू करने से पहले संबंधित सिस्टम जाँच सके। कनेक्शन टूटते समय सहायक जवाब तैयार कर रहा हो, तो नया मसौदा बनाना हानिरहित हो सकता है। लेकिन कोई अलग औज़ार जवाब भेज रहा हो, तो पूरा काम दोहराने से वही जवाब दो बार जा सकता है। कार्यप्रवाह रिकॉर्ड में यह अंतर दर्ज होना चाहिए।
Anthropic के API दस्तावेज़ के अनुसार, शुरुआती HTTP 200 सफलता-जवाब के बाद भी स्ट्रीमिंग प्रतिक्रिया विफल हो सकती है। पहला पाठ दिखाई देना या शुरुआती स्थिति मिलना यह साबित नहीं करता कि पूरा जवाब आ गया। इंटीग्रेशन से कहें कि वह पूरा होना पहचाने और अधूरे काम को अधूरा ही सुरक्षित रखे। Claude API में त्रुटियों के दस्तावेज़
दोबारा कोशिशों की सीमा और ज़िम्मेदार व्यक्ति तय करें
दोबारा कोशिश से अस्थायी विफलता दूर हो सकती है। लेकिन अगर हर परत स्वतंत्र रूप से वही काम दोहराए, तो अनिश्चितता बढ़ सकती है। एक और दोहराने वाला बटन या स्वचालित चक्र जोड़ने से पहले सॉफ़्टवेयर विक्रेता से पूछें कि उसकी क्लाइंट लाइब्रेरी के भीतर पहले से कोशिशें होती हैं या नहीं।
Anthropic के अनुसार उसके आधिकारिक SDK अस्थायी विफलताओं पर डिफ़ॉल्ट रूप से दो स्वचालित कोशिशें करते हैं; इनके बीच बढ़ता हुआ अंतर रखते हैं और उपलब्ध होने पर retry-after निर्देश मानते हैं। उसके त्रुटि-दस्तावेज़ अस्थायी सर्वर समस्याओं को प्रमाणीकरण, अनुमति और ग़लत अनुरोध की विफलताओं से अलग भी करते हैं। यह मानकर नहीं चल सकते कि वही अनुरोध दोहराने से हर तरह की समस्या ठीक हो जाएगी। Claude का दस्तावेज़ीकृत दोबारा-कोशिश व्यवहार
सेवा-डेस्क के संचालन-नियम में बताया जाना चाहिए कि स्वचालित कोशिशें कब रुकेंगी और उसके बाद केस किसे मिलेगा। समस्या-जाँच के लिए अनुरोध पहचान-संख्या सुरक्षित रखें। कर्मचारियों को दिखना चाहिए कि काम कतार में है, दोबारा कोशिश हो रही है या किसी व्यक्ति की प्रतीक्षा है—ताकि वे अनजाने में प्रतिस्पर्धी कोशिशें शुरू न करें।
AWS बताता है कि जवाब न पहुँचने पर भी कार्रवाई सफल हो सकती है। उसके idempotent API स्पष्ट अनुरोध-संख्या से दोहराए अनुरोध पहचानते और अतिरिक्त दुष्प्रभाव रोकते हैं। प्राप्तकर्ता सेवा को यह नियम लागू करना होता है; सिर्फ़ आंतरिक केस नंबर जोड़ने से ऐसी सुरक्षा नहीं मिलती। AWS: दोबारा कोशिशें सुरक्षित बनाना
अपने कार्यप्रवाह की कार्रवाइयों के बारे में खास तौर पर पूछें। क्या दोहराई गई कोशिश दूसरा सहायता-टिकट बना सकती है या एक और ईमेल भेज सकती है? अगर डुप्लिकेट रोकने की सुविधा नहीं है, तो योजना में अगली कोशिश से पहले गंतव्य रिकॉर्ड जाँचना शामिल होना चाहिए। पाठ तैयार करने की कोशिश दोहराना और पूरी कारोबारी प्रक्रिया दोहराना अलग फ़ैसले हैं।
बैकअप मॉडल को सीमित काम दें
दूसरी AI सेवा काम जारी रखने में मदद कर सकती है, लेकिन दूसरा खाता होना ही बैकअप नहीं। विकल्प के पास सही निर्देश, स्वीकृत संदर्भ सामग्री और डेटा सँभालने की अनुमति होनी चाहिए। कारोबार उस पर निर्भर हो, तब उसके पास पर्याप्त क्षमता भी होनी चाहिए।
पूरा विकल्प बनाने से पहले सीमित बैकअप काम चुनें। हमारे काल्पनिक सेवा-डेस्क में दूसरा मॉडल नियमित संदेशों की श्रेणी तय कर सकता है, जबकि कर्मचारी ग्राहकों को भेजे जाने वाले जवाब सँभालें। टीम अस्पष्ट उत्पाद-नाम और किसी व्यक्ति को सौंपे जाने वाले अनुरोधों समेत प्रतिनिधि मामलों पर उसका आकलन कर सकती है। सहज जवाब भर से यह साबित नहीं होगा कि मॉडल ने कंपनी के सहायता-नियम माने।
घटना से पहले तय करें कि वैकल्पिक सेवा को कौन-सी जानकारी भेजी जा सकती है। कर्मचारी ग्राहक रिकॉर्ड को निजी खातों में कॉपी-पेस्ट करके तत्काल उपाय न करें। खरीद के दौरान विकल्प की डेटा-संभाल शर्तें और पहुँच व्यवस्था जाँचें; साथ में आउटपुट की गुणवत्ता और कीमत भी देखें।
अलग मॉडल-नाम होने से उपलब्धता स्वतंत्र साबित नहीं होती। बैकअप उसी लॉगिन, नेटवर्क कनेक्शन, दस्तावेज़ भंडार या समन्वय सॉफ़्टवेयर पर निर्भर हो सकता है। देखें कि प्रस्तावित विकल्प किन निर्भरताओं से सचमुच बचता है। इससे पता चल सकता है कि उन्हीं टूटे कनेक्शन के पीछे एक और मॉडल रखने से ज़्यादा उपयोगी सुरक्षा मैनुअल कतार और आसानी से मिलने वाले संदर्भ दस्तावेज़ देंगे।
निर्देश बदलने और उत्पाद-जानकारी पुरानी होने पर विकल्प को रखरखाव चाहिए। कम इस्तेमाल होने वाली प्रक्रिया का कर्मचारियों को अभ्यास भी चाहिए। छोटा कारोबार पूरे संचालन की दूसरी प्रति का ख़र्च उठाने के बजाय उचित रूप से धीमी मैनुअल सेवा रख सकता है। यह चुनाव काम में देरी की लागत और ग़लत जवाब से होने वाले नुकसान के अनुसार होना चाहिए।
जाँची हुई कतार के साथ काम फिर शुरू करें
प्रदाता सेवा बहाल होने की सूचना दे, तो सामान्य काम फिर शुरू करने से पहले अपने कार्यप्रवाह के कुछ मामलों का नमूना जाँचें। उसमें दस्तावेज़ खोजना और रिकॉर्ड अपडेट करना—आपके कारोबार को चाहिए ऐसी प्रक्रिया वाला मामला शामिल करें। मॉडल का सफल जवाब यह साबित नहीं कर सकता कि हर जुड़ा सिस्टम तैयार है।
फिर इंतज़ार कर रहे काम की समीक्षा करें। हाथ से पहले ही सँभाले गए मामले हटाएँ, अनिश्चित कार्रवाइयाँ जाँचें और बदली परिस्थितियों वाले अनुरोध पहचानें। रुकावट के दौरान ग्राहक नई जानकारी दे चुका हो सकता है। मामले के पुराने रूप के आधार पर जवाब बनाना तकनीकी समस्या सुलझने के बाद नई समस्या पैदा कर सकता है।
बाकी काम सीमित खेपों में जारी करें। नए अत्यावश्यक अनुरोधों के लिए क्षमता बचाकर रखें और देखें कि कतार घट रही है या नहीं। नए अनुरोध आने की दर उपलब्ध प्रोसेसिंग क्षमता पूरी खपा दे, तो हर नई कोशिश सफल होने पर भी बैकलॉग बना रहेगा। उसे निपटाने के लिए अतिरिक्त कर्मचारी, अस्थायी रूप से कम सेवा या जवाब के समय में ईमानदार बढ़ोतरी चाहिए हो सकती है।
एक अलग संख्यात्मक उदाहरण लें: मान लें कि हर घंटे 24 मामले आते हैं और काम 30 मिनट रुक जाता है। तब 12 मामले इंतज़ार में होंगे। अगर डेस्क फिर हर घंटे 36 मामले सँभाले और 24 नए मामले लगातार आते रहें, तो बैकलॉग मिटाने में एक घंटा लगेगा। ये उदाहरण के लिए मान्यताएँ हैं, Claude घटना के माप नहीं।
सेवा-स्तर लक्ष्य लागू करने पर Google की मार्गदर्शिका उपयोगकर्ताओं के लिए अहम नतीजे और उन्हें देने की ज़रूरी निर्भरताओं से शुरुआत करती है। इस डेस्क के लिए उपयोगी माप यह हो सकता है कि वादा किए समय के भीतर कितने अत्यावश्यक मामलों को उचित जवाब मिला। प्रदाता की उपलब्धता मायने रखती है, लेकिन कारोबार को यह भी जानना चाहिए कि ग्राहकों को सेवा मिली या नहीं। Google SRE: सेवा-स्तर लक्ष्य लागू करना
दर्ज करें कि सामान्य ग्राहक-सेवा किस समय लौटी, कितने मामले अनसुलझे हैं और बाद में किन सुधारों की ज़रूरत पड़ी। ये माप बहाली का वह काम सामने लाते हैं जिसे प्रदाता का स्थिति-पृष्ठ नहीं देख सकता।
स्वचालन बढ़ाने से पहले एक रुकावट का अभ्यास करें
कम समय का टेबलटॉप अभ्यास लाइव ग्राहकों को बाधित किए बिना पहुँच या ज़िम्मेदारी की कमी दिखा सकता है। कुछ काल्पनिक सहायता-मामले लें और यह क्रम अपनाएँ:
- मान लें कि जवाब बनाते समय मॉडल बीच में अनुपलब्ध हो गया। पूछें कि सीमित सेवा कौन शुरू करेगा और कर्मचारी मूल अनुरोध कहाँ पाएँगे।
- एक मामले में भेजे गए जवाब की पुष्टि और दूसरे में भेजने की अनिश्चित कोशिश रखें। जाँचें कि टीम जानती है या नहीं कि नतीजा किस सिस्टम से पता चलेगा।
- मान लें कि नए मामले आते रहने के दौरान प्रदाता की सेवा लौट आई है। तय करें कि कौन-सा काम पहले फिर शुरू होगा और हाथ से पूरे किए मामले बैकलॉग से कैसे हटेंगे।
- योजना के लेखक से अलग किसी व्यक्ति से प्रक्रिया समझाने और यह बताने को कहें कि उसके पास कौन-सी अनुमति या रिकॉर्ड नहीं हैं।
अभ्यास जिन सवालों का जवाब नहीं दे सका, उन्हें लिखें। उसके बाद छोटे सुधारों की ज़रूरत हो सकती है: मौजूदा कतार तक पहुँच, रोकने का साफ़ नियंत्रण, सहेजी गई पुष्टि या बहाली का ज़िम्मेदार व्यक्ति। इनमें से कोई भी निर्बाध सेवा की गारंटी नहीं देता। हर सुधार स्वचालन के लाभ छोड़े बिना रुकावट को सँभालना आसान कर सकता है।
सहायक को एक और संचालन-संबंधी ज़िम्मेदारी देने से पहले किसी सहकर्मी से दिखाने को कहें कि आउटेज के समय उसे कैसे सँभालेंगे। जवाब अनुपलब्ध सहायक की याद पर निर्भर हो, तो निरंतरता योजना में अब भी काम बाकी है।