Anthropicの最終障害更新によると、Claudeでは2026年9月22日、複数モデルでエラーが増加した。影響時間帯は00:50~02:10 UTCの80分間で、02:35 UTCに解消済みとされた。影響を受けたコンポーネントにはclaude.ai、API、Code、Coworkが含まれる。すべてのリクエストが失敗したとは記されておらず、根本原因の公表もない。Anthropicの障害記録
業務プロセスの中でAIを使う企業にとって、サービスの復旧だけでは問題の一部しか解決しない。顧客からの依頼はまだ待っているかもしれない。自動処理の試行が動いたまま、誰かが手作業で対応を始めていることもある。管理者は、どの作業を再開でき、どの作業を先に確認すべきか把握する必要がある。
アイデア出しに役立つアシスタントが時折使えなくなっても、不便で済むことがある。同じサービスで問い合わせを分類し、返信を作り、記録を更新していれば、停止は業務上の問題になる。有用な備えは、AIサービスにアクセスできなくてもスタッフが実行できる、小規模な継続計画だ。
ここでは、仮想のカスタマーサービス窓口を使って計画の一例を示す。手順は応用して訓練するための提案であり、BIG CHANGEが実施したテストでも、この障害で影響を受けた顧客についての説明でもない。
AIなしでも維持できるサービスを選ぶ
小規模な機器販売会社を考えてみよう。同社のアシスタントは、届いたサポートメッセージを分類し、承認済みの製品情報を使って返信案を準備する。スタッフは送信前に返信を確認する。回答の責任は人間が持っているが、問い合わせの整理はシステムに依存している。
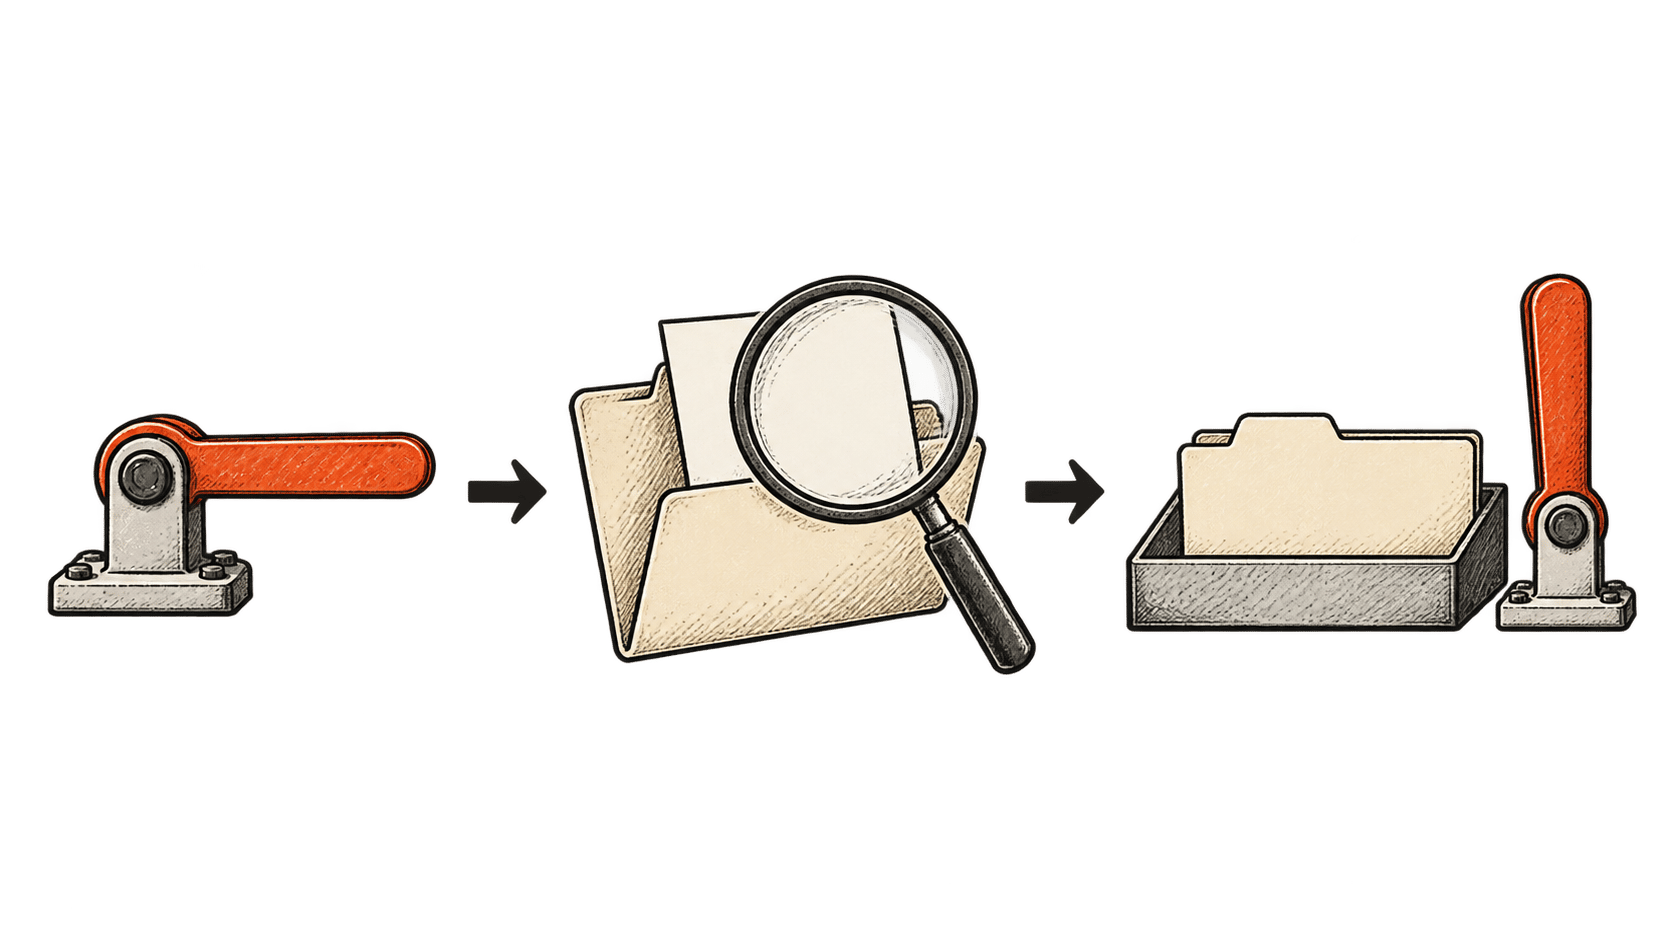
アシスタントが応答しなくなったら、管理者が最初に判断するのは、窓口が何を約束し続けられるかだ。依頼の受領連絡と、期限の迫った案件への対応は続け、通常の製品説明は後回しにできるかもしれない。そのためには、アシスタント外で元のメッセージと承認済みの参照資料にアクセスできる必要がある。そうでなければ「手作業に切り替える」という指示には、実行手段がない。
縮小サービスは事前に選んでおこう。切り替えを決定する人、停止する作業、残ったタスクを担当するスタッフを決める。一時的な運用が午後まで続き、誰も見直さない状態を防ぐため、再確認する時刻も設定する。顧客向けの案内では、遅延と緊急時の連絡方法を、チームが守れる約束とともに説明しよう。
Googleのエンジニアリング指針は、過負荷時に機能を縮小し、トラフィックを制限し、重要なリクエストを優先する方法を説明している。これらは確立された信頼性技術であり、今回のClaude障害の診断ではない。窓口業務に応用すれば、通常の処理を続けられない場合に、対象範囲を意図的に縮小する根拠となる。Google SRE:過負荷への対応
縮小後のサービスにも処理上限が必要だ。通常なら自動システムが多数の依頼を処理するのに、二人の担当者がその仕事を黙って引き継ぐことはできない。対応可能な件数、待たせる作業、追加支援が必要になる時点を記録しよう。通常どおり稼働しているように見せる自動受領通知より、守れる回答時期を伝えるほうが顧客のためになる。
会話の外に作業記録を残す
モデルが使えない間も読める案件記録が、サービス窓口には必要だ。既存のサポートシステムでもよい。重要なのは、停止したアシスタントに経緯を再構成させなくても、何が起きたかを会社が確認できることだ。
各案件では、元の依頼、担当する人またはプロセス、最後に確認された対応を保存しよう。保存した下書きと送信済みの返信は違う。顧客記録への変更案と、そのシステムが確認した変更も違う。区別に必要な証拠を、元の顧客情報と同じアクセス制限で保管する。
障害中の作業は、次の実務的な区分に分ける。
- 未着手:処理も外部への操作も始まっていない。
- 一部準備済み:分類や下書きはあるが、次の段階が未完了。
- 完了確認済み:送信先システムに、意図した操作が記録されている。
- 不確実:操作を試みたが、確認が取れていない。
不確実な案件は、再開前に関連システムを確認できる人に割り当てる。接続が失われたときにアシスタントが返信を準備中だったなら、新しい下書きを作るだけで済むかもしれない。別のツールが返信を送信中だった場合、タスク全体をやり直すと二重送信になる可能性がある。この違いを業務記録に残す必要がある。
AnthropicのAPI文書によると、ストリーミング応答は、最初にHTTP 200の成功応答が返った後でも失敗することがある。最初の文章が表示されたり、そのステータスが返ったりしても、回答全体の到着が確定するわけではない。連携システムには完了を判定させ、途中までの作業は未完了として保存させよう。Claude APIのエラー文書
再試行には上限と担当者を設ける
再試行で一時的な障害が解消することはある。一方、各階層が独立に同じジョブを繰り返すと、不確実な状態を長引かせることもある。再試行ボタンや自動ループを追加する前に、ソフトウェア提供者へ、クライアントライブラリ内ですでに再試行が行われているか確認しよう。
Anthropicによると、公式SDKは一時的な失敗に対して既定で2回、自動再試行する。間隔を延ばしながら試み、指示があればretry-afterにも従う。エラー文書では、一時的なサーバーの問題と、認証、権限、形式不正なリクエストの失敗も区別している。同じリクエストを繰り返せば、どのエラーも直るとは限らない。Claudeで文書化された再試行動作
窓口業務では、自動試行をいつ止め、その後どの担当者に案件を渡すかを運用ルールに定める。トラブル調査用にリクエスト識別子も保存する。スタッフがジョブの待機中、再試行中、人による対応待ちのいずれかを確認できるようにし、競合する試行を知らずに開始しないようにする。
AWSは、応答が届かなくても操作自体は成功している可能性を説明している。冪等性を備えたAPIは明示的なリクエスト識別子を使い、再試行を識別して追加の副作用を防ぐ。受信側のサービスがこの契約を実装しなければならない。社内の案件番号を付けるだけでは保護にならない。AWS:再試行を安全にする方法
業務フローが実行する操作を具体的に確認しよう。再試行でサポートチケットやメールを重複して作成することがあるか。重複を防ぐ仕組みがなければ、再試行前に送信先の記録を確認する必要がある。文章の生成を再試行することと、業務プロセス全体を繰り返すことでは判断が異なる。
代替モデルには、より限定した役割を与える
別のAIサービスを使えば作業を続けられることもあるが、予備アカウントを作るだけでは代替策にならない。代替サービスには適切な指示、承認済みの参照資料、データを扱う権限が必要だ。会社が使おうとするときに十分な処理能力があることも確かめよう。
完全な置き換えを試す前に、範囲を限った代替タスクを決めておく。仮想の窓口なら、別モデルには通常の問い合わせを分類させ、顧客向けの返信はスタッフが扱う方法がある。あいまいな製品名や人に回すべき依頼を含む代表的な案件で評価しよう。流暢な回答だけでは、会社のサポート規則に従ったことは証明されない。
障害発生前に、代替サービスへ送信してよい情報を決めておく。顧客記録を個人アカウントに貼り付けるなど、スタッフに即興で対応させてはならない。調達時に、出力の品質や価格とともに、代替サービスのデータ取扱条件とアクセス方法を確認しよう。
モデル名が異なるからといって、利用可能性も独立しているとは限らない。代替手段が、同じログイン、ネットワーク接続、文書保管庫、オーケストレーションソフトウェアに依存することもある。代替案が実際にどの依存関係を避けるかを書き出そう。失敗中の接続の先に別モデルを置くより、参照文書を利用できる手作業の待ち行列のほうが役立つとわかるかもしれない。
指示の更新や製品知識の陳腐化に伴い、代替手段にも保守が必要になる。まれにしか使わない手順をスタッフが練習しておくことも大切だ。小規模事業者なら、業務全体を二重化する費用を払わず、処理が遅れるコストと誤答の害に応じて、低速な手作業サービスを維持する判断も妥当だろう。
確認済みの待ち行列から再開する
提供者が復旧を報告したら、通常処理を再開する前に、自社の業務フローから少数の案件を選んで確認する。文書検索や記録更新など、事業に必要な操作を含めよう。モデルの応答が成功しても、接続されたすべてのシステムが利用可能とは限らない。
次に、待ち状態の作業を確認する。手作業で既に処理した案件を除き、不確実な操作を調べ、状況が変わった依頼を特定する。障害中に顧客が新しい情報を送っているかもしれない。案件の古い情報から返信を作ると、技術的な障害が終わった後に新たな問題が生じることがある。
残りの作業は管理できる量ずつ再開しよう。新たな緊急依頼に対応する余力を残し、待ち行列が減っているか観察する。新しい依頼が処理能力をすべて使うなら、その都度の試行が成功しても滞留は解消しない。追いつくには、人員を増やす、一時的にサービスを縮小する、回答時期を率直に延ばす必要があるかもしれない。
別の数値例を考えてみよう。1時間に24件の依頼が届き、処理が30分止まれば、12件が待ち状態になる。その後、窓口が1時間に36件を処理する一方、新しい依頼が引き続き24件ずつ届くなら、滞留分の解消には1時間かかる。これらは説明用の仮定であり、Claudeの障害に関する測定値ではない。
Googleのサービスレベル目標に関する指針は、利用者にとって重要な成果と、その提供に必要な依存関係から考えることを勧めている。この窓口なら、約束した時間内に適切な対応を受けた緊急案件の割合が有用な指標になる。提供者の稼働状況も重要だが、顧客がサービスを受けたかを会社自身も把握しなければならない。Google SRE:サービスレベル目標の実装
通常の顧客サービスが再開した時刻、未解決の案件数、その後必要になった訂正を記録する。こうした指標なら、提供者のステータスページでは把握できない復旧作業も見える。
自動化を広げる前に、障害を一度リハーサルする
短い机上演習なら、実際の顧客に影響を与えずに、アクセスや責任者の不足を見つけられる。架空のサポート案件をいくつか使い、次の流れを確認しよう。
- 返信の準備中にモデルが利用不能になったとする。誰が縮小サービスを有効にし、スタッフはどこで元の依頼を見つけるか。
- 一つは送信済みと確認された返信、もう一つは送信を試みたが結果が不確実な案件にする。結果を確認できるシステムをチームが知っているか確かめる。
- 新しい案件が届き続ける間に、提供者が復旧したと仮定する。どの作業を先に再開し、手作業で完了した案件をどう滞留分から除くか決める。
- 計画を作成した本人以外の人に手順を説明してもらい、足りない権限や記録を特定してもらう。
演習で答えられなかったことを書き残そう。必要な修正は、既存の待ち行列へのアクセス、明確な一時停止操作、保存済みの確認情報、復旧担当者の任命といった小さなものかもしれない。どれも停止しないサービスを保証するわけではない。それでも、自動化の利点を捨てずに、障害を封じ込めやすくできる。
アシスタントに次の業務責任を与える前に、障害時にその責任をどう扱うか同僚に実演してもらおう。利用できなくなったアシスタントの記憶に頼らなければ手順を説明できないなら、継続計画にはまだ対応すべき点がある。