A grande mudança
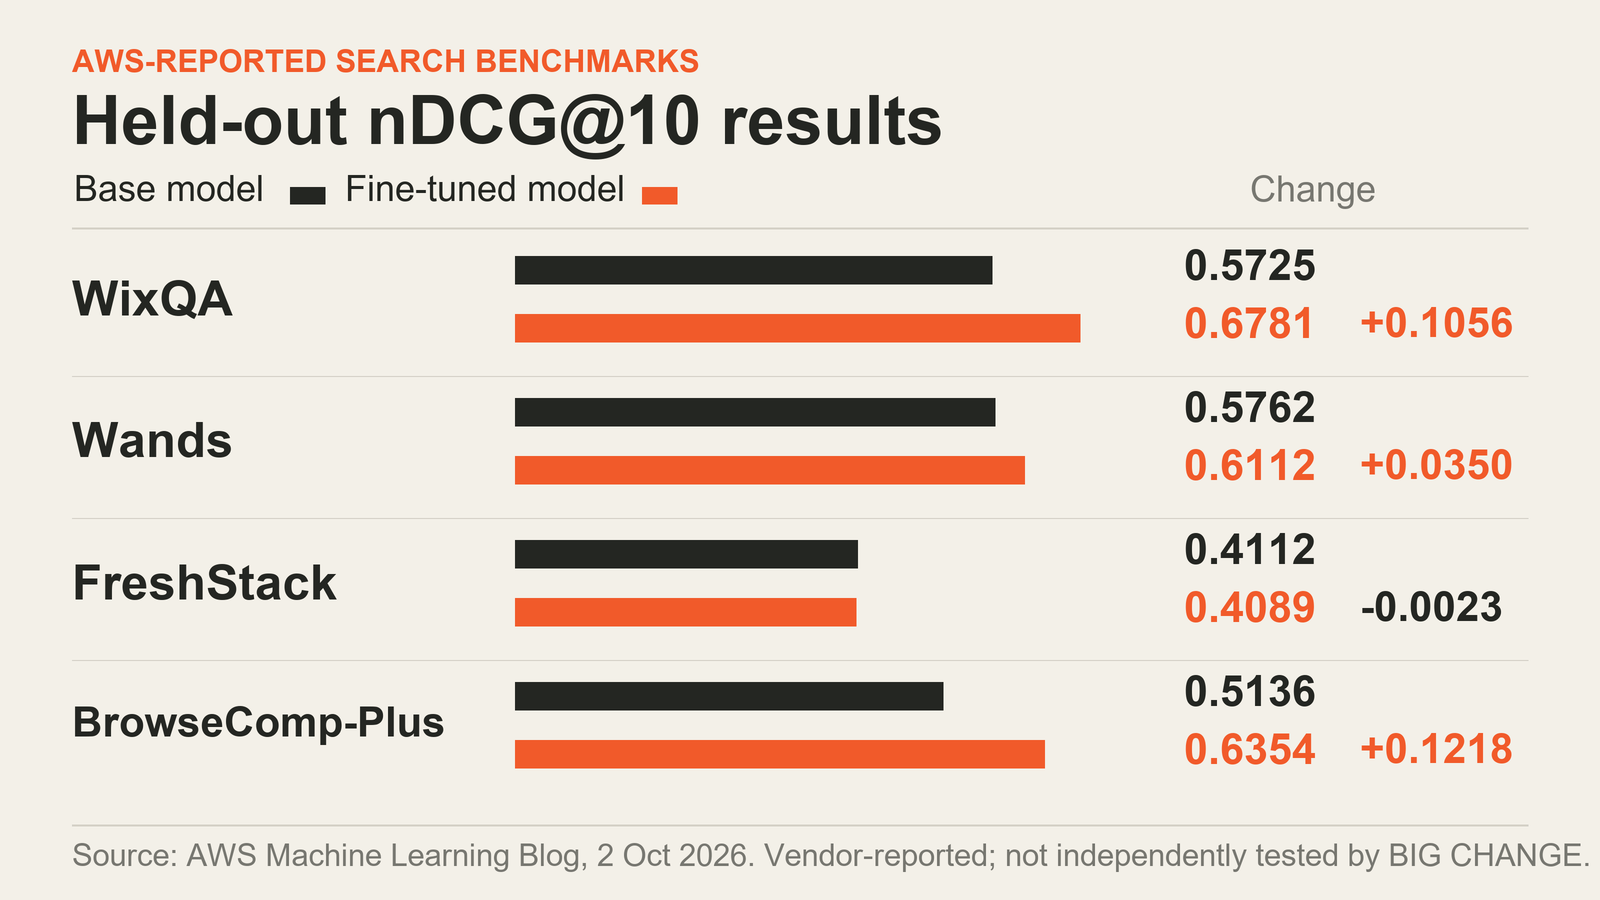
Na sua demonstração de 2 de outubro, a AWS descreve o ajuste fino de um agente de pesquisa Qwen3.6-27B através de aprendizagem por reforço multi-turno (MTRL) no SageMaker AI. O gráfico acima apresenta os valores nDCG@10 comunicados pela AWS para testes reservados: subiram no WixQA, no Wands e no BrowseComp-Plus, e desceram ligeiramente no FreshStack. A BIG CHANGE criou o gráfico com os valores da AWS; não testámos o agente de forma independente nem reproduzimos os resultados. A técnica treina um modelo com base no resultado de uma sequência de decisões que utilizam ferramentas.
Antes de submeter uma tarefa, um engenheiro de aprendizagem automática tem de confirmar que o modelo e a região são compatíveis, que o agente pode participar no ciclo de execução do SageMaker, que as instruções e as recompensas representam a tarefa de pesquisa pretendida e que um conjunto de avaliação separado consegue revelar regressões. Este guia baseia-se na documentação da AWS; a BIG CHANGE não executou uma tarefa na AWS nem chamou as respetivas APIs.
O que altera o MTRL no ciclo de treino
No ajuste fino supervisionado, uma equipa precisa de trajetórias de exemplo que demonstrem o comportamento desejado. Na descrição da AWS sobre o MTRL, o SageMaker envia instruções a um agente; este chama o modelo de política e as respetivas ferramentas ao longo de vários turnos e, no fim da execução, comunica uma recompensa. O modelo é atualizado com base nesse retorno. Na pesquisa, uma recompensa pode pontuar a classificação final, pelo que as primeiras escolhas de consulta são otimizadas tendo em conta todo o episódio de pesquisa.
Esta distinção é importante quando as chamadas a ferramentas dependem de resultados anteriores. Se o modelo fizer uma primeira consulta fraca, obtiver resultados pouco úteis e tiver de reformular a pesquisa, uma recompensa atribuída no final da tarefa pode refletir se a sequência conseguiu recuperar documentos relevantes. Isso não elimina a necessidade de definir o que significa «relevante» nem de criar um agente capaz de chamar as ferramentas de pesquisa da equipa.
Verifique primeiro o acesso, o modelo e a região
O exemplo de 2 de outubro foi executado na região US West (Oregon), us-west-2, e ajustou o Qwen3.6-27B. A tabela de modelos compatíveis com o SageMaker MTRL, consultada a 4 de outubro de 2026, lista quatro modelos em seis combinações de modelo e região: Nova Lite 2.0 e GPT-OSS-20B em US East (N. Virginia), us-east-1, e US West (Oregon), us-west-2; Gemma-4-31B-it e Qwen 3.6 27B apenas no Oregon. Confirme a tabela atualizada na região onde pretende criar a tarefa; a listagem de um modelo não confirma a sua disponibilidade noutras regiões.
A equipa também precisa de uma conta AWS e de um domínio SageMaker Studio, se utilizar a interface do Studio, de acesso ao S3 para conjuntos de dados e resultados, e de funções IAM configuradas para as novas chamadas de tarefa MTRL e de runtime. O documento de pré-requisitos da AWS indica que o utilizador tem de ter CreateJob e as ações relacionadas com tarefas, bem como autorização para transmitir a função de execução a job.sagemaker.amazonaws.com. A função de execução precisa da política AmazonSageMakerJobFullAccess e desse principal de serviço na respetiva política de confiança. A função de runtime do agente precisa de AmazonSageMakerJobRuntimeAccess; um runtime do AgentCore também requer a sua própria relação de confiança. O seletor de runtime do Studio precisa de permissões de listagem do AgentCore. Segundo a AWS, o acesso geral ao SageMaker já existente não inclui todas estas novas ações de tarefa.
Há dois percursos documentados para o agente. Para alojamento gerido, implemente-o com o Bedrock AgentCore, que, segundo a AWS, funciona melhor com agentes criados com Strands; em alternativa, aloje um agente personalizado e ligue-o através de um encaminhador Lambda. O agente recebe as instruções de execução, chama o modelo de política através do runtime de tarefas do SageMaker, invoca as suas ferramentas de pesquisa, conclui cada execução e comunica uma recompensa. O decorador SDK da AWS trata de grande parte desta integração; frameworks personalizados podem chamar diretamente as APIs de runtime. Se a função Lambda tiver um nome não convencional, a AWS diz que poderá ser necessário acrescentar explicitamente o respetivo ARN à política de permissões. Uma VPC ou uma chave KMS gerida pelo cliente acrescenta outros requisitos de configuração.
Prepare as instruções e a recompensa para a tarefa de pesquisa real
O guia de recursos do SageMaker aceita Parquet, JSON Lines, JSON ou CSV. Procura uma coluna com o nome prompt, e, se não existir, utiliza a primeira coluna e transmite esse valor ao agente tal como está. O serviço não analisa, valida nem transforma o conteúdo das instruções. Na pesquisa com ferramentas, a instrução pode incluir mensagens de conversa, metadados da tarefa, uma especificação da recompensa e a configuração das ferramentas no formato esperado pelo agente. A AWS alerta que as instruções são transmitidas sem inspeção, pelo que as equipas continuam responsáveis por proteger dados sensíveis; a encriptação ou outra proteção adequada deve ser integrada no armazenamento e no percurso do agente.
A recompensa é o objetivo que o modelo irá otimizar. O exemplo da AWS utiliza nDCG@10 nos documentos recuperados no final e atribui uma recompensa de -1 se o agente atingir o limite de turnos ou de tokens de amostragem. É um ponto de partida concreto para uma tarefa de recuperação ordenada, mas torna consequentes as escolhas de avaliação: as equipas precisam de rótulos de relevância fiáveis ou de outro método de pontuação defensável e devem verificar se a recompensa não favorece melhorias superficiais na classificação, prejudicando a qualidade das respostas, a latência ou o custo das ferramentas.
A publicação do blogue diz que a mistura de treino incluía FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique e MLQA, reservando para validação 5% das instâncias de treino de cada conjunto de dados. O conjunto de teste reservado incluía FreshStack, WixQA, BrowseComp-Plus e Wands. Estes conjuntos de dados públicos ou sintéticos não substituem a avaliação no corpus privado e na distribuição de consultas que a equipa pretende disponibilizar.
Submeta uma tarefa pequena e inspecionável
O blogue da AWS de 2 de outubro utiliza uma importação do SDK e nomes de argumentos diferentes no respetivo excerto de código. A referência atual de tarefas de treino do SageMaker apresenta a seguinte estrutura de API para um runtime do Bedrock AgentCore. O exemplo utiliza o identificador de modelo GPT-OSS-20B atualmente documentado pela AWS; escolha um modelo disponível na região de destino e consulte a tabela atualizada de modelos compatíveis antes de o adaptar. O exemplo atual também requer um ARN de aplicação MLflow, um ARN de função e a aceitação do EULA.
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
Este é o exemplo da documentação atual da AWS, não um comando testado pela BIG CHANGE. O blogue da AWS de 2 de outubro apresenta argumentos diferentes para sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri e output_s3_uri. Como diferem do guia atual das tarefas, siga a referência atual para novas implementações e confirme a versão do SDK e os requisitos do modelo no seu ambiente; não determinámos se o exemplo do blogue corresponde a uma versão anterior do SDK ou a uma inconsistência da documentação. A interface do Studio é outro percurso documentado para submissão: escolha um modelo JumpStart compatível, selecione Multi-Turn Reinforcement Learning, configure o runtime do AgentCore ou o encaminhador Lambda, indique os dados de treino e submeta.
Na primeira execução, registe o modelo, a região, a versão do conjunto de dados, a recompensa, os limites, os hiperparâmetros e o caminho de saída, para que uma avaliação posterior possa ser comparada com a mesma referência. Se utilizar uma VPC gerida pelo cliente, o guia VPC separado da AWS especifica sub-redes privadas em duas zonas de disponibilidade, endpoints VPC para S3 e CloudWatch Logs, além de um endpoint AgentCore ou Lambda, conforme aplicável; o MLflow também precisa de um endpoint, quando utilizado. A função de execução precisa de permissões de gestão de ENI. O percurso opcional com KMS gerido pelo cliente exige permissões adicionais e a configuração da política da chave para o utilizador, a função de execução e o runtime; por predefinição, os dados em repouso são encriptados com KMS da AWS. Consulte os guias de VPC e encriptação antes de utilizar qualquer uma destas configurações. Antes da submissão, verifique as quotas da conta: por predefinição, a AWS permite uma tarefa de ajuste fino MTRL e uma tarefa de avaliação simultâneas; ambas podem ser aumentadas através de Service Quotas. Os limites de estrangulamento das APIs de gestão de tarefas não podem ser alterados.
Avalie com instruções reservadas antes da implementação
A documentação de avaliação da AWS recomenda manter as instruções de avaliação fora do treino, usar o mesmo formato de instrução, cobrir ferramentas importantes e combinações de ferramentas, incluir casos que falharam anteriormente e proteger conteúdo sensível. O avaliador do SageMaker pode executar uma versão candidata contra um conjunto de instruções e comunicar a recompensa, pass@k e métricas das trajetórias. A documentação demonstra a avaliação de um modelo ajustado e, opcionalmente, do modelo de base no mesmo fluxo de comparação.
Defina o protocolo de avaliação antes do treino. Mantenha um conjunto fixo, reservado e representativo das consultas, permissões e alterações documentais que o agente encontrará em produção. Compare os modelos de base e ajustado com as mesmas ferramentas, limites e código de pontuação. Analise não só a pontuação média de recuperação, mas também as falhas das tarefas, o número de turnos, a latência, a utilização de tokens e os casos em que documentos relevantes desaparecem das primeiras posições. A documentação explica como submeter uma tarefa de avaliação da AWS; não demonstra que uma única métrica represente toda a qualidade da pesquisa em produção.
A publicação da AWS apresenta estes resultados de teste reservado:
Conjunto de dados (perguntas) | nDCG@10 de base | nDCG@10 após ajuste fino | Taxa de falha de base | Taxa de falha após ajuste fino |
|---|---|---|---|---|
WixQA (400) | 0,5725 | 0,6781 | 0,67% | 0,17% |
Wands (147) | 0,5762 | 0,6112 | 0,00% | 0,00% |
FreshStack (672) | 0,4112 | 0,4089 | 0,20% | 0,05% |
BrowseComp-Plus (830) | 0,5136 | 0,6354 | 22,89% | 0,68% |
A tabela mostra aumentos de nDCG@10 em três conjuntos e uma pequena descida no FreshStack. A AWS atribui a menor taxa de falha no BrowseComp-Plus à penalização por atingir os limites de turnos ou tokens. O blogue não apresenta intervalos de confiança nem uma análise de significância estatística juntamente com estes valores. Também refere que o modelo ajustado utilizou uma média de 4,5 contra 4,3 turnos no WixQA e de 2,9 contra 2,2 no Wands; por isso, o número de turnos não diminuiu em todos os casos. Considere isto uma experiência comunicada pelo fornecedor, não uma validação independente nem prova de que o desempenho irá melhorar noutro corpus.
Orçamente o ensaio completo
A documentação MTRL da AWS descreve três dimensões de cobrança do treino: tokens de prefill processados como entradas, tokens amostrados gerados durante as execuções e atualizações do treino. A página de preços apresenta tarifas específicas por modelo; essas tarifas e o volume de execuções da equipa, o comprimento das sequências, o número de épocas e o runtime determinam a estimativa. O artigo de exemplo não publica o custo total, e a documentação não indica um preço universal para um ensaio. Consulte a tarifa atual do modelo e da região escolhidos e estime o custo com base na utilização prevista da tarefa, em vez de assumir um valor fixo.
Inclua na estimativa os custos associados: armazenamento e pedidos S3 para treino, validação, checkpoints e artefactos de saída; o runtime do AgentCore ou Lambda e qualquer infraestrutura de pesquisa de apoio durante as execuções; registos e MLflow; avaliação com dados reservados; e qualquer endpoint ou implementação no Bedrock após o treino. A publicação da AWS recomenda especificamente parar ou eliminar uma tarefa MTRL em execução, apagar os artefactos de modelo S3 desnecessários e remover endpoints de avaliação para evitar cobranças continuadas. A implementação num endpoint é uma decisão e uma categoria de custo separadas do treino.
Decida se deve avançar
Este fluxo de trabalho é mais relevante quando a tarefa de pesquisa exige várias chamadas a ferramentas dependentes entre si e a equipa consegue pontuar o resultado final. Um ensaio só é útil para a tomada de decisões se houver uma combinação compatível de modelo e região, integração funcional do agente, dados de instrução representativos, uma recompensa adequada à tarefa, uma comparação com dados reservados e uma estimativa de custos que inclua os serviços adjacentes. Um resultado forte nos quatro testes da AWS é motivo para analisar o método, não para presumir o mesmo efeito noutro índice, mistura de consultas ou limite de permissões.
Fontes e leituras complementares
- Blogue de Machine Learning da AWS: «Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI» (2 de outubro de 2026) — o guia prático do fornecedor, a configuração, as escolhas de conjuntos de dados e os resultados de avaliação divulgados.
- Amazon SageMaker AI: Aprendizagem por reforço multi-turno — modelos e regiões compatíveis atuais e dimensões de cobrança do treino.
- Pré-requisitos, Preparar o seu agente, Configuração de VPC e encriptação em repouso — permissões, opções de runtime, integração e configuração opcional de rede e encriptação.
- Criar recursos, submeter uma tarefa de treino, avaliação, hiperparâmetros e quotas — referências atuais de implementação.
- Preços do SageMaker AI — preços atuais da personalização de modelos; as tarifas podem mudar e variam consoante o modelo e a região.
Nota de reportagem: apenas revisão da documentação. A BIG CHANGE não acedeu a uma conta AWS, não submeteu nem inspecionou uma tarefa do SageMaker, não chamou APIs da AWS nem reproduziu de forma independente as métricas comunicadas. A AWS criou o guia de implementação e relata a sua própria experiência.