核心變化
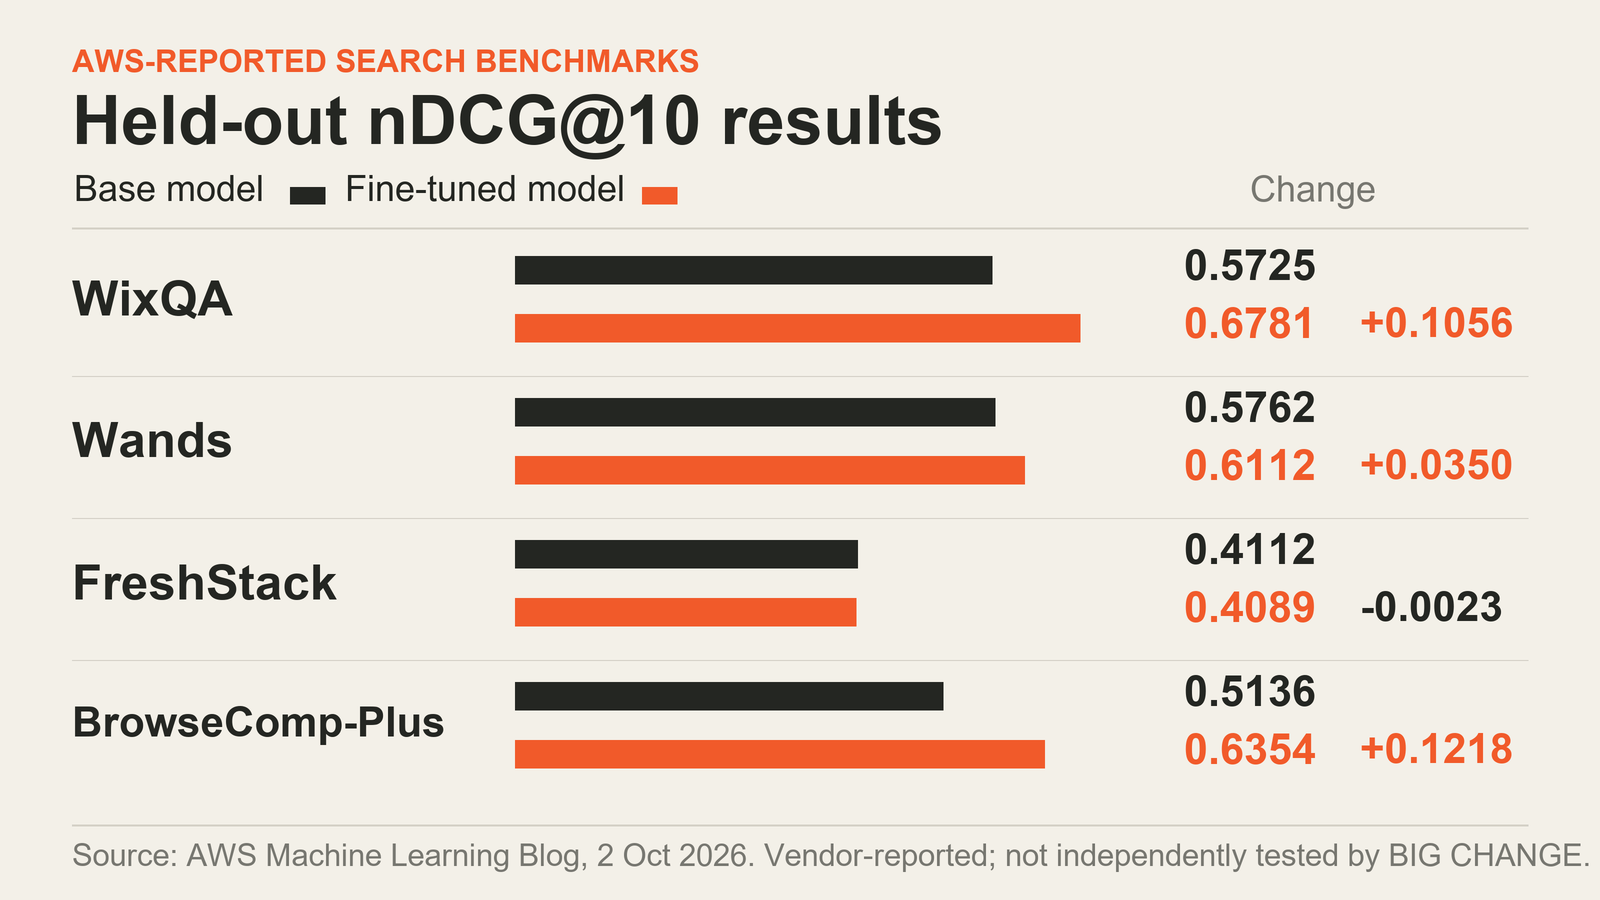
在10 月 2 日的操作指南中,AWS 說明如何在 SageMaker AI 使用多輪強化學習(MTRL),微調 Qwen3.6-27B 搜尋代理。上方圖表呈現 AWS 公布的留出集 nDCG@10 分數:WixQA、Wands 和 BrowseComp-Plus 的分數上升,FreshStack 則略微下降。圖表由 BIG CHANGE 根據 AWS 提供的數據製作;我們未獨立測試該代理,也未重現這些結果。這項技術根據一連串工具操作的結果訓練模型。
提交工作前,機器學習工程師需要確認模型與區域受到支援、代理可參與 SageMaker 的 rollout 迴圈、提示與獎勵能代表預定的搜尋任務,且另有一組評估資料可揭露退步之處。本指南根據 AWS 文件編寫;BIG CHANGE 未執行 AWS 工作,也未呼叫其 API。
MTRL 如何改變訓練迴圈
監督式微調需要團隊提供展示目標行為的範例軌跡。AWS 對 MTRL 的說明則是:SageMaker 將提示傳給代理,代理透過多輪操作呼叫策略模型與工具,並在 rollout 完成後回報獎勵;模型再根據這項回饋更新。對搜尋任務而言,獎勵可以評分最終排名,讓模型依整個搜尋過程的結果來最佳化早期的查詢選擇。
當工具呼叫取決於先前結果時,這項差異就很重要。如果模型的第一個查詢不理想、看到的結果不佳,理應重新措辭查詢,那麼任務結束時給予的獎勵可以反映整個序列最終是否找回相關文件。但這不會免除團隊界定「相關」的責任,也不能取代能呼叫團隊搜尋工具的代理。
先確認存取權、模型與區域
AWS 10 月 2 日的範例在美國西部(奧勒岡)執行,us-west-2,並微調 Qwen3.6-27B。現行的SageMaker MTRL 支援模型表於 2026 年 10 月 4 日查閱,列出四種模型,共有六種模型與區域組合:Nova Lite 2.0 和 GPT-OSS-20B 可在美國東部(北維吉尼亞)us-east-1,以及美國西部(奧勒岡)us-west-2使用;Gemma-4-31B-it 和 Qwen 3.6 27B 僅限奧勒岡。請在預定建立工作的區域查閱即時支援表;某模型列於表中,不代表其他區域也能使用。
如果使用 Studio 介面,團隊還需要 AWS 帳戶與 SageMaker Studio 網域、存取 S3 資料集與輸出的權限,以及已為新版 MTRL 工作和執行階段呼叫設定好的 IAM 角色。AWS 的先決條件文件指出,呼叫者需要CreateJob以及相關工作操作的權限,並須獲准將執行角色傳遞給job.sagemaker.amazonaws.com。執行角色需要AmazonSageMakerJobFullAccess政策,且其信任政策須包含該服務主體。代理執行階段角色需要AmazonSageMakerJobRuntimeAccess;AgentCore 執行階段也需要自己的信任關係。Studio 的執行階段選擇器需要 AgentCore 列表權限。AWS 表示,既有的廣泛 SageMaker 存取權本身並不涵蓋這些新增的工作操作。
文件列出兩種代理途徑。可透過 Bedrock AgentCore 部署並採用代管託管;AWS 表示,此方式最適合以 Strands 建置的代理。另一種方式是自行託管代理,再透過 Lambda 轉送函式橋接。代理會接收 rollout 提示,透過 SageMaker 工作執行階段呼叫策略模型、使用搜尋工具、完成每個 rollout,並回報獎勵。AWS 的 SDK 裝飾器會處理大部分整合作業;自訂框架也可直接呼叫執行階段 API。如果 Lambda 函式使用非標準名稱,AWS 表示可能需要在權限政策中明確加入其 ARN。使用客戶管理的 VPC 或 KMS 金鑰,還會增加其他設定需求。
為實際搜尋任務準備提示與獎勵
SageMaker 的資產指南接受 Parquet、JSON Lines、JSON 或 CSV。服務會尋找名為prompt的欄位;若沒有,就使用第一欄,並將欄位值原樣傳給代理。服務不會剖析、驗證或轉換提示內容。對使用工具的搜尋任務,提示可依代理預期的格式,包含對話訊息、任務中繼資料、獎勵規格和工具設定。AWS 提醒,提示會未經檢查直接傳遞,因此團隊仍須負責保護敏感資料;應在儲存與代理處理流程中設計加密或其他合適的防護措施。
獎勵是模型要最佳化的目標。AWS 範例會使用最終取回文件的 nDCG@10,並在代理達到輪次或抽樣 token 上限時給予 -1 獎勵。這為排序檢索任務提供了具體的起始設計,但也使評估選擇格外重要:團隊需要可靠的相關性標籤或其他可辯護的評分方法,並應檢查獎勵是否會偏好表面上的排名提升,卻損害答案品質、延遲或工具成本。
部落格文章表示,其訓練資料組合包括 FRAMES、BRIGHT、Enterprise RAG、ESCI、Musique 和 MLQA,每個資料集有 5% 的訓練樣本保留作為驗證資料。留出測試集則包含 FreshStack、WixQA、BrowseComp-Plus 和 Wands。這些公開或合成資料集不能取代團隊針對預定服務的私有語料庫及查詢分布所做的評估。
提交規模小且便於檢查的工作
這份AWS 10 月 2 日的部落格文章程式碼片段使用了不同的 SDK 匯入方式與參數名稱。現行的SageMaker 訓練工作參考文件列出 Bedrock AgentCore 執行階段目前採用的 API 格式。此範例使用 AWS 現行文件所列的 GPT-OSS-20B 模型識別碼;請選擇目標區域可用的模型,並在改寫範例前查閱即時支援模型表。現行範例也要求提供 MLflow 應用程式 ARN、角色 ARN 並接受 EULA。
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
這是 AWS 現行文件中的範例,並非經 BIG CHANGE 測試的指令。AWS 10 月 2 日的部落格文章使用不同的sagemaker.modules.train 匯入、model_id、agent_endpoint、training_dataset_s3_uri以及output_s3_uri引數。由於這些引數與現行工作指南不同,新實作應遵循現行參考文件,並在自己的環境中確認 SDK 版本及模型需求;我們尚未確認部落格範例反映的是舊版 SDK,或是文件不一致。Studio UI 也是文件列出的提交方式:選取受支援的 JumpStart 模型、選擇 Multi-Turn Reinforcement Learning、設定 AgentCore 執行階段或 Lambda 轉送函式、提供訓練資料並提交。
首次執行時,請記錄模型、區域、資料集版本、獎勵、限制、超參數和輸出路徑,以便之後使用相同基準比較評估結果。如果使用客戶管理的 VPC,AWS 的獨立 VPC 指南規定須在兩個可用區建立私有子網、為 S3 和 CloudWatch Logs 設定 VPC 端點,並視情況設定 AgentCore 或 Lambda 端點;使用 MLflow 時也需要相應端點。執行角色需要管理 ENI 的權限。選用客戶管理的 KMS 設定時,呼叫者、執行角色和執行階段還需要額外權限及金鑰政策設定;預設則使用 AWS 管理的 KMS 靜態加密。採用任一設定前,請查閱 VPC 與加密指南。提交前也要檢查帳戶配額:AWS 列出的預設值為同時執行一個 MTRL 微調工作及一個評估工作,兩者均可透過 Service Quotas 調整。工作管理 API 的節流限制則無法調整。
部署前先以留出提示進行評估
AWS 評估文件建議評估提示不要納入訓練、提示格式應保持一致、涵蓋重要工具及工具組合、納入先前失敗的案例,並保護敏感內容。SageMaker 評估器可以用提示集測試候選模型,並回報獎勵、pass@k 和軌跡指標。文件示範了如何評估微調後的模型,也可選擇在同一比較流程中評估基礎模型。
訓練前先訂好評估規程。保留固定的留出集,代表實際代理將面對的查詢、權限和文件變動。基礎模型與微調模型應使用相同工具、限制和評分程式碼進行比較。除了平均檢索分數,也要檢查任務失敗、輪次、延遲、token 用量,以及相關文件從排名前列消失的案例。文件說明如何提交 AWS 評估工作,但並未證明任何單一指標足以代表正式環境中的搜尋品質。
AWS 公布的留出集結果如下:
資料集(問題數) | 基礎模型 nDCG@10 | 微調模型 nDCG@10 | 基礎模型失敗率 | 微調模型失敗率 |
|---|---|---|---|---|
WixQA(400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands(147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack(672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus(830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
表中顯示,nDCG@10 在三項資料集上提升,在 FreshStack 上則小幅下降。AWS 將 BrowseComp-Plus 較低的失敗率歸因於:代理達到輪次或 token 上限時會受到懲罰。部落格文章並未同時提供這些數據的信賴區間或統計顯著性分析。文章也指出,微調模型在 WixQA 平均使用 4.5 輪,基礎模型為 4.3 輪;在 Wands 則分別為 2.9 輪與 2.2 輪,因此輪次並非全面減少。應將此結果視為供應商公布的實驗,而非獨立驗證,也不能據此認定其他語料庫會有相同改善。
估算整體試用成本
AWS 的 MTRL 文件說明三項訓練費用:處理作為輸入的 prefill token、rollout 期間產生的 sampled token,以及模型訓練更新。定價頁列出各模型費率;費率與團隊的 rollout 數量、序列長度、訓練 epoch 和執行時間共同決定估算金額。範例文章未公布總帳單,文件也沒有提供適用所有情況的單一試用價格。請查詢所選模型與區域的現行費率,並依預期工作用量估算,不要假設成本固定。
估算時也要納入周邊費用:訓練、驗證、檢查點與輸出產物所用的 S3 儲存和請求;rollout 期間的 AgentCore 執行階段或 Lambda,以及支援搜尋的基礎設施;記錄與 MLflow;留出集評估;以及訓練後使用的任何端點或 Bedrock 部署。AWS 的文章特別建議停止或刪除執行中的 MTRL 工作、刪除不再需要的 S3 模型產物,並移除評估端點,以免持續產生費用。部署端點屬於與訓練不同的決策與成本類別。
決定是否繼續
當搜尋任務需要多次相依的工具呼叫,而且團隊能為最終結果評分時,這套流程最值得考慮。只有在模型與區域組合受支援、代理整合可正常運作、提示資料具代表性、獎勵能反映任務、有留出集比較,而且估算涵蓋周邊服務成本的情況下,試用結果才足以支持決策。AWS 的四項基準取得好成績,值得進一步檢視其方法,但不能據此假設在不同索引、查詢組合或權限邊界下也會有相同效果。
資料來源與延伸閱讀
- AWS Machine Learning Blog:「在 Amazon SageMaker AI 以多輪強化學習微調搜尋代理」(2026 年 10 月 2 日) — 供應商提供的操作指南、設定方式、資料集選擇及評估結果。
- Amazon SageMaker AI:多輪強化學習 — 現行支援模型、區域及計費項目。
- 先決條件、準備代理、VPC 設定及靜態加密 — 權限、執行階段選項、整合方式,以及選用的網路與加密設定。
- 建立資產、提交訓練工作、評估、超參數及配額 — 現行實作參考資料。
- SageMaker AI 定價 — 現行模型自訂定價資訊;費率可能變動,並依模型與區域而異。
報導說明:本文僅檢視文件。BIG CHANGE 未登入 AWS 帳戶、提交或檢視 SageMaker 工作、呼叫 AWS API,也未獨立重現所公布的指標。實作指南由 AWS 撰寫,實驗結果亦由 AWS 公布。