పెద్ద మార్పు
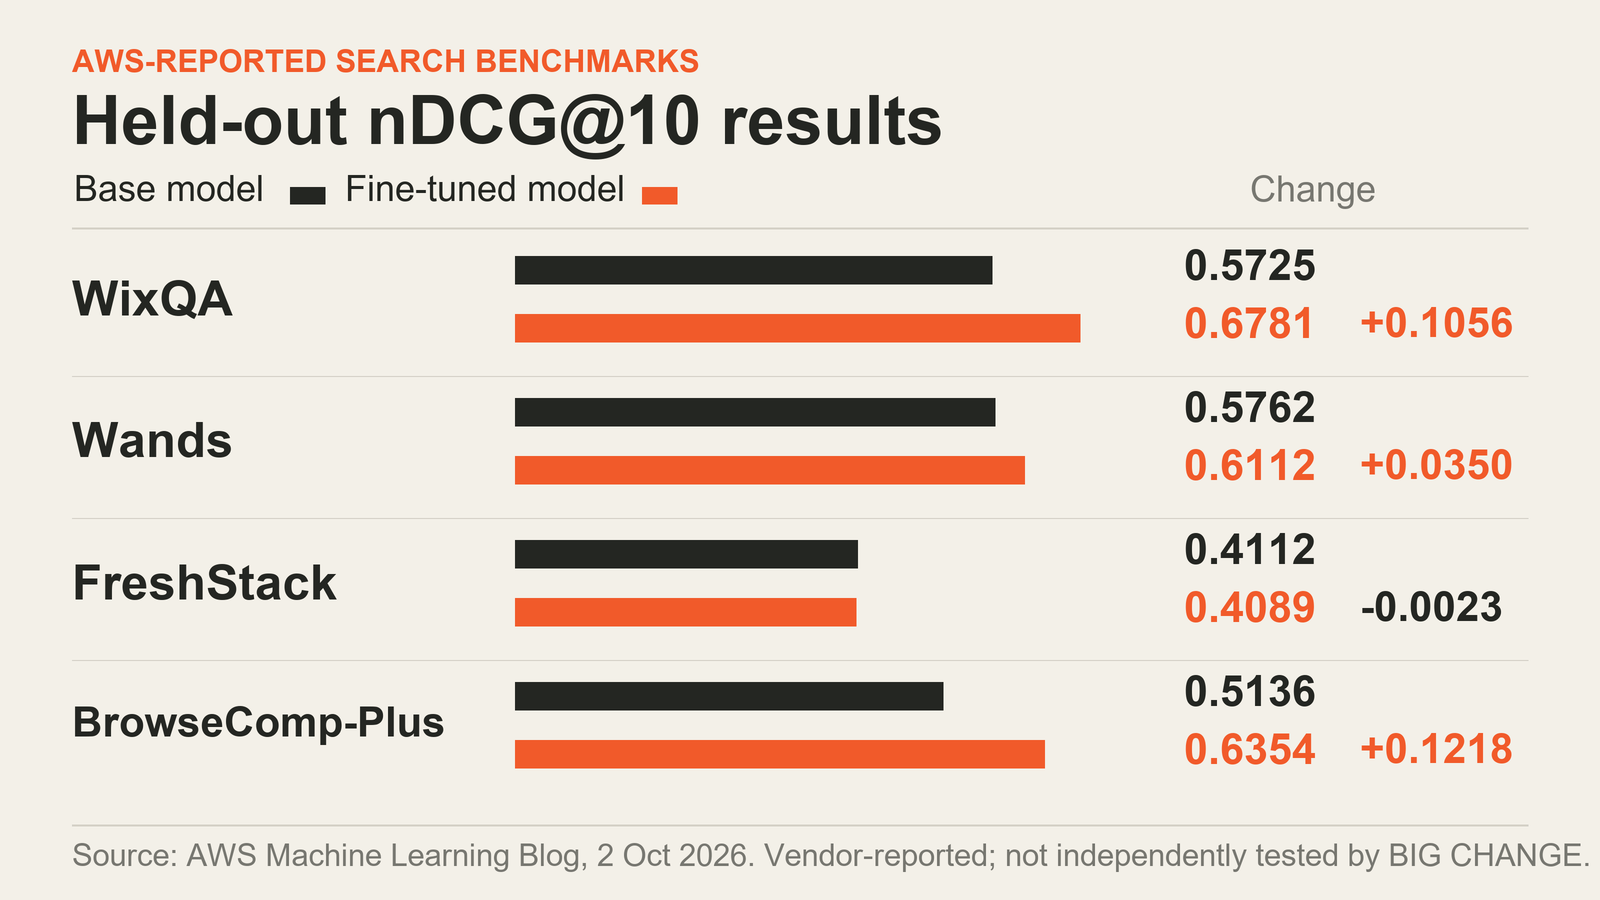
తన అక్టోబర్ 2 వివరణలో, సేజ్మేకర్ ఏఐలో బహుళ-దశ రీఇన్ఫోర్స్మెంట్ లెర్నింగ్ (MTRL)తో Qwen3.6-27B శోధన ఏజెంట్కు ఫైన్-ట్యూనింగ్ చేసినట్లు AWS వివరిస్తుంది. పై గ్రాఫ్లో నిలిపి ఉంచిన పరీక్షా సమితిపై AWS నివేదించిన nDCG@10 స్కోర్లు ఉన్నాయి: WixQA, Wands, BrowseComp-Plusలో పెరిగాయి; FreshStackలో స్వల్పంగా తగ్గాయి. AWS గణాంకాల ఆధారంగా గ్రాఫ్ను BIG CHANGE రూపొందించింది; మేము ఏజెంట్ను స్వతంత్రంగా పరీక్షించలేదు లేదా ఫలితాలను మళ్లీ ఉత్పత్తి చేయలేదు. సాధనాలను ఉపయోగించే నిర్ణయాల వరుస ఫలితానికి అనుగుణంగా మోడల్కు శిక్షణ ఇవ్వడమే ఈ సాంకేతికత.
పని సమర్పించే ముందు, మోడల్, ప్రాంతానికి మద్దతు ఉందని, సేజ్మేకర్ rollout loopలో ఏజెంట్ పాల్గొనగలడని, promptలు, rewardలు ఉద్దేశించిన శోధన పనిని ప్రతిబింబిస్తాయని, వేరొక మూల్యాంకన సమితి వెనుకడుగులను బయటపెట్టగలదని మెషీన్ లెర్నింగ్ ఇంజినీర్ నిర్ధారించాలి. ఈ మార్గదర్శిని AWS పత్రాలపై ఆధారపడింది; BIG CHANGE AWS పని నడపలేదు లేదా దాని APIలను పిలవలేదు.
శిక్షణ చక్రంలో MTRL చేసే మార్పు
పర్యవేక్షిత ఫైన్-ట్యూనింగ్లో, కావలసిన ప్రవర్తనను చూపే ఉదాహరణలతో కూడిన trajectories బృందానికి అవసరం. MTRLపై AWS వివరణ ప్రకారం, బదులుగా సేజ్మేకర్ promptలను ఏజెంట్కు పంపుతుంది; ఏజెంట్ policy model, సాధనాలను అనేక దశల్లో పిలుస్తుంది; పూర్తయిన rolloutకు rewardను నివేదిస్తుంది. ఆ స్పందన ఆధారంగా మోడల్ను నవీకరిస్తారు. శోధనలో, చివరి rankingకు reward ఇవ్వవచ్చు; అప్పుడు మొదటి query ఎంపికలూ మొత్తం శోధన ప్రక్రియ సందర్భంలో ఆప్టిమైజ్ అవుతాయి.
సాధన పిలుపులు మునుపటి ఫలితాలపై ఆధారపడినప్పుడు ఈ తేడా ముఖ్యం. మోడల్ మొదటి queryని సరిగా ఎంచుకోక, బలహీన ఫలితాలు చూసి మళ్లీ query రూపొందించాల్సి వస్తే, చివర్లో ఇచ్చే reward మొత్తం ప్రక్రియ సంబంధిత పత్రాలను తిరిగి పొందిందా అని కొలవగలదు. అయితే “సంబంధితం” అంటే ఏమిటో నిర్వచించాల్సిన అవసరం పోదు; బృందం శోధన సాధనాలను పిలవగల ఏజెంట్ను కూడా నిర్మించాలి.
ప్రాప్యత, మోడల్, ప్రాంతాన్ని ముందుగా పరిశీలించండి
అక్టోబర్ 2 ఉదాహరణ US West (Oregon) ప్రాంతంలో నడిచింది, us-west-2, Qwen3.6-27Bకు ఫైన్-ట్యూనింగ్ చేసింది. సేజ్మేకర్ MTRL మద్దతు ఉన్న మోడళ్ల పట్టిక (2026 అక్టోబర్ 4న పరిశీలించబడింది) ఆరు మోడల్-ప్రాంత జతల్లో నాలుగు మోడళ్లను జాబితా చేస్తుంది: Nova Lite 2.0, GPT-OSS-20B మోడళ్లు US East (N. Virginia), us-east-1 మరియు US West (Oregon), us-west-2; Gemma-4-31B-it, Qwen 3.6 27B మాత్రం Oregonలో మాత్రమే. పని సృష్టించాలనుకుంటున్న ప్రాంతంలోని తాజా పట్టికను నిర్ధారించండి; ఒక ప్రాంతంలో మోడల్ జాబితా కావడం మరోచోటా అందుబాటులో ఉందని నిరూపించదు.
స్టూడియో ఇంటర్ఫేస్ వాడితే AWS ఖాతా, సేజ్మేకర్ స్టూడియో domain, డేటా, అవుట్పుట్ల కోసం S3 ప్రాప్యత, కొత్త MTRL job, runtime పిలుపులకోసం అమర్చిన IAM పాత్రలూ బృందానికి అవసరం. AWS ముందస్తు అవసరాల పత్రం ప్రకారం, పిలిచే వినియోగదారుకు CreateJob మరియు సంబంధిత job చర్యలతో పాటు, అమలు పాత్రను job.sagemaker.amazonaws.com. అమలు పాత్రకు AmazonSageMakerJobFullAccess policy, trust policyలో ఆ service principal అవసరం. ఏజెంట్ runtime పాత్రకు AmazonSageMakerJobRuntimeAccess కావాలి; AgentCore runtimeకు దాని స్వంత trust సంబంధమూ అవసరం. స్టూడియో runtime ఎంపికకు AgentCore list permissions కావాలి. AWS ప్రకారం, విస్తృత పాత SageMaker ప్రాప్యత ఒక్కటే ఈ కొత్త job చర్యలన్నింటినీ కలిగి ఉండదు.
ఏజెంట్కు రెండు పత్రబద్ధ మార్గాలున్నాయి. AWS ప్రకారం, Strandsతో నిర్మించిన ఏజెంట్లకు అనుకూలమైన నిర్వహిత hosting కోసం Bedrock AgentCoreలో deploy చేయవచ్చు; లేదా స్వంత ఏజెంట్ను host చేసి Lambda forwarder ద్వారా అనుసంధానించవచ్చు. ఏజెంట్ rollout promptలు స్వీకరిస్తుంది, job runtime ద్వారా policy modelను పిలుస్తుంది, శోధన సాధనాలను ఉపయోగిస్తుంది, ప్రతి rolloutను పూర్తి చేసి rewardను నివేదిస్తుంది. AWS SDK decorator ఈ అనుసంధానంలో అధిక భాగాన్ని నిర్వహిస్తుంది; స్వంత frameworkలు runtime APIలను నేరుగా పిలవవచ్చు. Lambda ఫంక్షన్కు ప్రామాణికం కాని పేరు ఉంటే, అనుమతి policyలో దాని ARNను స్పష్టంగా చేర్చాల్సి రావచ్చని AWS చెబుతోంది. కస్టమర్ నిర్వహించే VPC లేదా KMS key అదనపు అమరికను కోరుతుంది.
వాస్తవ శోధన పనికి సరిపోయే prompt, reward సిద్ధం చేయండి
సేజ్మేకర్ asset మార్గదర్శి Parquet, JSON Lines, JSON లేదా CSVను అంగీకరిస్తుంది. ఇది column పేరుగా promptreward అనేది మోడల్ ఆప్టిమైజ్ చేసే లక్ష్యం. AWS ఉదాహరణలో తిరిగి పొందిన తుది పత్రాలపై nDCG@10ను లెక్కించి, ఏజెంట్ turn లేదా sampling-token గరిష్ఠాన్ని తాకితే -1 reward ఇస్తుంది. ranking పనికి ఇది స్పష్టమైన ప్రారంభ రూపకల్పన; కానీ మూల్యాంకన ఎంపికలు కీలకం: నమ్మదగిన relevance labels లేదా సమర్థించగల వేరే స్కోరింగ్ విధానం అవసరం. reward వల్ల సమాధాన నాణ్యత, జాప్యం లేదా సాధనాల ఖర్చు దెబ్బతిన్నా, పైపై ranking మెరుగుదలకే ప్రాధాన్యం వస్తుందా అని పరిశీలించాలి.
reward అనేది మోడల్ మెరుగుపరచే లక్ష్యం. AWS ఉదాహరణలో చివరి పత్రాల rankingకు nDCG@10 లెక్కించి, ఏజెంట్ turn లేదా token పరిమితిని చేరితే -1 reward ఇస్తారు. ranked retrievalకు ఇది ఉపయోగకరమైన ఆరంభం. నమ్మదగిన relevance labels లేదా సమర్థనీయమైన మరో scoring పద్ధతి అవసరం. సమాధాన నాణ్యత, జాప్యం లేదా సాధన ఖర్చు దెబ్బతిన్నా పైపై ranking మెరుగుదలకే reward ప్రోత్సాహమిస్తుందా అని పరిశీలించండి.
బ్లాగ్ ప్రకారం, శిక్షణ మిశ్రమంలో FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique, MLQA ఉన్నాయి; ప్రతి datasetలోని శిక్షణ ఉదాహరణల్లో ఐదు శాతాన్ని validationకు కేటాయించారు. నిలిపి ఉంచిన పరీక్షా సమితిలో FreshStack, WixQA, BrowseComp-Plus, Wands ఉన్నాయి. ఈ బహిరంగ లేదా కృత్రిమ datasetలు, బృందం సేవలందించాలనుకునే ప్రైవేటు corpus, query పంపిణీపై పరీక్షకు ప్రత్యామ్నాయం కావు.
చిన్న, పరిశీలించగల jobను సమర్పించండి
అక్టోబర్ 2నాటి AWS బ్లాగ్ తన code snippetలో వేరే SDK import, argument పేర్లను ఉపయోగిస్తుంది. ప్రస్తుత SageMaker training-job సూచన Bedrock AgentCore runtimeకు కింది API ఆకృతిని చూపుతుంది. ఈ ఉదాహరణ AWS ప్రస్తుతంగా పత్రబద్ధం చేసిన GPT-OSS-20B model identifierను వాడుతుంది; లక్ష్య ప్రాంతంలో అందుబాటులో ఉన్న మోడల్ను ఎంచుకుని, దానికి అనుగుణంగా మార్చే ముందు తాజా మోడల్ మద్దతు పట్టికను పరిశీలించండి. ప్రస్తుత ఉదాహరణకు MLflow app ARN, role ARN, EULA అంగీకారమూ అవసరం.
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
ఇది ప్రస్తుత AWS పత్రాల్లోని ఉదాహరణ; BIG CHANGE పరీక్షించిన ఆదేశం కాదు. AWS అక్టోబర్ 2 బ్లాగ్ వేరే sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri మరియు output_s3_uri argumentలను చూపుతుంది. ప్రస్తుత job మార్గదర్శినితో ఇవి భిన్నంగా ఉన్నందున, కొత్త అమలుకు తాజా సూచనను అనుసరించి, మీ వాతావరణంలో SDK సంచిక, మోడల్ అవసరాలను నిర్ధారించండి. బ్లాగ్ ఉదాహరణ పాత SDK సంచికను ప్రతిబింబిస్తుందా, లేక పత్రాల్లో అసంగతత ఉందా అనేది మేము నిర్ధారించలేదు. స్టూడియో UI మరో పత్రబద్ధ సమర్పణ మార్గం: మద్దతు ఉన్న JumpStart మోడల్ను ఎంచుకుని, Multi-Turn Reinforcement Learningను ఎంచుకోండి; AgentCore runtime లేదా Lambda forwarder అమర్చి, శిక్షణ డేటా అందించి, submit చేయండి.
మొదటి ప్రయత్నానికి మోడల్, ప్రాంతం, dataset సంచిక, reward, పరిమితులు, hyperparameterలు, అవుట్పుట్ మార్గాన్ని నమోదు చేయండి; తదుపరి మూల్యాంకనాన్ని అదే ప్రాథమిక స్థాయితో పోల్చవచ్చు. కస్టమర్ నిర్వహించే VPC కోసం AWS వేరే మార్గదర్శి, రెండు Availability Zoneల్లో private subnetలు, S3, CloudWatch Logsకు VPC endpointలు, అవసరాన్ని బట్టి AgentCore లేదా Lambda endpointను సూచిస్తుంది; MLflow వాడితే దానికీ endpoint కావాలి. అమలు పాత్రకు ENI నిర్వహణ అనుమతులు అవసరం. ఐచ్ఛిక కస్టమర్ నిర్వహించే KMS విధానానికి కాలర్, అమలు పాత్ర, runtime కోసం అదనపు అనుమతులు, key-policy అమరిక అవసరం; AWS యాజమాన్యంలోని KMS at-rest encryption సహజ అమరిక. ఏదైనా అమరిక ఎంచుకునే ముందు VPC, encryption మార్గదర్శకాలను చూడండి. సమర్పణకు ముందు ఖాతా quotaలను తనిఖీ చేయండి: సాధారణంగా ఒక MTRL fine-tuning job, ఒక evaluation job మాత్రమే ఏకకాలంలో నడుస్తాయి; Service Quotasలో రెండింటినీ మార్చవచ్చు. job-management API throttling పరిమితులను మార్చలేరు.
విడిగా ఉంచిన promptలపై deploy చేయడానికి ముందు మూల్యాంకనం చేయండి
AWS మూల్యాంకన మార్గదర్శి ప్రకారం evaluation promptలను శిక్షణ నుంచి వేరుగా ఉంచాలి, ఒకే prompt ఫార్మాట్ వాడాలి, ముఖ్యమైన సాధనాలు, వాటి కలయికలను పరీక్షించాలి, గతంలో విఫలమైన సందర్భాలను చేర్చాలి, సున్నితమైన సమాచారాన్ని రక్షించాలి. SageMaker evaluator promptల సమితిపై candidate మోడల్ను నడిపి reward, pass@k, trajectory కొలమానాలను నివేదించగలదు. Fine-tuned మోడల్తో పాటు base మోడల్నూ ఒకే పోలిక pipelineలో ఐచ్ఛికంగా పరీక్షించవచ్చని పత్రం చూపుతుంది.
శిక్షణకు ముందే మూల్యాంకన విధానాన్ని నిర్ణయించండి. live agent ఎదుర్కొనే queryలు, permissions, document మార్పులను ప్రతిబింబించే ఒకే స్థిరమైన holdout సమితిని ఉంచండి. base, fine-tuned మోడళ్లను ఒకే సాధనాలు, పరిమితులు, scoring codeతో పోల్చండి. సగటు retrieval scoreతో పాటు పని వైఫల్యాలు, turnల సంఖ్య, జాప్యం, token వినియోగం, సంబంధిత పత్రాలు అగ్రస్థానాల నుంచి మాయమయ్యే సందర్భాలనూ పరిశీలించండి. AWS evaluation jobను ఎలా సమర్పించాలో పత్రాలు వివరిస్తాయి; ఏకైక కొలమానం ఉత్పత్తి శోధన నాణ్యతను పూర్తిగా పట్టుకుంటుందని నిరూపించవు.
AWS బ్లాగ్ ఈ holdout ఫలితాలను నివేదించింది:
డేటాసెట్ (ప్రశ్నలు) | ఆధార nDCG@10 | fine-tuned nDCG@10 | ఆధార వైఫల్య రేటు | ఫైన్-ట్యూన్ చేసిన వైఫల్య రేటు |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
ఈ పట్టికలో nDCG@10 మూడు సమూహాల్లో పెరిగి, FreshStackలో స్వల్పంగా తగ్గింది. turn లేదా token పరిమితిని చేరితే విధించే శిక్షే BrowseComp-Plusలో తక్కువ వైఫల్య రేటుకు కారణమని AWS చెబుతోంది. నమ్మక పరిధులు లేదా గణాంక ప్రాముఖ్యత విశ్లేషణను బ్లాగ్ అందించలేదు. WixQAలో fine-tuned మోడల్ సగటు 4.5 turnలు తీసుకోగా, base 4.3 తీసుకుంది; Wandsలో అవి 2.9, 2.2. కాబట్టి turnలు ఎల్లప్పుడూ తగ్గలేదు. ఇవి విక్రేత నివేదించిన ప్రయోగ ఫలితాలు; స్వతంత్ర ధృవీకరణ కాదు, ఇతర corpusలలోనూ ఫలితం మెరుగవుతుందనే ఆధారమూ కాదు.
మొత్తం ప్రయోగ వ్యయాన్ని అంచనా వేయండి
AWS MTRL పత్రాల ప్రకారం శిక్షణ ఖర్చులో మూడు అంశాలుంటాయి: ఇన్పుట్గా ప్రాసెస్ చేసే prefill tokens, rolloutల సమయంలో రూపొందించే sampled tokens, శిక్షణ updates. ధరల పేజీలో మోడల్ వారీ రేట్లు ఉంటాయి. rolloutల సంఖ్య, sequence పొడవు, epochs, runtime ఆధారంగా కూడా ఖర్చు మారుతుంది. వ్యాసం మొత్తం బిల్లును వెల్లడించలేదు; అందరికీ వర్తించే ఒకే trial ధరను పత్రాలు ఇవ్వవు. ఎంచుకున్న మోడల్, ప్రాంతానికి ప్రస్తుత రేటు చూసి, అంచనా job వినియోగం ఆధారంగా లెక్కించండి.
అంచనాలో పక్క ఖర్చులనూ చేర్చండి: training, validation, checkpoints, output artifacts కోసం S3 నిల్వ, అభ్యర్థనలు; rolloutల సమయంలో AgentCore runtime లేదా Lambda, సహాయక search మౌలిక సదుపాయాలు; logging, MLflow; holdout మూల్యాంకనం; శిక్షణ తర్వాత ఉపయోగించే endpoint లేదా Bedrock deployment. కొనసాగుతున్న ఛార్జీలను నివారించేందుకు నడుస్తున్న MTRL jobను ఆపాలని లేదా తొలగించాలని, అవసరం లేని S3 model artifactsను తీసేయాలని, evaluation endpointsను తొలగించాలని AWS సూచిస్తుంది. Endpoint deployment అనేది trainingకు వేరైన ఖర్చు నిర్ణయం.
తదుపరి దశకు వెళ్లాలా నిర్ణయించండి
చివరి ఫలితాన్ని స్కోర్ చేయగలిగే, పరస్పరం ఆధారపడిన అనేక tool calls అవసరమయ్యే search పనులకు ఈ విధానం ఉపయోగకరం. ఒక trial నిర్ణయానికి ఉపయోగపడాలంటే, మద్దతున్న model-region జత, పనిచేసే agent integration, ప్రతినిధ్య prompt డేటా, పనిని ప్రతిబింబించే reward, holdout పోలిక, సహాయక సేవల ఖర్చుతో కూడిన అంచనా అవసరం. AWS తెలిపిన నాలుగు benchmarksలో మంచి ఫలితం రావడం ఈ పద్ధతిని పరిశీలించడానికి కారణం మాత్రమే; వేరే index, query mix లేదా permissionsలోనూ అదే ప్రభావం ఉంటుందని అనుకోవడానికి ఆధారం కాదు.
మూలాలు, మరింత చదవడానికి
- AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (2026 అక్టోబర్ 2) — విక్రేత మార్గదర్శకం, సెటప్, dataset ఎంపికలు, AWS నివేదించిన మూల్యాంకన ఫలితాలు.
- Amazon SageMaker AI: Multi-turn reinforcement learningAmazon SageMaker AI: Multi-turn reinforcement learning
- ముందస్తు అవసరాలు , Preparing your agent , VPC configuration మరియు encryption at rest — అనుమతులు, runtime ఎంపికలు, agent అనుసంధానం, ఐచ్ఛిక నెట్వర్క్, encryption అమరిక.
- Creating assets , training job submission , evaluation , hyperparameters మరియు quotas — తాజా అమలు సూచనలు.
- SageMaker AI pricing — ప్రస్తుత model customization ధరలు; మోడల్, ప్రాంతాన్ని బట్టి రేట్లు మారుతాయి.
నివేదిక గమనిక: ఇది పత్రాల పరిశీలన మాత్రమే. BIG CHANGE AWS ఖాతాను యాక్సెస్ చేయలేదు; SageMaker jobను సమర్పించలేదు లేదా పరిశీలించలేదు; AWS APIలను పిలవలేదు; నివేదించిన కొలతలను స్వతంత్రంగా పునరుత్పత్తి చేయలేదు. అమలు మార్గదర్శి, ప్రయోగ ఫలితాలు AWS నుంచే వచ్చాయి.