Mistral abrió la vista previa pública de Large 4 el 6 de octubre de 2026. Los desarrolladores pueden llamar a su API alojada con el ID del modelo mistral-large-4. La ficha del modelo lo describe como de pesos abiertos, mientras que la actualización de la empresa dice que el lanzamiento completo está previsto para finales de octubre. No verificamos si hay pesos descargables para esta vista previa. Esta guía sigue la documentación de Mistral; BIG CHANGE no ha enviado una solicitud a la API ni medido la salida del modelo.
El gran cambio
- Qué cambió: El nuevo modelo insignia de Mistral está disponible para desarrolladores mediante una vista previa de API de pago. Su contexto documentado de 1 millón de tokens y el codificador visual amplían los tipos de material que una aplicación puede enviar, aunque este recorrido solo usa texto.
- Por qué importa: Un equipo puede evaluar Large 4 hoy mediante la interfaz de chat alojada. Las tarifas publicadas por token permiten calcular de antemano el coste variable de una prueba pequeña. La calidad de salida y la latencia aún deben medirse en la aplicación del propio equipo.
- Qué observar: Mistral dice que el lanzamiento completo está previsto para finales de este mes. Los equipos interesados en el autoalojamiento tendrán que comprobar si se ofrecen pesos descargables y en qué condiciones. La vista previa pública actual puede recibir actualizaciones silenciosas y no tiene una vía garantizada hacia la disponibilidad general; por tanto, la decisión de integración también depende de la tolerancia al ciclo de vida.
Envía una solicitud de texto
La guía de inicio rápido de la API de Mistral indica que hay que crear una cuenta de Studio, activar los pagos para habilitar las claves de API y usar una clave para el endpoint de chat. Esas instrucciones no indican una compra mínima. Guarda la clave como MISTRAL_API_KEY en tu entorno. La ficha del modelo identifica el modelo de vista previa como mistral-large-4; un ejemplo antiguo de la guía de inicio rápido mistral-large-latest usa otro alias. La política del ciclo de vida de Mistral indica que los modelos Public Preview no tienen alias -latest .
La solicitud siguiente usa el endpoint documentado de chat completions. Su tarea sencilla es extraer dos datos del texto de la ficha del modelo. Sustituye el prompt por material de tu aplicación después de comprobar su exactitud y permisos.
curl https://api.mistral.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {
        "role": "user",
        "content": "Extract the model name and context size from this text: Mistral Large 4. Context: 1M tokens. Answer in one sentence."
      }
    ]
  }'
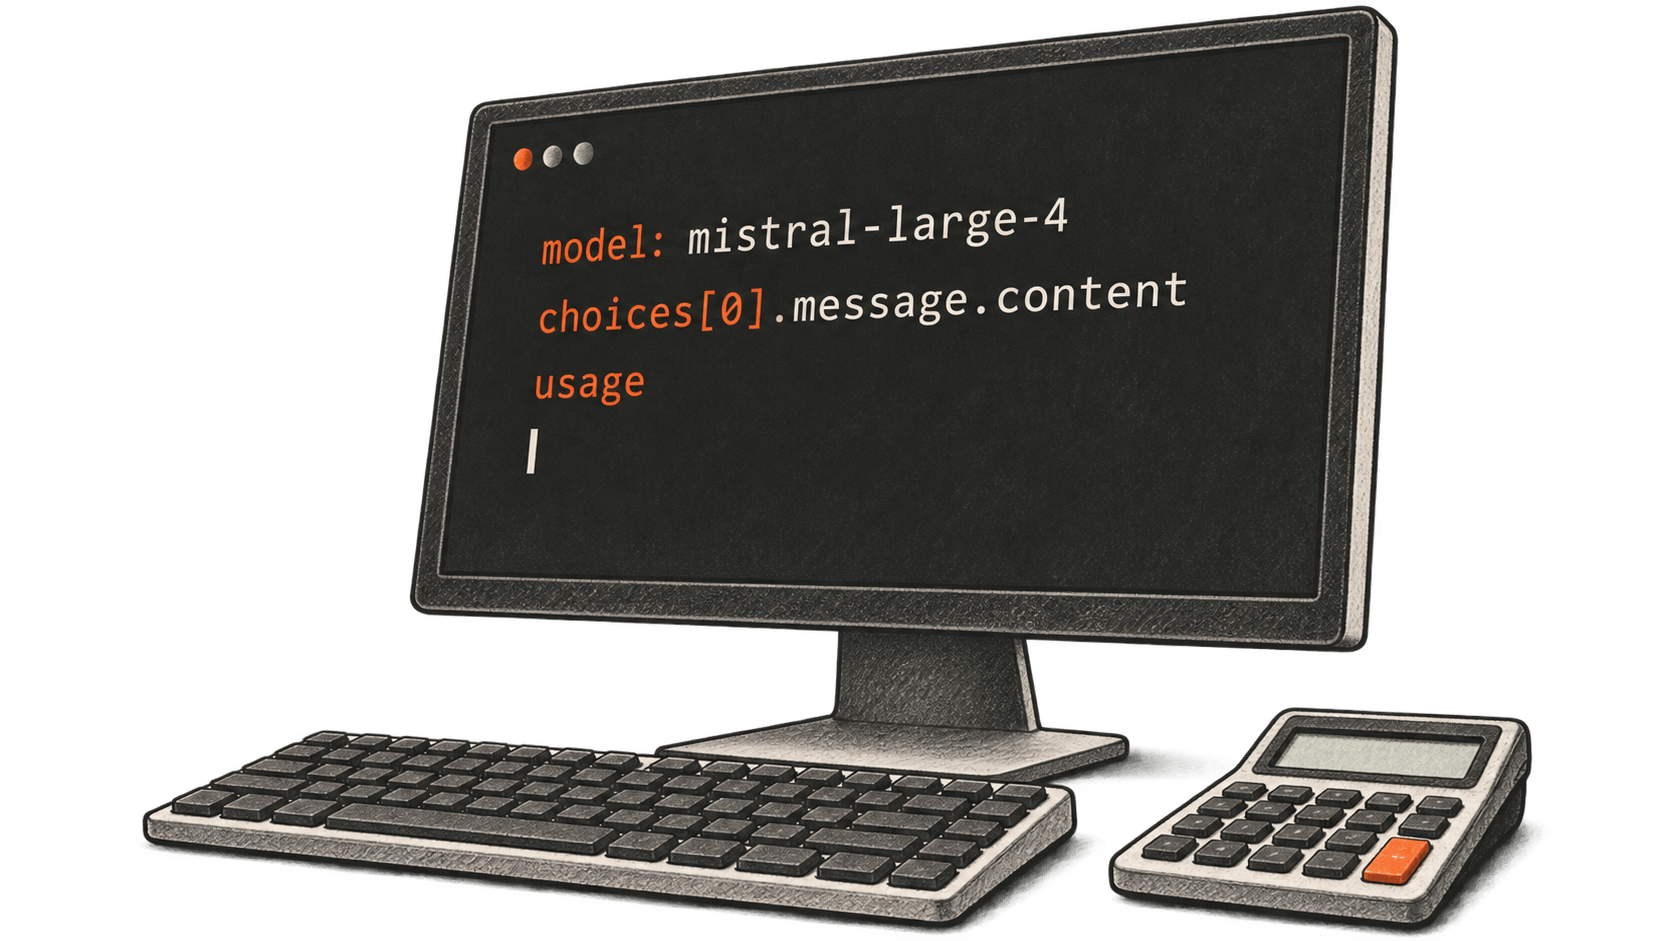
El endpoint recibe una cadena model y un arreglo messages . Aquí el único mensaje tiene el rol user y contenido de texto. Para una finalización de chat normal y correcta, Mistral documenta una respuesta con choices; el texto generado está en choices[0].message.content. La respuesta también contiene model y usage. Cabe esperar una respuesta que identifique Mistral Large 4 y su contexto de 1 millón de tokens, pero la redacción exacta se genera automáticamente y BIG CHANGE no la ha comprobado. Revisa usage devuelto para ver los recuentos reales de tokens; no tomes las palabras visibles del prompt como tokens.
La ficha del modelo enumera salidas estructuradas, llamadas a funciones, preguntas y respuestas sobre documentos, chat completions, procesamiento por lotes, agentes y herramientas integradas. Describe un codificador visual, pero esta solicitud de texto no establece un formato de carga de imágenes ni prueba la comprensión visual. Consulta la documentación de cada función antes de añadir archivos, imágenes o herramientas a una aplicación.
Calcula el coste variable
Según la ficha del modelo del 6 de octubre, la entrada estándar cuesta 0,68 $ por millón de tokens, la entrada en caché 0,07 $ por millón y la salida 2,09 $ por millón. Para una solicitud ilustrativa con 1.000 tokens de entrada sin caché y 200 de salida, el cargo por tokens es de (1,000 × $0.68 + 200 × $2.09) ÷ 1,000,000 = $0.001098. Esos recuentos son supuestos para el cálculo, no una ejecución medida de la solicitud anterior. Las condiciones del plan de cuenta y otros cargos quedan fuera de este ejemplo.
El contexto de 1 millón de tokens es el espacio máximo combinado para entrada y salida. Las limitaciones conocidas de Mistral indican que una solicitud demasiado larga devuelve 400 Bad Request. La plataforma también aplica límites de velocidad por organización, que varían según el plan y el modelo, y devuelve 429 Too Many Requests cuando se superan. Comprueba los modelos y límites disponibles en tu cuenta antes de basar una integración en la vista previa.
La política del ciclo de vida de Mistral define Public Preview como una fase casi definitiva, sujeta a actualizaciones silenciosas. No garantiza el paso a disponibilidad general y establece un aviso de retirada de un mes. Mantén explícito el ID del modelo en la integración, registra el modelo y el uso de tokens que devuelve cada solicitud y vuelve a ejecutar tus propias comprobaciones cuando cambie la vista previa. Son precauciones prácticas basadas en las condiciones publicadas, no resultados de pruebas de BIG CHANGE.
Fuentes y lecturas adicionales
- Ficha del modelo Mistral Large 4, fechada el 6 de octubre de 2026. Incluye el ID
mistral-large-4, el estado Public Preview Open v26.10, el contexto de 1 millón de tokens, las funciones enumeradas y los precios actuales por token. - Actualización de la empresa Mistral, 6 de octubre de 2026: indica que el modelo ya está disponible en vista previa y que el lanzamiento completo se prevé para finales de mes. Su anuncio de lanzamiento no estaba disponible para nuestra herramienta de recuperación. No verificamos un archivo de pesos descargable ni una fecha exacta de publicación de los pesos.
- Guía de inicio rápido de la API y referencia del endpoint de chat. Explican la activación de pagos para las claves de API, los campos de solicitud y la estructura de respuesta. El código anterior adapta su ejemplo general de chat al ID del modelo Large 4.
- Política del ciclo de vida del modelo y limitaciones conocidas. Explican las actualizaciones de la vista previa, el aviso de retirada, los errores de contexto y los límites de velocidad.