Nagbukas ang Mistral ng Public Preview ng Large 4 noong Oktubre 6, 2026. Maaaring tawagin ng mga developer ang naka-host nitong API gamit ang model ID mistral-large-4 . Inilalarawan ito ng model card bilang open-weight, samantalang sinasabi ng update ng kumpanya ng Mistral na nakaplano ang buong release sa huling bahagi ng Oktubre. Hindi namin tiniyak kung mada-download ang mga weight para sa preview na ito. Sinusunod ng gabay na ito ang dokumentasyon ng Mistral; walang API request na ipinadala ang BIG CHANGE at hindi nito sinukat ang output ng modelo.
Ang malaking pagbabago
- Ano ang nagbago: Available na sa mga developer ang bagong flagship ng Mistral sa pamamagitan ng may bayad na API preview. Pinapalawak ng dokumentadong 1 milyong-token na context at vision encoder nito ang mga uri ng materyal na maaaring ipadala ng isang application, bagaman teksto lamang ang ginagamit sa walkthrough na ito.
- Bakit ito mahalaga: Maaari nang suriin ng isang team ang Large 4 sa naka-host na chat interface. Nagbibigay-daan ang inilathalang mga rate ng token na maagang kalkulahin ang pabagu-bagong gastos ng maliit na pagsubok. Kailangan pa ring sukatin ang kalidad ng output at latency sa sariling application ng team.
- Ano ang dapat bantayan: Ayon sa Mistral, nakaplano ang buong release sa huling bahagi ng buwang ito. Kailangang tiyakin ng mga team na interesado sa self-hosting kung magiging available ang mga nada-download na weight at kung ano ang mga tuntunin nito. Maaaring makatanggap ng tahimik na update ang kasalukuyang Public Preview at walang garantisadong landas tungo sa general availability, kaya nakadepende rin ang pasya sa integrasyon sa pagtanggap sa lifecycle na ito.
Magpadala ng text request
Inirerekomenda ng API quickstart ng Mistral na gumawa ng Studio account, i-activate ang pagbabayad upang magkaroon ng API keys, at gumamit ng key para sa chat endpoint. Walang binanggit na minimum na pagbili sa mga tagubiling iyon. Itago ang key bilang MISTRAL_API_KEY sa environment mo. Ang model card ay tumutukoy sa preview model bilang mistral-large-4; ginagamit sa mas lumang quickstart ang mistral-large-latest bilang halimbawa ng ibang alias. Ayon sa Mistral, sinasabi ng patakaran sa lifecycle na walang -latest alias ang mga modelo ng Public Preview.
Ginagamit ng request sa ibaba ang dokumentadong chat completions endpoint . Maliit na gawain nito ang kumuha ng dalawang katotohanan mula sa teksto ng model card. Palitan ang prompt ng materyal mula sa application mo matapos tiyakin ang katumpakan at mga pahintulot nito.
curl https://api.mistral.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {
        "role": "user",
        "content": "Extract the model name and context size from this text: Mistral Large 4. Context: 1M tokens. Answer in one sentence."
      }
    ]
  }'
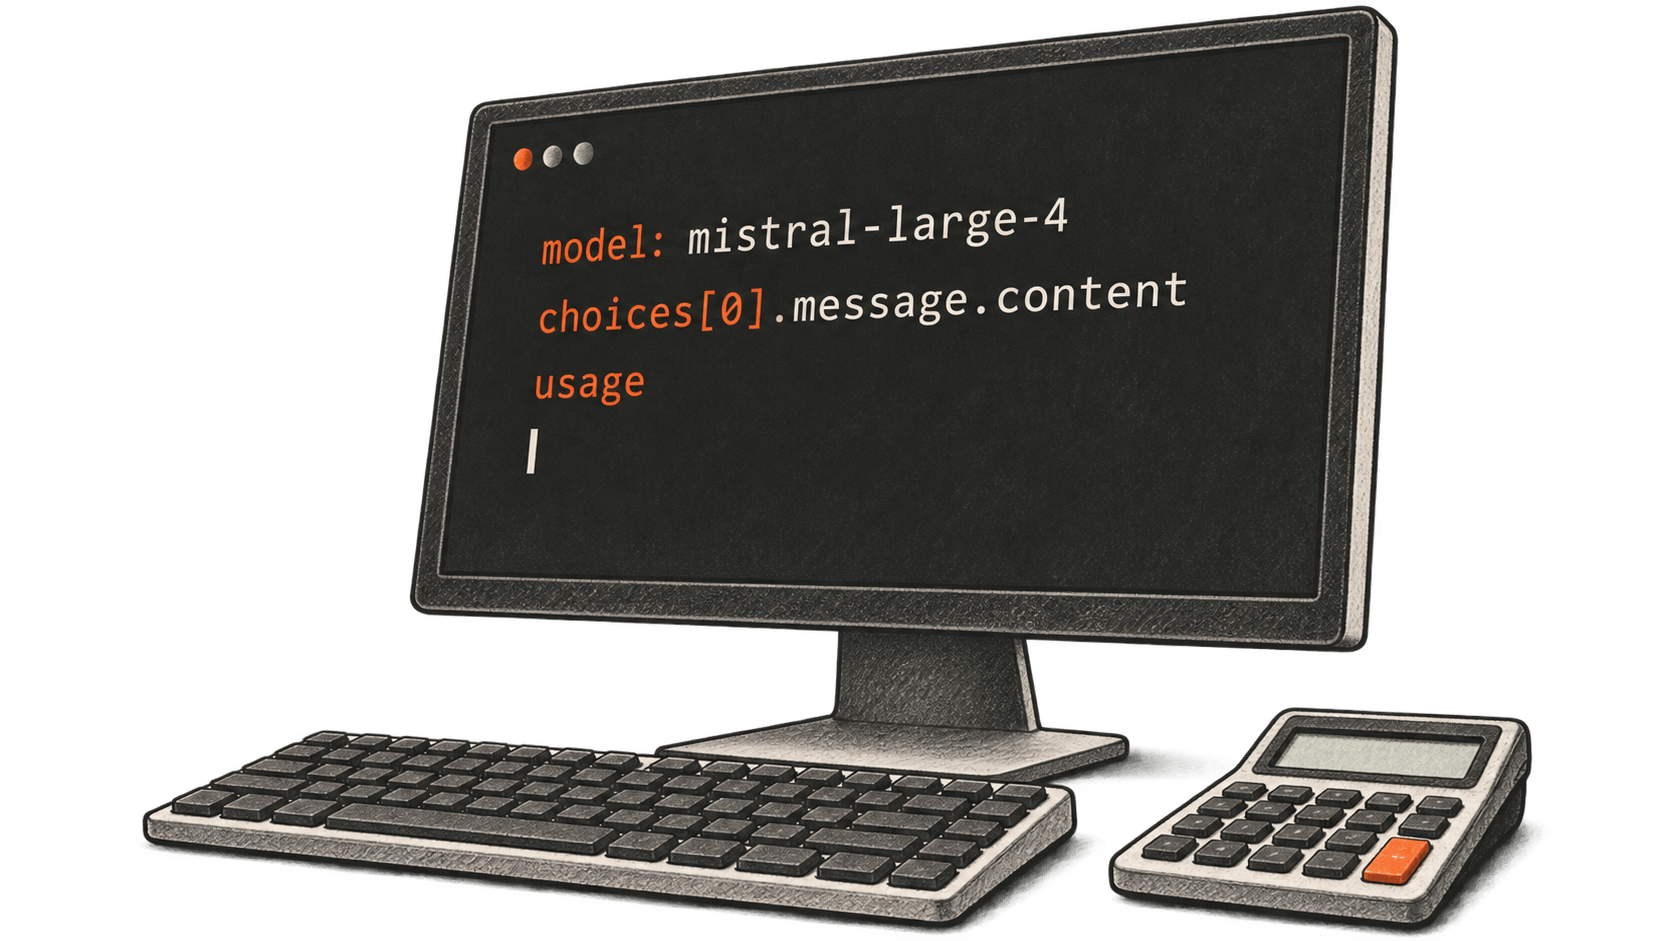
Tumatanggap ang endpoint ng model string at messages array. Ang iisang mensahe rito ay may user role at tekstong nilalaman. Sa matagumpay at karaniwang chat completion, dokumentado ng Mistral ang tugon na may choices; nasa choices[0].message.content ang nabuong teksto. Kasama rin sa tugon ang model at usage. Dapat tukuyin ng sagot ang Mistral Large 4 at ang 1 milyong-token nitong context, ngunit hindi alam ang eksaktong pananalita hangga't hindi ito nabubuo at hindi ito sinuri ng BIG CHANGE. Tingnan ang ibinalik na usage para sa aktuwal na bilang ng token sa halip na ituring na token ang nakikitang mga salita sa prompt.
Nakalista sa model card ang structured outputs, function calling, document Q&A, chat completions, batching, agents, at mga built-in na tool. Inilalarawan nito ang isang vision encoder, ngunit hindi itinatakda ng text request na ito ang format ng image payload o sinusubok ang visual understanding. Sumangguni sa dokumentasyon ng kaugnay na feature bago magdagdag ng mga file, larawan, o tool sa isang application.
Tantiyahin ang pabagu-bagong singil
Ayon sa model card noong Oktubre 6 , nagkakahalaga ang karaniwang input ng $0.68 kada isang milyong token; ang naka-cache na input ay $0.07 kada isang milyon at ang output ay $2.09 kada isang milyon . Sa halimbawang request na may 1,000 uncached na input token at 200 output token, (1,000 × $0.68 + 200 × $2.09) ÷ 1,000,000 = $0.001098 ang singil sa token. Palagay lamang sa pagkukuwenta ang mga bilang ng token na ito, hindi sukat mula sa request sa itaas. Hindi kasama rito ang mga tuntunin ng account plan at iba pang singil.
Pinagsamang pinakamataas na espasyo para sa input at output ang 1 milyong-token na context. Sinasabi sa kilalang limitasyon ng Mistral na nagbabalik ng 400 Bad Request ang sobrang habang request. Naglalapat din ang platform ng mga rate limit para sa organisasyon na nag-iiba ayon sa plan at modelo, at nagbabalik ng 429 Too Many Requests kapag nalampasan ang mga ito. Tingnan ang mga modelong available sa account mo at ang mga limitasyon nito bago umasa sa preview.
Itinuturing ng patakaran sa lifecycle ng Mistral na malapit na sa pinal na bersyon ang Public Preview ngunit maaari itong makatanggap ng tahimik na update. Walang garantisadong landas tungo sa general availability at nagbibigay ito ng isang buwang abiso bago itigil. Panatilihing tahasan ang model ID sa integrasyon mo, itala ang ibinalik na modelo at paggamit ng token sa bawat request, at ulitin ang sarili mong mga pagsusuri sa application kapag nagbago ang preview. Mga praktikal na pag-iingat ang mga ito batay sa inilathalang tuntunin ng lifecycle, hindi resulta ng pagsubok ng BIG CHANGE.
Mga mapagkukunan at karagdagang babasahin
- Model card ng Mistral Large 4, na may petsang Oktubre 6, 2026. Ibinibigay nito ang ID na
mistral-large-4, status na Public Preview Open v26.10, 1 milyong-token na context, mga nakalistang feature, at kasalukuyang presyo ng token. - Update ng kumpanya ng Mistral, noong Oktubre 6, 2026, na nagsasabing maaari nang subukan ang modelo at nakaplano ang buong release sa huling bahagi ng buwan. Hindi available sa retrieval tool namin ang anunsyo ng paglulunsad nito. Hindi namin tiniyak kung may nada-download na weight file o kung kailan eksaktong ilalabas ang mga weight.
- Ipinapaliwanag ng API quickstart at sanggunian sa chat endpoint
- ang pag-activate ng bayad para sa API keys, mga field ng request, at istruktura ng tugon. Iniaangkop ng code sa itaas ang pangkalahatang halimbawa ng chat sa model ID ng Large 4.Ipinapaliwanag ng patakaran sa lifecycle ng modelo at